



2026 में आपकी robots.txt पहले से कहीं ज़्यादा अहम क्यों है
robots.txt फ़ाइल 1994 में इसलिए बनी थी ताकि वेब क्रॉलर्स को बताया जा सके कि किन पेजों से दूर रहना है। 30 साल तक वेबमास्टर्स को असल में एक ही बड़े क्रॉलर परिवार की फ़िक्र करनी पड़ती थी: Googlebot। 2026 में यह लिस्ट बहुत लंबी हो चुकी है। OpenAI, Anthropic, Perplexity, Google जैसी AI कंपनियाँ अपने-अपने क्रॉलर चलाती हैं, जो आपका कंटेंट पढ़कर मॉडल ट्रेन करते हैं, नॉलेज बेस बनाते हैं और AI सर्च के जवाब तैयार करते हैं।
इन क्रॉलर्स को आप allow करते हैं या ब्लॉक, इसका सीधा असर AI सर्च में आपकी विज़िबिलिटी पर पड़ता है। GPTBot आपकी साइट क्रॉल नहीं कर पाया, तो आपका कंटेंट ChatGPT के जवाबों तक नहीं पहुँचेगा। PerplexityBot को ब्लॉक किया, तो Perplexity आपके पेज cite नहीं कर पाएगा। Google-Extended ब्लॉक है, तो हो सकता है आपका कंटेंट Google के AI Overviews (Google के AI वाले सारांश) और AI Mode के जवाबों में न दिखे।
AI क्रॉलर्स के दौर में robots.txt सही रखने के लिए तीन बातें समझनी होंगी: कौन-से बॉट मौजूद हैं, वे क्या करते हैं, और एक्सेस को ऐसे कैसे सेट करें कि कंटेंट भी सुरक्षित रहे और AI citation के मौके भी ज़्यादा से ज़्यादा मिलें। यह गाइड यह सब कवर करती है, साथ में एक फ्री robots.txt जनरेटर भी है, जिससे आप कुछ ही मिनटों में AI-रेडी कॉन्फ़िगरेशन बना सकते हैं।
AI क्रॉलर्स की पूरी लिस्ट
कुछ भी कॉन्फ़िगर करने से पहले यह जानना ज़रूरी है कि किन बॉट्स के लिए रूल लिखने हैं। 2026 के हिसाब से बड़े AI क्रॉलर्स और उनके user agents ये हैं:
OpenAI - ChatGPT
- User-agent: GPTBot
- काम: ट्रेनिंग डेटा जुटाना और ChatGPT का Browse फ़ीचर
- ब्लॉक करने का असर: आपका कंटेंट ChatGPT के जवाबों तक नहीं पहुँचेगा और ChatGPT Browse के citations में नहीं दिखेगा
- डॉक्यूमेंटेशन: OpenAI, GPTBot की IP रेंज की एक पब्लिक लिस्ट रखता है
Anthropic - Claude
- User-agent: ClaudeBot (anthropic-ai के नाम से भी पहचाना जाता है)
- काम: Claude AI के लिए ट्रेनिंग डेटा और नॉलेज बेस
- ब्लॉक करने का असर: जब यूज़र्स आपके विषय पर सवाल पूछेंगे, तो Claude के जवाबों में आपके कंटेंट का योगदान नहीं होगा
- डॉक्यूमेंटेशन: Anthropic ने अपनी क्रॉलिंग पॉलिसी पब्लिश की है और वह robots.txt के निर्देशों को मानता है
Perplexity AI
- User-agent: PerplexityBot
- काम: Perplexity AI के जवाबों और citations के लिए रियल-टाइम वेब सर्च
- ब्लॉक करने का असर: आपके पेज बहुत ज़्यादा प्रासंगिक होने पर भी Perplexity के जवाबों में cite नहीं होंगे
- डॉक्यूमेंटेशन: Perplexity, robots.txt को मानता है और उसने अपनी क्रॉलिंग गाइडलाइंस पब्लिश की हैं
Google - AI फ़ीचर्स
- User-agent: Google-Extended
- काम: Google Bard/Gemini की ट्रेनिंग और AI Overviews का कंटेंट
- ब्लॉक करने का असर: हो सकता है आपका कंटेंट Google के AI Overviews, AI Mode या Gemini के जवाबों में न दिखे
- ध्यान दें: यह Googlebot से अलग है। आप Googlebot (पारंपरिक सर्च) को allow रखकर Google-Extended (AI फ़ीचर्स) को ब्लॉक कर सकते हैं
Microsoft - Copilot
- User-agent: Bingbot (साझा), Copilot के खास क्रॉलर अलग-अलग होते हैं
- काम: Microsoft Copilot और Bing के AI जवाबों को चलाता है
- ब्लॉक करने का असर: Microsoft Copilot और Bing के AI फ़ीचर्स में विज़िबिलिटी घट जाती है
Meta - Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- काम: Meta AI और Llama मॉडल्स के लिए ट्रेनिंग डेटा
- ब्लॉक करने का असर: Meta AI के जवाबों में आपके कंटेंट का योगदान नहीं होगा
Apple - Applebot
- User-agent: Applebot, Applebot-Extended
- काम: Siri, Apple Intelligence और Apple के सर्च फ़ीचर्स
- ब्लॉक करने का असर: Siri और Apple के AI फ़ीचर्स में विज़िबिलिटी घट जाती है
असली दिक्कत: ज़्यादातर robots.txt फ़ाइलें AI क्रॉलर्स के आने से पहले लिखी गई थीं
2020-2023 की एक आम robots.txt कुछ ऐसी दिखती है:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
यह कॉन्फ़िगरेशन Googlebot को तो allow करता है, लेकिन बाकी सभी बॉट्स के लिए wildcard रूल के भरोसे छोड़ देता है। इसे कैसे पढ़ा जाता है, उस पर निर्भर करता है कि यह wildcard रूल AI क्रॉलर्स को आपकी साइट के कुछ हिस्सों से रोक रहा हो, या फिर उन्हें हर जगह जाने दे रहा हो, उन पेजों पर भी जिन्हें आप बचाकर रखना चाहते हैं।
इससे भी बुरा यह कि AI क्रॉलर्स के शुरुआती दौर (2022-2023) में, जब AI ट्रेनिंग के लिए डेटा इस्तेमाल पर पब्लिशर्स का विरोध चरम पर था, कई साइट्स ने धड़ल्ले से ब्लॉकिंग जोड़ दी। अगर आपकी साइट ने सभी बॉट्स के लिए Disallow: / लगा दिया था, तो हो सकता है आपने AI क्रॉलर्स को बाहर कर दिया हो और फिर भूल गए हों। इसका नतीजा तभी दिखता है जब आप नोटिस करते हैं कि AI सर्च के जवाबों में आपका ब्रांड उतना नज़र नहीं आ रहा जितना आना चाहिए।
AI Rank Lab का AI बॉट ट्रैकिंग फ़ीचर दिखाता है कि असल में कौन-से AI बॉट आपके पेजों पर आ रहे हैं और कौन-से AI असिस्टेंट आपको रेफ़रल ट्रैफ़िक भेज रहे हैं, वो भी बिना मैन्युअल लॉग एनालिसिस के। जिस क्रॉलर को आप allow करना चाहते थे, वह कभी दिखे ही नहीं, तो अपनी robots.txt में उसके रूल चेक कीजिए।
अलग-अलग स्थितियों के लिए robots.txt टेम्पलेट्स
इन टेम्पलेट्स को अपनी साइट के हिसाब से ढालने के लिए हमारा फ्री robots.txt जनरेटर इस्तेमाल कीजिए। नीचे सबसे आम कॉन्फ़िगरेशन दिए गए हैं:
टेम्पलेट 1: AI को पूरा एक्सेस (ज़्यादातर साइट्स के लिए सही)
सभी AI क्रॉलर्स को अपना कंटेंट पढ़ने दीजिए। यह उन साइट्स के लिए सबसे अच्छा है जो AI सर्च में ज़्यादा से ज़्यादा विज़िबिलिटी चाहती हैं और जिन्हें इस बात से कोई दिक्कत नहीं कि उनका कंटेंट AI मॉडल की ट्रेनिंग में काम आए।
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
टेम्पलेट 2: चुनिंदा AI एक्सेस (कंटेंट की सुरक्षा)
पब्लिक कंटेंट वाले पेजों पर AI क्रॉलर्स को आने दीजिए, लेकिन प्रीमियम कंटेंट, पेवॉल वाले आर्टिकल्स और मेंबर एरिया को ब्लॉक रखिए। सब्सक्रिप्शन पब्लिशर्स और गेटेड कंटेंट वाली साइट्स के लिए यह सबसे सही है।
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
टेम्पलेट 3: AI ट्रेनिंग ब्लॉक, AI सर्च allow
यह थोड़ा सधा हुआ कॉन्फ़िगरेशन है: Perplexity को allow कीजिए (जो आपके कंटेंट को रियल-टाइम citations के लिए इस्तेमाल करता है), लेकिन ट्रेनिंग क्रॉलर्स को ब्लॉक कर दीजिए (जो आपके कंटेंट से मॉडल ट्रेन करते हैं)। जो पब्लिशर्स AI सर्च में citations तो चाहते हैं पर मॉडल ट्रेनिंग में अपने कंटेंट के इस्तेमाल के ख़िलाफ़ हैं, उनके लिए यह एक आम बीच का रास्ता है।
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml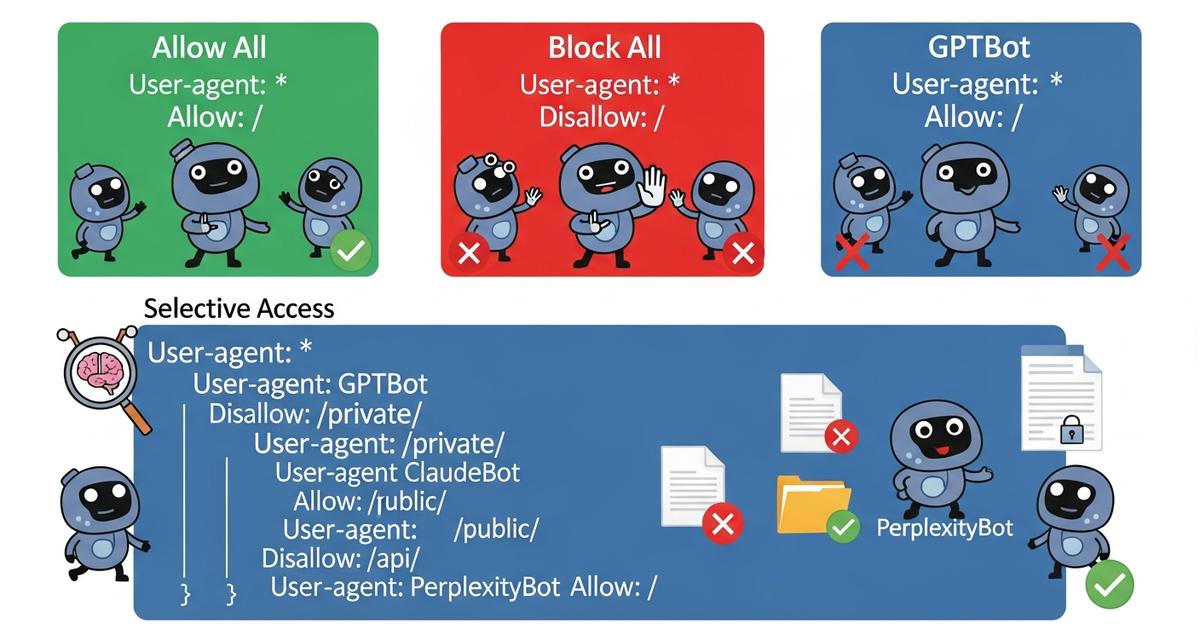
आपके लिए कौन-सा कॉन्फ़िगरेशन सही है, यह कैसे तय करें
सही robots.txt कॉन्फ़िगरेशन आपके कंटेंट के प्रकार, बिज़नेस मॉडल और AI सर्च विज़िबिलिटी के लक्ष्यों पर निर्भर करता है। फ़ैसला लेने के लिए यह फ़्रेमवर्क अपनाइए:
सभी AI क्रॉलर्स को allow कीजिए, अगर:
- आपकी साइट खुले तौर पर उपलब्ध कंटेंट पब्लिश करती है (ब्लॉग, डॉक्यूमेंटेशन, रिसोर्सेज़)
- आप AI सर्च में ज़्यादा से ज़्यादा विज़िबिलिटी चाहते हैं और citations आपके लिए ट्रैफ़िक का ज़रिया हैं
- आपके पास ऐसा गेटेड या प्रीमियम कंटेंट नहीं है जिसे बचाना ज़रूरी हो
- आपका कंटेंट जानकारी देने वाला है और जितना फैले, उतना फ़ायदा
चुनिंदा एक्सेस रखिए, अगर:
- आपके पास फ्री और प्रीमियम, दोनों तरह का कंटेंट है
- कुछ पेज cite नहीं होने चाहिए (अकाउंट पेज, चेकआउट फ़्लो, सिर्फ़ मेंबर्स वाला कंटेंट)
- आप चाहते हैं कि AI क्रॉलर्स सब कुछ क्रॉल करने के बजाय आपके सबसे अच्छे कंटेंट पर फ़ोकस करें
ट्रेनिंग क्रॉलर्स ब्लॉक कीजिए (सिर्फ़ सर्च allow), अगर:
- आप एक पब्लिशर हैं और AI ट्रेनिंग में डेटा के इस्तेमाल को लेकर आपकी चिंताएँ हैं
- आप फिर भी Perplexity और Google AI Overviews में दिखना चाहते हैं (रियल-टाइम citation)
- आप अपना कंटेंट AI कंपनियों को अलग से लाइसेंस करने का विकल्प खुला रखना चाहते हैं
सभी AI क्रॉलर्स को ब्लॉक सिर्फ़ तब कीजिए, जब:
- कंटेंट को AI सिस्टम्स से दूर रखने के लिए आपके पास साफ़ कानूनी या प्रतिस्पर्धी कारण हों
- किसी खास AI कंपनी के साथ आपका लाइसेंसिंग एग्रीमेंट है और आप उसकी एक्सक्लूसिविटी लागू करना चाहते हैं
- आप यह सौदा समझते हैं: आपके डोमेन की AI सर्च विज़िबिलिटी शून्य हो जाएगी
इन आम गलतियों से बचिए
गलती 1: अनजान बॉट्स के लिए wildcard ब्लॉक लगाना
User-agent: * / Disallow: / जैसे कॉन्फ़िगरेशन, जिनके बाद सिर्फ़ Googlebot के लिए allow रूल हों, सभी AI क्रॉलर्स को ब्लॉक कर देंगे, क्योंकि उनके लिए कोई साफ़ allow रूल नहीं है। AI क्रॉलर्स के एक्सेस के बारे में हमेशा साफ़-साफ़ रूल लिखिए।
गलती 2: अपना मौजूदा कॉन्फ़िगरेशन ही न पता होना
कई टीमों को पता ही नहीं होता कि उनकी robots.txt अभी AI क्रॉलर्स के बारे में क्या कहती है। इसे अभी yoursite.com/robots.txt पर चेक कीजिए। AI Rank Lab के टूल्स भी मदद कर सकते हैं: फ्री साइट ऑडिट चेक करता है कि आपकी robots.txt मौजूद है और खुल रही है।
गलती 3: Googlebot और Google-Extended को एक समझ लेना
Googlebot को allow करने से Google-Extended (AI फ़ीचर्स वाला क्रॉलर) अपने-आप allow नहीं होता। अगर आपको Google AI Overviews और AI Mode में दिखना है, तो Google-Extended को allow करने वाला अलग रूल लिखना होगा।
गलती 4: बदलाव के बाद टेस्ट न करना
robots.txt अपडेट करने के बाद लाइव फ़ाइल देखकर और किसी robots.txt टेस्टिंग टूल से पक्का कीजिए कि बदलाव लागू हो गए हैं। Google Search Console में Googlebot के लिए बिल्ट-इन robots.txt टेस्टर है, लेकिन AI क्रॉलर्स के रूल आपको मैन्युअली वेरिफ़ाई करने होंगे।
गलती 5: एक बार सेट करके भूल जाना
नए AI क्रॉलर्स लगातार आते रहते हैं। 2023 की AI user agents वाली लिस्ट 2026 में पहले ही अधूरी हो चुकी है। अपनी robots.txt को कम से कम हर तिमाही रिव्यू कीजिए और बड़ी AI कंपनियों के नए क्रॉलर डॉक्यूमेंटेशन पर नज़र रखिए।
robots.txt से आगे: AI क्रॉलर्स को कंट्रोल करने का पूरा स्टैक
AI क्रॉलर्स के एक्सेस को कंट्रोल करने में robots.txt सबसे अहम है, लेकिन अकेला तरीका नहीं। एक पूरे AEO टेक्निकल सेटअप में ये चीज़ें होती हैं:
- robots.txt: क्रॉलर एक्सेस के रूल (ऊपर कवर किए गए)
- llms.txt: LLMs के लिए एक गाइडेंस फ़ाइल, जो बताती है कि आपकी साइट किस बारे में है और कंटेंट का इस्तेमाल कैसे होना चाहिए; यह robots.txt की जगह नहीं लेती, उसके साथ काम करती है
- noindex मेटा टैग्स: पेज-लेवल कंट्रोल, जो खास पेजों को इंडेक्स होने से रोकता है; कुछ AI क्रॉलर्स इसे मानते हैं
- AI बॉट मॉनिटरिंग: ट्रैक कीजिए कि कौन-से क्रॉलर आपकी साइट पर आ रहे हैं और कितनी बार; AI Rank Lab का बॉट ट्रैकिंग फ़ीचर बिना लॉग एनालिसिस के यह जानकारी देता है
फ्री robots.txt जनरेटर इस्तेमाल कीजिए
robots.txt शुरू से लिखने के बजाय AI Rank Lab का फ्री robots.txt जनरेटर इस्तेमाल कीजिए। अपना कॉन्फ़िगरेशन टाइप चुनिए (पूरा एक्सेस, चुनिंदा, ट्रेनिंग ब्लॉक या कस्टम), जिन पाथ्स को बचाना है उन्हें बताइए, और यह सभी मौजूदा AI क्रॉलर user agents के साथ सही फ़ॉर्मैट वाली फ़ाइल बना देगा। आउटपुट को आप सीधे अपने सर्वर पर कॉपी कर सकते हैं या फ़ाइल के रूप में डाउनलोड कर सकते हैं।
नए AI क्रॉलर user agents आने पर जनरेटर को अपडेट किया जाता है, इसलिए आपको ऐसा कॉन्फ़िगरेशन मिलता है जिसमें वे बॉट भी शामिल हैं जो इस आर्टिकल के लिखे जाने के वक़्त मौजूद ही नहीं थे।
निष्कर्ष
आपकी robots.txt, AI सर्च विज़िबिलिटी का सीधा कंट्रोल पैनल है। इसे सही रखने का मतलब है कि AI क्रॉलर्स आपका कंटेंट पढ़ और समझ सकें, और इसका नतीजा ChatGPT, Perplexity, Claude और Gemini के जवाबों में citations के रूप में मिलता है। इसे गलत रखना, या कोई पुरानी फ़ाइल यूँ ही पड़ी रहने देना, आपके कंटेंट और उन AI इंजनों के बीच अदृश्य दीवारें खड़ी कर देता है जिनके ज़रिए लोग अब ज़्यादा से ज़्यादा चीज़ें खोज रहे हैं।
अपनी मौजूदा robots.txt चेक करने और फ्री जनरेटर से AI-रेडी कॉन्फ़िगरेशन बनाने में बस पाँच मिनट लगते हैं, और AI सर्च विज़िबिलिटी के लिए यह सबसे ज़्यादा फ़ायदे वाले टेक्निकल कामों में से एक है। आज ही कर डालिए, फिर हर तिमाही रिव्यू का रिमाइंडर लगा लीजिए, क्योंकि नए AI क्रॉलर्स इस इकोसिस्टम में आते ही रहेंगे।
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


