



llms.txt पर बहस: असली सिग्नल या सिर्फ़ प्लेसीबो?
जब से llms.txt स्पेसिफ़िकेशन का प्रस्ताव आया है, SEO और AEO कम्युनिटी दो खेमों में बँटी हुई है। समर्थकों का कहना है कि यह AI सिस्टम्स को साफ़ बताता है कि आपकी साइट क्या है और किन विषयों को कवर करती है, यानी एक ऐसा स्ट्रक्चर्ड गाइडेंस जो साइटेशन का फ़ैसला आपके पक्ष में झुका सकता है। वहीं संदेह करने वालों का तर्क है कि यह अभी इतना नया है कि इसका कोई ठोस असर नहीं हो सकता, बहुत कम AI सिस्टम इसे औपचारिक रूप से सपोर्ट करते हैं, और llms.txt को जिन साइटेशन सुधारों का श्रेय दिया जाता है, वे असल में उन कंटेंट सुधारों की वजह से होते हैं जो टीमें इसे लागू करते समय साथ-साथ कर देती हैं।
हम अटकलों से आगे बढ़ना चाहते थे। AI Rank Lab के साइटेशन ट्रैकिंग इंफ्रास्ट्रक्चर की मदद से हमने 500 साइट्स का llms.txt फ़ाइल जोड़ने से पहले और बाद का विश्लेषण किया, और 90 दिनों तक ChatGPT (GPT-4o), Perplexity और Claude 3.5 Sonnet पर उनके साइटेशन रेट को ट्रैक किया। हमने यह भी देखा कि जिन साइट्स के साइटेशन में बड़ा उछाल आया, वे उन साइट्स से किस बात में अलग थीं जिनमें लगभग कोई बदलाव नहीं हुआ।
नीचे हमारे नतीजे हैं, उन हिस्सों के साथ भी जो llms.txt को लेकर किए जा रहे सबसे आशावादी दावों से मेल नहीं खाते।
500 साइट्स की स्टडी: हमने कैसे मापा
हमने छह महीने की विश्लेषण अवधि में उन 500 डोमेन को ट्रैक किया जिन्होंने पहली बार llms.txt जोड़ा। इन सभी डोमेन में:
- AI क्रॉलर्स को पहले से एक्सेस मिला हुआ था (robots.txt में GPTBot, ClaudeBot, PerplexityBot की अनुमति थी)
- llms.txt जोड़ने से पहले कम से कम 30 दिनों का साइटेशन बेसलाइन डेटा मौजूद था
- मापने की अवधि के दौरान कंटेंट में कोई बड़ा बदलाव नहीं किया गया और न ही कोई बड़े नए बैकलिंक्स हासिल किए गए
- 10-500 पेज थे (दूसरे कारकों का असर कम करने के लिए हमने बहुत छोटी और बहुत बड़ी साइट्स को बाहर रखा)
साइटेशन रेट को हमने इस तरह मापा: डोमेन के मुख्य टॉपिक क्लस्टर से जुड़ी किसी क्वेरी का जवाब देते समय किसी LLM ने उस डोमेन को कितनी बार साइट किया, इसे टेस्ट की गई क्वेरीज़ के प्रतिशत के रूप में लिया गया। हर डोमेन के लिए, हर LLM पर हमने 50 क्वेरीज़ टेस्ट कीं, जो उस डोमेन के मुख्य कीवर्ड सेट से ली गई थीं।
ये साइट्स 12 इंडस्ट्रीज़ से थीं: SaaS, ई-कॉमर्स, लोकल सर्विसेज़, B2B सर्विसेज़, पब्लिशिंग, हेल्थकेयर, लीगल, फ़ाइनेंशियल सर्विसेज़, एजुकेशन, रियल एस्टेट, ट्रैवल और टेक्नोलॉजी न्यूज़।
पहला अहम नतीजा: llms.txt से साइटेशन रेट बढ़ता है, लेकिन हर LLM पर नहीं
सभी 500 साइट्स को मिलाकर, llms.txt जोड़ने के बाद 90 दिनों में औसत साइटेशन रेट में ये बदलाव दिखे:
- Perplexity: औसत साइटेशन रेट में +18% सुधार
- ChatGPT (Browse के साथ): औसत साइटेशन रेट में +12% सुधार
- Claude: औसत साइटेशन रेट में +7% सुधार
- ChatGPT (Browse के बिना, बेस GPT-4o): +3% (सांख्यिकीय रूप से महत्वपूर्ण नहीं)
LLM के हिसाब से यह फ़र्क़ काफ़ी बड़ा है, और इसे सिर्फ़ क्रॉलिंग के तरीक़ों के अंतर से पूरी तरह नहीं समझाया जा सकता। Perplexity का बेहतर रिस्पॉन्स शायद उसके रियल-टाइम वेब सर्च आर्किटेक्चर की वजह से है: जवाब तैयार करते समय वह स्ट्रक्चर्ड गाइडेंस फ़ाइलों का सक्रिय रूप से इस्तेमाल करता है। ChatGPT का Browse मोड (जो लाइव वेब कंटेंट लाता है) अच्छा-ख़ासा सुधार दिखाता है, जबकि बेस GPT-4o मॉडल (जो मुख्य रूप से ट्रेनिंग डेटा पर निर्भर है) में सिर्फ़ एक फ़ाइल जोड़ने से बहुत मामूली बदलाव आता है।
Claude में दिखा मध्यम सुधार Anthropic के प्रकाशित तरीक़े से मेल खाता है: ClaudeBot गाइडेंस फ़ाइलों को क्रॉल करता है और उनका सम्मान करता है, लेकिन Claude के ट्रेनिंग डेटा का रिफ़्रेश साइकल Perplexity की रियल-टाइम रिट्रीवल से लंबा है। सुधार असली है, बस दिखने में वक़्त लगता है।
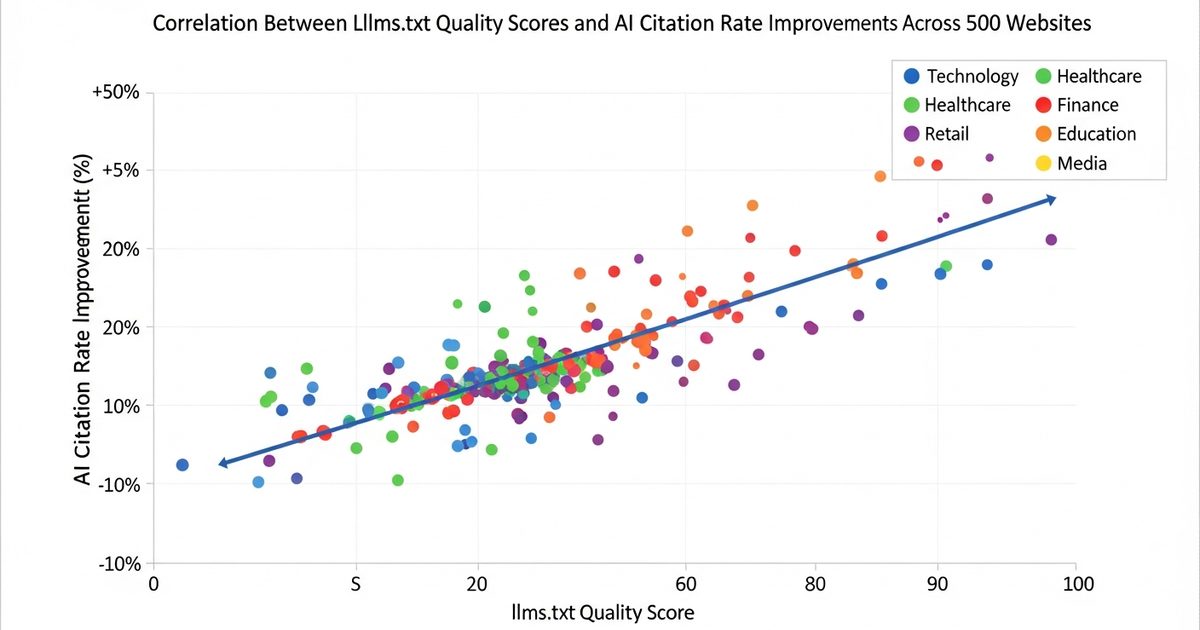
दूसरा अहम नतीजा: असली फ़र्क़ llms.txt समरी की क्वालिटी से पड़ता है
जिन साइट्स के साइटेशन में सबसे बड़ा सुधार हुआ (टॉप क्वार्टाइल, औसतन +31% साइटेशन रेट बढ़ोतरी), उनमें एक बात कॉमन थी: बेहद स्पेसिफ़िक समरी ब्लॉककोट्स, जो साफ़ बताते थे कि साइट किस बात में अलग है, किसके लिए है और किन विषयों को कवर करती है।
हमने हर साइट की llms.txt समरी को पाँच कसौटियों पर स्कोर किया:
- ऑडियंस कितनी स्पष्ट है (यह किसके लिए है?)
- अलग पहचान कितनी साफ़ है (इस साइट को ख़ास क्या बनाता है?)
- टॉपिक कवरेज कितना पूरा है (यह साइट किन विषयों को कवर करती है?)
- अथॉरिटी सिग्नल (भरोसे का कोई भी संकेत: डेटा, विशेषज्ञता, मेथडोलॉजी)
- एक्शन कॉन्टेक्स्ट (पाठक इस साइट से क्या कर सकते हैं?)
इस रूब्रिक पर 4-5 स्कोर करने वाली साइट्स में औसतन +27% साइटेशन सुधार दिखा। 1-2 स्कोर वाली साइट्स में औसत सिर्फ़ +6% रहा, जो नॉइज़ से बस ज़रा ऊपर है। फ़ाइल का फ़ॉर्मैट उतना मायने नहीं रखता जितना समरी सेक्शन के कंटेंट की क्वालिटी।
कम स्कोर और ज़्यादा स्कोर वाली समरी के उदाहरण:
कम स्कोर (5 में से 1 कसौटी पूरी):
"Example Corp व्यवसायों के लिए मार्केटिंग टूल्स और संसाधन उपलब्ध कराता है।"
ज़्यादा स्कोर (5 में से 5 कसौटियाँ पूरी):
"Example Corp एक B2B मार्केटिंग एट्रिब्यूशन प्लेटफ़ॉर्म है, जिसे 2,000+ मिड-मार्केट SaaS कंपनियाँ डार्क सोशल चैनलों (LinkedIn, पॉडकास्ट मेंशन, कम्युनिटी फ़ोरम) से आने वाले पाइपलाइन योगदान को ट्रैक करने के लिए इस्तेमाल करती हैं, जिसे सामान्य UTM-आधारित एट्रिब्यूशन पकड़ नहीं पाता। मुख्य इस्तेमाल: VP of Marketing का बोर्ड को ऐसी पाइपलाइन की रिपोर्ट देना जो ट्रैक नहीं हो पाती, और डिमांड जेन टीमों का डार्क सोशल पर हुए ख़र्च को सही ठहराना।"
ज़्यादा स्कोर वाला उदाहरण ऑडियंस (मिड-मार्केट SaaS कंपनियों के VP of Marketing और डिमांड जेन टीमें), अलग पहचान (डार्क सोशल एट्रिब्यूशन), अथॉरिटी (2,000+ कंपनियाँ) और एक्शन कॉन्टेक्स्ट (बोर्ड रिपोर्टिंग, ख़र्च को सही ठहराना) सब साफ़ बताता है। इसे पढ़ने वाला AI सिस्टम उस समय प्रोडक्ट के बारे में सटीक जानकारी दे सकता है, जब कोई यूज़र SaaS कंपनियों के लिए मार्केटिंग एट्रिब्यूशन टूल्स के बारे में पूछे।
तीसरा अहम नतीजा: पेज लिस्टिंग से लॉन्ग-टेल साइटेशन बढ़ते हैं
जिन साइट्स ने अपनी llms.txt में सिर्फ़ समरी सेक्शन नहीं, बल्कि विस्तृत पेज लिस्टिंग भी दी, उनमें लॉन्ग-टेल क्वेरीज़ पर अतिरिक्त साइटेशन सुधार दिखा। ये वे क्वेरीज़ हैं जो लिस्ट किए गए पेजों में कवर की गई किसी ख़ास फ़ीचर, इस्तेमाल या विषय के बारे में होती हैं।
यह असर उन पेजों पर सबसे ज़्यादा था जिन्हें अंदरूनी लिंक कम मिलते हैं। ऐसे "अनाथ लेकिन ज़रूरी" पेजों, जैसे टूल पेज, टेक्निकल डॉक्यूमेंटेशन और निश गाइड्स, के लिए llms.txt की पेज लिस्टिंग में होना ही वह मुख्य तरीक़ा था जिससे AI सिस्टम्स ने संबंधित क्वेरीज़ पर उन्हें साइट करना सीखा। लिस्टिंग के बिना ये पेज, क़ीमती कंटेंट होने के बावजूद, AI साइटेशन की नज़र से लगभग ग़ायब ही रहे।
15+ अच्छी तरह से बताई गई पेज लिस्टिंग वाली साइट्स में लॉन्ग-टेल क्वेरीज़ पर +22% साइटेशन सुधार दिखा, जबकि बिना पेज लिस्टिंग या बिना विवरण वाली छोटी लिस्टिंग वाली साइट्स में यह +9% रहा।
चौथा अहम नतीजा: सिर्फ़ llms.txt काफ़ी नहीं है
सबसे अहम नकारात्मक नतीजा: जिन साइट्स का robots.txt AI क्रॉलर्स को ब्लॉक कर रहा था, उनमें llms.txt जोड़ने के बाद साइटेशन में ज़ीरो सुधार हुआ। यह अपेक्षित था, फिर भी साफ़ कहना ज़रूरी है: अगर AI क्रॉलर्स आपकी साइट तक पहुँच ही नहीं सकते, तो llms.txt कोई मदद नहीं कर सकता। यह फ़ाइल उन क्रॉलर्स को गाइड करती है जिन्हें पहले से अंदर आने की इजाज़त है; यह एक्सेस पर लगी पाबंदियों को ओवरराइड नहीं करती।
इसी तरह, कमज़ोर या कम क्वालिटी वाले कंटेंट वाली साइट्स में मज़बूत llms.txt फ़ाइल के बावजूद बहुत मामूली सुधार दिखा। सिर्फ़ इसलिए कि कोई फ़ाइल कहती है कि कंटेंट ज़रूरी है, AI सिस्टम्स ख़राब कंटेंट को ज़्यादा साइट नहीं करते। यह फ़ाइल बेहतर बनाती है कि AI सिस्टम्स आपकी साइट को कैसे समझते और उसमें कैसे नेविगेट करते हैं; लेकिन मूल कंटेंट का साइट किए जाने लायक़ होना अब भी ज़रूरी है।
AI साइटेशन किन चीज़ों से मिलते हैं, इसकी पूरी तस्वीर के लिए हमारी AI सर्च ऑप्टिमाइज़ेशन गाइड देखें। llms.txt कई सिग्नल्स में से एक है जो मिलकर काम करते हैं, यह अपने आप में पूरा समाधान नहीं है।
इंडस्ट्री के हिसाब से: llms.txt से सबसे ज़्यादा फ़ायदा किसे होता है
llms.txt से मिलने वाला साइटेशन सुधार इंडस्ट्री के हिसाब से काफ़ी अलग-अलग रहा:
सबसे ज़्यादा फ़ायदा (औसतन +20-35% सुधार)
- SaaS और टेक्नोलॉजी: AI सिस्टम्स अक्सर सॉफ़्टवेयर प्रोडक्ट्स को ग़लत कैटेगरी में डाल देते हैं या उनका ग़लत वर्णन करते हैं। स्पेसिफ़िक llms.txt समरी इन ग़लतफ़हमियों को असरदार तरीक़े से ठीक करती है।
- फ़ाइनेंशियल सर्विसेज़: साफ़ अथॉरिटी सिग्नल के बिना AI सिस्टम्स फ़ाइनेंशियल कंटेंट को साइट करने में सावधानी बरतते हैं। जिस llms.txt में रेगुलेटरी क्रेडेंशियल्स, मेथडोलॉजी का विवरण या प्रोफ़ेशनल योग्यताएँ शामिल हों, वह साइटेशन रेट को साफ़ तौर पर बढ़ाती है।
- हेल्थकेयर और मेडिकल: यहाँ भी फ़ाइनेंशियल सर्विसेज़ जैसा ही हाल है: असली विशेषज्ञता वाली हेल्थ इन्फ़ॉर्मेशन साइट्स के लिए समरी में दिए गए अथॉरिटी सिग्नल साइटेशन रेट में ज़बरदस्त सुधार लाते हैं।
मध्यम फ़ायदा (औसतन +8-18% सुधार)
- B2B सर्विसेज़: जिन जटिल सर्विसेज़ को सिर्फ़ कंटेंट से वर्गीकृत करना मुश्किल होता है, उन्हें साफ़ विवरण से फ़ायदा मिलता है, लेकिन सुधार मध्यम रहता है।
- एजुकेशन: टॉपिक कवरेज का साफ़ विवरण AI सिस्टम्स को एजुकेशनल कंटेंट को ख़ास लर्निंग क्वेरीज़ से जोड़ने में मदद करता है।
- पब्लिशिंग और न्यूज़: इन्हें मुख्य रूप से कंटेंट फ़्रेशनेस गाइडेंस से फ़ायदा होता है (यानी यह बताना कि कौन-से सेक्शन बार-बार अपडेट होते हैं), न कि ख़ुद समरी से।
कम फ़ायदा (औसतन +3-8% सुधार)
- ई-कॉमर्स: AI सिस्टम्स स्ट्रक्चर्ड डेटा (Product schema) की मदद से प्रोडक्ट पेजों को पहले से अच्छी तरह समझते हैं। जब schema पूरा हो, तो llms.txt से अतिरिक्त फ़ायदा कम मिलता है।
- लोकल सर्विसेज़: लोकल सर्विसेज़ के साइटेशन पैटर्न पर llms.txt गाइडेंस से ज़्यादा असर रिव्यूज़ की मौजूदगी और NAP कंसिस्टेंसी (नाम, पता, फ़ोन नंबर का हर जगह एक जैसा होना) का होता है।
संदेह करने वालों की बातें, जो सही निकलीं
हमारा डेटा llms.txt को लेकर कुछ संदेह भरे दावों का समर्थन करता है:
यह साइटेशन की गारंटी नहीं है। टॉप क्वार्टाइल की साइट्स में भी +31% सुधार दिखा, और वह भी एक बेसलाइन से शुरू होकर। 10% साइटेशन रेट वाली साइट्स ~13% तक पहुँचीं। यह कोई कायापलट नहीं है, लेकिन समय के साथ जुड़ता जाने वाला एक ठोस सुधार ज़रूर है।
कंटेंट सुधार ज़्यादा मायने रखते हैं। हमने उन साइट्स की तुलना की जिन्होंने सिर्फ़ llms.txt जोड़ी, उन साइट्स से जिन्होंने साथ-साथ कंटेंट क्वालिटी भी सुधारी (बेहतर FAQ जवाब, ज़्यादा स्पेसिफ़िक स्ट्रक्चर्ड डेटा)। कंटेंट सुधारने वाले ग्रुप में साइटेशन सुधार, सिर्फ़ llms.txt वाले ग्रुप के मुक़ाबले 2.4 गुना रहा। llms.txt अच्छे कंटेंट का असर बढ़ाती है, उसकी जगह नहीं लेती।
हर LLM एक जैसा रिस्पॉन्ड नहीं करता। ChatGPT के बेस मॉडल (Browse के बिना) पर असर छोटा है। अगर आपकी टारगेट क्वेरीज़ ज़्यादातर ऐसे मॉडल्स संभालते हैं जो रियल-टाइम रिट्रीवल के बजाय ट्रेनिंग डेटा पर निर्भर हैं, तो llms.txt से सुधार धीमा होगा और उसे मापना भी मुश्किल होगा।
हमारी सलाह
डेटा के आधार पर हमारी सलाह यह है:
- अगर अभी तक नहीं किया है, तो llms.txt लागू करें: संभावित फ़ायदा असली है, इसे लागू करने की लागत कम है (एक अच्छी क्वालिटी की फ़ाइल के लिए 30-60 मिनट), और इसका कोई नुक़सान नहीं है
- समरी की क्वालिटी को प्राथमिकता दें: साइटेशन सुधार का 70% हिस्सा यहीं से आता है; अपना समय एक स्पेसिफ़िक, ऑडियंस पर केंद्रित और अलग पहचान बताने वाले विवरण पर लगाएँ
- अपने अहम लेकिन कम लिंक वाले पेज लिस्ट करें: ख़ासकर टूल पेज, डॉक्यूमेंटेशन और टॉपिक-स्पेसिफ़िक गाइड्स, जिन्हें अंदरूनी लिंक कम मिलते हैं
- अगर AI क्रॉलर्स ब्लॉक हैं, तो पहले robots.txt ठीक करें: ब्लॉक की गई साइट पर llms.txt कुछ नहीं करती
- इसे कंटेंट और schema सुधारों के साथ जोड़ें: llms.txt पूरी AEO स्ट्रैटेजी का हिस्सा बनकर सबसे असरदार होती है, अकेले फ़िक्स के तौर पर नहीं
अपनी फ़ाइल बनाने के लिए AI Rank Lab का फ़्री llms.txt जनरेटर इस्तेमाल करें, और यह जाँचने के लिए फ़ुल ऑडिट टूल चलाएँ कि आपकी मौजूदा llms.txt सही फ़ॉर्मैट में है या नहीं और आपके दूसरे AEO सिग्नल्स के साथ काम कर रही है या नहीं।
निष्कर्ष
llms.txt का AI साइटेशन रेट पर असली और मापने लायक़ असर होता है, ख़ासकर Perplexity और ChatGPT Browse पर, ख़ासकर उन साइट्स के लिए जिनके प्रोडक्ट/सर्विसेज़ जटिल हैं या आसानी से ग़लत कैटेगरी में चले जाते हैं, और ख़ासकर तब जब समरी स्पेसिफ़िक और अलग पहचान वाली हो। यह फ़ाइल कोई जादू नहीं है: यह ख़राब कंटेंट को साइट किए जाने लायक़ नहीं बना सकती और ब्लॉक किए गए क्रॉलर्स की पाबंदी नहीं हटा सकती। लेकिन पूरी AEO स्ट्रैटेजी के एक हिस्से के तौर पर, यह अपने 30 मिनट के इंप्लीमेंटेशन निवेश की पूरी क़ीमत वसूल करती है।
सबसे अहम सबक़: आपकी llms.txt समरी की क्वालिटी, फ़ाइल के होने भर से कहीं ज़्यादा मायने रखती है। दो लाइन का घिसा-पिटा विवरण बहुत कम फ़ायदा देता है। अथॉरिटी सिग्नल और साफ़ अलग पहचान वाली, ऑडियंस पर केंद्रित स्पेसिफ़िक समरी उन सभी LLMs पर साइटेशन में ठोस सुधार लाती है जो इसे सपोर्ट करते हैं।
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


