



2026년, robots.txt가 그 어느 때보다 중요한 이유
robots.txt 파일은 1994년에 웹 크롤러가 피해야 할 페이지를 알려 주려고 만들어졌어요. 그 뒤 30년 동안 웹마스터가 신경 쓸 주요 크롤러는 사실상 Googlebot 하나였죠. 그런데 2026년에는 그 목록이 크게 늘었어요. OpenAI, Anthropic, Perplexity, Google 같은 AI 기업들이 모두 전용 크롤러를 운영하면서, 여러분의 콘텐츠를 읽어 모델을 학습시키고 지식 베이스를 만들고 AI 검색 답변을 생성하고 있거든요.
이 크롤러들을 허용하느냐 차단하느냐는 AI 검색 노출에 직접적인 영향을 줘요. GPTBot이 사이트를 크롤링하지 못하면 여러분의 콘텐츠는 ChatGPT 답변에 반영되지 않아요. PerplexityBot을 차단하면 Perplexity가 여러분의 페이지를 인용할 수 없고요. Google-Extended가 차단돼 있다면 콘텐츠가 Google의 AI Overviews(AI 개요)나 AI Mode 답변에 나오지 않을 수도 있어요.
AI 크롤러 시대에 robots.txt를 제대로 설정하려면 어떤 봇이 있는지, 각각 무엇을 하는지, 그리고 콘텐츠를 보호하면서도 AI 인용 가능성을 최대로 끌어올리도록 접근 권한을 어떻게 구성할지 알아야 해요. 이 가이드에서 그 전부를 다루고, 몇 분 만에 AI 대응 설정을 만들 수 있는 무료 robots.txt 생성기도 소개할게요.
AI 크롤러 총정리
설정을 시작하기 전에 어떤 봇을 다뤄야 하는지부터 알아야겠죠. 2026년 기준 주요 AI 크롤러와 user agent는 다음과 같아요.
OpenAI - ChatGPT
- User-agent: GPTBot
- 용도: 학습 데이터 수집 및 ChatGPT Browse 기능
- 차단 시 영향: 콘텐츠가 ChatGPT 답변에 반영되지 않고, ChatGPT Browse 인용에도 나오지 않아요
- 문서: OpenAI는 GPTBot IP 대역 목록을 공개하고 있어요
Anthropic - Claude
- User-agent: ClaudeBot (anthropic-ai로도 식별돼요)
- 용도: Claude AI의 학습 데이터와 지식 베이스
- 차단 시 영향: 사용자가 여러분의 분야에 대해 물어볼 때 콘텐츠가 Claude 답변에 반영되지 않아요
- 문서: Anthropic은 크롤링 정책을 공개했고 robots.txt 지시를 준수해요
Perplexity AI
- User-agent: PerplexityBot
- 용도: Perplexity AI 답변과 인용을 위한 실시간 웹 검색
- 차단 시 영향: 관련성이 아주 높더라도 페이지가 Perplexity 답변에 인용되지 않아요
- 문서: Perplexity는 robots.txt를 준수하며 크롤링 가이드라인을 공개했어요
Google - AI 기능
- User-agent: Google-Extended
- 용도: Google Bard/Gemini 학습 및 AI Overviews 콘텐츠
- 차단 시 영향: 콘텐츠가 Google의 AI Overviews, AI Mode, Gemini 답변에 나오지 않을 수 있어요
- 참고: Googlebot과는 별개예요. Googlebot(기존 검색)은 허용하면서 Google-Extended(AI 기능)만 차단할 수도 있어요
Microsoft - Copilot
- User-agent: Bingbot(공용), Copilot 전용 크롤러는 경우에 따라 달라요
- 용도: Microsoft Copilot과 Bing AI 답변
- 차단 시 영향: Microsoft Copilot과 Bing AI 기능에서 노출이 줄어요
Meta - Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- 용도: Meta AI와 Llama 모델의 학습 데이터
- 차단 시 영향: 콘텐츠가 Meta AI 답변에 반영되지 않아요
Apple - Applebot
- User-agent: Applebot, Applebot-Extended
- 용도: Siri, Apple Intelligence, Apple 검색 기능
- 차단 시 영향: Siri와 Apple AI 기능에서 노출이 줄어요
문제는 대부분의 robots.txt가 AI 크롤러 등장 전에 작성됐다는 점이에요
2020~2023년에 만들어진 전형적인 robots.txt는 이렇게 생겼어요.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
이 설정은 Googlebot은 허용하지만, 나머지 봇은 모두 와일드카드 규칙에 맡겨요. 해석에 따라 이 와일드카드 규칙이 AI 크롤러를 사이트 일부 영역에서 막고 있을 수도 있고, 반대로 보호하고 싶은 페이지까지 포함해 모든 곳을 열어 두고 있을 수도 있어요.
더 큰 문제도 있어요. AI 학습 데이터 사용에 대한 퍼블리셔들의 반발이 정점이던 AI 크롤러 초기(2022~2023년)에 강하게 차단을 걸어 둔 사이트들이 있거든요. 모든 봇에 Disallow: /를 추가했다면, AI 크롤러를 막아 놓고 잊어버렸을 가능성이 있어요. 그 결과는 AI 검색 답변에서 브랜드가 잘 안 보인다는 걸 알아챈 뒤에야 드러나죠.
AI Rank Lab의 AI 봇 트래킹 기능을 쓰면 실제로 어떤 AI 봇이 페이지를 방문하는지, 어떤 AI 어시스턴트가 추천 트래픽을 보내는지 로그를 직접 분석하지 않고도 확인할 수 있어요. 허용하려던 크롤러가 한 번도 나타나지 않는다면 robots.txt에서 해당 규칙을 확인해 보세요.
상황별 robots.txt 템플릿
무료 robots.txt 생성기로 아래 템플릿을 사이트에 맞게 수정해 보세요. 가장 많이 쓰는 설정은 다음과 같아요.
템플릿 1: AI 전면 허용 (대부분의 사이트에 추천)
모든 AI 크롤러가 콘텐츠에 접근하도록 허용해요. AI 검색 노출을 최대한 끌어올리고 싶고, 콘텐츠가 AI 모델 학습에 쓰여도 괜찮은 사이트에 가장 잘 맞아요.
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
템플릿 2: AI 선택적 허용 (콘텐츠 보호)
공개 콘텐츠 페이지는 AI 크롤러에 열어 두고, 프리미엄 콘텐츠와 유료 기사, 회원 전용 영역은 막아요. 구독형 퍼블리셔나 접근 제한 콘텐츠가 있는 사이트에 적합해요.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
템플릿 3: AI 학습은 차단, AI 검색은 허용
조금 더 섬세한 설정이에요. 실시간 인용에 콘텐츠를 쓰는 Perplexity는 허용하고, 모델 학습에 콘텐츠를 쓰는 학습용 크롤러는 차단해요. AI 검색 인용은 원하지만 모델 학습에 쓰이는 건 반대하는 퍼블리셔들이 흔히 택하는 절충안이에요.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml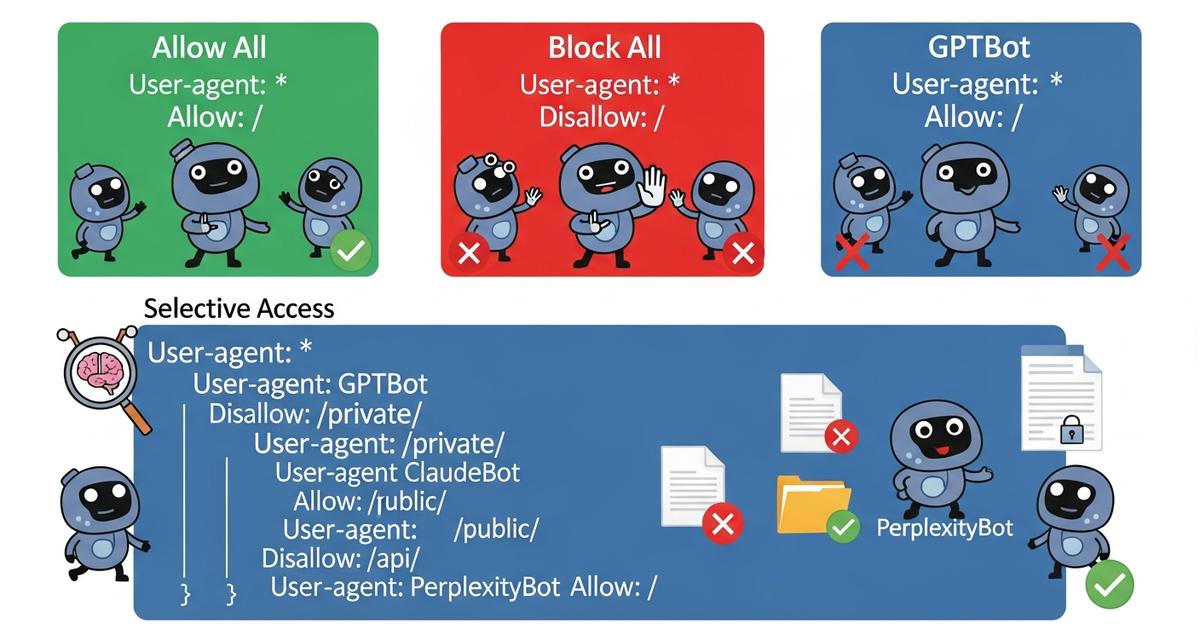
우리 사이트에는 어떤 설정이 맞을까요?
알맞은 robots.txt 설정은 콘텐츠 유형, 비즈니스 모델, AI 검색 노출 목표에 따라 달라요. 다음 기준으로 판단해 보세요.
이런 경우엔 모든 AI 크롤러를 허용하세요
- 누구나 볼 수 있는 콘텐츠(블로그, 문서, 자료)를 발행하는 사이트
- AI 검색 노출을 최대로 원하고, 인용이 트래픽 유입 경로인 경우
- 보호가 필요한 접근 제한 콘텐츠나 프리미엄 콘텐츠가 없는 경우
- 정보성 콘텐츠라서 널리 퍼질수록 이득인 경우
이런 경우엔 선택적으로 허용하세요
- 무료 콘텐츠와 프리미엄 콘텐츠가 섞여 있는 경우
- 인용되면 안 되는 페이지(계정 페이지, 결제 흐름, 회원 전용 콘텐츠)가 있는 경우
- AI 크롤러가 전부 다 크롤링하기보다 가장 좋은 콘텐츠에 집중하길 원하는 경우
이런 경우엔 학습용 크롤러만 차단하세요 (검색만 허용)
- AI 학습 데이터 사용이 걱정되는 퍼블리셔인 경우
- 그래도 Perplexity와 Google AI Overviews(실시간 인용)에는 나오고 싶은 경우
- 콘텐츠를 AI 기업에 별도로 라이선스할 여지를 남겨 두고 싶은 경우
이런 경우에만 모든 AI 크롤러를 차단하세요
- 콘텐츠를 AI 시스템에서 제외해야 할 명확한 법적·경쟁상 이유가 있는 경우
- 특정 AI 기업과 라이선스 계약을 맺어 독점권을 지켜야 하는 경우
- 그 대가로 도메인의 AI 검색 노출이 0이 된다는 점을 이해하고 있는 경우
피해야 할 흔한 실수
실수 1: 정체 모를 봇을 와일드카드로 막아 버리기
User-agent: * / Disallow: / 뒤에 Googlebot용 허용 규칙만 따로 둔 설정은 모든 AI 크롤러를 차단해요. AI 크롤러에는 명시적인 허용 규칙이 없기 때문이에요. AI 크롤러의 접근 권한은 항상 명시적으로 적어 주세요.
실수 2: 현재 설정이 어떤지 모르기
robots.txt가 지금 AI 크롤러에 대해 어떻게 돼 있는지 모르는 팀이 많아요. 지금 바로 yoursite.com/robots.txt에서 확인해 보세요. AI Rank Lab의 도구도 도움이 돼요. 무료 사이트 감사에서 robots.txt가 있는지, 접근 가능한지 확인해 줘요.
실수 3: Googlebot과 Google-Extended를 헷갈리기
Googlebot을 허용한다고 해서 Google-Extended(AI 기능용 크롤러)까지 자동으로 허용되지는 않아요. Google AI Overviews와 AI Mode에 나오고 싶다면 Google-Extended를 허용하는 규칙을 따로 명시해야 해요.
실수 4: 변경 후 테스트하지 않기
robots.txt를 수정했다면 실제 파일을 확인하고 robots.txt 테스트 도구를 써서 변경 사항이 반영됐는지 검증하세요. Google Search Console에는 Googlebot용 robots.txt 테스터가 내장돼 있지만, AI 크롤러 규칙은 직접 확인해야 해요.
실수 5: 한 번 설정하고 잊어버리기
새로운 AI 크롤러는 계속 등장해요. 2023년의 AI user agent 목록은 2026년인 지금 이미 불완전해요. 최소 분기마다 robots.txt를 점검하고, 주요 AI 기업이 새 크롤러 문서를 냈는지 확인하세요.
robots.txt 그 너머: AI 크롤러 제어 도구 총정리
robots.txt는 AI 크롤러 접근을 제어하는 가장 중요한 수단이지만 유일한 수단은 아니에요. 완전한 AEO 기술 설정에는 다음이 포함돼요.
- robots.txt: 크롤러 접근 규칙(위에서 다룬 내용)
- llms.txt: 사이트가 무엇을 다루고 콘텐츠를 어떻게 써야 하는지 LLM에 알려 주는 안내 파일. robots.txt를 대체하는 게 아니라 보완해요
- noindex 메타 태그: 특정 페이지가 색인되지 않도록 막는 페이지 단위 제어. 일부 AI 크롤러가 준수해요
- AI 봇 모니터링: 어떤 크롤러가 얼마나 자주 사이트에 접근하는지 추적해요. AI Rank Lab의 봇 트래킹 기능으로 로그 분석 없이 확인할 수 있어요
무료 robots.txt 생성기를 써 보세요
robots.txt를 처음부터 직접 쓰는 대신 AI Rank Lab의 무료 robots.txt 생성기를 써 보세요. 설정 유형(전면 허용, 선택적 허용, 학습 차단, 사용자 지정)을 고르고 보호할 경로를 지정하면, 현재의 AI 크롤러 user agent가 모두 포함된 올바른 형식의 파일을 만들어 줘요. 결과를 그대로 복사해 서버에 붙여 넣거나 파일로 내려받으면 돼요.
생성기는 새로운 AI 크롤러 user agent가 나올 때마다 업데이트돼요. 그래서 이 글을 쓸 때는 없던 봇까지 반영된 설정을 받을 수 있어요.
마무리
robots.txt는 AI 검색 노출을 직접 조종하는 제어판이에요. 제대로 설정하면 AI 크롤러가 콘텐츠에 접근해 학습할 수 있고, 이는 ChatGPT, Perplexity, Claude, Gemini 답변 속 인용으로 이어져요. 반대로 잘못 설정하거나 오래된 파일을 그대로 두면, 점점 더 많은 발견이 일어나는 AI 엔진과 여러분의 콘텐츠 사이에 보이지 않는 벽이 생겨요.
지금의 robots.txt를 확인하고 무료 생성기로 AI 대응 설정을 만드는 데 드는 시간은 5분이에요. AI 검색 노출을 위해 할 수 있는 기술 작업 중 가장 효과가 큰 일 중 하나죠. 오늘 바로 해 두고, 새로운 AI 크롤러가 생태계에 들어오는 만큼 분기마다 점검하도록 알림을 설정해 두세요.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


