



Perché nel 2026 il robots.txt conta più che mai
Il file robots.txt è nato nel 1994 con uno scopo semplice: dire ai crawler quali pagine evitare. Per 30 anni i webmaster hanno dovuto preoccuparsi praticamente di una sola grande famiglia di crawler, quella di Googlebot. Nel 2026 la lista si è allungata parecchio. Le aziende dell'IA (OpenAI, Anthropic, Perplexity, Google) hanno tutte crawler dedicati che leggono i tuoi contenuti per addestrare i modelli, costruire basi di conoscenza e generare le risposte della ricerca IA.
Consentire o bloccare questi crawler ha conseguenze dirette sulla tua visibilità nella ricerca IA. Se GPTBot non può scansionare il tuo sito, i tuoi contenuti non entrano nelle risposte di ChatGPT. Se blocchi PerplexityBot, Perplexity non può citare le tue pagine. E se Google-Extended è bloccato, i tuoi contenuti potrebbero non comparire nelle AI Overviews (le panoramiche generate dall'IA di Google) né nelle risposte di AI Mode.
Impostare bene il robots.txt nell'era dei crawler IA vuol dire sapere quali bot esistono, cosa fanno e come configurarne l'accesso in modo da proteggere i contenuti e, allo stesso tempo, massimizzare le possibilità di essere citati dall'IA. Questa guida copre tutto, compreso un generatore di robots.txt gratuito con cui creare in pochi minuti una configurazione pronta per l'IA.
L'elenco completo dei crawler IA
Prima di configurare qualsiasi cosa, devi sapere a quali bot rivolgerti. Ecco i principali crawler IA e i relativi user agent aggiornati al 2026:
OpenAI - ChatGPT
- User-agent: GPTBot
- A cosa serve: raccolta di dati di addestramento e funzione Browse di ChatGPT
- Se lo blocchi: i tuoi contenuti non entreranno nelle risposte di ChatGPT né compariranno tra le citazioni di ChatGPT Browse
- Documentazione: OpenAI pubblica un elenco aggiornato degli intervalli IP di GPTBot
Anthropic - Claude
- User-agent: ClaudeBot (identificato anche come anthropic-ai)
- A cosa serve: dati di addestramento e base di conoscenza per Claude AI
- Se lo blocchi: i tuoi contenuti non entrano nelle risposte di Claude quando gli utenti chiedono informazioni sul tuo settore
- Documentazione: Anthropic ha pubblicato la propria policy di crawling e rispetta le direttive del robots.txt
Perplexity AI
- User-agent: PerplexityBot
- A cosa serve: ricerca web in tempo reale per le risposte e le citazioni di Perplexity AI
- Se lo blocchi: le tue pagine non verranno citate nelle risposte di Perplexity, nemmeno quando sono molto pertinenti
- Documentazione: Perplexity rispetta il robots.txt e ha pubblicato le sue linee guida sul crawling
Google - Funzioni IA
- User-agent: Google-Extended
- A cosa serve: addestramento di Google Bard/Gemini e contenuti per le AI Overviews
- Se lo blocchi: i tuoi contenuti potrebbero non comparire nelle AI Overviews, in AI Mode o nelle risposte di Gemini
- Nota: è un crawler separato da Googlebot. Puoi consentire Googlebot (ricerca tradizionale) e bloccare Google-Extended (funzioni IA)
Microsoft - Copilot
- User-agent: Bingbot (condiviso); i crawler specifici di Copilot variano
- A cosa serve: alimenta Microsoft Copilot e le risposte IA di Bing
- Se lo blocchi: meno visibilità in Microsoft Copilot e nelle funzioni IA di Bing
Meta - Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- A cosa serve: dati di addestramento per Meta AI e per i modelli Llama
- Se lo blocchi: i tuoi contenuti non entrano nelle risposte di Meta AI
Apple - Applebot
- User-agent: Applebot, Applebot-Extended
- A cosa serve: Siri, Apple Intelligence e le funzioni di ricerca di Apple
- Se lo blocchi: meno visibilità in Siri e nelle funzioni IA di Apple
Il problema: quasi tutti i robots.txt sono stati scritti prima dei crawler IA
Un tipico robots.txt del periodo 2020-2023 ha più o meno questo aspetto:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Questa configurazione consente Googlebot, ma per tutti gli altri bot si affida alla regola jolly. A seconda di come viene interpretata, quella regola potrebbe tenere i crawler IA fuori da intere sezioni del sito, oppure lasciarli entrare ovunque, comprese le pagine che preferiresti proteggere.
C'è di peggio: nella prima fase dei crawler IA (2022-2023), quando la protesta degli editori contro l'uso dei loro contenuti per l'addestramento era al culmine, molti siti hanno introdotto blocchi aggressivi. Se il tuo sito ha aggiunto Disallow: / per tutti i bot, potresti aver chiuso fuori i crawler IA e poi esserti dimenticato di averlo fatto. Le conseguenze diventano evidenti solo quando ti accorgi che il tuo brand è poco presente nelle risposte della ricerca IA.
La funzione di monitoraggio dei bot IA di AI Rank Lab ti mostra quali bot IA visitano davvero le tue pagine e quali assistenti IA ti portano traffico di referral, senza bisogno di analizzare i log a mano. Se un crawler che volevi consentire non si fa mai vedere, controlla le sue regole nel robots.txt.
Template di robots.txt per ogni scenario
Usa il nostro generatore di robots.txt gratuito per adattare questi template al tuo sito. Ecco le configurazioni più comuni:
Template 1: accesso IA completo (consigliato per la maggior parte dei siti)
Consente a tutti i crawler IA di accedere ai tuoi contenuti. È la scelta giusta per i siti che puntano alla massima visibilità nella ricerca IA e non hanno problemi a far contribuire i propri contenuti all'addestramento dei modelli.
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Template 2: accesso IA selettivo (protezione dei contenuti)
Consente ai crawler IA di accedere alle pagine pubbliche, ma blocca contenuti premium, articoli a pagamento e aree riservate agli iscritti. Ideale per gli editori in abbonamento e per i siti con contenuti protetti.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Template 3: blocca l'addestramento IA, consenti la ricerca IA
Una configurazione più sfumata: consenti Perplexity (che usa i tuoi contenuti per le citazioni in tempo reale) e blocchi i crawler di addestramento (che li usano per allenare i modelli). È una via di mezzo molto diffusa tra gli editori che vogliono le citazioni nella ricerca IA ma non accettano l'uso dei propri contenuti per l'addestramento.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml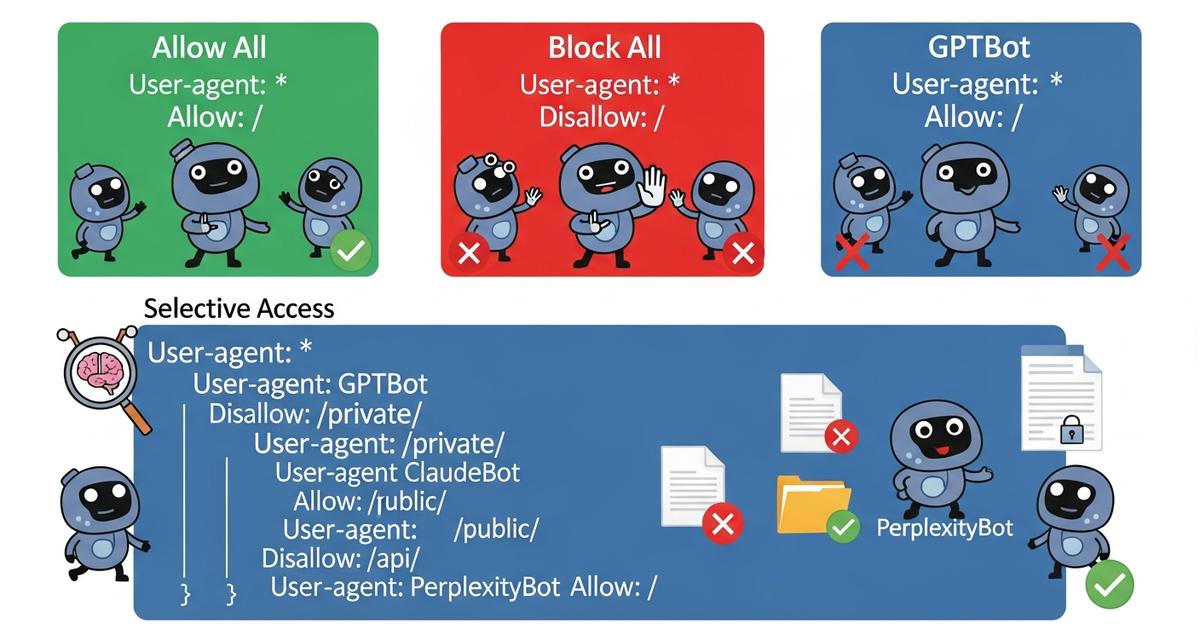
Come scegliere la configurazione giusta per te
La configurazione giusta dipende dal tipo di contenuti, dal modello di business e dagli obiettivi di visibilità nella ricerca IA. Per decidere, segui questo schema:
Consenti tutti i crawler IA se:
- il tuo sito pubblica contenuti liberamente accessibili (blog, documentazione, risorse)
- vuoi la massima visibilità nella ricerca IA e le citazioni sono per te una fonte di traffico
- non hai contenuti riservati o premium da proteggere
- i tuoi contenuti sono informativi e traggono vantaggio da un'ampia diffusione
Scegli l'accesso selettivo se:
- hai un mix di contenuti gratuiti e premium
- alcune pagine non dovrebbero essere citate (pagine account, processi di checkout, contenuti riservati agli iscritti)
- vuoi che i crawler IA si concentrino sui tuoi contenuti migliori invece di scansionare tutto
Blocca i crawler di addestramento (e consenti solo la ricerca) se:
- sei un editore e l'uso dei tuoi contenuti per l'addestramento IA ti preoccupa
- vuoi comunque comparire su Perplexity e nelle AI Overviews di Google (citazioni in tempo reale)
- vuoi tenerti la possibilità di concedere in licenza i tuoi contenuti alle aziende IA separatamente
Blocca tutti i crawler IA solo se:
- hai motivi legali o competitivi espliciti per tenere i contenuti fuori dai sistemi IA
- hai un accordo di licenza con aziende IA specifiche e vuoi farne rispettare l'esclusiva
- hai chiaro il prezzo da pagare: zero visibilità nella ricerca IA per il tuo dominio
Gli errori più comuni da evitare
Errore 1: usare un blocco jolly per i bot sconosciuti
Configurazioni come User-agent: * / Disallow: / seguite da regole di allow specifiche per Googlebot bloccano tutti i crawler IA, perché per loro non esiste una regola di allow esplicita. Indica sempre in modo esplicito l'accesso dei crawler IA.
Errore 2: non sapere cosa dice oggi il tuo robots.txt
Molti team non sanno cosa preveda il loro robots.txt per i crawler IA. Controllalo subito su yoursite.com/robots.txt. Anche gli strumenti di AI Rank Lab possono darti una mano: l'audit gratuito del sito verifica che il robots.txt sia presente e raggiungibile.
Errore 3: confondere Googlebot con Google-Extended
Consentire Googlebot non consente automaticamente Google-Extended (il crawler delle funzioni IA). Se vuoi comparire nelle AI Overviews e in AI Mode di Google, ti serve una regola esplicita che consenta Google-Extended.
Errore 4: non fare test dopo le modifiche
Dopo aver aggiornato il robots.txt, verifica che le modifiche siano attive controllando il file online e usando uno strumento di test per robots.txt. Google Search Console ha un tester del robots.txt integrato per Googlebot, ma le regole per i crawler IA dovrai verificarle a mano.
Errore 5: impostarlo e non pensarci più
Nuovi crawler IA spuntano di continuo: l'elenco degli user agent IA del 2023 nel 2026 è già incompleto. Rivedi il robots.txt almeno una volta a trimestre e tieni d'occhio la documentazione sui nuovi crawler pubblicata dalle principali aziende IA.
Oltre il robots.txt: tutti gli strumenti per controllare i crawler IA
Il robots.txt è la leva più importante per gestire l'accesso dei crawler IA, ma non è l'unica. Un setup tecnico AEO completo comprende:
- robots.txt: le regole di accesso per i crawler (viste sopra)
- llms.txt: un file di indicazioni per gli LLM su cosa tratta il tuo sito e su come usarne i contenuti; affianca il robots.txt, non lo sostituisce
- meta tag noindex: un controllo a livello di pagina che impedisce l'indicizzazione di pagine specifiche, rispettato da alcuni crawler IA
- Monitoraggio dei bot IA: sapere quali crawler accedono al tuo sito e con quale frequenza; la funzione di monitoraggio dei bot di AI Rank Lab ti dà questa visibilità senza dover analizzare i log
Usa il generatore di robots.txt gratuito
Invece di scrivere il robots.txt da zero, usa il generatore di robots.txt gratuito di AI Rank Lab. Scegli il tipo di configurazione (accesso completo, selettivo, blocco dell'addestramento o personalizzata), indica i percorsi da proteggere e il tool genererà un file formattato correttamente con tutti gli user agent dei crawler IA attuali. Puoi copiare il risultato direttamente sul tuo server o scaricarlo come file.
Il generatore viene aggiornato man mano che escono nuovi user agent di crawler IA: così ottieni una configurazione che tiene conto anche dei bot che non esistevano quando è stato scritto questo articolo.
Conclusione
Il robots.txt è un vero e proprio pannello di controllo della tua visibilità nella ricerca IA. Se lo imposti bene, i crawler IA possono accedere ai tuoi contenuti e imparare da essi, e questo si traduce in citazioni nelle risposte di ChatGPT, Perplexity, Claude e Gemini. Se lo sbagli, o lasci al suo posto un file ormai datato, crei barriere invisibili tra i tuoi contenuti e i motori IA che contano sempre di più nel modo in cui le persone scoprono le informazioni.
Cinque minuti per controllare il robots.txt attuale e creare con il generatore gratuito una configurazione pronta per l'IA: è una delle azioni tecniche con il miglior rapporto sforzo/risultato che puoi fare per la tua visibilità nella ricerca IA. Fallo oggi, poi imposta un promemoria per rivederlo ogni trimestre, man mano che nuovi crawler IA entrano in gioco.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


