



Por que o robots.txt importa mais do que nunca em 2026
O arquivo robots.txt nasceu em 1994 com uma missão simples: avisar aos crawlers quais páginas eles deveriam evitar. Durante 30 anos, quem cuidava de site só precisava se preocupar com uma grande família de robôs: o Googlebot. Em 2026, essa lista cresceu muito. Empresas de IA como OpenAI, Anthropic, Perplexity e Google mantêm crawlers próprios que leem o seu conteúdo para treinar modelos, montar bases de conhecimento e gerar respostas na busca com IA.
Liberar ou bloquear esses robôs tem impacto direto na sua visibilidade na busca com IA. Se o GPTBot não consegue rastrear o seu site, o seu conteúdo não alimenta as respostas do ChatGPT. Se você bloqueia o PerplexityBot, o Perplexity não pode citar as suas páginas. E, com o Google-Extended bloqueado, o seu conteúdo pode ficar de fora das AI Overviews (os resumos gerados por IA do Google) e das respostas do AI Mode.
Acertar o robots.txt na era dos crawlers de IA exige saber quais bots existem, o que cada um faz e como configurar o acesso de um jeito que proteja o seu conteúdo e, ao mesmo tempo, aumente as chances de citação pelas IAs. Este guia cobre tudo isso, inclusive um gerador de robots.txt gratuito para você criar uma configuração pronta para IA em poucos minutos.
Guia completo dos crawlers de IA
Antes de configurar qualquer coisa, você precisa saber com quais bots está lidando. Estes são os principais crawlers de IA e os seus user agents em 2026:
OpenAI - ChatGPT
- User-agent: GPTBot
- Função: coleta de dados de treinamento e recurso Browse do ChatGPT
- Efeito do bloqueio: o seu conteúdo não alimenta as respostas do ChatGPT nem aparece nas citações do ChatGPT Browse
- Documentação: a OpenAI mantém uma lista pública das faixas de IP do GPTBot
Anthropic - Claude
- User-agent: ClaudeBot (também identificado como anthropic-ai)
- Função: dados de treinamento e base de conhecimento do Claude
- Efeito do bloqueio: o seu conteúdo não alimenta as respostas do Claude quando alguém pergunta sobre o seu tema
- Documentação: a Anthropic publicou a sua política de rastreamento e respeita as diretivas do robots.txt
Perplexity AI
- User-agent: PerplexityBot
- Função: busca na web em tempo real para as respostas e citações do Perplexity AI
- Efeito do bloqueio: as suas páginas não serão citadas nas respostas do Perplexity, mesmo quando forem muito relevantes
- Documentação: o Perplexity respeita o robots.txt e publicou diretrizes de rastreamento
Google - recursos de IA
- User-agent: Google-Extended
- Função: treinamento do Google Bard/Gemini e conteúdo das AI Overviews
- Efeito do bloqueio: o seu conteúdo pode não aparecer nas AI Overviews, no AI Mode ou nas respostas do Gemini
- Observação: ele é separado do Googlebot. Você pode liberar o Googlebot (busca tradicional) e bloquear o Google-Extended (recursos de IA)
Microsoft - Copilot
- User-agent: Bingbot (compartilhado); os crawlers específicos do Copilot variam
- Função: alimenta o Microsoft Copilot e as respostas de IA do Bing
- Efeito do bloqueio: menos visibilidade no Microsoft Copilot e nos recursos de IA do Bing
Meta - Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- Função: dados de treinamento para a Meta AI e os modelos Llama
- Efeito do bloqueio: o seu conteúdo não alimenta as respostas da Meta AI
Apple - Applebot
- User-agent: Applebot, Applebot-Extended
- Função: Siri, Apple Intelligence e recursos de busca da Apple
- Efeito do bloqueio: menos visibilidade na Siri e nos recursos de IA da Apple
O problema: a maioria dos robots.txt foi escrita antes dos crawlers de IA
Um robots.txt típico de 2020-2023 é mais ou menos assim:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Essa configuração libera o Googlebot, mas deixa todos os outros bots por conta da regra curinga. Dependendo da interpretação, essa regra pode estar bloqueando os crawlers de IA em partes do seu site ou, ao contrário, liberando o acesso a tudo, inclusive a páginas que você preferiria proteger.
Pior: alguns sites adotaram bloqueios agressivos no início da era dos crawlers de IA (2022-2023), quando a reação dos publishers contra o uso de conteúdo para treinar IA estava no auge. Se o seu site incluiu Disallow: / para todos os bots, é possível que você tenha trancado a porta para os crawlers de IA e esquecido disso. O estrago só aparece quando você percebe que a sua marca quase não surge nas respostas da busca com IA.
O recurso de rastreamento de bots de IA do AI Rank Lab mostra quais bots de IA realmente visitam as suas páginas e quais assistentes de IA enviam tráfego de referência para você, sem precisar analisar logs na mão. Se um crawler que você queria liberar nunca aparece, confira as regras dele no seu robots.txt.
Modelos de robots.txt para cada cenário
Use o nosso gerador de robots.txt gratuito para adaptar estes modelos ao seu site. Abaixo estão as configurações mais comuns:
Modelo 1: acesso total para IA (recomendado para a maioria dos sites)
Libera todos os crawlers de IA para acessar o seu conteúdo. Ideal para sites que querem o máximo de visibilidade na busca com IA e não se importam que o conteúdo ajude a treinar modelos de IA.
# Crawlers de busca padrão
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Buscadores tradicionais
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# Crawlers de IA - liberados explicitamente
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Modelo 2: acesso seletivo para IA (proteção de conteúdo)
Libera os crawlers de IA nas páginas de conteúdo público, mas bloqueia conteúdo premium, artigos com paywall e áreas de membros. Ideal para publishers com assinatura e sites com conteúdo restrito.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# Crawlers de IA - somente conteúdo público
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Modelo 3: bloquear o treinamento de IA e liberar a busca com IA
Uma configuração mais refinada: libera o Perplexity (que usa o seu conteúdo para citações em tempo real) e bloqueia os crawlers de treinamento (que usam o seu conteúdo para treinar modelos). É um meio-termo comum entre publishers que querem ser citados na busca com IA, mas não aceitam ver o conteúdo usado para treinar modelos.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - citações em tempo real, liberar
User-agent: PerplexityBot
Allow: /

# Recursos de IA do Google - liberar para as AI Overviews
User-agent: Google-Extended
Allow: /

# Treinamento da OpenAI - bloquear
User-agent: GPTBot
Disallow: /

# Treinamento da Anthropic - bloquear
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml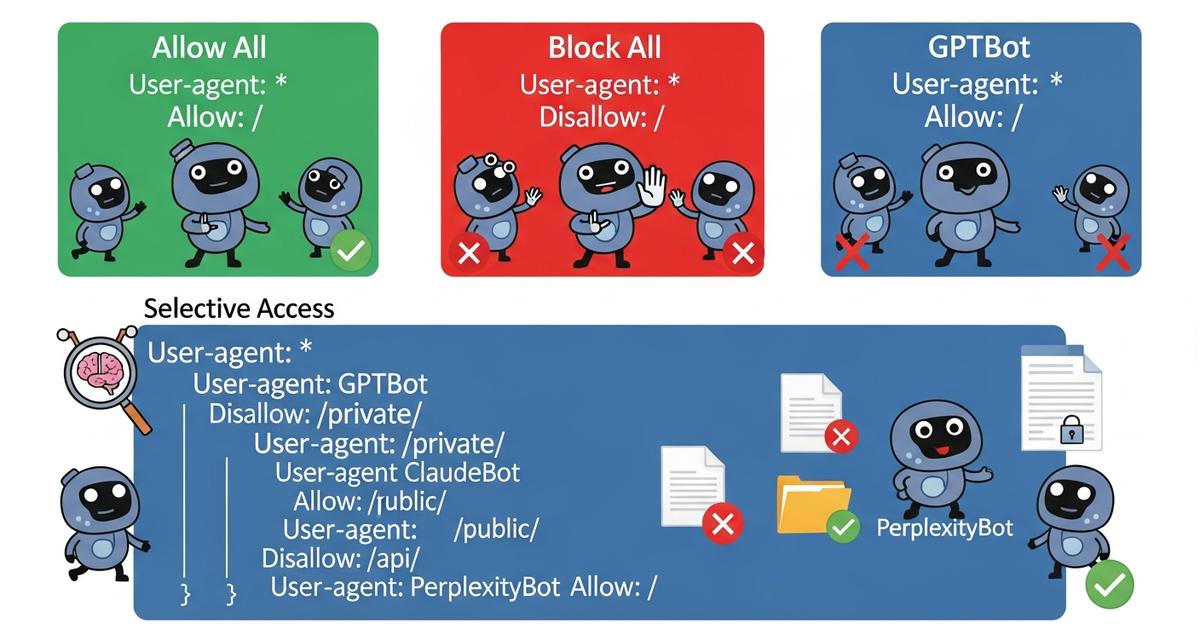
Como escolher a configuração certa para o seu site
A configuração ideal do robots.txt depende do tipo de conteúdo, do modelo de negócio e dos seus objetivos de visibilidade na busca com IA. Use este roteiro para decidir:
Libere todos os crawlers de IA se:
- O seu site publica conteúdo aberto (blog, documentação, materiais)
- Você quer o máximo de visibilidade na busca com IA e as citações são uma fonte de tráfego
- Você não tem conteúdo restrito ou premium que precise de proteção
- O seu conteúdo é informativo e ganha com uma distribuição ampla
Use o acesso seletivo se:
- Você mistura conteúdo gratuito e premium
- Algumas páginas não devem ser citadas (páginas de conta, fluxos de checkout, conteúdo exclusivo para membros)
- Você quer que os crawlers de IA se concentrem no seu melhor conteúdo em vez de rastrear tudo
Bloqueie os crawlers de treinamento (e libere só a busca) se:
- Você é um publisher preocupado com o uso do seu conteúdo para treinar IA
- Mesmo assim, você quer aparecer no Perplexity e nas AI Overviews do Google (citação em tempo real)
- Você quer manter a opção de licenciar o seu conteúdo para empresas de IA separadamente
Bloqueie todos os crawlers de IA somente se:
- Você tem motivos jurídicos ou competitivos claros para manter o conteúdo fora dos sistemas de IA
- Você tem um acordo de licenciamento com empresas de IA específicas e quer garantir exclusividade
- Você entende o preço dessa escolha: visibilidade zero na busca com IA para o seu domínio
Erros comuns que você deve evitar
Erro 1: usar um bloqueio curinga para bots desconhecidos
Configurações como User-agent: * / Disallow: / seguidas de regras de liberação específicas para o Googlebot vão bloquear todos os crawlers de IA, porque eles não têm regras de liberação explícitas. Seja sempre explícito sobre o acesso dos crawlers de IA.
Erro 2: não saber como está a sua configuração atual
Muitas equipes não sabem o que o robots.txt delas diz hoje sobre os crawlers de IA. Confira agora mesmo em yoursite.com/robots.txt. As ferramentas do AI Rank Lab também ajudam: a auditoria gratuita do site verifica se o seu robots.txt existe e está acessível.
Erro 3: confundir Googlebot com Google-Extended
Liberar o Googlebot não libera automaticamente o Google-Extended (o crawler dos recursos de IA). Se você quer aparecer nas AI Overviews e no AI Mode do Google, precisa de uma regra explícita liberando o Google-Extended.
Erro 4: não testar depois das mudanças
Depois de atualizar o robots.txt, confirme que as mudanças entraram em vigor: confira o arquivo publicado e use uma ferramenta de teste de robots.txt. O Google Search Console tem um testador de robots.txt integrado para o Googlebot, mas as regras dos crawlers de IA você vai precisar verificar manualmente.
Erro 5: configurar e esquecer
Novos crawlers de IA surgem o tempo todo. A lista de user agents de IA de 2023 já está incompleta em 2026. Revise o seu robots.txt pelo menos uma vez por trimestre e acompanhe a documentação de novos crawlers publicada pelas grandes empresas de IA.
Além do robots.txt: o kit completo para controlar crawlers de IA
O robots.txt é a alavanca mais importante, mas não a única, para controlar o acesso dos crawlers de IA. Uma configuração técnica completa de AEO inclui:
- robots.txt: regras de acesso dos crawlers (vistas acima)
- llms.txt: um arquivo de orientação para LLMs sobre o que o seu site cobre e como o conteúdo deve ser usado; complementa o robots.txt, não o substitui
- Meta tags noindex: controle por página que impede a indexação de páginas específicas, respeitado por alguns crawlers de IA
- Monitoramento de bots de IA: acompanhe quais crawlers acessam o seu site e com que frequência; o recurso de rastreamento de bots do AI Rank Lab dá essa visibilidade sem análise de logs
Use o gerador de robots.txt gratuito
Em vez de escrever o seu robots.txt do zero, use o gerador de robots.txt gratuito do AI Rank Lab. Escolha o tipo de configuração (acesso total, seletivo, bloqueio de treinamento ou personalizado), indique os caminhos que quer proteger e ele gera um arquivo bem formatado, já com todos os user agents de crawlers de IA atuais. Você pode copiar o resultado direto para o seu servidor ou baixá-lo como arquivo.
O gerador é atualizado conforme novos user agents de crawlers de IA são lançados. Assim, você recebe uma configuração que já considera bots que nem existiam quando este artigo foi escrito.
Conclusão
O seu robots.txt é um painel de controle direto da sua visibilidade na busca com IA. Configurá-lo bem significa que os crawlers de IA conseguem acessar e aprender com o seu conteúdo, o que se traduz em citações nas respostas do ChatGPT, Perplexity, Claude e Gemini. Errar na configuração, ou deixar um arquivo desatualizado no ar, cria barreiras invisíveis entre o seu conteúdo e os mecanismos de IA que cada vez mais guiam a descoberta de marcas e conteúdos.
Investir cinco minutos para conferir o seu robots.txt atual e usar o gerador gratuito para criar uma configuração pronta para IA é uma das ações técnicas de maior retorno que você pode tomar pela sua visibilidade na busca com IA. Faça isso hoje e deixe um lembrete para revisar a cada trimestre, à medida que novos crawlers de IA entram no jogo.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


