



Почему в 2026 году robots.txt важнее, чем когда-либо
Файл robots.txt появился в 1994 году, чтобы подсказывать поисковым роботам, какие страницы обходить стороной. 30 лет вебмастерам по большому счёту нужно было думать об одном крупном семействе краулеров — Googlebot. В 2026 году список резко вырос. У ИИ-компаний — OpenAI, Anthropic, Perplexity, Google — есть собственные краулеры, которые читают ваш контент, чтобы обучать модели, собирать базы знаний и формировать ответы ИИ-поиска.
Пустите вы этих ботов или закроете им доступ — от этого напрямую зависит ваша видимость в ИИ-поиске. Если GPTBot не может обойти ваш сайт, ваш контент не влияет на ответы ChatGPT. Заблокируете PerplexityBot — Perplexity не сможет цитировать ваши страницы. Закрыт Google-Extended — ваш контент может не попасть в ответы Google AI Overviews (ИИ-обзоры в поиске Google) и AI Mode.
Чтобы правильно настроить robots.txt в эпоху ИИ-краулеров, нужно понимать, какие боты существуют, что они делают и как выдать доступ так, чтобы и защитить контент, и выжать максимум шансов на цитирование в ИИ-ответах. В этом руководстве разберём всё по порядку — включая бесплатный генератор robots.txt, с которым готовая к ИИ-эпохе конфигурация собирается за несколько минут.
Полный справочник ИИ-краулеров
Прежде чем что-то настраивать, нужно знать, к каким ботам обращаться. Вот основные ИИ-краулеры и их user-agent по состоянию на 2026 год:
OpenAI — ChatGPT
- User-agent: GPTBot
- Назначение: сбор обучающих данных и функция Browse в ChatGPT
- Если заблокировать: ваш контент не будет влиять на ответы ChatGPT и не появится в цитатах ChatGPT Browse
- Документация: OpenAI ведёт публичный список IP-диапазонов GPTBot
Anthropic — Claude
- User-agent: ClaudeBot (также встречается как anthropic-ai)
- Назначение: обучающие данные и база знаний для Claude AI
- Если заблокировать: ваш контент не влияет на ответы Claude, когда пользователи спрашивают о вашей теме
- Документация: Anthropic опубликовала свою политику обхода и соблюдает директивы robots.txt
Perplexity AI
- User-agent: PerplexityBot
- Назначение: веб-поиск в реальном времени для ответов и цитат Perplexity AI
- Если заблокировать: ваши страницы не будут цитироваться в ответах Perplexity, даже если они идеально подходят по теме
- Документация: Perplexity соблюдает robots.txt и опубликовала правила обхода
Google — ИИ-функции
- User-agent: Google-Extended
- Назначение: обучение Google Bard/Gemini и контент для AI Overviews
- Если заблокировать: ваш контент может не появиться в Google AI Overviews, AI Mode или ответах Gemini
- Важно: это не Googlebot. Можно разрешить Googlebot (классический поиск) и при этом заблокировать Google-Extended (ИИ-функции)
Microsoft — Copilot
- User-agent: Bingbot (общий), отдельные краулеры для Copilot бывают разными
- Назначение: работа Microsoft Copilot и ИИ-ответов Bing
- Если заблокировать: меньше видимости в Microsoft Copilot и ИИ-функциях Bing
Meta — Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- Назначение: обучающие данные для Meta AI и моделей Llama
- Если заблокировать: ваш контент не влияет на ответы Meta AI
Apple — Applebot
- User-agent: Applebot, Applebot-Extended
- Назначение: Siri, Apple Intelligence и поисковые функции Apple
- Если заблокировать: меньше видимости в Siri и ИИ-функциях Apple
В чём проблема: большинство robots.txt писали ещё до появления ИИ-краулеров
Типичный robots.txt образца 2020–2023 годов выглядит так:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Такая конфигурация пускает Googlebot, а для всех остальных ботов полагается на правило со звёздочкой. В зависимости от того, как его интерпретировать, это правило может закрывать ИИ-краулерам часть сайта — или, наоборот, пускать их везде, включая страницы, которые вы предпочли бы защитить.
Хуже того, в ранний период ИИ-краулеров (2022–2023), когда недовольство издателей использованием их контента для обучения ИИ было на пике, некоторые сайты добавили жёсткие блокировки. Если вы когда-то прописали Disallow: / для всех ботов, вполне возможно, вы закрыли дверь ИИ-краулерам и благополучно об этом забыли. Последствия всплывают, только когда вы замечаете, что ваш бренд почти не упоминается в ответах ИИ-поиска.
Функция отслеживания ИИ-ботов в AI Rank Lab показывает, какие ИИ-боты на самом деле заходят на ваши страницы и какие ИИ-ассистенты приводят к вам реферальный трафик — без ручного разбора логов. Если краулер, которого вы собирались пустить, так и не появляется, проверьте правила для него в robots.txt.
Шаблоны robots.txt под разные сценарии
Подстройте эти шаблоны под свой сайт в нашем бесплатном генераторе robots.txt. Ниже — самые распространённые конфигурации:
Шаблон 1: полный доступ для ИИ (рекомендуем большинству сайтов)
Разрешите всем ИИ-краулерам доступ к контенту. Лучший вариант для сайтов, которым нужна максимальная видимость в ИИ-поиске и которые не против, чтобы их контент участвовал в обучении ИИ-моделей.
# Стандартные поисковые краулеры
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Классические поисковые системы
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# ИИ-краулеры — явно разрешены
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Шаблон 2: выборочный доступ для ИИ (защита контента)
Пустите ИИ-краулеров на публичные страницы, но закройте премиум-контент, платные статьи и разделы для участников. Лучший вариант для издателей с подпиской и сайтов с закрытым контентом.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# ИИ-краулеры — только публичный контент
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Шаблон 3: закрыть обучение ИИ, оставить ИИ-поиск
Более тонкая настройка: пустить Perplexity (он использует ваш контент для цитат в реальном времени), но закрыть краулеры для обучения (они используют контент, чтобы тренировать модели). Популярный компромисс для издателей, которые хотят цитирования в ИИ-поиске, но против того, чтобы на их материалах обучали модели.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity — цитаты в реальном времени, разрешаем
User-agent: PerplexityBot
Allow: /

# ИИ-функции Google — разрешаем ради AI Overviews
User-agent: Google-Extended
Allow: /

# Обучение OpenAI — блокируем
User-agent: GPTBot
Disallow: /

# Обучение Anthropic — блокируем
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml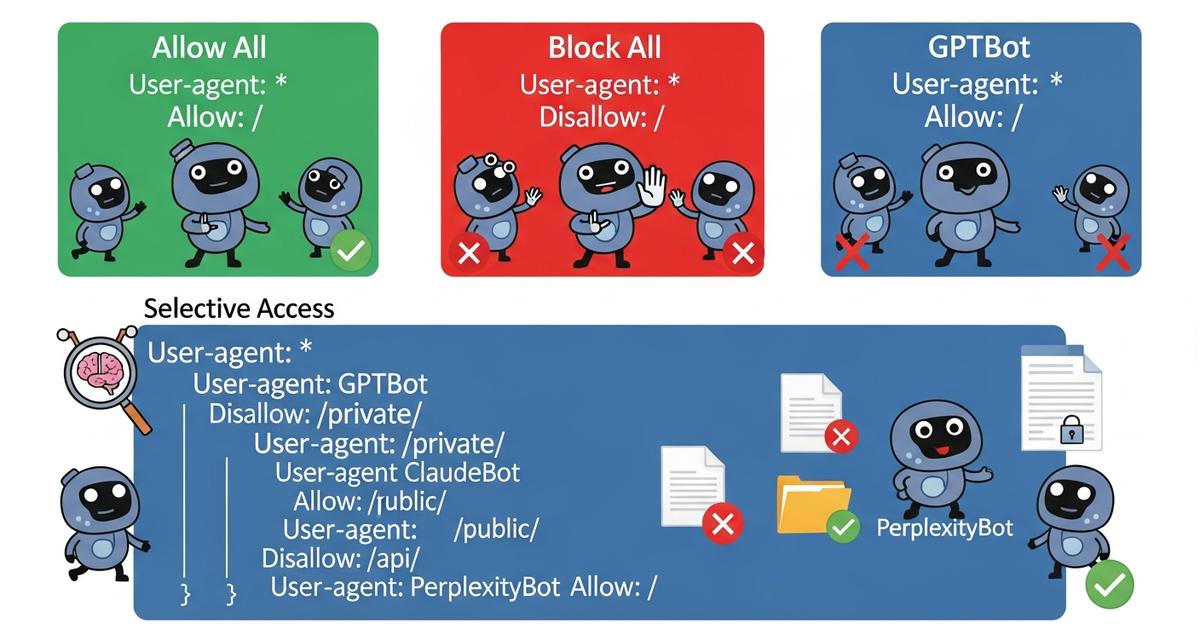
Какая конфигурация подойдёт именно вам
Правильная настройка robots.txt зависит от типа контента, бизнес-модели и ваших целей по видимости в ИИ-поиске. Ориентируйтесь на эту схему:
Разрешайте всех ИИ-краулеров, если:
- ваш сайт публикует открытый контент (блог, документацию, полезные материалы);
- вам нужна максимальная видимость в ИИ-поиске, а цитаты приносят трафик;
- у вас нет закрытого или премиум-контента, который нужно защищать;
- ваш контент информационный и только выигрывает от широкого распространения.
Выбирайте выборочный доступ, если:
- у вас есть и бесплатный, и премиум-контент;
- некоторые страницы не должны цитироваться (личный кабинет, оформление заказа, контент только для участников);
- вы хотите, чтобы ИИ-краулеры сосредоточились на лучшем контенте, а не обходили всё подряд.
Блокируйте краулеры для обучения (оставив только поиск), если:
- вы издатель и вас беспокоит использование контента для обучения ИИ;
- вы всё же хотите появляться в Perplexity и Google AI Overviews (цитирование в реальном времени);
- вы хотите сохранить возможность отдельно лицензировать контент ИИ-компаниям.
Блокируйте всех ИИ-краулеров, только если:
- у вас есть чёткие юридические или конкурентные причины держать контент подальше от ИИ-систем;
- у вас есть лицензионное соглашение с конкретными ИИ-компаниями и нужно обеспечить эксклюзивность;
- вы понимаете цену такого решения: нулевая видимость вашего домена в ИИ-поиске.
Типичные ошибки, которых стоит избегать
Ошибка 1: блокировать всех неизвестных ботов звёздочкой
Конфигурация вида User-agent: * / Disallow: /, за которой следуют разрешающие правила только для Googlebot, закроет доступ всем ИИ-краулерам, потому что для них нет явных правил Allow. Всегда прописывайте доступ для ИИ-краулеров явно.
Ошибка 2: не знать, что сейчас написано в вашем файле
Многие команды понятия не имеют, что их robots.txt сейчас говорит об ИИ-краулерах. Проверьте его прямо сейчас по адресу yoursite.com/robots.txt. Помогут и инструменты AI Rank Lab: бесплатный аудит сайта проверяет, что robots.txt существует и доступен.
Ошибка 3: путать Googlebot и Google-Extended
Разрешение для Googlebot не открывает автоматически доступ Google-Extended (краулеру ИИ-функций). Если хотите появляться в Google AI Overviews и AI Mode, нужно отдельное правило, разрешающее Google-Extended.
Ошибка 4: не проверять изменения
Обновив robots.txt, убедитесь, что изменения вступили в силу: посмотрите живой файл и прогоните его через инструмент проверки robots.txt. В Google Search Console есть встроенный тестер robots.txt для Googlebot, но правила для ИИ-краулеров придётся проверять вручную.
Ошибка 5: настроить и забыть
Новые ИИ-краулеры появляются регулярно. Список ИИ-user-agent образца 2023 года в 2026-м уже неполон. Пересматривайте robots.txt хотя бы раз в квартал и следите за новой документацией по краулерам от крупных ИИ-компаний.
Не только robots.txt: полный набор инструментов для управления ИИ-краулерами
robots.txt — главный, но не единственный рычаг управления доступом ИИ-краулеров. Полноценная техническая настройка под AEO включает:
- robots.txt: правила доступа для краулеров (о них выше);
- llms.txt: файл-подсказка для LLM о том, чему посвящён ваш сайт и как следует использовать контент, — дополняет robots.txt, а не заменяет его;
- мета-теги noindex: контроль на уровне страницы, который не даёт индексировать конкретные страницы; некоторые ИИ-краулеры его соблюдают;
- мониторинг ИИ-ботов: отслеживайте, какие краулеры заходят на сайт и как часто, — функция отслеживания ботов в AI Rank Lab даёт эту картину без анализа логов.
Воспользуйтесь бесплатным генератором robots.txt
Вместо того чтобы писать robots.txt с нуля, воспользуйтесь бесплатным генератором robots.txt от AI Rank Lab. Выберите тип конфигурации (полный доступ, выборочный, блокировка обучения или своя), укажите пути, которые нужно защитить, — и генератор выдаст корректно оформленный файл со всеми актуальными user-agent ИИ-краулеров. Результат можно сразу скопировать на сервер или скачать файлом.
Генератор обновляется по мере появления новых user-agent ИИ-краулеров, так что ваша конфигурация учтёт и ботов, которых ещё не было на момент написания этой статьи.
Итоги
Ваш robots.txt — это прямой пульт управления видимостью в ИИ-поиске. Настроите его правильно — ИИ-краулеры смогут читать ваш контент и учиться на нём, а это превращается в цитаты в ответах ChatGPT, Perplexity, Claude и Gemini. Ошибётесь или оставите устаревший файл — между вашим контентом и ИИ-системами, через которые люди всё чаще находят информацию, встанут невидимые барьеры.
Пять минут на то, чтобы проверить текущий robots.txt и собрать в бесплатном генераторе конфигурацию под ИИ, — одно из самых выгодных технических действий для видимости в ИИ-поиске. Сделайте это сегодня, а потом поставьте напоминание пересматривать файл раз в квартал: новые ИИ-краулеры появляются постоянно.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


