



Споры вокруг llms.txt: реальный сигнал или плацебо?
С тех пор как появилась спецификация llms.txt, SEO- и AEO-сообщество разделилось на два лагеря. Сторонники считают файл понятным сигналом для ИИ-систем: что это за сайт и о чём он. По их мнению, именно такая структурированная подсказка может склонить нейросеть процитировать вас. Скептики возражают: стандарт слишком новый, чтобы реально на что-то влиять, официально его поддерживают единицы, а рост цитирования, который приписывают llms.txt, на самом деле дают правки контента, которые команды вносят параллельно с внедрением файла.
Мы решили уйти от догадок. На базе инфраструктуры AI Rank Lab для отслеживания цитирования мы проанализировали 500 сайтов до и после добавления llms.txt и в течение 90 дней следили за частотой цитирования в ChatGPT (GPT-4o), Perplexity и Claude 3.5 Sonnet. Отдельно мы разобрали, чем сайты с сильным ростом цитирования отличаются от тех, у кого почти ничего не изменилось.
Вот что мы обнаружили, включая выводы, которые расходятся с самыми оптимистичными обещаниями насчёт llms.txt.
Исследование 500 сайтов: методология
Мы отслеживали 500 доменов, которые впервые добавили llms.txt за шестимесячный период анализа. У всех доменов:
- уже был открыт доступ ИИ-краулерам (GPTBot, ClaudeBot и PerplexityBot разрешены в robots.txt);
- было не меньше 30 дней базовых данных по цитированию до добавления llms.txt;
- в период измерений не было крупных изменений контента и заметного прироста новых обратных ссылок;
- было от 10 до 500 страниц (очень маленькие и очень большие сайты мы исключили, чтобы уменьшить влияние посторонних факторов).
Частоту цитирования мы считали так: сколько раз LLM процитировала домен, отвечая на запросы из основного тематического кластера этого домена, в процентах от всех проверенных запросов. Для каждого домена и каждой LLM мы проверяли 50 запросов из основного набора ключевых слов домена.
Сайты представляли 12 отраслей: SaaS, электронная коммерция, локальные услуги, B2B-услуги, издательства и медиа, здравоохранение, юриспруденция, финансовые услуги, образование, недвижимость, путешествия и технологические новости.
Вывод 1: llms.txt повышает цитирование, но не во всех LLM
По всем 500 сайтам за 90 дней после добавления llms.txt средняя частота цитирования изменилась так:
- Perplexity: в среднем +18 % к частоте цитирования
- ChatGPT (с Browse): в среднем +12 % к частоте цитирования
- Claude: в среднем +7 % к частоте цитирования
- ChatGPT (без Browse, базовая GPT-4o): +3 % (статистически незначимо)
Разница между моделями существенная, и одними особенностями сканирования её до конца не объяснить. Более сильная реакция Perplexity, скорее всего, связана с его архитектурой поиска в реальном времени: при составлении ответов он активно использует файлы со структурированными подсказками. Режим Browse в ChatGPT (который подтягивает живой веб-контент) даёт заметный прирост, а базовая модель GPT-4o, опирающаяся в основном на обучающие данные, от добавления одного файла почти не меняется.
Умеренный рост у Claude согласуется с опубликованным подходом Anthropic: ClaudeBot сканирует сайты и учитывает файлы с подсказками, но обучающие данные Claude обновляются реже, чем Perplexity получает данные в реальном времени. Эффект настоящий, просто проявляется медленнее.
Вывод 2: главное — качество описания в llms.txt
У сайтов с самым большим ростом цитирования (верхний квартиль, в среднем +31 %) было одно общее: очень конкретное описание в блоке-цитате (blockquote), где чётко сказано, чем сайт отличается, для кого он и какие темы охватывает.
Мы оценили описание в llms.txt каждого сайта по пяти критериям:
- Конкретность аудитории (для кого это?)
- Понятность отличий (чем этот сайт выделяется?)
- Полнота тематики (какие темы охватывает сайт?)
- Сигналы авторитетности (любые признаки надёжности: данные, экспертиза, методология)
- Контекст действия (что читатель может сделать на этом сайте?)
Сайты, набравшие по этой шкале 4–5 баллов, в среднем получили +27 % к цитированию. Сайты с 1–2 баллами — всего +6 %, это едва выше статистического шума. Формат файла важен куда меньше, чем содержание раздела с описанием.
Примеры описаний с высокой и низкой оценкой:
Низкая оценка (выполнен 1 из 5 критериев):
«Example Corp предлагает маркетинговые инструменты и ресурсы для бизнеса».
Высокая оценка (выполнены 5 из 5 критериев):
«Example Corp — B2B-платформа маркетинговой атрибуции, которой пользуются более 2 000 SaaS-компаний среднего бизнеса, чтобы отслеживать вклад в пайплайн каналов dark social (LinkedIn, упоминания в подкастах, сообщества и форумы), которые стандартная атрибуция по UTM-меткам не видит. Основные сценарии: VP of Marketing отчитывается перед советом директоров о неотслеживаемом пайплайне, команды demand gen обосновывают бюджет на dark social».
В сильном примере указаны аудитория (VP of Marketing и команды demand gen в SaaS-компаниях среднего бизнеса), отличие (атрибуция dark social), авторитетность (более 2 000 компаний) и контекст действия (отчёты для совета директоров, обоснование бюджета). Прочитав такое описание, ИИ-система сможет точно рассказать о продукте, когда пользователь спросит об инструментах маркетинговой атрибуции для SaaS-компаний.
Вывод 3: списки страниц дают эффект в длинном хвосте запросов
Сайты, которые добавили в llms.txt подробные списки страниц (а не только раздел с описанием), получили дополнительный рост цитирования по низкочастотным запросам длинного хвоста — о конкретных функциях, сценариях использования или темах, раскрытых на перечисленных страницах.
Сильнее всего эффект проявился у страниц, на которые мало внутренних ссылок. Для таких «осиротевших, но важных» страниц — страниц инструментов, технической документации, нишевых руководств — попадание в список llms.txt стало основным способом, благодаря которому ИИ-системы начали цитировать их по релевантным запросам. Без списка эти страницы оставались для ИИ практически невидимыми, хотя содержали ценный контент.
Сайты с 15 и более хорошо описанными страницами в списке получили +22 % к цитированию по запросам длинного хвоста, тогда как сайты без списков или с короткими списками без описаний — +9 %.
Вывод 4: одного llms.txt недостаточно
Самый важный негативный результат: сайты, которые блокируют ИИ-краулеры в robots.txt, после добавления llms.txt не получили никакого роста цитирования. Это ожидаемо, но стоит сказать прямо: llms.txt не поможет, если ИИ-краулеры не могут попасть на ваш сайт. Файл подсказывает краулерам, которых уже пустили, но не отменяет ограничения доступа.
Точно так же сайты со слабым или некачественным контентом почти не выросли даже при сильных файлах llms.txt. ИИ-системы не начинают чаще цитировать плохой контент только потому, что в файле написано, что он важен. Файл улучшает то, как ИИ понимает ваш сайт и ориентируется в нём, но сам контент всё равно должен заслуживать цитирования.
Полную картину того, что влияет на цитирование в нейросетях, смотрите в руководстве по оптимизации под ИИ-поиск. llms.txt — один из нескольких сигналов, которые работают вместе, а не самостоятельное решение.
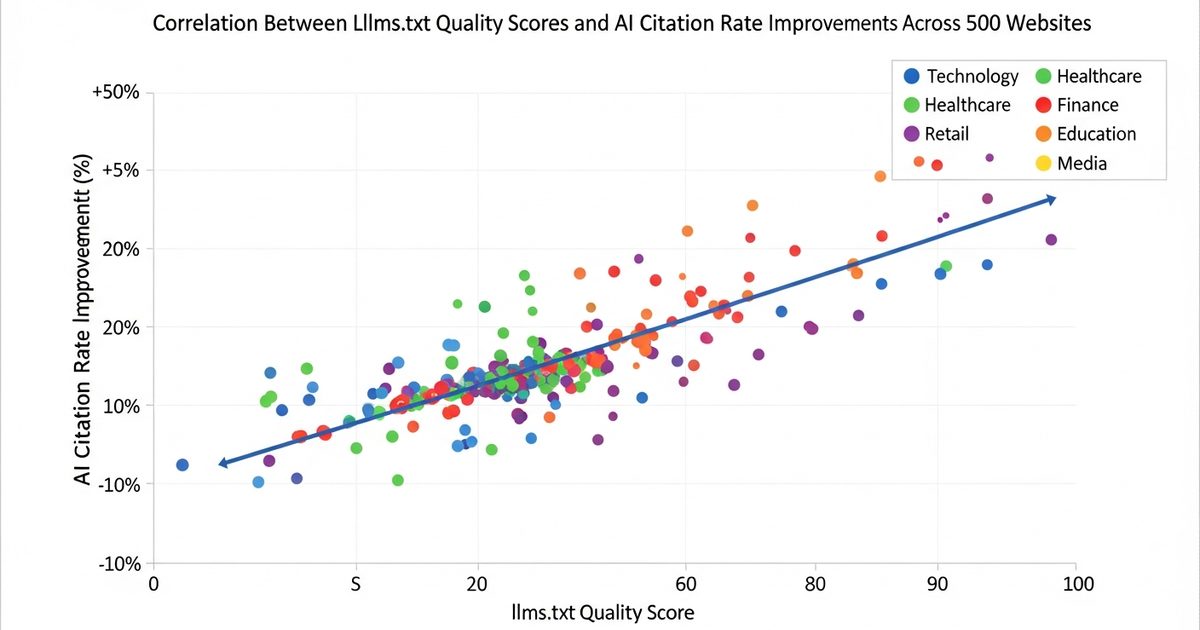
По отраслям: кому llms.txt полезнее всего
Рост цитирования после внедрения llms.txt сильно зависел от отрасли:
Максимальная польза (в среднем +20–35 %)
- SaaS и технологии: ИИ-системы часто неверно классифицируют программные продукты или описывают их с ошибками. Конкретное описание в llms.txt хорошо исправляет такие искажения.
- Финансовые услуги: ИИ осторожно цитирует финансовый контент без явных сигналов авторитетности. llms.txt с указанием лицензий регуляторов, описанием методологии или профессиональной квалификации заметно повышает цитирование.
- Здравоохранение и медицина: та же логика, что и в финансах: сигналы авторитетности в описании резко повышают цитирование медицинских сайтов с реальной экспертизой.
Умеренная польза (в среднем +8–18 %)
- B2B-услуги: сложным услугам, которые трудно классифицировать только по контенту, явное описание помогает, но рост умеренный.
- Образование: чёткое описание охваченных тем помогает ИИ сопоставлять образовательный контент с конкретными учебными запросами.
- Издательства и новости: выигрывают в основном от подсказок о свежести контента (указания, какие разделы часто обновляются), а не от самого описания.
Меньшая польза (в среднем +3–8 %)
- Электронная коммерция: страницы товаров ИИ и так хорошо понимает по структурированным данным (разметка Product). Если разметка полная, llms.txt добавляет немного.
- Локальные услуги: цитирование локальных услуг куда больше зависит от отзывов и согласованности NAP (название, адрес, телефон), чем от подсказок в llms.txt.
В чём скептики правы
Наши данные подтверждают часть скептических аргументов:
Цитирование не гарантировано. Даже верхний квартиль показал +31 %, но это рост от исходного уровня. Сайты с частотой цитирования 10 % вышли примерно на 13 %. Это не революция, а заметное улучшение, которое со временем накапливается.
Улучшение контента важнее. Мы сравнили сайты, которые только добавили llms.txt, с сайтами, которые одновременно улучшили качество контента (лучшие ответы в FAQ, более конкретные структурированные данные). У группы с улучшенным контентом рост цитирования оказался в 2,4 раза выше, чем у группы «только llms.txt». llms.txt усиливает хороший контент, но не заменяет его.
Не все LLM реагируют одинаково. Для базовой модели ChatGPT (без Browse) эффект небольшой. Если по вашим целевым запросам отвечают в основном модели, которые опираются на обучающие данные, а не на поиск в реальном времени, результат от llms.txt будет медленнее и его сложнее измерить.
Наши рекомендации
Исходя из данных, мы рекомендуем:
- Внедрите llms.txt, если ещё не сделали этого — польза реальная, затраты низкие (30–60 минут на качественный файл), а минусов нет
- Сделайте упор на качество описания — именно оно даёт 70 % роста цитирования; потратьте время на конкретное, нацеленное на аудиторию и отличающее вас от конкурентов описание
- Перечислите важные страницы с малым числом внутренних ссылок — особенно страницы инструментов, документацию и тематические руководства, на которые мало ссылаются внутри сайта
- Сначала исправьте robots.txt, если ИИ-краулеры заблокированы — на закрытом сайте llms.txt ничего не даёт
- Совмещайте с улучшением контента и разметки — llms.txt эффективнее всего как часть полноценной AEO-стратегии, а не как разовая заплатка
Создайте свой файл с помощью бесплатного генератора llms.txt от AI Rank Lab, а инструментом полного аудита проверьте, правильно ли составлен ваш текущий llms.txt и работает ли он вместе с остальными AEO-сигналами.
Заключение
llms.txt реально и измеримо влияет на частоту цитирования в ИИ — особенно в Perplexity и ChatGPT с Browse, особенно у сайтов со сложными или легко путаемыми продуктами и услугами и особенно когда описание конкретное и выделяет вас среди конкурентов. Это не волшебство: файл не сделает слабый контент достойным цитирования и не обойдёт блокировку краулеров. Но как часть полноценной AEO-стратегии он с лихвой окупает 30 минут, потраченных на внедрение.
Главный вывод: качество описания в llms.txt значит гораздо больше, чем сам факт наличия файла. Шаблонное описание из двух предложений почти ничего не даёт. Конкретное описание, нацеленное на вашу аудиторию, с сигналами авторитетности и понятными отличиями заметно повышает цитирование во всех LLM, которые поддерживают этот стандарт.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


