



حصة الصوت في الذكاء الاصطناعي (AI Share of Voice) هي نصيب علامتك التجارية من مجموع إشارات العلامات التجارية في الإجابات التي يولّدها الذكاء الاصطناعي لمجموعة ثابتة من الأوامر (prompts): عدد إشاراتك مقسومًا على إشارات كل العلامات الواردة في تلك الإجابات، مضروبًا في 100. إنها نسبة تنافسية وليست معدل ظهور، لذلك لا معنى لها إلا إذا قُرئت مع مجموعة الأوامر والمحركات وقائمة المنافسين والفترة الزمنية التي أنتجتها. وهناك صيغتان أخريان لا تقلّان أهمية: حصة الصوت من الاستشهادات (أي المواقع التي تربط إليها الإجابات)، وحصة الصوت الموزونة بالترتيب (أي من يُذكر أولًا).
يقدّم لك هذا الدليل المعادلات الثلاث، ومجموعة بيانات تطبيقية واحدة تُخرج أربعة أرقام مختلفة لـ«حصة الصوت» للعلامة نفسها، ومعادلات جداول بيانات جاهزة للنسخ، ومقارنة جنبًا إلى جنب لطريقة تعريف Profound وPeec AI وSemrush وAhrefs لهذا المقياس، وحسابات حجم العينة المبنية على بيانات التشغيل المتكرر لدينا، وقالبًا لعرض النتائج على الإدارة. تحقّقنا من تعريفات الأدوات في 18 أكتوبر 2026.
أهم النقاط
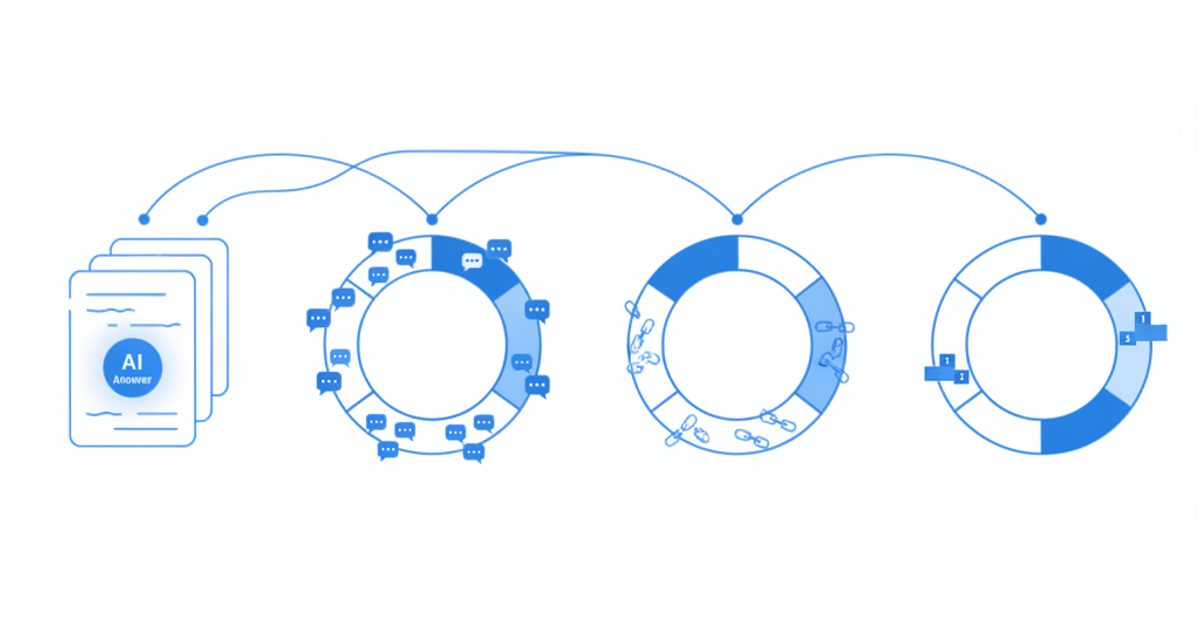
- ثلاث معادلات، ثلاث إجابات. حصة الإشارات تَعُدّ الأسماء الواردة في الإجابة، وحصة الاستشهادات تَعُدّ الروابط المؤدية إلى موقعك، والحصة الموزونة بالترتيب تكافئ من يُذكر أولًا. في مثالنا التطبيقي تحصل العلامة نفسها على 17.5% و44.0% و14.3%.
- حصة الصوت ليست معدل الظهور. عبارة «ظهرنا في 35% من الإجابات» تصف معدل الظهور (visibility). أما حصة الصوت فتقسم على مجموع إشارات كل العلامات، ولذلك تنخفض حين يزدحم المنافسون في الإجابة.
- المقام هو ما يحدد الرقم. حين اكتفينا بعدّ العلامات الأربع التي اخترناها بدلًا من كل علامة ذكرها الذكاء الاصطناعي، قفز مثالنا من 17.5% إلى 22.6%.
- التشغيل الواحد مجرد عينة. عبر 968 تشغيلًا متكررًا لـ42 زوجًا من الأوامر والمحركات في AI Rank Lab، تقلّب 42.9% من الأزواج مرة واحدة على الأقل بين ذكر العلامة وعدم ذكرها. اعرض النتائج على فترات لا لقطات، وأظهر هامش الخطأ.
- لا يوجد معيار عالمي موثّق المصدر. النطاقات المنشورة لما يُعدّ «جيدًا» متضاربة، وكثيرًا ما تقيس مقاييس مختلفة. قارن نفسك بمنافسيك المحددين وبحصتك السوقية الفعلية بدلًا من ذلك.
ما هي حصة الصوت في الذكاء الاصطناعي؟
تقيس حصة الصوت في الذكاء الاصطناعي مقدار ما يخصّك من الحديث عن العلامات التجارية داخل إجابات الذكاء الاصطناعي. تحدد مجموعة من الأوامر التي يطرحها عملاؤك المحتملون، وتشغّلها على محركات مثل ChatGPT وClaude وGemini وPerplexity وميزات الذكاء الاصطناعي في Google، وتسجّل كل علامة تذكرها كل إجابة، ثم تحسب نصيبك من المجموع.
الفكرة مستعارة من عالم الإعلان. في تخطيط الوسائط التقليدي كانت حصة الصوت تعني نصيب العلامة من إجمالي الظهور الإعلاني في فئتها، وقد رأى جون فيليب جونز (John Philip Jones) في مقال في Harvard Business Review عام 1990 أن مقارنة حصة الصوت بالحصة السوقية طريقة أفضل لتحديد الميزانيات. تحتفظ حصة الصوت في الذكاء الاصطناعي بالنسبة نفسها، لكنها تستبدل الظهور المدفوع بشيء لا يمكنك شراؤه مباشرة: أن يُذكر اسمك في الإجابة.
تتفق الشركات التي تتتبّع هذا المقياس على النسبة الأساسية. يعرّف مسرد Profound حصة الصوت بأنها «عدد مرات ذكر علامتك مقارنةً بكل العلامات»، وتقدّم وثائق Peec AI المعادلة على أنها إشاراتك مقسومة على إجمالي إشارات العلامات، مضروبة في 100.
ما الفرق بين حصة الصوت ومعدل الإشارة أو الظهور؟
معدل الإشارة (ويُسمّى أيضًا الظهور أو معدل الحضور) يسأل: «في أي نسبة من الإجابات ظهرنا؟» أما حصة الصوت فتسأل: «ما نسبة إشاراتنا من مجموع إشارات العلامات؟» الفرق كله في المقام: الإجابات مقابل الإشارات.
العلامة التي تظهر في كل إجابة يكون معدل إشارتها 100%، لكن إذا ظهرت أربع علامات أخرى في كل إجابة أيضًا، فحصة صوتها 20% فقط. ويوضح مثال Peec نفسه هذه الفجوة: 4 إشارات مقابل 12 لمنافس عبر 10 محادثات تعني ظهورًا بنسبة 40% لكن حصة صوت بنسبة 25%. بعض الأدلة الشائعة تنشر معادلة معدل الحضور تحت اسم حصة الصوت، وهذا أحد أسباب نادرة تطابق الأرقام المنشورة. اعرض المقياسين معًا، وسمِّ كلًّا منهما باسمه، ولا تستبدل أحدهما بالآخر بين فترة تقرير وأخرى.
ومقاييس الإشارة لا تقول شيئًا عن الزيارات. الإشارة تضع اسمك أمام المستخدم، أما الاستشهاد فيمنحه رابطًا. نشرح لماذا يغيّر هذا الفرق طريقة قراءتك للتقرير في مقال إشارات العلامة مقابل الاستشهادات في بحث الذكاء الاصطناعي.
كيف تحسب حصة الصوت في الذكاء الاصطناعي؟ المعادلات الثلاث
استخدم معادلة واحدة لكل سؤال تريد الإجابة عنه، واعرض النتائج جنبًا إلى جنب بدلًا من دمجها في درجة واحدة.
| المقياس | المعادلة | وحدة العدّ | السؤال الذي يجيب عنه |
|---|---|---|---|
| حصة الصوت من الإشارات | إشارات علامتك / مجموع إشارات العلامات × 100 | اسم العلامة الوارد في نص الإجابة، مرة واحدة على الأكثر لكل إجابة | كم نملك من الحديث عن التوصيات؟ |
| حصة الصوت من الاستشهادات | الاستشهادات بنطاقك / الاستشهادات بنطاقات كل العلامات المتتبَّعة × 100 | رابط مصدر يقع على نطاق تملكه علامة تجارية | حين تشير الإجابات إلى موقع علامة ما، كم مرة يكون موقعنا؟ |
| حصة الصوت الموزونة بالترتيب | مجموع أوزانك / مجموع أوزان كل العلامات × 100، حيث الوزن = 1 / الترتيب | كل إشارة، موزونة بموقعها في الإجابة | هل نحن الاسم الأول أم مجرد إضافة في الذيل؟ |
| معدل الإشارة (للسياق) | الإجابات التي تذكر علامتك / كل الإجابات × 100 | الإجابات | كم مرة نظهر أصلًا؟ |
حصة الصوت من الإشارات
هذه هي الصيغة الافتراضية، وهي التي توثّقها Profound وPeec. احسب كل علامة مرة واحدة على الأكثر في كل إجابة حتى لو ذكرتها الإجابة ثلاث مرات، وإلا ستطغى الإجابات الطويلة على المجموع. وأدخل في المقام كل علامة تذكرها الإجابة، لا المنافسين الذين اخترت تتبّعهم فقط؛ وسيشرح القسم الخاص بمجموعات المنافسين السبب.
حصة الصوت من الاستشهادات
تتتبّع حصة الصوت من الاستشهادات الروابط أسفل الإجابة، لا الأسماء داخلها. معظم الاستشهادات في إجابات الذكاء الاصطناعي تذهب إلى مواقع طرف ثالث: في لوحة Trakkr التي ضمّت 48.4 مليون ظهور استشهادي عبر 529,165 نطاقًا (من أكتوبر 2025 إلى أغسطس 2026)، استحوذ النطاق الأكثر استشهادًا، youtube.com، على 3.47% من الإجمالي، تلاه Wikipedia بنسبة 1.83% ثم Reddit بنسبة 1.74%. لهذا السبب تقسم الصيغة التنافسية للمعادلة على الاستشهادات بنطاقات العلامات المتتبَّعة نفسها. وإذا كنت تفضّل الحصة من كل الاستشهادات (تسمّيها Profound «Citation Share»)، فاعرضها منفصلة وتوقّع أرقامًا من خانة واحدة.
وحصة الاستشهادات مركّزة أيضًا على مستوى عناوين URL. وجد تحليل Peec AI لـأكثر من مليون استشهاد أن 31% من عناوين URL في ChatGPT، وهي التي يُستشهد بها مرتين أو أكثر في المتوسط لكل إجابة، تستحوذ على 59% من كل الاستشهادات، وأن 64% من عناوين URL التي يجلبها Perplexity لا يُستشهد بها إطلاقًا. عادةً ما تحمل بضع صفحات فقط حصتك الكاملة من الاستشهادات.
حصة الصوت الموزونة بالترتيب
يمنح الوزن حسب الترتيب الإشارة الأولى قيمة أكبر من الخامسة. الطريقة الشائعة هي 1/الترتيب: الأول = 1.0، والثاني = 0.5، والثالث = 0.33، وهكذا. تقول Semrush إن حصة الصوت في Enterprise AIO لديها تأخذ في الحسبان التكرار والترتيب معًا، لكنها لا تنشر الأوزان.
تعامَل معها كمقياس ثانوي. شغّلت SparkToro وGumshoe.ai اثني عشر أمرًا على ChatGPT وClaude والذكاء الاصطناعي في Google 2,961 مرة، ووجدتا أن احتمال الحصول على قائمة العلامات نفسها مرتين أقل من 1 في 100، وأن الترتيب نفسه يتكرر نحو مرة واحدة في كل 1,000 تشغيل. وخلصتا إلى أن نسبة الظهور عبر أوامر وتشغيلات كثيرة مقياس معقول، بينما «ترتيب» واحد ليس كذلك. فعند حساب المتوسط على مئات الإجابات، يظل الترتيب يميّز بين «الأول عادةً» و«الأخير عادةً»؛ أما في إجابة واحدة فهو مجرد ضجيج.
مثال تطبيقي: مجموعة بيانات واحدة وأربعة أرقام مختلفة
الأرقام أدناه مجموعة بيانات توضيحية أعددناها لنبيّن كيف تتباعد المعادلات، وهي ليست بيانات عملاء. الإعداد: 20 أمرًا، و4 محركات، و3 تشغيلات لكل منها، أي 240 إجابة. ذكرت 228 إجابة منها علامة واحدة على الأقل، بإجمالي 480 إشارة للعلامات، وتضمّنت الإجابات 1,440 استشهادًا. و«أخرى» هي العلامات التي ذكرتها المحركات ولم يضعها الفريق على قائمة التتبّع.
| العلامة | الإجابات التي تذكرها (معدل الإشارة) | الإشارات حسب الترتيب (الأول / الثاني / الثالث / الرابع فأكثر) | حصة الصوت من الإشارات | حصة الصوت الموزونة بالترتيب | الاستشهادات بالنطاق الخاص | حصة الصوت من الاستشهادات (المجموعة المتتبَّعة) |
|---|---|---|---|---|---|---|
| علامتك | 84 (35.0%) | 24 / 30 / 18 / 12 | 17.5% | 14.3% | 66 | 44.0% |
| المنافس A | 132 (55.0%) | 90 / 30 / 9 / 3 | 27.5% | 32.5% | 48 | 32.0% |
| المنافس B | 96 (40.0%) | 54 / 30 / 9 / 3 | 20.0% | 21.7% | 30 | 20.0% |
| المنافس C | 60 (25.0%) | 18 / 24 / 12 / 6 | 12.5% | 10.6% | 6 | 4.0% |
| أخرى (غير متتبَّعة) | - | 42 / 36 / 24 / 6 | 22.5% | 20.8% | - | - |
| الإجمالي | 240 إجابة | 228 / 150 / 72 / 30 | 480 إشارة | 334.5 وزنًا | 150 | 100% |
هكذا تُبنى الأرقام لعلامتك:
- معدل الإشارة: 84 إجابة / 240 إجابة = 35.0%.
- حصة الصوت من الإشارات: 84 / 480 إشارة = 17.5%.
- حصة الصوت الموزونة بالترتيب: (24 × 1) + (30 × 0.5) + (18 × 0.333) + (12 × 0.25) = 48.0 وزنًا؛ 48.0 / 334.5 = 14.3%. المراتب الرابعة فما دونها تُحسب هنا على أنها 4.
- حصة الصوت من الاستشهادات: 66 / 150 استشهادًا بنطاقات العلامات المتتبَّعة = 44.0%. وكنسبة من كل الاستشهادات البالغة 1,440 تكون 4.6%.
- حصة الصوت في المجموعة المغلقة: احذف «أخرى» من المقام فتصبح حصة الإشارات 84 / 372 = 22.6%.
في هذا الجدول الواحد أربعة دروس. أولًا، العلامة نفسها تحتل المركز الثالث في الإشارات، وتتراجع أكثر في الترتيب، لكنها تتصدر في الاستشهادات، وهو نمط شائع لدى العلامات التي يكون محتواها قويًا بينما علامتها أقل شهرة من رائد الفئة. ثانيًا، رقم المجموعة المغلقة يجمّل صورة الجميع بنحو الخُمس. ثالثًا، ذهب 22.5% من الحديث إلى علامات لم يكن أحد يتتبّعها، وهذا هو الإنذار المبكر الذي تخفيه القائمة المغلقة. رابعًا، حصة الاستشهادات من كل المصادر (4.6%) وحصة الاستشهادات من المجموعة المتتبَّعة (44.0%) مقياسان مختلفان بحجمين متباعدين جدًا، لذا يجب أن يوضّح التقرير أيّهما يعرض.
كيف تحسب حصة الصوت في الذكاء الاصطناعي في جدول بيانات؟
سجّل صفًا لكل إجابة، وصفًا لكل إشارة إلى علامة، وصفًا لكل استشهاد، ثم دع المعادلات تتولى العدّ. يعمل هذا التنظيم في Google Sheets وExcel.
- ورقة الإجابات (Answers): answer_id وprompt وengine وrun_date. صف لكل إجابة، بما فيها الإجابات التي لا تذكر أي علامة، لأنها تدخل في مقام معدل الإشارة.
- ورقة الإشارات (Mentions): answer_id (العمود A) وbrand (العمود B) وposition (العمود C). صف لكل علامة في كل إجابة، وكل علامة مرة واحدة على الأكثر لكل إجابة. وحّد الأسماء أولًا: اجعل «HubSpot CRM» و«HubSpot» علامة واحدة، وقرّر مسبقًا هل يُحسب المنتج والشركة الأم علامة واحدة أم اثنتين.
- ورقة الاستشهادات (Citations): answer_id (A) وcited_url (B) وdomain (C) وowner_brand (D). اترك owner_brand فارغًا إذا كان النطاق ملكًا لطرف ثالث مثل Reddit أو YouTube أو موقع مراجعات.
- ورقة الملخص (Summary): ضع اسم كل علامة في العمود H، ثم استخدم المعادلات أدناه في الصف نفسه.
| المقياس | المعادلة (اسم العلامة في H2) |
|---|---|
| معدل الإشارة | =COUNTIF(Mentions!B2:B5000,H2)/COUNTA(Answers!A2:A5000) |
| حصة الصوت من الإشارات | =COUNTIF(Mentions!B2:B5000,H2)/COUNTA(Mentions!B2:B5000) |
| حصة الصوت الموزونة بالترتيب | =SUMPRODUCT(IFERROR((Mentions!B2:B5000=H2)/Mentions!C2:C5000,0))/SUMPRODUCT(IFERROR(1/Mentions!C2:C5000,0)) |
| حصة الصوت من الاستشهادات (المجموعة المتتبَّعة) | =COUNTIF(Citations!D2:D5000,H2)/COUNTA(Citations!D2:D5000) |
| حصة الاستشهادات من كل المصادر | =COUNTIF(Citations!D2:D5000,H2)/COUNTA(Citations!B2:B5000) |
| هامش الخطأ عند 95% (الحصة في I2، وn في J2) | =1.96*SQRT(I2*(1-I2)/J2) |
نسّق النتائج كنسب مئوية. تحتاج المعادلة الموزونة بالترتيب إلى Excel 365 أو Google Sheets لتقييم IFERROR داخل SUMPRODUCT؛ أما في إصدارات Excel الأقدم فأدخلها كمعادلة صفيف (array formula). أضف عامل تصفية لعمود المحرك (أو جدولًا محوريًا) لتحصل على المقاييس نفسها لكل محرك على حدة، وهي أرقام ينبغي أن تنظر إليها دائمًا قبل الرقم المجمّع.
كيف تعرّف Profound وPeec AI وSemrush وAhrefs حصة الصوت؟
لا تعرّفها بالطريقة نفسها، لذا فإن 30% في أداة و30% في أداة أخرى ليسا الإنجاز نفسه. إليك ما تقوله وثائق كل شركة، وقد تحقّقنا منها في 18 أكتوبر 2026.
| الأداة | ما تعدّه حصة الصوت فيها | الترجيح | مصدر الأوامر | المصدر |
|---|---|---|---|---|
| AI Rank Lab | إشاراتك / (إشاراتك + إشارات المنافسين الذين تحددهم)، عبر التشغيلات المجدولة | لا ترجيح في الحصة؛ متوسط الترتيب ومعدل الإشارة ومعدل الاستشهاد تُعرض منفصلة | مجموعة أوامرك | منتجنا (انظر الإفصاح أدناه) |
| Profound | إشارات العلامة / كل إشارات العلامات عبر الإجابات المتتبَّعة؛ أما Citation Share وVisibility Score فمقياسان منفصلان | غير مذكور؛ Average Position منفصل | أوامرك المتتبَّعة | مسرد Profound |
| Peec AI | إشاراتك / إجمالي إشارات العلامات × 100 | لا يوجد؛ الترتيب والانطباع (Sentiment) منفصلان | أوامرك المتتبَّعة | وثائق Peec |
| Semrush AI Visibility Toolkit | «نسبة الإشارات التي تحصل عليها علامتك في الإجابات المولَّدة بالذكاء الاصطناعي مقارنةً بالمنافسين في سوقك»؛ تُحدَّث بيانات Brand Performance أسبوعيًا | تقول Semrush إن نسخة Enterprise AIO تأخذ في الحسبان التكرار والترتيب؛ الأوزان الدقيقة غير منشورة | قاعدة أوامر Semrush إضافةً إلى الأوامر المتتبَّعة | قاعدة معارف Semrush |
| Ahrefs Brand Radar | «نسبة مرات ظهور العلامة التي تملكها مقارنةً بالمنافسين» | إشارات موزونة بحجم البحث في Google للأمر، وتصف Ahrefs ذلك بأنه «خيار نمذجة، لا علاقة مقيسة» | مجموعة أسئلة People Also Ask (أسئلة ذات صلة) في Google وقاعدة كلمات Ahrefs المفتاحية، لا أوامرك أنت | منهجية Ahrefs |
يترتب على ذلك أمران عمليان. تجيب Ahrefs عن سؤال «كم نملك من السوق موزونًا بحجم الطلب؟» من دون أن تبني مجموعة أوامر، بينما تجيب Profound وPeec وAI Rank Lab عن سؤال «كيف أداؤنا في الأوامر التي اخترناها؟». كلا النهجين مشروع، ولن تتطابق نتائجهما. ولأن أيًّا من هذه الأدوات لا يرى ما يجري داخل المحركات، فكلها تأخذ عينات من الإجابات؛ بل إن Google نفسها تقول إن تقرير أداء الذكاء الاصطناعي التوليدي الجديد في Search Console (يونيو 2026) يعرض مرات ظهورك وصفحاتك ودولك وأجهزتك في AI Overviews (ملخصات الذكاء الاصطناعي في Google) وAI Mode، من دون أي بيانات عن المنافسين. لذلك يجب أن تأتي حصة الصوت على واجهات الذكاء الاصطناعي في Google من أداة تتبّع، وأن تُقرأ بجانب أرقام Search Console لا بدلًا منها. تتعمق مراجعتنا لـSemrush AI Visibility Toolkit في طريقة جمع Semrush لبياناتها.
كيف تختار مجموعة الأوامر ومجموعة المنافسين؟
المعادلة تستغرق دقيقة؛ أما مجموعة الأوامر وقائمة المنافسين فهما ما يقرر إن كان للرقم معنى أصلًا. ثبّت الاثنتين قبل أول قياس، ولا تغيّرهما إلا مع خط أساس جديد.
بناء مجموعة الأوامر
- ابدأ من أسئلة المشترين لا من تموضعك. اقتبس الصياغات من مكالمات المبيعات وتذاكر الدعم والبحث داخل الموقع ونقاشات Reddit وPeople Also Ask. الأوامر المكتوبة حول شعاراتك التسويقية تضخّم حصتك.
- غطِّ مراحل القمع بنسب ثابتة. على سبيل المثال: 50% أوامر عن الفئة و«أفضل X لـY»، و30% أوامر مقارنة وبدائل، و20% أوامر عن مشكلات أو «كيف أفعل». حافظ على ثبات النسب حتى لا يبدو تغيّر التركيبة كأنه تغيّر في الحصة.
- استبعد الأوامر التي تحمل اسم علامتك من الرقم الرئيسي. سؤال مثل «هل [علامتك] جيدة؟» سيذكرك في كل مرة. تتبّع هذه الأوامر في مجموعة منفصلة لقياس الدقة والانطباع.
- صنّف كل أمر حسب الموضوع ومرحلة القمع والشخصية المستهدفة والسوق، لتتمكن من عرض حصة الصوت لكل شريحة، لا رقمًا واحدًا ممزوجًا فحسب.
- اجعل الحجم على قدر القرار. تبدأ عدة أدلة منشورة بـ20 إلى 50 أمرًا ذا صلة تجارية، وتوصي أخرى بـ100 إلى 200 للفئات الواسعة. يوضح قسم حجم العينة أدناه لماذا تتفوق زيادة الأوامر عادةً على زيادة التشغيلات.
ولأن المحركات توسّع كل أمر إلى استعلامات فرعية كثيرة قبل جلب المصادر، فقد تُرجع إعادة الصياغة القريبة علامات مختلفة. وهذا سبب وجيه لإدراج صيغتين أو ثلاث لأهم أسئلتك بدلًا من صيغة واحدة.
اختيار المنافسين: مجموعة مفتوحة أم مغلقة؟
استخدم مجموعة مفتوحة للمقام وقائمة محددة للتقارير. المجموعة المفتوحة تَعُدّ كل علامة تذكرها الإجابات، أما المغلقة فتَعُدّ المنافسين الذين أدخلتهم فقط. المجموعات المغلقة أبسط وقابلة للمقارنة عبر الزمن، لكنها تبالغ في حصة الجميع وتفوّت الداخلين الجدد، كما تُظهر نسبة 22.5% لفئة «أخرى» في المثال التطبيقي.
- القائمة المحددة: من 5 إلى 8 منافسين مباشرين تخسر أمامهم الصفقات، إضافةً إلى رائد أو اثنين من رواد الفئة تطمح إلى منافستهم.
- جولة الاستكشاف: مرة كل شهر، اجمع كل علامة ذكرتها المحركات وليست على قائمتك. أي علامة تظهر في أكثر من نسبة مئوية صغيرة من الإجابات تنضم إلى القائمة في خط الأساس التالي.
- قواعد الكيانات: دوّن كيف تتعامل مع الأسماء البديلة والعلامات الفرعية والموزعين والأسواق الإلكترونية (هل «Amazon» منافس أم قناة بيع؟)، وطبّق القاعدة نفسها في كل فترة.
إذا كانت أداتك لا تدعم إلا قائمة مغلقة، فاذكر ذلك في كل تقرير وأبقِ القائمة ثابتة، حتى يظل الاتجاه صادقًا وإن كان المستوى مرتفعًا.
كم أمرًا وكم تشغيلًا تحتاج للحصول على رقم موثوق؟
ما يكفي لأن يكون التغيّر الذي يهمك أكبر من الضجيج. إجابات الذكاء الاصطناعي لا تتكرر بالشكل نفسه، فكل إجابة عينة، وحصة صوت محسوبة من بضع عشرات من الإجابات قد تتأرجح بعشرات النقاط من دون أن يتغير شيء فعلًا.
وبياناتنا الخاصة تُظهر حجم ذلك. عبر 968 تشغيلًا ناجحًا لـ42 زوجًا من الأوامر والمحركات تتبّعناها في AI Rank Lab بين 13 فبراير و14 أكتوبر 2026 (الأزواج التي لها 5 تشغيلات أو أكثر فقط)، تقلّب 18 زوجًا (42.9%) مرة واحدة على الأقل بين ذكر العلامة المتتبَّعة وعدم ذكرها، ولم يشترك تشغيلان متتاليان للأمر نفسه إلا في 41% فقط من النطاقات المستشهد بها (بالوسيط). وكانت المصادر الأكثر تبدّلًا في Gemini (وسيط التداخل 0.26) والأقل تبدّلًا في Perplexity (0.59). المنهجية الكاملة وحدودها في دراستنا عن ثبات إجابات الذكاء الاصطناعي. وحتى الإعدادات «الحتمية» لا تحل المشكلة: وجدت دراسة على خمسة نماذج لغوية كبيرة مضبوطة على الحتمية أن الدقة تفاوتت بما يصل إلى 15% بين التشغيلات.
والبيانات نفسها تخبرك أين تنفق ميزانية العينة. أعطى 24 زوجًا من أصل 42 (57%) الحكم نفسه بشأن الإشارة في كل تشغيل، أي أن التشغيلات الإضافية لم تضف تقريبًا أي معلومة جديدة لتلك الأوامر. والتشغيلات المتكررة للأمر الواحد مترابطة، ما يعني أن 20 أمرًا مُشغَّلة 10 مرات تساوي أقل بكثير من 200 إجابة مستقلة. أضف أوامر قبل أن تضيف تشغيلات، واحتفظ بتشغيلين إلى ثلاثة لكل أمر على كل محرك في كل فترة لتخفيف التقلبات، واجمع التشغيلات على فترة من أسبوعين إلى 4 أسابيع.
لتقدير الخطأ، عامِل حصة الصوت كنسبة واستخدم فترة التقريب الطبيعي المعيارية، p ± 1.96 × sqrt(p(1-p)/n)، من دليل NIST للإحصاء الهندسي. وللحصول على قيمة n متحفظة، استخدم عدد أزواج الأوامر والمحركات المختلفة، لا عدد الإجابات.
| n (أزواج الأوامر والمحركات) | هامش 95% إذا كانت حصتك نحو 20% | هامش 95% إذا كانت حصتك نحو 50% | ما الذي يمكنه رصده |
|---|---|---|---|
| 50 | ± 11.1 نقطة | ± 13.9 نقطة | الفجوات الكبيرة بين العلامات فقط |
| 100 | ± 7.8 نقطة | ± 9.8 نقطة | تحركات ربع سنوية بـ10 نقاط فأكثر |
| 200 | ± 5.5 نقطة | ± 6.9 نقطة | تحركات من 6 إلى 7 نقاط |
| 400 | ± 3.9 نقطة | ± 4.9 نقطة | تحركات من 4 إلى 5 نقاط |
| 1,000 | ± 2.5 نقطة | ± 3.1 نقطة | مكاسب صغيرة ومطّردة |
بالتطبيق على المثال: 20 أمرًا على 4 محركات تعني 80 زوجًا من الأوامر والمحركات، فحصة صوت من الإشارات قدرها 17.5% يرافقها هامش يقارب ± 8.3 نقطة. أي أن الانتقال من 17.5% إلى 22% في الشهر التالي يبقى ضمن الضجيج. وتشير صفحة NIST أيضًا إلى أن هذه الفترة تفقد موثوقيتها مع العينات الصغيرة جدًا أو الحصص القريبة من 0%، وعندها تكون فترة Wilson الخيار الأفضل؛ وإذا كانت أداتك تدعم إعادة المعاينة حسب الأمر (bootstrap) فهذا أفضل.
هل تدمج المحركات في حصة صوت واحدة؟
اعرض كل محرك على حدة أولًا، ثم رقمًا مجمّعًا مع توثيق طريقة الترجيح. المحركات لا تتفق: وجد معيار Trakkr للمحركات على 825,343 أمرًا متوسط اتفاق بين النماذج قدره 43.3%، وقد تتصدر علامة في محرك بينما تغيب تمامًا عن آخر. لا بأس بجمع الأعداد الخام عبر المحركات إذا حصل كل محرك على عدد الإجابات نفسه. وإذا أردت ترجيح المحركات حسب أهميتها، فرجّحها حسب المكان الذي يوجد فيه جمهورك فعلًا. وكنقطة مرجعية، أرسل ChatGPT 56.8% من 3,677 مشاهدة صفحة قادمة من الذكاء الاصطناعي سجّلها وسم AI Rank Lab عبر 28 موقعًا (من يوليو 2025 إلى أكتوبر 2026)، تلاه Gemini (17.1%) ثم Perplexity (12.4%) ثم Claude (12.0%) ثم Copilot (1.7%). حصة الإحالات ليست حصة الاستخدام، وأرقامك ستختلف، فقِس أرقامك قبل استخدامها كأوزان.
ما هي حصة الصوت الجيدة في الذكاء الاصطناعي؟
لا يوجد معيار عالمي موثّق المصدر، وينبغي أن تحذر ممن يقدّم لك رقمًا من دون منهجية. فـ«الجيد» يتوقف على عدد العلامات التي تتنافس في إجاباتك، وعلى فئتك، وعلى المعادلة المستخدمة.
وتتضارب النطاقات المنشورة جزئيًا لأنها تقيس أشياء مختلفة:
| المصدر | المقياس الذي ينطبق عليه النطاق | نطاق «الريادة» | هل هو موثّق؟ |
|---|---|---|---|
| Alex Birkett | الإجابات التي تذكرك / كل الإجابات (معدل حضور) | من 50% إلى 90% | خبرة المؤلف، أوامر أسفل القمع |
| LLM Pulse | حصة الإشارات من كل إشارات العلامات | من 40% إلى 70% | لا يذكر مصدرًا |
| geotoolbox | حصة الإشارات من كل إشارات العلامات | 50% فأكثر | خلاصة لأدلة أخرى، موصوفة بأنها للاسترشاد فقط |
معدل حضور بنسبة 60% وحصة إشارات بنسبة 60% موقعان مختلفان تمامًا، لذلك لا يمكن مقارنة هذه النطاقات ببعضها أو برقم أداتك ما لم تتطابق المعادلة. أما النقاط المرجعية الموثّقة فهي:
- خط الحصة العادلة. إذا كانت هناك N علامة تُذكر بانتظام، فالتقسيم المتساوي هو 100 / N. مع خمس علامات تكون 20% هي نقطة التعادل، وما فوقها يعني أنك تتفوق على نصيبك. تقترح Trakkr هذا الخط للاسترشاد لا كهدف.
- التفاوت بين الفئات هائل. في دراسة SparkToro، ظهرت علامة مستشفى في 97% من إجابات ChatGPT لاستعلامها، وظهرت علامات سماعات الرأس في 55% إلى 77%، بينما لم تتجاوز وكالات تصميم الهوية التجارية نطاق الثلاثينيات والأربعينيات بالمئة. قارن داخل فئتك، ولا تقارن بين الفئات أبدًا.
- حصة الاستشهادات من كل المصادر تبقى صغيرة. إذا كان النطاق الأكثر استشهادًا في لوحة تضم 48 مليون استشهاد يملك 3.47%، فإن حصة استشهادات من خانة واحدة من كل المصادر قد تعني موقعًا رياديًا.
- حصة الصوت مقابل الحصة السوقية. باستعارة منطق جونز، فإن أفيد معيار هو مقارنة حصة صوتك في الذكاء الاصطناعي بحصتك السوقية الفعلية. إذا كانت حصة صوتك أقل من حصتك السوقية، فإجابات الذكاء الاصطناعي تُظهرك أقل من حجمك الحقيقي، وهذه مشكلة ملموسة يجب إصلاحها.
المعيار الأهم هو اتجاهك أنت مقابل المنافسين المحددين أنفسهم، على مجموعة الأوامر نفسها، بما يتجاوز هامش الخطأ. وإذا كنت تتتبّع أيضًا درجة مركّبة، فإن شرحنا حول طريقة قياس درجة AEO يوضح كيف تمزج هذه الدرجات تلك المدخلات.
كيف تعرض حصة الصوت في الذكاء الاصطناعي على الإدارة؟
قدّم جدولًا واحدًا وخط اتجاه واحدًا وقرارًا واحدًا. تحتاج الإدارة إلى معرفة ما إذا كان التغيّر حقيقيًا، ومن تحرّك، وماذا ستفعل، لا إلى سجلات الأوامر الخام. هكذا يبدو صف في التقرير (قيم المثال من مجموعة البيانات التطبيقية، مع فترة سابقة افتراضية):
| المقياس | هذه الفترة | الفترة السابقة | التغيّر | الهامش (±) | القراءة |
|---|---|---|---|---|---|
| معدل الإشارة | 35.0% | 22.5% | +12.5 نقطة | 10.5 نقطة | إشارة حقيقية - تأكّد في الفترة القادمة |
| حصة الصوت من الإشارات | 17.5% | 15.0% | +2.5 نقطة | 8.3 نقطة | ضمن الضجيج - لا تغيير |
| حصة الصوت من الاستشهادات (المجموعة المتتبَّعة) | 44.0% | 36.0% | +8.0 نقطة | 10.9 نقطة | ضمن الضجيج - راقب |
| حصة الإشارات لأقوى منافس | 27.5% (A) | 29.0% (A) | -1.5 نقطة | 9.8 نقطة | بلا تغيير |
| حصة العلامات غير المتتبَّعة | 22.5% | 18.0% | +4.5 نقطة | - | نفّذ جولة استكشاف |
وحول هذا الجدول، اجعل التقرير في صفحة واحدة:
- سطر النطاق: الأوامر والمحركات والأسواق والتشغيلات والفترة والمعادلة، مثل: «80 زوجًا من الأوامر والمحركات، 4 محركات، الإنجليزية الأمريكية، 240 إجابة، من 15 سبتمبر إلى 12 أكتوبر، حصة إشارات بمجموعة مفتوحة».
- العنوان الرئيسي: جملة واحدة عن التغيّر الذي تجاوز هامش الخطأ، أو «لا تغيير ذو دلالة».
- التقسيم حسب المحرك: جدول صغير، لأن الرقم المجمّع قد يخفي تراجعًا في محرك بعينه.
- عرض الشرائح: حصة الصوت حسب مرحلة القمع أو الموضوع، فمن هنا تنبثق الإجراءات.
- المحرّكات: الصفحات المستشهد بها ومصادر الطرف الثالث التي تقف وراء أكبر التحركات، من بيانات الاستشهادات لديك.
- الإجراءات والمسؤولون: إصلاحان أو ثلاثة، كل منها مرتبط بشريحة من الأوامر.
ما يجب تجنّبه: لا تعرض تشغيلًا واحدًا على أنه اتجاه، ولا تغيّر مجموعة الأوامر من دون إعادة ضبط خط الأساس، ولا تقدّم الحصة الموزونة بالترتيب على أنها «ترتيبنا في ChatGPT».
أدوات تؤتمت تتبّع حصة الصوت في الذكاء الاصطناعي
إفصاح: AI Rank Lab منتجنا. نذكره أولًا لأن هذا موقعنا، وقد طبّقنا المعايير نفسها على كل الأدوات أدناه. المعايير هي: أي معادلة توثّقها الأداة، وهل تتحكم أنت في مجموعة الأوامر، وماذا يمكنك أن تفعل بالنتيجة.
- AI Rank Lab. يشغّل تتبّع ظهور العلامة التجارية أوامرك على ChatGPT وClaude وGemini وPerplexity وفق جدول زمني، ويسجّل في كل تشغيل الإشارة والترتيب والانطباع والمنافسين المذكورين وعناوين URL المستشهد بها؛ وتغطي أداتا تتبّع منفصلتان لـAI Overview وAI Mode محرك Google. ويعرض تحليل المنافسين وأداة تتبّع الاستشهادات حصة الإشارات وحصة استشهادات المنافسين مقارنةً بالمنافسين الذين تحددهم، بينما تحوّل خطة العمل (Action Plan) وأدوات المحتوى الفجوات إلى إصلاحات. تبدأ الخطط من 69 دولارًا أمريكيًا شهريًا (تحقّقنا من الأسعار في 18 أكتوبر 2026). القيد: حصة الصوت فيه تعتمد على المنافسين الذين تُدخلهم، أي مجموعة مغلقة، لذا نفّذ جولة استكشاف دورية للعلامات غير المدرجة.
- Profound. مسرد عام واضح يعرّف Share of Voice وVisibility Score وCitation Share وAverage Position كلًّا على حدة، مع عرض مصفوفي عبر المحركات والمواضيع والمنافسين. خيار قوي لفرق المؤسسات الكبيرة التي تريد الحوكمة والقدرة على التوسع.
- Peec AI. يوثّق معادلة بسيطة لحصة الإشارات مع مثال تطبيقي، ويبقي الظهور والترتيب والانطباع مقاييس منفصلة، ما يجعل أرقامه سهلة الاستنساخ في جدول بيانات. مناسب للفرق التي تريد إعدادًا بسيطًا وشفافًا.
- Semrush AI Visibility Toolkit. تقع حصة الصوت ضمن تقارير Brand Performance التي تُحدَّث أسبوعيًا، مع قاعدة أوامر كبيرة إلى جانب أوامرك المتتبَّعة. الخيار الأفضل إذا كان فريق SEO لديك يعمل أصلًا داخل Semrush، مع أن ترجيح الترتيب غير منشور.
- Ahrefs Brand Radar. يرجّح الإشارات حسب الطلب البحثي ويبني الأوامر من People Also Ask، فتحصل على حصة صوت على مستوى السوق من دون كتابة مجموعة أوامر. الأنسب حين تريد رؤية موزونة بالطلب لفئة كاملة بدلًا من أدائك في أسئلتك أنت.
- جدول بيانات. تعمل المعادلات أعلاه مع التسجيل اليدوي لـ20 إلى 50 أمرًا. إنه أرخص طريقة للبدء وأفضل طريقة لفهم معنى المقاييس، لكنه يتوقف عن التوسع حين تحتاج إلى تشغيلات يومية عبر عدة محركات.
حدود حصة الصوت في الذكاء الاصطناعي
- إنها عينة من أوامرك، لا من محادثات المستخدمين الحقيقية. لا تملك أي أداة رؤية لما سأله المستخدمون الفعليون أو ما عُرض عليهم، كما أن التخصيص والذاكرة والموقع الجغرافي تغيّر الإجابات.
- قد تختلف إجابات واجهة API عن إجابات التطبيقات. كثير من أدوات التتبّع تستعلم المحركات عبر واجهات API مع تفعيل البحث، وقد تتصرف تطبيقات المستهلكين بشكل مختلف.
- اكتشاف العلامات مؤتمت. الأسماء البديلة والأخطاء الإملائية والعلامات التي تحمل أسماء كلمات شائعة تسبب أخطاء في العدّ. افحص عينة من الإجابات يدويًا في كل فترة.
- الإشارة ليست تزكية. علامة تُذكر بعبارة «تجنّبها في المؤسسات» تُحسب أيضًا. اربط حصة الصوت بالانطباع أو بمؤشر يوضح ما إذا كانت الإجابة توصي بك.
- حصة الصوت ليست إيرادات. اربطها بزيارات الإحالة من الذكاء الاصطناعي وبخط المبيعات قبل أن تدّعي أثرًا تجاريًا.
الخلاصة
حصة الصوت في الذكاء الاصطناعي سهلة الحساب وسهلة الخطأ أيضًا. اختر المعادلة التي تجيب عن سؤالك، ودوّن قواعد العدّ، واستخدم مقامًا مفتوحًا، واجعل حجم عينتك كافيًا لتتجاوز التغيّرات هامش الخطأ، واعرض حصة الإشارات وحصة الاستشهادات ومعدل الإشارة معًا. وإذا كنت تفضّل ألا تدير جدول البيانات بنفسك، فإن تحليل المنافسين في AI Rank Lab يتتبّع الإشارات والاستشهادات وحصة المنافسين وفق جدول زمني، لتقرأ الاتجاهات بدلًا من اللقطات.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


