



جدل llms.txt: إشارة حقيقية أم مجرد وهم؟
منذ طرح مواصفة llms.txt، انقسم مجتمع تحسين محركات البحث (SEO) وتحسين محركات الإجابة (AEO) حولها. المؤيدون يرون أنها إشارة واضحة لأنظمة الذكاء الاصطناعي تخبرها بماهية موقعك وما يغطيه، أي إرشادات منظمة قد ترجّح كفتك حين يقرر النموذج المصدر الذي يستشهد به. أما المشككون فيرون أنها أحدث من أن يكون لها أثر يُذكر، وأن قلة من أنظمة الذكاء الاصطناعي تدعمها رسميًا، وأن التحسن في الاستشهادات الذي يُنسب إلى llms.txt سببه في الواقع تحسينات المحتوى التي تجريها الفرق في الوقت نفسه عند إضافة الملف.
أردنا أن نتجاوز التخمين. فباستخدام البنية التحتية لتتبع الاستشهادات في AI Rank Lab، حللنا 500 موقع قبل إضافة ملف llms.txt وبعدها، وتتبعنا معدلات الاستشهاد في ChatGPT (GPT-4o) وPerplexity وClaude 3.5 Sonnet على مدى 90 يومًا. ودرسنا كذلك ما الذي ميّز المواقع التي حققت قفزة كبيرة في الاستشهادات عن تلك التي لم يتغير وضعها إلا قليلًا.
إليك ما وجدناه، بما في ذلك الجوانب التي تتعارض مع أكثر الادعاءات تفاؤلًا حول llms.txt.
دراسة الـ500 موقع: المنهجية
تتبعنا 500 نطاق أضافت llms.txt لأول مرة خلال فترة تحليل امتدت ستة أشهر. وكانت جميع هذه النطاقات:
- تتيح أصلًا الوصول لزواحف الذكاء الاصطناعي (مع السماح لـ GPTBot وClaudeBot وPerplexityBot في robots.txt)
- تملك بيانات أساس للاستشهادات لمدة 30 يومًا على الأقل قبل إضافة llms.txt
- لم تُجرِ تغييرات كبيرة على المحتوى ولم تحصل على روابط خلفية جديدة مؤثرة خلال فترة القياس
- تضم ما بين 10 و500 صفحة (استبعدنا المواقع الصغيرة جدًا والكبيرة جدًا للحد من العوامل المربكة)
عرّفنا معدل الاستشهاد بأنه: عدد المرات التي استشهد فيها نموذج لغوي كبير (LLM) بالنطاق عند الرد على استعلام ضمن المجموعة الموضوعية الرئيسية لذلك النطاق، معبَّرًا عنه كنسبة مئوية من الاستعلامات المختبرة. واختبرنا 50 استعلامًا لكل نطاق في كل نموذج، مأخوذة من مجموعة الكلمات المفتاحية الرئيسية للنطاق.
وشملت المواقع 12 قطاعًا: البرمجيات كخدمة (SaaS)، والتجارة الإلكترونية، والخدمات المحلية، وخدمات الشركات (B2B)، والنشر، والرعاية الصحية، والقانون، والخدمات المالية، والتعليم، والعقارات، والسفر، وأخبار التقنية.
النتيجة الأولى: llms.txt يرفع معدلات الاستشهاد، لكن ليس في كل النماذج
على مستوى المواقع الـ500 كلها، رصدنا التغيرات التالية في متوسط معدل الاستشهاد خلال الأيام الـ90 التي تلت إضافة llms.txt:
- Perplexity: تحسن بمتوسط +18% في معدل الاستشهاد
- ChatGPT (مع التصفح Browse): تحسن بمتوسط +12% في معدل الاستشهاد
- Claude: تحسن بمتوسط +7% في معدل الاستشهاد
- ChatGPT (دون التصفح، نموذج GPT-4o الأساسي): +3% (غير دال إحصائيًا)
الفارق بين النماذج كبير، ولا تفسّره بالكامل الاختلافات في سلوك الزحف. فاستجابة Perplexity الأقوى تعكس على الأرجح بنيته القائمة على البحث في الويب لحظيًا، إذ يستخدم ملفات الإرشاد المنظمة فعليًا عند صياغة إجاباته. ويُظهر وضع Browse في ChatGPT (الذي يجلب محتوى الويب المباشر) تحسنًا ملموسًا، في حين لا يتغير نموذج GPT-4o الأساسي (الذي يعتمد أساسًا على بيانات التدريب) إلا قليلًا عند إضافة ملف واحد.
ويتسق التحسن المعتدل في Claude مع النهج الذي نشرته Anthropic: فـ ClaudeBot يزحف إلى ملفات الإرشاد ويحترمها، لكن بيانات تدريب Claude تتجدد على دورة أطول من الاسترجاع اللحظي في Perplexity. التحسن حقيقي، لكنه يحتاج وقتًا أطول ليظهر.
النتيجة الثانية: جودة الملخص في llms.txt هي العامل الحاسم
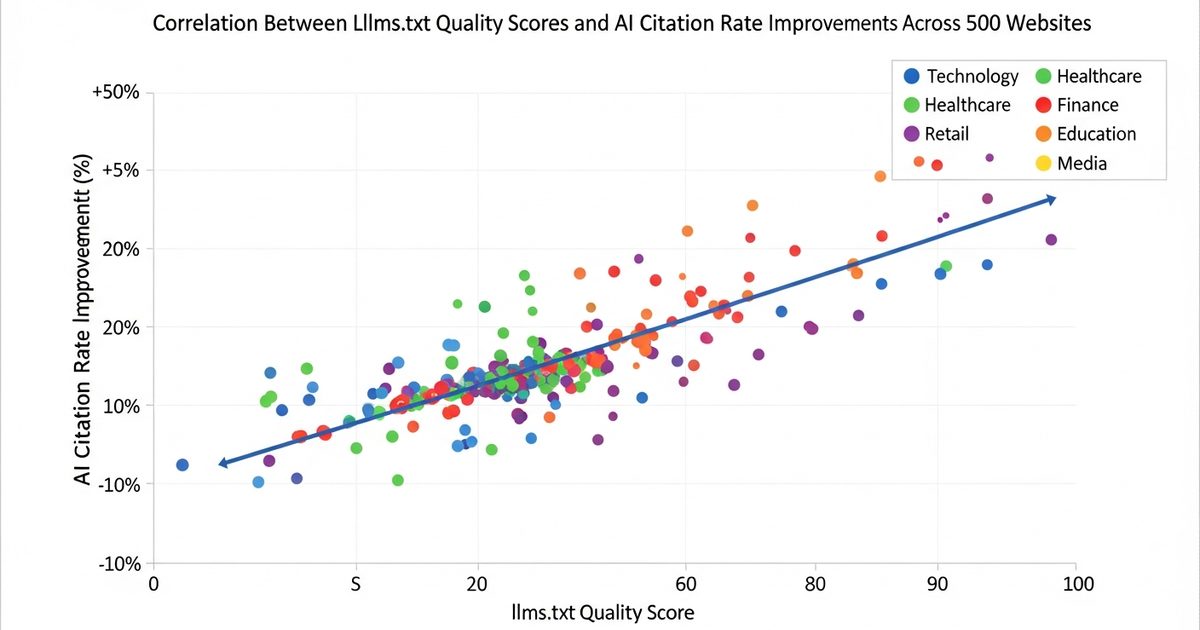
المواقع التي حققت أكبر تحسن في الاستشهادات (الربع الأعلى، بمتوسط زيادة +31% في معدل الاستشهاد) جمعها قاسم مشترك واحد: ملخصات (blockquote) محددة للغاية تصف بوضوح ما يميزها وجمهورها والموضوعات التي تغطيها.
قيّمنا ملخص llms.txt لكل موقع وفق خمسة معايير:
- تحديد الجمهور (لمن هذا الموقع؟)
- وضوح التميّز (ما الذي يجعل هذا الموقع مختلفًا؟)
- اكتمال تغطية الموضوعات (ما الموضوعات التي يغطيها؟)
- إشارات الموثوقية (أي مؤشرات مصداقية مثل البيانات أو الخبرة أو المنهجية)
- سياق الاستخدام (ماذا يستطيع القراء أن يفعلوا بهذا الموقع؟)
المواقع التي حصلت على 4 إلى 5 في هذا المقياس حققت تحسنًا متوسطه +27% في الاستشهادات، أما التي حصلت على 1 إلى 2 فلم يتجاوز متوسطها +6%، أي بالكاد فوق مستوى الضجيج الإحصائي. صيغة الملف أقل أهمية بكثير من جودة محتوى قسم الملخص.
أمثلة على ملخصات حصلت على درجات عالية وأخرى منخفضة:
درجة منخفضة (معيار واحد من 5):
"تقدم Example Corp أدوات وموارد تسويقية للشركات."
درجة عالية (5 معايير من 5):
"Example Corp منصة لإسناد التسويق (marketing attribution) بين الشركات، تستخدمها أكثر من 2,000 شركة SaaS متوسطة الحجم لتتبع مساهمة قنوات dark social (القنوات الاجتماعية غير القابلة للتتبع مثل LinkedIn وذكر العلامة في البودكاست ومنتديات المجتمعات) في خط المبيعات، وهي مساهمة يغفلها الإسناد التقليدي القائم على UTM. أبرز حالات الاستخدام: نائب رئيس التسويق حين يرفع تقاريره لمجلس الإدارة عن خط مبيعات لا يمكن تتبعه، وفرق توليد الطلب حين تبرر إنفاقها على dark social."
المثال صاحب الدرجة العالية يحدد الجمهور (نائب رئيس التسويق وفرق توليد الطلب في شركات SaaS متوسطة الحجم)، والتميّز (إسناد dark social)، والموثوقية (أكثر من 2,000 شركة)، وسياق الاستخدام (تقارير مجلس الإدارة وتبرير الإنفاق). وأي نظام ذكاء اصطناعي يقرأ هذا الملخص يستطيع أن يصف المنتج بدقة حين يسأل مستخدم عن أدوات إسناد التسويق لشركات SaaS.
النتيجة الثالثة: قوائم الصفحات تصنع أثر الاستشهاد في الاستعلامات الطويلة
المواقع التي أدرجت قوائم مفصلة لصفحاتها في llms.txt (ولم تكتفِ بقسم الملخص) حققت تحسنًا إضافيًا في الاستشهادات على الاستعلامات الطويلة (long-tail)، أي الاستعلامات المتعلقة بميزات أو حالات استخدام أو موضوعات محددة تغطيها الصفحات المدرجة.
وكان الأثر أوضح ما يكون في الصفحات التي لا تحظى بروابط داخلية كثيرة. فبالنسبة لهذه الصفحات "المهمة لكنها شبه معزولة"، مثل صفحات الأدوات والتوثيق التقني والأدلة المتخصصة، كان ظهورها في قوائم صفحات llms.txt هو الطريقة الأساسية التي تعلّمت بها أنظمة الذكاء الاصطناعي الاستشهاد بها في الاستعلامات ذات الصلة. ومن دون هذه القوائم، بقيت تلك الصفحات غائبة إلى حد كبير عن استشهادات الذكاء الاصطناعي رغم قيمة محتواها.
المواقع التي أدرجت 15 صفحة أو أكثر مع أوصاف جيدة حققت تحسنًا بنسبة +22% في الاستشهادات على الاستعلامات الطويلة، مقابل +9% للمواقع التي لم تُدرج صفحات أو أدرجتها باختصار دون أوصاف.
النتيجة الرابعة: llms.txt وحده لا يكفي
أهم نتيجة سلبية: المواقع التي تحجب زواحف الذكاء الاصطناعي عبر robots.txt لم تحقق أي تحسن في الاستشهادات بعد إضافة llms.txt. هذا متوقع، لكن يجدر قوله صراحة: لا يمكن لـ llms.txt أن يساعدك إذا كانت زواحف الذكاء الاصطناعي عاجزة عن الوصول إلى موقعك. فالملف يقدّم إرشادات للزواحف المسموح لها بالدخول أصلًا، ولا يتجاوز قيود الوصول.
وبالمثل، لم تحقق المواقع ذات المحتوى الضعيف أو الهزيل إلا تحسنًا طفيفًا حتى مع ملفات llms.txt قوية. فأنظمة الذكاء الاصطناعي لا تستشهد بمحتوى رديء أكثر لمجرد أن ملفًا يقول إنه مهم. الملف يحسّن طريقة فهم أنظمة الذكاء الاصطناعي لموقعك وتنقّلها فيه، لكن المحتوى نفسه يجب أن يستحق الاستشهاد.
وللصورة الكاملة عما يدفع استشهادات الذكاء الاصطناعي، راجع دليل تحسين الظهور في البحث بالذكاء الاصطناعي. فملف llms.txt إشارة واحدة من عدة إشارات تعمل معًا، وليس حلًا قائمًا بذاته.
حسب القطاع: من يستفيد أكثر من llms.txt؟
تفاوت التحسن في الاستشهادات الناتج عن llms.txt تفاوتًا كبيرًا من قطاع لآخر:
أعلى استفادة (تحسن بمتوسط +20% إلى +35%)
- البرمجيات كخدمة (SaaS) والتقنية: كثيرًا ما تخطئ أنظمة الذكاء الاصطناعي في تصنيف المنتجات البرمجية أو تصفها وصفًا غير صحيح. والملخصات المحددة في llms.txt تصحح هذه الصورة المغلوطة بفعالية.
- الخدمات المالية: تتحفظ أنظمة الذكاء الاصطناعي في الاستشهاد بالمحتوى المالي ما لم تجد إشارات موثوقية واضحة. وملف llms.txt الذي يتضمن تراخيص تنظيمية أو وصفًا للمنهجية أو مؤهلات مهنية يرفع معدلات الاستشهاد بشكل ملموس.
- الرعاية الصحية والطب: الديناميكية نفسها كما في الخدمات المالية، إذ ترفع إشارات الموثوقية في الملخص معدلات الاستشهاد بشكل لافت لمواقع المعلومات الصحية التي تملك خبرة حقيقية.
استفادة متوسطة (تحسن بمتوسط +8% إلى +18%)
- خدمات الشركات (B2B): الخدمات المعقدة التي يصعب تصنيفها من المحتوى وحده تستفيد من الوصف الصريح، لكن التحسن يبقى معتدلًا.
- التعليم: الأوصاف الواضحة للموضوعات المغطاة تساعد أنظمة الذكاء الاصطناعي على مطابقة المحتوى التعليمي مع استعلامات تعلّم محددة.
- النشر والأخبار: تأتي الاستفادة أساسًا من إرشادات حداثة المحتوى (الإشارة إلى الأقسام التي تُحدَّث كثيرًا)، لا من الملخص نفسه.
استفادة أقل (تحسن بمتوسط +3% إلى +8%)
- التجارة الإلكترونية: تفهم أنظمة الذكاء الاصطناعي صفحات المنتجات جيدًا من البيانات المنظمة (مخطط Product). ولذلك تقل القيمة الإضافية لـ llms.txt حين يكون المخطط شاملًا.
- الخدمات المحلية: أنماط الاستشهاد في الخدمات المحلية تتأثر بحضور التقييمات واتساق بيانات الاسم والعنوان والهاتف (NAP) أكثر بكثير من تأثرها بإرشادات llms.txt.
حين يكون المشككون على حق
تؤيد بياناتنا بعض الحجج المتشككة في llms.txt:
ليس ضمانًا للاستشهاد. حتى الربع الأعلى من المواقع حقق تحسنًا بنسبة +31% انطلاقًا من مستوى أساس. فالمواقع التي كان معدل الاستشهاد بها 10% وصلت إلى نحو 13%. ليس تحولًا جذريًا، لكنه تحسن ملموس يتراكم مع الوقت.
تحسين المحتوى أهم. قارنّا المواقع التي أضافت llms.txt وحده بالمواقع التي حسّنت جودة المحتوى في الوقت نفسه (إجابات أفضل في الأسئلة الشائعة، وبيانات منظمة أكثر تحديدًا). فحققت مجموعة تحسين المحتوى 2.4 ضعف التحسن الذي حققته مجموعة llms.txt وحده. الملف يضخّم أثر المحتوى الجيد، لكنه لا يحل محله.
لا تستجيب كل النماذج بالقدر نفسه. في نموذج ChatGPT الأساسي (دون Browse) يبقى الأثر صغيرًا. وإذا كانت الاستعلامات التي تستهدفها تعالجها في الغالب نماذج تعتمد على بيانات التدريب لا على الاسترجاع اللحظي، فستكون مكاسب llms.txt أبطأ وأصعب في القياس.
توصيتنا
بناءً على البيانات، هذه توصيتنا:
- أضف llms.txt إن لم تكن قد فعلت: الفائدة المحتملة حقيقية، وتكلفة التنفيذ منخفضة (من 30 إلى 60 دقيقة لملف جيد)، ولا توجد أي سلبيات
- اجعل جودة الملخص أولويتك: من هنا يأتي 70% من التحسن في الاستشهادات، فاستثمر وقتك في وصف محدد يستهدف جمهورك ويبرز ما يميزك
- أدرج صفحاتك المهمة قليلة الروابط: خاصة صفحات الأدوات والتوثيق والأدلة المتخصصة في موضوعات بعينها التي لا تحظى بروابط داخلية كثيرة
- أصلح robots.txt أولًا إذا كانت زواحف الذكاء الاصطناعي محجوبة: ملف llms.txt على موقع محجوب لا يفعل شيئًا
- اجمعه مع تحسينات المحتوى والمخططات: يكون llms.txt أكثر فعالية حين يكون جزءًا من استراتيجية AEO متكاملة، لا حلًا منفردًا
استخدم مولّد llms.txt المجاني من AI Rank Lab لإنشاء ملفك، وأداة التدقيق الشاملة للتحقق من أن ملف llms.txt الحالي سليم البنية ومن أنه يعمل جنبًا إلى جنب مع إشارات AEO الأخرى لديك.
الخلاصة
لملف llms.txt أثر حقيقي وقابل للقياس على معدلات الاستشهاد في الذكاء الاصطناعي، خاصة في Perplexity وChatGPT Browse، وخاصة للمواقع التي تقدم منتجات أو خدمات معقدة أو يسهل تصنيفها خطأً، وخاصة حين يكون الملخص محددًا ومميِّزًا. الملف ليس عصا سحرية، فهو لا يجعل المحتوى الضعيف جديرًا بالاستشهاد ولا يتجاوز حجب الزواحف، لكنه كعنصر ضمن استراتيجية AEO متكاملة يستحق الثلاثين دقيقة التي يتطلبها تنفيذه.
أهم ما يجب أن تخرج به: جودة ملخص llms.txt أهم بكثير من مجرد وجود الملف. الوصف العام المكوّن من جملتين لا يقدّم إلا فائدة ضئيلة، أما الملخص المحدد الذي يستهدف جمهورًا بعينه ويتضمن إشارات موثوقية وتميّزًا واضحًا فيحقق تحسنًا ملموسًا في الاستشهادات عبر النماذج التي تدعمه.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


