



لماذا أصبح ملف robots.txt أهم من أي وقت مضى في 2026؟
صُمّم ملف robots.txt عام 1994 ليخبر زواحف الويب بالصفحات التي ينبغي أن تتجنبها. وعلى مدى 30 عامًا، لم يكن على مديري المواقع أن يشغلوا بالهم إلا بعائلة زواحف كبيرة واحدة: Googlebot. أما في 2026 فقد اتسعت القائمة كثيرًا؛ إذ تشغّل شركات الذكاء الاصطناعي، مثل OpenAI وAnthropic وPerplexity وGoogle، زواحف مخصصة تقرأ محتواك لتدريب النماذج وبناء قواعد المعرفة وتوليد إجابات البحث بالذكاء الاصطناعي.
وقرارك بالسماح لهذه الزواحف أو حظرها ينعكس مباشرة على ظهورك في البحث بالذكاء الاصطناعي. فإذا لم يتمكن GPTBot من زحف موقعك، فلن يدخل محتواك في إجابات ChatGPT. وإذا حظرت PerplexityBot، فلن يستطيع Perplexity الاستشهاد بصفحاتك. وإذا كان Google-Extended محظورًا، فقد لا يظهر محتواك في AI Overviews (الملخصات المولّدة بالذكاء الاصطناعي في Google) ولا في إجابات AI Mode.
ولضبط robots.txt بالشكل الصحيح في عصر زواحف الذكاء الاصطناعي، عليك أن تعرف ما الروبوتات الموجودة، وما الذي يفعله كل منها، وكيف تضبط صلاحيات الوصول بطريقة تحمي محتواك وتزيد في الوقت نفسه فرص الاستشهاد بك. يغطي هذا الدليل كل ذلك، ومعه مولّد robots.txt مجاني تنشئ به إعدادًا جاهزًا للذكاء الاصطناعي في دقائق.
الدليل الكامل لزواحف الذكاء الاصطناعي
قبل أن تضبط أي شيء، عليك أن تعرف الروبوتات التي ستخاطبها. إليك أبرز زواحف الذكاء الاصطناعي ووكلاء المستخدم (user agents) الخاصة بها حتى عام 2026:
OpenAI - ChatGPT
- وكيل المستخدم: GPTBot
- الغرض: جمع بيانات التدريب وميزة التصفح Browse في ChatGPT
- أثر الحظر: لن يدخل محتواك في إجابات ChatGPT ولن يظهر ضمن استشهادات ChatGPT Browse
- التوثيق: تنشر OpenAI قائمة علنية بنطاقات عناوين IP الخاصة بـ GPTBot
Anthropic - Claude
- وكيل المستخدم: ClaudeBot (ويُعرَف أيضًا باسم anthropic-ai)
- الغرض: بيانات التدريب وقاعدة المعرفة لـ Claude
- أثر الحظر: لن يدخل محتواك في إجابات Claude حين يسأل المستخدمون عن مجالك
- التوثيق: نشرت Anthropic سياسة الزحف الخاصة بها، وهي تحترم توجيهات robots.txt
Perplexity AI
- وكيل المستخدم: PerplexityBot
- الغرض: البحث الفوري في الويب لتوليد إجابات Perplexity AI واستشهاداتها
- أثر الحظر: لن يُستشهد بصفحاتك في إجابات Perplexity حتى لو كانت شديدة الصلة بالسؤال
- التوثيق: يحترم Perplexity ملف robots.txt، وقد نشر إرشادات الزحف الخاصة به
Google - ميزات الذكاء الاصطناعي
- وكيل المستخدم: Google-Extended
- الغرض: تدريب Google Bard/Gemini ومحتوى AI Overviews
- أثر الحظر: قد لا يظهر محتواك في AI Overviews أو AI Mode أو إجابات Gemini
- ملاحظة: هذا الزاحف منفصل عن Googlebot. يمكنك السماح لـ Googlebot (البحث التقليدي) مع حظر Google-Extended (ميزات الذكاء الاصطناعي)
Microsoft - Copilot
- وكيل المستخدم: Bingbot (مشترك)، وتختلف الزواحف الخاصة بـ Copilot
- الغرض: تشغيل Microsoft Copilot وإجابات Bing المدعومة بالذكاء الاصطناعي
- أثر الحظر: ظهور أقل في Microsoft Copilot وميزات الذكاء الاصطناعي في Bing
Meta - Llama
- وكيل المستخدم: FacebookBot وMeta-ExternalAgent
- الغرض: بيانات التدريب لـ Meta AI ونماذج Llama
- أثر الحظر: لن يدخل محتواك في إجابات Meta AI
Apple - Applebot
- وكيل المستخدم: Applebot وApplebot-Extended
- الغرض: Siri وApple Intelligence وميزات البحث في Apple
- أثر الحظر: ظهور أقل في Siri وميزات الذكاء الاصطناعي لدى Apple
المشكلة: معظم ملفات robots.txt كُتبت قبل ظهور زواحف الذكاء الاصطناعي
هكذا يبدو ملف robots.txt نموذجي من الفترة 2020-2023:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
هذا الإعداد يسمح لـ Googlebot لكنه يترك بقية الروبوتات لقاعدة البدل (wildcard). وبحسب طريقة التفسير، قد تحظر هذه القاعدة زواحف الذكاء الاصطناعي من أقسام في موقعك، أو تسمح لها بالوصول إلى كل مكان، بما فيه صفحات تفضّل حمايتها.
والأسوأ أن بعض المواقع أضافت حظرًا صارمًا في المرحلة المبكرة لزواحف الذكاء الاصطناعي (2022-2023)، حين بلغ غضب الناشرين من استخدام محتواهم في تدريب الذكاء الاصطناعي ذروته. فإذا كان موقعك قد أضاف Disallow: / لجميع الروبوتات، فربما أغلقت الباب أمام زواحف الذكاء الاصطناعي ثم نسيت الأمر. ولا تظهر العواقب إلا حين تلاحظ أن علامتك التجارية شبه غائبة عن إجابات البحث بالذكاء الاصطناعي.
تعرض لك ميزة تتبّع روبوتات الذكاء الاصطناعي في AI Rank Lab الروبوتات التي تزور صفحاتك فعلًا، ومساعدات الذكاء الاصطناعي التي ترسل إليك زيارات إحالة، من دون الحاجة إلى تحليل السجلات يدويًا. وإذا لم يظهر زاحف كنت تنوي السماح له إطلاقًا، فراجع قواعده في ملف robots.txt.
قوالب robots.txt جاهزة لسيناريوهات مختلفة
استخدم مولّد robots.txt المجاني لتخصيص هذه القوالب لموقعك. وإليك أكثر الإعدادات شيوعًا:
القالب 1: وصول كامل للذكاء الاصطناعي (موصى به لمعظم المواقع)
اسمح لجميع زواحف الذكاء الاصطناعي بالوصول إلى محتواك. هذا الخيار هو الأنسب للمواقع التي تريد أقصى ظهور في البحث بالذكاء الاصطناعي، ولا تمانع في أن يدخل محتواها في تدريب النماذج.
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
القالب 2: وصول انتقائي (حماية المحتوى)
اسمح لزواحف الذكاء الاصطناعي بصفحات المحتوى العام، واحظر المحتوى المميز والمقالات المدفوعة ومناطق الأعضاء. هذا الخيار هو الأنسب لناشري الاشتراكات والمواقع ذات المحتوى المقيّد.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
القالب 3: حظر التدريب والسماح بالبحث
إعداد أكثر دقة: اسمح لـ Perplexity (الذي يستخدم محتواك في الاستشهادات الفورية) واحظر زواحف التدريب (التي تستخدم محتواك لتدريب النماذج). هذا حل وسط شائع بين الناشرين الذين يريدون الاستشهاد بهم في البحث بالذكاء الاصطناعي لكنهم يرفضون استخدام محتواهم في التدريب.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml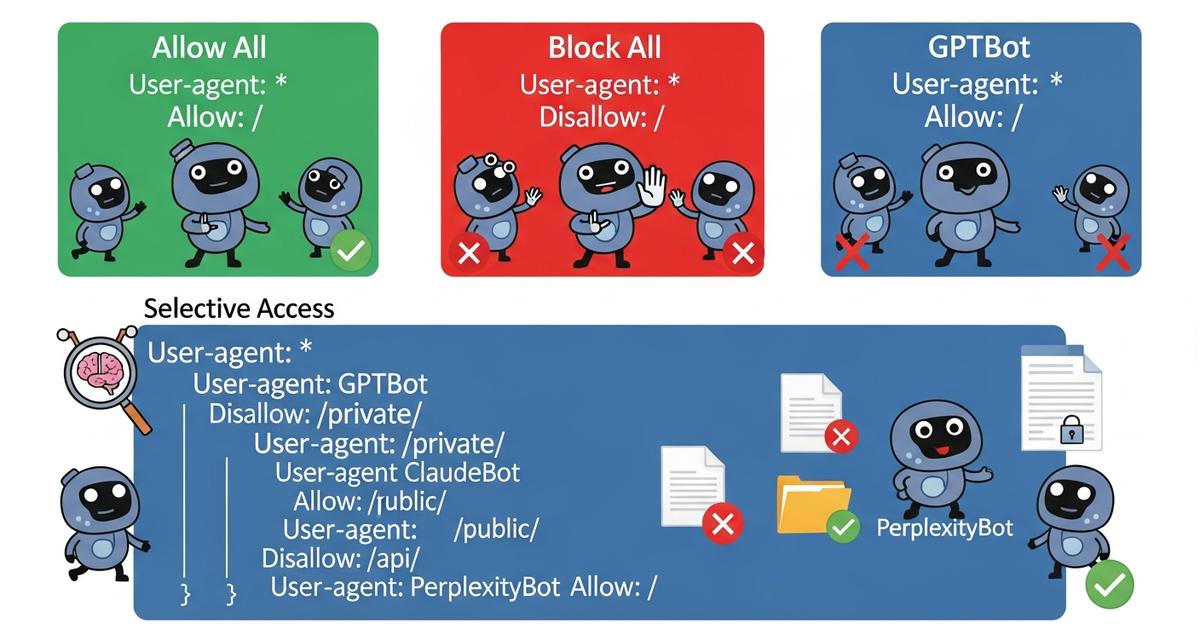
كيف تختار الإعداد المناسب لموقعك؟
يعتمد إعداد robots.txt المناسب على نوع محتواك ونموذج عملك وأهدافك في الظهور بالبحث بالذكاء الاصطناعي. استعن بإطار القرار التالي:
اسمح لجميع زواحف الذكاء الاصطناعي إذا:
- كان موقعك ينشر محتوى متاحًا للجميع (مدونة، توثيق، موارد)
- كنت تريد أقصى ظهور في البحث بالذكاء الاصطناعي وتعدّ الاستشهادات مصدرًا للزيارات
- لم يكن لديك محتوى مقيّد أو مميز يحتاج إلى حماية
- كان محتواك معلوماتيًا ويستفيد من الانتشار الواسع
استخدم الوصول الانتقائي إذا:
- كان لديك مزيج من المحتوى المجاني والمميز
- كانت هناك صفحات لا ينبغي الاستشهاد بها (صفحات الحساب، مسارات الدفع، المحتوى الخاص بالأعضاء)
- كنت تريد أن تركّز زواحف الذكاء الاصطناعي على أفضل محتواك بدل أن تزحف إلى كل شيء
احظر زواحف التدريب (واسمح بالبحث فقط) إذا:
- كنت ناشرًا لديك مخاوف من استخدام محتواك في تدريب الذكاء الاصطناعي
- كنت لا تزال تريد الظهور في Perplexity وGoogle AI Overviews (الاستشهاد الفوري)
- كنت تريد الإبقاء على خيار ترخيص محتواك لشركات الذكاء الاصطناعي بشكل منفصل
احظر جميع زواحف الذكاء الاصطناعي فقط إذا:
- كانت لديك أسباب قانونية أو تنافسية واضحة لإبقاء محتواك خارج أنظمة الذكاء الاصطناعي
- كان لديك اتفاق ترخيص مع شركات ذكاء اصطناعي بعينها وتريد فرض الحصرية
- كنت تدرك المقايضة: صفر ظهور لنطاقك في البحث بالذكاء الاصطناعي
أخطاء شائعة عليك تجنبها
الخطأ 1: استخدام حظر عام بالبدل للروبوتات غير المعروفة
إعدادات مثل User-agent: * / Disallow: / تليها قواعد سماح محددة لـ Googlebot ستحظر جميع زواحف الذكاء الاصطناعي، لأنها لا تملك قواعد سماح صريحة. احرص دائمًا على أن تكون صريحًا في تحديد صلاحيات زواحف الذكاء الاصطناعي.
الخطأ 2: عدم معرفة إعدادك الحالي
كثير من الفرق لا تعرف ما الذي يقوله ملف robots.txt لديها عن زواحف الذكاء الاصطناعي. افحصه الآن على yoursite.com/robots.txt. ويمكن أن تساعدك أدوات AI Rank Lab أيضًا: فالتدقيق المجاني للموقع يتحقق من وجود ملف robots.txt وإمكانية الوصول إليه.
الخطأ 3: الخلط بين Googlebot وGoogle-Extended
السماح لـ Googlebot لا يعني تلقائيًا السماح لـ Google-Extended (زاحف ميزات الذكاء الاصطناعي). إذا أردت الظهور في Google AI Overviews وAI Mode، فأنت تحتاج إلى قاعدة صريحة تسمح لـ Google-Extended.
الخطأ 4: عدم الاختبار بعد التعديل
بعد تحديث ملف robots.txt، تأكد من سريان التغييرات بفحص الملف المنشور واستخدام أداة لاختبار robots.txt. يوفّر Google Search Console أداة مدمجة لاختبار robots.txt خاصة بـ Googlebot، لكن عليك التحقق من قواعد زواحف الذكاء الاصطناعي يدويًا.
الخطأ 5: ضبط الملف ثم نسيانه
تظهر زواحف ذكاء اصطناعي جديدة بانتظام، وقائمة وكلاء المستخدم من عام 2023 أصبحت ناقصة بالفعل في 2026. راجع ملف robots.txt مرة كل ربع سنة على الأقل، وتابع التوثيق الجديد الذي تنشره كبرى شركات الذكاء الاصطناعي عن زواحفها.
ما بعد robots.txt: منظومة التحكم الكاملة في زواحف الذكاء الاصطناعي
ملف robots.txt هو أهم أداة للتحكم في وصول زواحف الذكاء الاصطناعي، لكنه ليس الأداة الوحيدة. يتضمن الإعداد التقني الكامل لتحسين محركات الإجابة (AEO) ما يلي:
- robots.txt: قواعد وصول الزواحف (شرحناها أعلاه)
- llms.txt: ملف إرشادي للنماذج اللغوية الكبيرة يوضح ما يغطيه موقعك وكيف ينبغي استخدام محتواه، وهو مكمّل لـ robots.txt لا بديل عنه
- وسوم noindex الوصفية: تحكم على مستوى الصفحة يمنع فهرسة صفحات بعينها، وتحترمه بعض زواحف الذكاء الاصطناعي
- مراقبة روبوتات الذكاء الاصطناعي: تتبّع الزواحف التي تصل إلى موقعك ومعدل زياراتها، وتوفر لك ميزة تتبّع الروبوتات في AI Rank Lab هذه الرؤية من دون تحليل السجلات
جرّب مولّد robots.txt المجاني
بدل أن تكتب ملف robots.txt من الصفر، استخدم مولّد robots.txt المجاني من AI Rank Lab. اختر نوع الإعداد (وصول كامل، أو انتقائي، أو حظر التدريب، أو مخصص)، وحدّد أي مسارات تريد حمايتها، وسيُنشئ لك ملفًا منسقًا بشكل صحيح يتضمن جميع وكلاء المستخدم الحاليين لزواحف الذكاء الاصطناعي. يمكنك نسخ الناتج مباشرة إلى خادمك أو تنزيله كملف.
ويجري تحديث المولّد كلما ظهرت وكلاء مستخدم جديدة لزواحف الذكاء الاصطناعي، فتحصل على إعداد يأخذ في الحسبان روبوتات لم تكن موجودة حين كُتب هذا المقال.
الخلاصة
ملف robots.txt هو لوحة تحكم مباشرة في ظهورك بالبحث بالذكاء الاصطناعي. إذا ضبطته جيدًا، تستطيع زواحف الذكاء الاصطناعي الوصول إلى محتواك والتعلم منه، وهو ما يتحول إلى استشهادات في إجابات ChatGPT وPerplexity وClaude وGemini. وإذا أخطأت في ضبطه، أو تركت ملفًا قديمًا في مكانه، فأنت تضع حواجز خفية بين محتواك ومحركات الذكاء الاصطناعي التي باتت تقود الاكتشاف أكثر فأكثر.
خمس دقائق تقضيها في فحص ملف robots.txt الحالي واستخدام المولّد المجاني لإنشاء إعداد جاهز للذكاء الاصطناعي من أكثر الخطوات التقنية تأثيرًا في ظهورك بالبحث بالذكاء الاصطناعي. ابدأ اليوم، ثم ضع تذكيرًا لمراجعته كل ربع سنة مع دخول زواحف ذكاء اصطناعي جديدة إلى الساحة.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


