



Die llms.txt-Debatte: echtes Signal oder Placebo?
Seit die llms.txt-Spezifikation vorgeschlagen wurde, ist die SEO- und AEO-Community gespalten. Die Befürworter sehen darin ein klares Signal an KI-Systeme: Hier steht, was deine Website ist und welche Themen sie abdeckt – genau die strukturierte Orientierung, die eine Zitierentscheidung zu deinen Gunsten kippen kann. Die Skeptiker halten dagegen: Die Datei sei zu neu, um wirklich etwas zu bewirken, kaum ein KI-System unterstütze sie offiziell, und die Zitier-Zuwächse, die man llms.txt zuschreibt, kämen in Wahrheit von den Content-Verbesserungen, die Teams nebenbei bei der Einführung umsetzen.
Wir wollten die Spekulation hinter uns lassen. Mit der Citation-Tracking-Infrastruktur von AI Rank Lab haben wir 500 Websites vor und nach dem Hinzufügen einer llms.txt-Datei analysiert und ihre Zitierraten in ChatGPT (GPT-4o), Perplexity und Claude 3.5 Sonnet über einen Zeitraum von 90 Tagen verfolgt. Außerdem haben wir uns angesehen, was Websites mit großen Zuwächsen von denen unterscheidet, bei denen sich kaum etwas getan hat.
Hier sind unsere Ergebnisse – auch die Teile, die den optimistischsten Versprechen rund um llms.txt widersprechen.
Die Studie mit 500 Websites: So sind wir vorgegangen
Wir haben 500 Domains begleitet, die während eines sechsmonatigen Analysezeitraums zum ersten Mal eine llms.txt eingeführt haben. Für alle Domains galt:
- KI-Crawler hatten bereits Zugriff (GPTBot, ClaudeBot und PerplexityBot in der robots.txt erlaubt)
- Vor der Einführung der llms.txt lagen mindestens 30 Tage Basisdaten zu Zitierungen vor
- Im Messzeitraum gab es keine größeren Content-Änderungen und keine nennenswerten neuen Backlinks
- Die Websites hatten 10–500 Seiten (sehr kleine und sehr große Websites haben wir ausgeschlossen, um Störfaktoren zu reduzieren)
Die Zitierrate haben wir so gemessen: Wie oft wurde eine Domain von einem LLM zitiert, wenn es eine Anfrage aus dem zentralen Themencluster der Domain beantwortet hat – angegeben als Prozentsatz der getesteten Anfragen. Pro Domain und LLM haben wir 50 Anfragen getestet, die aus dem Haupt-Keyword-Set der Domain stammen.
Die Websites kamen aus 12 Branchen: SaaS, E-Commerce, lokale Dienstleistungen, B2B-Dienstleistungen, Publishing, Gesundheitswesen, Recht, Finanzdienstleistungen, Bildung, Immobilien, Reisen und Tech-News.
Erkenntnis 1: llms.txt steigert die Zitierrate – aber nicht bei jedem LLM
Über alle 500 Websites hinweg haben wir in den 90 Tagen nach Einführung der llms.txt folgende durchschnittliche Veränderungen der Zitierrate beobachtet:
- Perplexity: durchschnittlich +18 % bei der Zitierrate
- ChatGPT (mit Browse): durchschnittlich +12 % bei der Zitierrate
- Claude: durchschnittlich +7 % bei der Zitierrate
- ChatGPT (ohne Browse, GPT-4o-Basismodell): +3 % (statistisch nicht signifikant)
Die Unterschiede zwischen den LLMs sind deutlich und lassen sich nicht allein durch unterschiedliches Crawling-Verhalten erklären. Dass Perplexity stärker reagiert, liegt vermutlich an seiner Architektur mit Websuche in Echtzeit – es nutzt strukturierte Orientierungsdateien aktiv, wenn es Antworten zusammenstellt. Der Browse-Modus von ChatGPT (der Live-Inhalte aus dem Web abruft) zeigt spürbare Verbesserungen, während das GPT-4o-Basismodell, das sich vor allem auf Trainingsdaten stützt, auf eine einzelne neue Datei kaum reagiert.
Die moderate Verbesserung bei Claude passt zum veröffentlichten Ansatz von Anthropic: ClaudeBot crawlt und respektiert Orientierungsdateien, aber die Trainingsdaten von Claude werden in längeren Zyklen aktualisiert als die Echtzeit-Abfrage von Perplexity. Der Effekt ist real, zeigt sich aber langsamer.
Erkenntnis 2: Die Qualität der llms.txt-Zusammenfassung entscheidet
Die Websites mit den größten Zuwächsen (oberstes Quartil, im Schnitt +31 % Zitierrate) hatten eines gemeinsam: sehr konkrete Zusammenfassungen im Blockquote, die klar beschreiben, wodurch sie sich abheben, für wen sie gemacht sind und welche Themen sie abdecken.
Wir haben die llms.txt-Zusammenfassung jeder Website anhand von fünf Kriterien bewertet:
- Klare Zielgruppe (für wen ist das?)
- Klare Differenzierung (was macht diese Website besonders?)
- Vollständige Themenabdeckung (welche Themen behandelt die Website?)
- Autoritätssignale (Hinweise auf Glaubwürdigkeit – Daten, Expertise, Methodik)
- Handlungskontext (was können Leser mit dieser Website anfangen?)
Websites mit 4–5 Punkten in diesem Raster kamen im Schnitt auf +27 % mehr Zitierungen. Websites mit 1–2 Punkten lagen bei durchschnittlich nur +6 % – kaum mehr als Rauschen. Das Dateiformat spielt eine viel kleinere Rolle als die inhaltliche Qualität der Zusammenfassung.
Beispiele für schwach und stark bewertete Zusammenfassungen:
Schwach bewertet (1/5 Kriterien erfüllt):
„Example Corp bietet Marketing-Tools und Ressourcen für Unternehmen.“
Stark bewertet (5/5 Kriterien erfüllt):
„Example Corp ist eine B2B-Plattform für Marketing-Attribution, mit der mehr als 2.000 SaaS-Unternehmen aus dem Mittelstandssegment den Pipeline-Beitrag aus Dark-Social-Kanälen (LinkedIn, Erwähnungen in Podcasts, Community-Foren) messen, den klassische UTM-basierte Attribution übersieht. Wichtigste Anwendungsfälle: VPs of Marketing, die dem Board über nicht trackbare Pipeline berichten, und Demand-Gen-Teams, die Ausgaben für Dark Social begründen müssen.“
Das stark bewertete Beispiel nennt die Zielgruppe (VP of Marketing, Demand-Gen-Teams in SaaS-Unternehmen aus dem Mittelstandssegment), die Differenzierung (Dark-Social-Attribution), Autorität (mehr als 2.000 Unternehmen) und den Handlungskontext (Reporting ans Board, Begründung von Budgets). Ein KI-System, das diesen Text liest, kann das Produkt treffend beschreiben, wenn jemand nach Marketing-Attribution-Tools für SaaS-Unternehmen fragt.
Erkenntnis 3: Seitenlisten sorgen für Zitierungen im Long Tail
Websites, die in ihrer llms.txt ausführliche Seitenlisten angelegt hatten (statt nur der Zusammenfassung), legten bei Long-Tail-Anfragen zusätzlich zu – also bei Fragen zu bestimmten Funktionen, Anwendungsfällen oder Themen, die auf den gelisteten Seiten behandelt werden.
Am stärksten war der Effekt bei Seiten, die intern kaum verlinkt sind. Für diese „verwaisten, aber wichtigen“ Seiten – Tool-Seiten, technische Dokumentation, Nischen-Guides – war der Eintrag in der Seitenliste der llms.txt der wichtigste Weg, über den KI-Systeme lernten, sie bei passenden Anfragen zu zitieren. Ohne diesen Eintrag blieben solche Seiten für KI-Zitierungen weitgehend unsichtbar, obwohl sie wertvolle Inhalte boten.
Websites mit 15 oder mehr gut beschriebenen Seiteneinträgen erreichten bei Long-Tail-Anfragen +22 % mehr Zitierungen, verglichen mit +9 % bei Websites ohne Seitenliste oder mit knappen Einträgen ohne Beschreibung.
Erkenntnis 4: llms.txt allein reicht nicht
Das wichtigste negative Ergebnis: Websites, die KI-Crawler per robots.txt blockieren, verzeichneten nach Einführung der llms.txt null Zuwachs bei den Zitierungen. Das war zu erwarten, sollte aber klar gesagt werden: llms.txt kann nicht helfen, wenn KI-Crawler gar nicht auf deine Website zugreifen dürfen. Die Datei gibt Crawlern Orientierung, die ohnehin schon hereingelassen werden – Zugriffsbeschränkungen hebelt sie nicht aus.
Genauso zeigten Websites mit dünnem oder minderwertigem Content selbst mit starken llms.txt-Dateien kaum Verbesserungen. KI-Systeme zitieren schwache Inhalte nicht häufiger, nur weil eine Datei sie für wichtig erklärt. Die Datei verbessert, wie KI-Systeme deine Website verstehen und sich darin zurechtfinden – der Content selbst muss trotzdem zitierwürdig sein.
Das Gesamtbild, was KI-Zitierungen wirklich antreibt, findest du in unserem Leitfaden zur Optimierung für die KI-Suche. llms.txt ist eines von mehreren Signalen, die zusammenwirken – keine Lösung für sich allein.
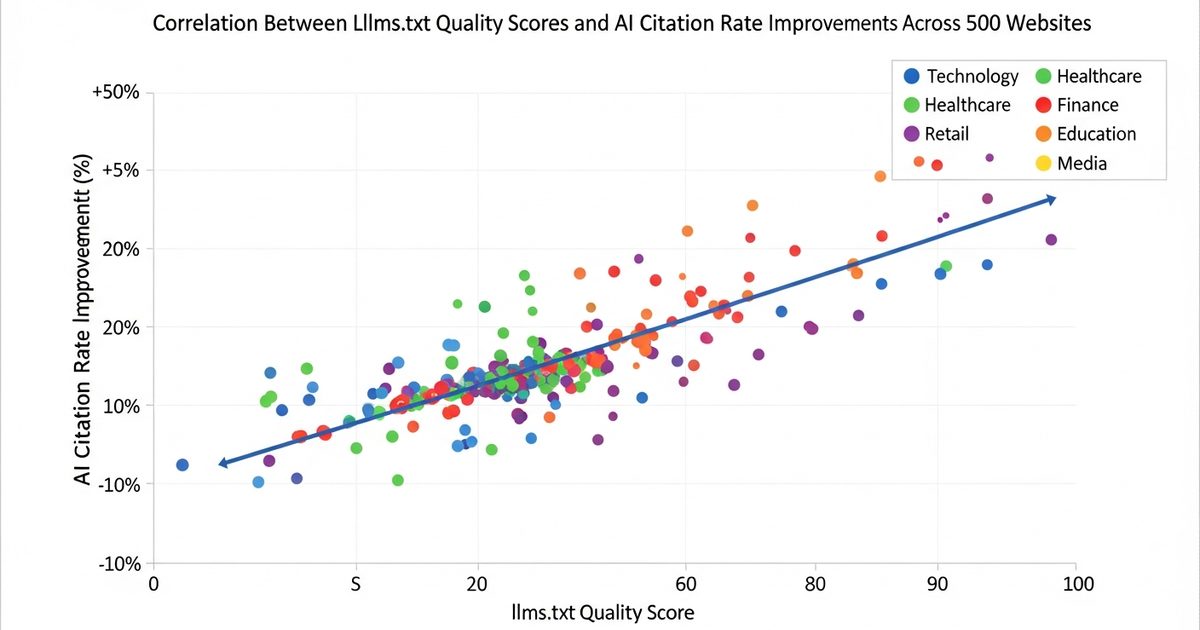
Nach Branchen: Wer am meisten von llms.txt profitiert
Wie stark llms.txt die Zitierungen steigert, hing deutlich von der Branche ab:
Größter Nutzen (durchschnittlich +20–35 %)
- SaaS und Technologie: KI-Systeme ordnen Softwareprodukte häufig falsch ein oder beschreiben sie unzutreffend. Konkrete llms.txt-Zusammenfassungen korrigieren solche Fehldarstellungen wirksam.
- Finanzdienstleistungen: KI-Systeme zitieren Finanzinhalte nur zurückhaltend, wenn klare Autoritätssignale fehlen. Eine llms.txt mit regulatorischen Zulassungen, Beschreibungen der Methodik oder beruflichen Qualifikationen verbessert die Zitierrate messbar.
- Gesundheit und Medizin: Hier wirkt dieselbe Dynamik wie bei Finanzdienstleistungen – Autoritätssignale in der Zusammenfassung verbessern die Zitierrate von Gesundheitsportalen mit echter Expertise drastisch.
Mittlerer Nutzen (durchschnittlich +8–18 %)
- B2B-Dienstleistungen: Komplexe Leistungen, die sich allein aus dem Content schwer einordnen lassen, profitieren von einer expliziten Beschreibung – der Zuwachs bleibt aber moderat.
- Bildung: Klare Angaben zur Themenabdeckung helfen KI-Systemen, Lerninhalte passenden Lernanfragen zuzuordnen.
- Publishing und News: Profitieren vor allem von Hinweisen zur Aktualität (welche Bereiche häufig aktualisiert werden), weniger von der Zusammenfassung selbst.
Geringerer Nutzen (durchschnittlich +3–8 %)
- E-Commerce: Produktseiten verstehen KI-Systeme dank strukturierter Daten (Product-Schema) bereits gut. Wenn das Schema umfassend ist, bringt llms.txt wenig zusätzlichen Mehrwert.
- Lokale Dienstleistungen: Welche lokalen Anbieter zitiert werden, hängt viel stärker von Bewertungen und konsistenten NAP-Daten (Name, Adresse, Telefonnummer) ab als von einer llms.txt.
Wo die Skeptiker recht haben
Einige kritische Einwände gegen llms.txt werden von unseren Daten gestützt:
Eine Zitier-Garantie ist es nicht. Selbst das oberste Quartil kam auf +31 % – ausgehend von einem Basiswert. Websites mit 10 % Zitierrate landeten bei rund 13 %. Kein radikaler Umbruch, aber eine spürbare Verbesserung, die sich mit der Zeit aufsummiert.
Content-Verbesserungen wiegen schwerer. Wir haben Websites, die nur eine llms.txt ergänzt haben, mit Websites verglichen, die gleichzeitig ihre Content-Qualität verbessert haben (bessere FAQ-Antworten, konkretere strukturierte Daten). Die Gruppe mit Content-Verbesserungen erzielte das 2,4-Fache des Zuwachses der Gruppe, die nur auf llms.txt gesetzt hat. llms.txt verstärkt guten Content – ersetzt ihn aber nicht.
Nicht alle LLMs reagieren gleich. Beim Basismodell von ChatGPT (ohne Browse) ist der Effekt gering. Wenn deine Zielanfragen vor allem von Modellen beantwortet werden, die auf Trainingsdaten statt auf Echtzeit-Abfragen setzen, zeigen sich Verbesserungen durch llms.txt langsamer und lassen sich schwerer messen.
Unsere Empfehlung
Auf Basis der Daten empfehlen wir:
- Führe llms.txt ein, falls du es noch nicht getan hast – der mögliche Nutzen ist real, der Aufwand gering (30–60 Minuten für eine gute Datei), und Nachteile gibt es keine
- Steck deine Energie in die Zusammenfassung – daher kommen 70 % des Zuwachses bei den Zitierungen; investiere deine Zeit in eine konkrete, zielgruppengenaue Beschreibung, die zeigt, was dich unterscheidet
- Liste deine wichtigen, schwach verlinkten Seiten auf – vor allem Tool-Seiten, Dokumentation und themenspezifische Guides, die intern wenig verlinkt sind
- Bring zuerst die robots.txt in Ordnung, wenn KI-Crawler blockiert sind – eine llms.txt auf einer gesperrten Website bewirkt nichts
- Kombiniere sie mit Verbesserungen an Content und Schema – llms.txt wirkt am besten als Teil einer vollständigen AEO-Strategie, nicht als isolierter Fix
Erstelle deine Datei mit dem kostenlosen llms.txt-Generator von AI Rank Lab und prüfe mit dem vollständigen Audit-Tool, ob deine aktuelle llms.txt korrekt aufgebaut ist und ob sie mit deinen übrigen AEO-Signalen zusammenspielt.
Fazit
llms.txt hat einen echten, messbaren Einfluss auf die Zitierrate in KI-Antworten – vor allem bei Perplexity und ChatGPT Browse, vor allem bei Websites mit komplexen oder leicht falsch eingeordneten Produkten und Dienstleistungen, und vor allem dann, wenn die Zusammenfassung konkret ist und klar zeigt, was dich unterscheidet. Zauberei ist die Datei nicht – schwachen Content macht sie nicht zitierwürdig, und blockierte Crawler lässt sie nicht herein. Als ein Baustein einer vollständigen AEO-Strategie sind die 30 Minuten für die Einrichtung aber gut investiert.
Die wichtigste Erkenntnis: Die Qualität deiner llms.txt-Zusammenfassung zählt weit mehr als die bloße Existenz der Datei. Eine generische Beschreibung aus zwei Sätzen bringt kaum etwas. Eine konkrete, auf die Zielgruppe zugeschnittene Zusammenfassung mit Autoritätssignalen und klarer Differenzierung sorgt dagegen für spürbar mehr Zitierungen in den LLMs, die die Datei unterstützen.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


