



Warum deine robots.txt 2026 wichtiger ist denn je
Die robots.txt wurde 1994 erfunden, um Web-Crawlern zu sagen, welche Seiten sie meiden sollen. 30 Jahre lang mussten sich Webmaster im Grunde nur um eine große Crawler-Familie kümmern: Googlebot. 2026 ist diese Liste deutlich länger geworden. KI-Unternehmen wie OpenAI, Anthropic, Perplexity und Google betreiben eigene Crawler, die deine Inhalte lesen, um Modelle zu trainieren, Wissensdatenbanken aufzubauen und Antworten in der KI-Suche zu generieren.
Ob du diese Crawler zulässt oder blockierst, wirkt sich direkt auf deine Sichtbarkeit in der KI-Suche aus. Kann GPTBot deine Website nicht crawlen, fließen deine Inhalte nicht in die Antworten von ChatGPT ein. Blockierst du PerplexityBot, kann Perplexity deine Seiten nicht zitieren. Und ist Google-Extended gesperrt, tauchen deine Inhalte unter Umständen nicht in Googles AI Overviews (den KI-Übersichten in der Google-Suche) und in den Antworten von AI Mode auf.
Damit deine robots.txt fit für die Ära der KI-Crawler ist, musst du wissen, welche Bots es gibt, was sie tun und wie du den Zugriff so konfigurierst, dass deine Inhalte geschützt sind und du trotzdem möglichst oft von KI zitiert wirst. Genau darum geht es in diesem Leitfaden, inklusive eines kostenlosen robots.txt-Generators, mit dem du in wenigen Minuten eine KI-taugliche Konfiguration erstellst.
Das komplette Verzeichnis der KI-Crawler
Bevor du irgendetwas konfigurierst, musst du wissen, welche Bots du ansprechen willst. Das sind die wichtigsten KI-Crawler und ihre User-Agents, Stand 2026:
OpenAI – ChatGPT
- User-Agent: GPTBot
- Zweck: Sammeln von Trainingsdaten und die Browse-Funktion von ChatGPT
- Folgen einer Blockierung: Deine Inhalte fließen nicht in ChatGPT-Antworten ein und erscheinen nicht als Quellen in ChatGPT Browse
- Dokumentation: OpenAI pflegt eine öffentliche Liste der IP-Bereiche von GPTBot
Anthropic – Claude
- User-Agent: ClaudeBot (tritt auch als anthropic-ai auf)
- Zweck: Trainingsdaten und Wissensbasis für Claude
- Folgen einer Blockierung: Deine Inhalte fließen nicht in die Antworten von Claude ein, wenn Nutzer nach deinem Themengebiet fragen
- Dokumentation: Anthropic hat seine Crawling-Richtlinie veröffentlicht und hält sich an robots.txt-Anweisungen
Perplexity AI
- User-Agent: PerplexityBot
- Zweck: Websuche in Echtzeit für die Antworten und Quellenangaben von Perplexity AI
- Folgen einer Blockierung: Deine Seiten werden in Perplexity-Antworten nicht zitiert, selbst wenn sie hochrelevant sind
- Dokumentation: Perplexity hält sich an robots.txt und hat Crawling-Richtlinien veröffentlicht
Google – KI-Funktionen
- User-Agent: Google-Extended
- Zweck: Training von Google Bard/Gemini und Inhalte für AI Overviews
- Folgen einer Blockierung: Deine Inhalte erscheinen unter Umständen nicht in Googles AI Overviews, in AI Mode oder in Gemini-Antworten
- Hinweis: Das ist ein anderer Crawler als Googlebot. Du kannst Googlebot (klassische Suche) zulassen und gleichzeitig Google-Extended (KI-Funktionen) blockieren
Microsoft – Copilot
- User-Agent: Bingbot (gemeinsam genutzt), Copilot-spezifische Crawler variieren
- Zweck: Grundlage für Microsoft Copilot und die KI-Antworten in Bing
- Folgen einer Blockierung: Weniger Sichtbarkeit in Microsoft Copilot und den KI-Funktionen von Bing
Meta – Llama
- User-Agent: FacebookBot, Meta-ExternalAgent
- Zweck: Trainingsdaten für Meta AI und die Llama-Modelle
- Folgen einer Blockierung: Deine Inhalte fließen nicht in die Antworten von Meta AI ein
Apple – Applebot
- User-Agent: Applebot, Applebot-Extended
- Zweck: Siri, Apple Intelligence und die Suchfunktionen von Apple
- Folgen einer Blockierung: Weniger Sichtbarkeit in Siri und den KI-Funktionen von Apple
Das Problem: Die meisten robots.txt-Dateien stammen aus der Zeit vor den KI-Crawlern
Eine typische robots.txt aus den Jahren 2020–2023 sieht so aus:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Diese Konfiguration lässt Googlebot zu, verlässt sich bei allen anderen Bots aber auf die Wildcard-Regel. Je nach Auslegung sperrt diese Regel KI-Crawler womöglich aus Teilen deiner Website aus – oder lässt sie überall hinein, auch auf Seiten, die du lieber schützen würdest.
Noch schlimmer: Manche Websites haben in der frühen Phase der KI-Crawler (2022–2023), als der Widerstand von Publishern gegen die Nutzung ihrer Inhalte als Trainingsdaten am größten war, rigoros blockiert. Hat deine Website damals Disallow: / für alle Bots eingetragen, hast du KI-Crawler vielleicht ausgesperrt und es längst vergessen. Die Folgen merkst du erst, wenn dir auffällt, dass deine Marke in den Antworten der KI-Suche unterrepräsentiert ist.
Die Funktion für KI-Bot-Tracking von AI Rank Lab zeigt dir, welche KI-Bots deine Seiten tatsächlich besuchen und welche KI-Assistenten dir Referral-Traffic schicken – ganz ohne manuelle Logfile-Analyse. Taucht ein Crawler, den du eigentlich zulassen wolltest, nie auf, prüf seine Regeln in deiner robots.txt.
Robots.txt-Vorlagen für verschiedene Szenarien
Mit unserem kostenlosen robots.txt-Generator passt du diese Vorlagen an deine Website an. Hier die gängigsten Konfigurationen:
Vorlage 1: Voller KI-Zugriff (für die meisten Websites empfohlen)
Alle KI-Crawler dürfen auf deine Inhalte zugreifen. Ideal für Websites, die maximale Sichtbarkeit in der KI-Suche wollen und kein Problem damit haben, dass ihre Inhalte ins Training von KI-Modellen einfließen.
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Vorlage 2: Selektiver KI-Zugriff (Schutz von Inhalten)
KI-Crawler dürfen auf öffentliche Inhaltsseiten, aber nicht auf Premium-Inhalte, Paywall-Artikel und Mitgliederbereiche. Ideal für Abo-Publisher und Websites mit geschützten Inhalten.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Vorlage 3: KI-Training blockieren, KI-Suche zulassen
Eine differenzierte Konfiguration: Perplexity (nutzt deine Inhalte für Quellenangaben in Echtzeit) wird zugelassen, Trainings-Crawler (nutzen deine Inhalte, um Modelle zu trainieren) werden blockiert. Ein gängiger Mittelweg für Publisher, die in der KI-Suche zitiert werden wollen, das Training von Modellen mit ihren Inhalten aber ablehnen.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml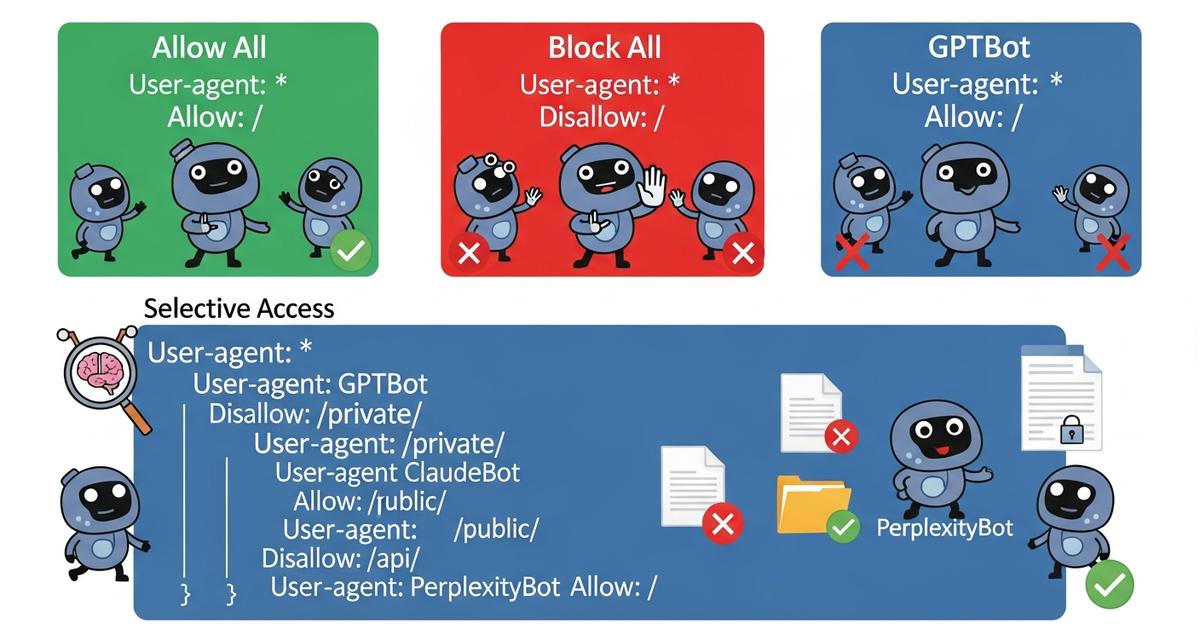
Welche Konfiguration passt zu dir?
Die richtige robots.txt hängt von deiner Art von Inhalten, deinem Geschäftsmodell und deinen Zielen für die Sichtbarkeit in der KI-Suche ab. Dieses Entscheidungsraster hilft dir dabei:
Lass alle KI-Crawler zu, wenn:
- deine Website frei zugängliche Inhalte veröffentlicht (Blog, Dokumentation, Ressourcen)
- du maximale Sichtbarkeit in der KI-Suche willst und Zitate für dich eine Traffic-Quelle sind
- du keine geschützten oder Premium-Inhalte hast, die abgeschirmt werden müssen
- deine Inhalte informativ sind und von breiter Verbreitung profitieren
Setz auf selektiven Zugriff, wenn:
- du eine Mischung aus kostenlosen und Premium-Inhalten hast
- bestimmte Seiten nicht zitiert werden sollen (Kontoseiten, Checkout-Strecken, Inhalte nur für Mitglieder)
- KI-Crawler sich auf deine besten Inhalte konzentrieren sollen, statt alles zu crawlen
Blockiere Trainings-Crawler (und lass nur die Suche zu), wenn:
- du als Publisher Bedenken wegen der Nutzung deiner Inhalte als KI-Trainingsdaten hast
- du trotzdem in Perplexity und Googles AI Overviews erscheinen willst (Zitate in Echtzeit)
- du dir die Option offenhalten willst, deine Inhalte separat an KI-Unternehmen zu lizenzieren
Blockiere alle KI-Crawler nur, wenn:
- du ausdrückliche rechtliche oder wettbewerbliche Gründe hast, deine Inhalte von KI-Systemen fernzuhalten
- du eine Lizenzvereinbarung mit bestimmten KI-Unternehmen hast und Exklusivität durchsetzen willst
- dir der Preis dafür klar ist: null Sichtbarkeit deiner Domain in der KI-Suche
Typische Fehler, die du vermeiden solltest
Fehler 1: Wildcard-Sperre für unbekannte Bots
Konfigurationen wie User-agent: * / Disallow: / mit anschließenden Allow-Regeln nur für Googlebot sperren alle KI-Crawler aus, weil für sie keine ausdrücklichen Allow-Regeln existieren. Regle den Zugriff für KI-Crawler deshalb immer explizit.
Fehler 2: Die eigene Konfiguration nicht kennen
Viele Teams wissen gar nicht, was ihre robots.txt aktuell über KI-Crawler sagt. Schau sie dir jetzt gleich unter yoursite.com/robots.txt an. Auch die Tools von AI Rank Lab helfen dir: Das kostenlose Website-Audit prüft, ob deine robots.txt vorhanden und erreichbar ist.
Fehler 3: Googlebot mit Google-Extended verwechseln
Wer Googlebot zulässt, lässt Google-Extended (den Crawler für KI-Funktionen) nicht automatisch zu. Wenn du in Googles AI Overviews und in AI Mode erscheinen willst, brauchst du eine ausdrückliche Regel, die Google-Extended zulässt.
Fehler 4: Nach Änderungen nicht testen
Wenn du deine robots.txt aktualisiert hast, prüf, ob die Änderungen greifen: Schau dir die Live-Datei an und nutze ein Testtool für robots.txt. Die Google Search Console hat einen integrierten robots.txt-Tester für Googlebot, die Regeln für KI-Crawler musst du aber selbst überprüfen.
Fehler 5: Einmal einrichten und dann vergessen
Neue KI-Crawler tauchen regelmäßig auf. Die Liste der KI-User-Agents von 2023 ist 2026 schon nicht mehr vollständig. Überprüf deine robots.txt mindestens einmal pro Quartal und halte Ausschau nach neuer Crawler-Dokumentation der großen KI-Unternehmen.
Mehr als robots.txt: Der komplette Werkzeugkasten zur Steuerung von KI-Crawlern
Die robots.txt ist der wichtigste, aber nicht der einzige Hebel, um den Zugriff von KI-Crawlern zu steuern. Zu einem vollständigen technischen AEO-Setup gehören:
- robots.txt: Zugriffsregeln für Crawler (siehe oben)
- llms.txt: Eine Leitdatei für LLMs, die beschreibt, was deine Website abdeckt und wie die Inhalte genutzt werden sollen – eine Ergänzung zur robots.txt, kein Ersatz
- noindex-Meta-Tags: Steuerung auf Seitenebene, die die Indexierung einzelner Seiten verhindert und von manchen KI-Crawlern respektiert wird
- KI-Bot-Monitoring: Verfolge, welche Crawler wie oft auf deine Website zugreifen – die Bot-Tracking-Funktion von AI Rank Lab liefert dir diesen Überblick ohne Logfile-Analyse
Nutze den kostenlosen robots.txt-Generator
Statt deine robots.txt von Grund auf selbst zu schreiben, nimm einfach den kostenlosen robots.txt-Generator von AI Rank Lab. Wähl den Konfigurationstyp (voller Zugriff, selektiv, Training blockieren oder benutzerdefiniert), gib die Pfade an, die geschützt werden sollen, und der Generator erstellt eine korrekt formatierte Datei mit allen aktuellen User-Agents der KI-Crawler. Du kannst das Ergebnis direkt auf deinen Server kopieren oder als Datei herunterladen.
Der Generator wird laufend aktualisiert, sobald neue User-Agents von KI-Crawlern erscheinen. So bekommst du eine Konfiguration, die auch Bots berücksichtigt, die es beim Schreiben dieses Artikels noch gar nicht gab.
Fazit
Deine robots.txt ist ein direktes Steuerpult für deine Sichtbarkeit in der KI-Suche. Ist sie richtig eingestellt, können KI-Crawler auf deine Inhalte zugreifen und daraus lernen – und das zahlt sich in Zitaten in den Antworten von ChatGPT, Perplexity, Claude und Gemini aus. Ist sie falsch eingestellt oder schlicht veraltet, entstehen unsichtbare Barrieren zwischen deinen Inhalten und den KI-Engines, über die Menschen immer häufiger Neues entdecken.
Fünf Minuten, um deine aktuelle robots.txt zu prüfen und mit dem kostenlosen Generator eine KI-taugliche Konfiguration zu erstellen: Das ist einer der wirkungsvollsten technischen Schritte, die du für deine Sichtbarkeit in der KI-Suche machen kannst. Erledige es heute und stell dir eine Erinnerung, um die Datei jedes Quartal zu überprüfen, wenn neue KI-Crawler dazukommen.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


