



Die Zitier-Frage, die sich jedes Content-Team stellen sollte
Wenn ChatGPT eine Frage beantwortet, trifft es Tausende Mikroentscheidungen darüber, welchen Quellen es vertraut, welche es zitiert und welche es paraphrasiert. Diese Entscheidungen sind nicht zufällig: Sie folgen Mustern, die sich messen und in erheblichem Maß vorhersagen lassen. Wenn du verstehst, was eine Zitierung durch LLMs vorhersagt, kannst du Content gezielt so bauen, dass er mit höherer Wahrscheinlichkeit ausgewählt wird.
Wir haben 10.000 Anfragen über ChatGPT (GPT-4o), Perplexity, Claude 3.5 Sonnet und Gemini Advanced laufen lassen und dabei erfasst, welche Domains zitiert wurden, wie oft und in welchem Kontext. Anschließend haben wir die zitierten Domains mit 14 verschiedenen Website- und Content-Merkmalen abgeglichen, um herauszufinden, was eine Zitierung vorhersagt. Manche Ergebnisse bestätigen die gängige AEO-Theorie. Andere haben uns echt überrascht.
So war die Studie aufgebaut
Die 10.000 Anfragen verteilten sich gleichmäßig auf vier Kategorien:
- Informational: Anfragen nach dem Muster „Was ist [Konzept]?“ (2.500 Anfragen)
- Vergleichend: Anfragen nach dem Muster „Bestes X vs. Y für Z“ (2.500 Anfragen)
- Prozedural: Anfragen nach dem Muster „Wie mache ich [Aufgabe]?“ (2.500 Anfragen)
- Bewertend: Anfragen wie „Sollte ich X für Y nutzen?“ oder „Lohnt sich X?“ (2.500 Anfragen)
Die Anfragen deckten 20 Themencluster ab, darunter Software, Marketing, Gesundheit, Finanzen, Recht, Essen und Kochen, Reisen, Bildung, Heimwerken und Technologie. Jede Anfrage lief auf allen vier LLMs, und die Zitierungen wurden nach Domain, Position in der Antwort und Zitierart (expliziter Link vs. implizite Erwähnung) erfasst.
Die zitierten Domains haben wir mit folgenden Merkmalen abgeglichen: Domain Authority (DA), TF-IDF-Werte, Aktualität des Contents, Wortzahl, vorhandenes FAQPage-Schema, vorhandenes HowTo-Schema, vorhandenes Article-Schema, Zugriffsstatus für KI-Bots, vorhandene llms.txt, E-E-A-T-Signale, Anzahl der Backlinks, interne Linkdichte, Lesbarkeitswert und Einzigartigkeit des Contents.
Was eine LLM-Zitierung am besten vorhersagt: das Ranking
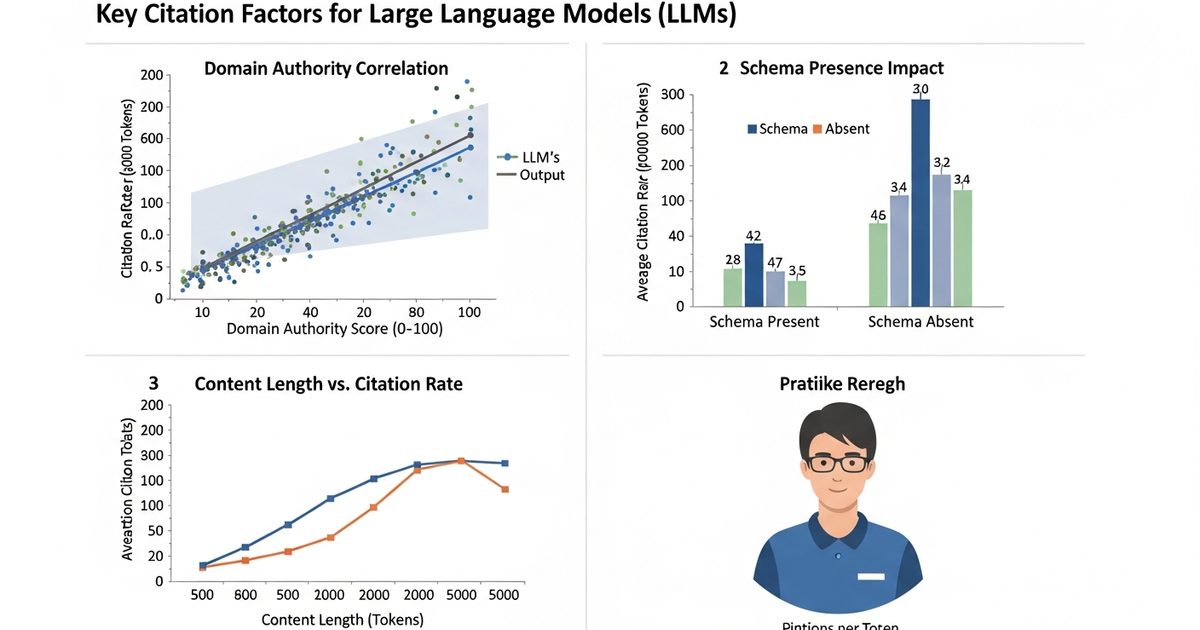
So schneiden die 14 untersuchten Merkmale nach ihrer Korrelation mit der Zitierrate ab (Pearson-Korrelationskoeffizient r):
- Vorhandenes FAQPage-Schema: r = 0,61 (stärkster Prädiktor)
- Domain Authority (50+): r = 0,54
- Aktualität des Contents (in den letzten 6 Monaten aktualisiert): r = 0,51
- Zugriff für KI-Bots (alle großen Crawler erlaubt): r = 0,49
- E-E-A-T-Signale (Qualifikation des Autors, Veröffentlichungsdatum): r = 0,47
- Direct Answer Density (Verhältnis klarer Aussagen zu relativierender Sprache): r = 0,44
- HowTo-Schema auf Anleitungsseiten: r = 0,41
- Anzahl der Backlinks: r = 0,38
- Vorhandene llms.txt: r = 0,33
- Länge des Contents (1.500-4.000 Wörter): r = 0,28
- Interne Linkdichte: r = 0,19
- Vorhandenes Article-Schema: r = 0,18
- Lesbarkeitswert: r = 0,14
- TF-IDF/Keyword-Dichte: r = 0,09
In diesem Ranking stecken einige Überraschungen, die einen genaueren Blick lohnen.
Überraschung 2: Aktualität ist der drittstärkste Prädiktor
Die Aktualität des Contents (definiert als Aktualisierung innerhalb der letzten 6 Monate, signalisiert über das Feld dateModified im Article-Schema) landete in unserer Studie auf Platz drei, noch vor dem Zugriff für KI-Bots, vor E-E-A-T-Signalen und vor Backlinks. Das hat uns überrascht, denn die AEO-Literatur konzentriert sich meist auf Struktur und Schema, nicht auf zeitliche Signale.
Die Erklärung scheint vom Anfragetyp abzuhängen. Bei informationalen Anfragen zu stabilen Konzepten spielt Aktualität kaum eine Rolle. Beim Großteil der Anfragen in unserem Testset (die sich um lebendige Themencluster wie Software, KI-Tools, Regulierung und Best Practices drehten) bevorzugen KI-Engines jedoch klar kürzlich aktualisierte Quellen. Veralteter Content zu schnelllebigen Themen wird systematisch nach hinten gereiht.
Die Lehre für die Praxis: Aktualität ist nicht nur ein Thema für die Suchmaschinenoptimierung (SEO), sondern auch ein AEO-Signal. Wenn du wichtige Seiten aktuell hältst (und diese Updates korrekt über dateModified im Article-Schema signalisierst), steigen deine LLM-Zitierraten bei Themen, in denen Aktualität zählt.
Überraschung 3: Keyword-Dichte ist der schwächste Prädiktor
TF-IDF und Keyword-Dichte landeten mit einem Korrelationskoeffizienten von gerade einmal 0,09 auf dem letzten Platz unserer 14 Merkmale, faktisch also Rauschen. Das ist der deutlichste Datenpunkt für den grundlegenden Unterschied zwischen SEO und AEO: Optimierung auf Keyword-Dichte ist für die Zitierentscheidungen von LLMs irrelevant. KI-Engines verstehen Themen über semantische Analyse, nicht über die Häufigkeit von Keywords.
Content, der Fragen klar und vollständig beantwortet, ohne Keyword-Stuffing oder gezielte Dichte-Optimierung, schlägt keyword-optimierten Content bei den LLM-Zitierraten durchgehend. Wer für Menschen schreibt und Fragen direkt beantwortet, fährt bei KI-Engines besser als jemand, der für Algorithmen schreibt.
Nach LLM aufgeschlüsselt: Die Zitiermuster unterscheiden sich
Die Prädiktoren oben sind Durchschnittswerte über alle vier LLMs. Schaut man sich jede Plattform einzeln an, zeigen sich wichtige Unterschiede:
ChatGPT (GPT-4o)
Bei ChatGPT ist die Domain Authority ein stärkerer Prädiktor (r = 0,61) als bei jeder anderen Plattform. Die Trainingsdaten von ChatGPT sind auf Quellen mit hoher Autorität ausgerichtet, was etablierten Domains einen dauerhaften Vorteil verschafft. Der Effekt des FAQPage-Schemas ist vorhanden, aber kleiner (r = 0,48), weil das Basismodell von ChatGPT vor allem auf Trainingsdaten setzt statt auf die Extraktion strukturierter Daten in Echtzeit. Neue Domains mit exzellentem Schema profitieren trotzdem, der Autoritätsbonus ist aber höher.
Perplexity
Perplexity zeigt das ausgewogenste Prädiktorprofil. Aktualität ist hier der stärkste Prädiktor (r = 0,68), denn Perplexity priorisiert in seinem Retrieval-Modell ausdrücklich aktuelle Live-Inhalte. Auch FAQPage-Schema (r = 0,58) und der Zugriff für KI-Bots (r = 0,57) wirken sehr stark. Perplexity ist das LLM, das am stärksten auf AEO-Optimierung „anspringt“, weil es aktiv aus dem Live-Web abruft und zitiert.
Claude
Claude zeigt die stärkste Korrelation mit E-E-A-T-Signalen (r = 0,59). Anthropics Ansatz zur Quellenqualität legt Wert auf die Qualifikation der Autoren, die Autorität der Organisation und die Herkunft des Contents. Websites mit klar ausgewiesenen, qualifizierten Autoren, institutioneller Anbindung und gut dokumentierter Methodik werden von Claude häufiger zitiert als von anderen LLMs. llms.txt wirkt bei Claude stärker (r = 0,41) als bei jeder anderen Plattform in unserer Studie.
Gemini
Gemini zeigt die am stärksten an Google angelehnten Muster: Domain Authority (r = 0,62) und Anzahl der Backlinks (r = 0,52) sind hier die stärksten Prädiktoren, näher am klassischen SEO als bei jedem anderen LLM. Das passt zur Architektur von Gemini, die Googles Knowledge Graph und aus PageRank abgeleitete Signale einbezieht. Der Weg zur Zitierung in Gemini führt eher über klassische SEO-Autorität als über AEO-spezifische Signale, auch wenn FAQPage-Schema (r = 0,44) weiterhin deutlich zählt.
Nach Anfragetyp: Was in welchem Kontext zitiert wird
Informationale Anfragen
Hier dominiert das FAQPage-Schema (r = 0,71). Die Direct Answer Density (also wie viel des Contents aus klaren Aussagen besteht, die konkrete Fragen beantworten) ist der zweitstärkste Prädiktor. Domain Authority spielt eine Rolle, liegt aber nur auf Platz drei. Bei diesem Anfragetyp hat AEO-Optimierung den größten Einfluss.
Vergleichende Anfragen
Domain Authority ist der stärkste Prädiktor (r = 0,65). Bei „X vs. Y“-Anfragen zitieren KI-Engines tendenziell Quellen, denen sie auf Domain-Ebene ohnehin vertrauen: etablierte Testportale und große Publikationen. Websites mit gezieltem Vergleichs-Content, der mit klaren Feature-Tabellen und FAQPage-Schema strukturiert ist, schlagen aber durchaus Websites mit höherer Autorität, deren Vergleiche weniger strukturiert sind.
Prozedurale Anfragen
Bei „Wie mache ich …“-Anfragen ist HowTo-Schema der stärkste Prädiktor (r = 0,67), genau wie es die Schema-Theorie erwarten lässt. Aktualität folgt auf Platz zwei, denn Anleitungen zu Tools und Software müssen aktuell sein, um zitierfähig zu sein. Bei diesem Anfragetyp hat HowTo-Schema den klarsten und am besten messbaren Einfluss auf Zitierungen.
Bewertende Anfragen
Bei bewertenden Anfragen sind E-E-A-T-Signale der stärkste Prädiktor (r = 0,61). Bei Fragen wie „Lohnt sich X?“ oder „Sollte ich X für Y nutzen?“ entscheiden die Qualifikation der Autoren, transparente Methodik und die Autorität der Organisation am stärksten über die Auswahl der Quellen. Genau hier ist Content ohne nachweisbare Expertise am systematischsten im Nachteil.
Der Effekt des Bot-Zugriffs
Ein Ergebnis verdient besondere Betonung: Bei Domains, die KI-Crawler blockieren, sinken die Zitierraten bei Echtzeit-KI-Systemen (Perplexity, ChatGPT Browse) nahezu auf null. Das war zu erwarten, denn blockierte Bots können den Content nicht lesen. Überrascht hat uns aber die verbleibende Zitierrate des Basismodells von ChatGPT aus den Trainingsdaten: Selbst Domains, die GPTBot blockieren, werden vom ChatGPT-Basismodell gelegentlich zitiert, wenn ihr Content schon vor der Sperre im Trainingskorpus war.
Das wiegt Publisher, die KI-Crawler blockiert haben, in falscher Sicherheit. Sie sehen womöglich einige ChatGPT-Zitierungen aus historischen Trainingsdaten und schließen daraus, dass die Sperre keine Auswirkung hat. Die tatsächliche Wirkung wird erst sichtbar, wenn man die Zitierungen in Perplexity und ChatGPT Browse misst, wo die Sperre zu Raten nahe null führt. Mit den Citation Analytics von AI Rank Lab misst du die Zitierraten über alle vier großen LLMs hinweg, nicht nur auf dem einen, das dir womöglich ein falsch positives Bild liefert.
So setzt du die Ergebnisse um
Aus dem Ranking der Prädiktoren ergibt sich eine klare Reihenfolge für deine AEO-Investitionen:
- FAQPage-Schema auf allen informationalen Seiten: höchste Korrelation mit Zitierungen über alle Anfragetypen und alle LLMs hinweg
- Domain Authority über hochwertige Backlinks aufbauen: zweitstärkster Prädiktor und besonders wichtig für ChatGPT und Gemini
- Content aktuell halten und Aktualität signalisieren: entscheidend für Perplexity und für jedes Thema, bei dem Aktualität zählt
- Zugriff für KI-Bots freigeben: Grundvoraussetzung für Echtzeit-Zitierungen durch Perplexity und ChatGPT Browse
- E-E-A-T-Signale ausbauen: besonders wichtig für Claude und für bewertende Anfragetypen
- HowTo-Schema für Tutorials ergänzen: der Schema-Typ mit der größten Wirkung bei Anleitungs-Content
- llms.txt einrichten: spürbarer Effekt vor allem bei Claude, bei relativ geringem Aufwand
Hör auf, auf Keyword-Dichte zu optimieren. Sie hat von allen Faktoren in unserer Studie die schwächste Korrelation mit LLM-Zitierungen. Derselbe Aufwand, in die Umsetzung von FAQPage-Schema gesteckt, bringt rund 7-mal so viel Verbesserung bei den Zitierungen.
Fazit
Die Zitiermuster der großen LLMs sind messbar, konsistent und lassen sich in konkrete Maßnahmen übersetzen. FAQPage-Schema ist über Anfragetypen und Plattformen hinweg der stärkste Einzelprädiktor für Zitierungen. Aktualität ist wichtiger, als die meisten AEO-Praktiker zugeben. Keyword-Dichte ist irrelevant. Und die Zitiermuster unterscheiden sich zwischen den LLMs so deutlich, dass eine plattformspezifische Strategie bessere Ergebnisse bringt als ein Ansatz, der nur auf ein LLM zielt: Perplexity (Aktualität + Schema), ChatGPT (Autorität + Schema), Claude (E-E-A-T + llms.txt) und Gemini (klassisches SEO + Schema).
Mit den Citation Analytics von AI Rank Lab verfolgst du deine Zitierraten auf allen vier Plattformen und siehst, welche Prädiktor-Signale in deinem konkreten Themencluster am stärksten wirken. Die Daten dieser Studie sind Durchschnittswerte; in deiner Kategorie und für deinen Content-Typ können die Faktoren anders gewichtet sein.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


