



Por qué tu robots.txt importa más que nunca en 2026
El archivo robots.txt nació en 1994 para decirles a los rastreadores web qué páginas debían evitar. Durante 30 años, a los webmasters solo les preocupaba una gran familia de rastreadores: Googlebot. En 2026, esa lista ha crecido una barbaridad. Las empresas de IA (OpenAI, Anthropic, Perplexity, Google) tienen sus propios rastreadores, que leen tu contenido para entrenar modelos, construir bases de conocimiento y generar respuestas en los buscadores con IA.
Permitir o bloquear estos rastreadores tiene consecuencias directas en tu visibilidad en la búsqueda con IA. Si GPTBot no puede rastrear tu sitio, tu contenido no alimenta las respuestas de ChatGPT. Si bloqueas PerplexityBot, Perplexity no puede citar tus páginas. Y si Google-Extended está bloqueado, puede que tu contenido no aparezca en las respuestas de AI Overviews (los resúmenes con IA de Google) ni de AI Mode (el modo IA).
Configurar bien el robots.txt en la era de los rastreadores de IA exige saber qué bots existen, qué hace cada uno y cómo dar acceso de forma que protejas tu contenido y, a la vez, aproveches al máximo tus posibilidades de que la IA te cite. Esta guía lo cubre todo, e incluye un generador de robots.txt gratis con el que puedes crear una configuración lista para la IA en pocos minutos.
El directorio completo de rastreadores de IA
Antes de configurar nada, tienes que saber a qué bots te diriges. Estos son los principales rastreadores de IA y sus user agents en 2026:
OpenAI - ChatGPT
- User-agent: GPTBot
- Función: recopilar datos de entrenamiento y alimentar la función Browse de ChatGPT
- Si lo bloqueas: tu contenido no alimentará las respuestas de ChatGPT ni aparecerá en las citas de ChatGPT Browse
- Documentación: OpenAI mantiene una lista pública de los rangos de IP de GPTBot
Anthropic - Claude
- User-agent: ClaudeBot (también identificado como anthropic-ai)
- Función: datos de entrenamiento y base de conocimiento para Claude AI
- Si lo bloqueas: tu contenido no alimenta las respuestas de Claude cuando los usuarios preguntan sobre tu temática
- Documentación: Anthropic publicó su política de rastreo y respeta las directivas de robots.txt
Perplexity AI
- User-agent: PerplexityBot
- Función: búsqueda web en tiempo real para las respuestas y citas de Perplexity AI
- Si lo bloqueas: tus páginas no se citarán en las respuestas de Perplexity, aunque sean muy relevantes
- Documentación: Perplexity respeta robots.txt y ha publicado sus pautas de rastreo
Google - Funciones de IA
- User-agent: Google-Extended
- Función: entrenamiento de Google Bard/Gemini y contenido para AI Overviews
- Si lo bloqueas: puede que tu contenido no aparezca en AI Overviews, AI Mode ni en las respuestas de Gemini
- Ojo: es independiente de Googlebot. Puedes permitir Googlebot (búsqueda tradicional) y bloquear Google-Extended (funciones de IA)
Microsoft - Copilot
- User-agent: Bingbot (compartido); los rastreadores específicos de Copilot varían
- Función: impulsa Microsoft Copilot y las respuestas con IA de Bing
- Si lo bloqueas: menos visibilidad en Microsoft Copilot y en las funciones de IA de Bing
Meta - Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- Función: datos de entrenamiento para Meta AI y los modelos Llama
- Si lo bloqueas: tu contenido no alimenta las respuestas de Meta AI
Apple - Applebot
- User-agent: Applebot, Applebot-Extended
- Función: Siri, Apple Intelligence y las funciones de búsqueda de Apple
- Si lo bloqueas: menos visibilidad en Siri y en las funciones de IA de Apple
El problema: la mayoría de los robots.txt se escribieron antes de que existieran los rastreadores de IA
Un robots.txt típico de 2020-2023 tiene este aspecto:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Esta configuración permite Googlebot, pero deja todos los demás bots en manos de la regla comodín. Según cómo se interprete, esa regla podría estar bloqueando a los rastreadores de IA en algunas secciones de tu sitio, o bien dejándolos entrar en todas partes, incluidas las páginas que preferirías proteger.
Peor aún: algunos sitios añadieron bloqueos agresivos en los primeros tiempos de los rastreadores de IA (2022-2023), cuando el rechazo de los editores al uso de su contenido para entrenar IA estaba en su punto álgido. Si tu sitio añadió Disallow: / para todos los bots, puede que dejaras fuera a los rastreadores de IA y te olvidaras del tema. Las consecuencias solo salen a la luz cuando notas que tu marca apenas aparece en las respuestas de los buscadores con IA.
La función de seguimiento de bots de IA de AI Rank Lab te muestra qué bots de IA visitan realmente tus páginas y qué asistentes de IA te envían tráfico de referencia, sin tener que analizar logs a mano. Si un rastreador que querías permitir nunca aparece, revisa sus reglas en tu robots.txt.
Plantillas de robots.txt para cada escenario
Usa nuestro generador de robots.txt gratis para adaptar estas plantillas a tu sitio. Estas son las configuraciones más habituales:
Plantilla 1: acceso total para la IA (recomendada para la mayoría de los sitios)
Permite que todos los rastreadores de IA accedan a tu contenido. Ideal para sitios que buscan la máxima visibilidad en la búsqueda con IA y no tienen problema en que su contenido se use para entrenar modelos de IA.
# Rastreadores de búsqueda estándar
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Buscadores tradicionales
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# Rastreadores de IA - permitidos explícitamente
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Plantilla 2: acceso selectivo para la IA (protección de contenido)
Permite los rastreadores de IA en las páginas de contenido público, pero bloquea el contenido premium, los artículos de pago y las zonas de miembros. Ideal para medios por suscripción y sitios con contenido restringido.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# Rastreadores de IA - solo contenido público
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Plantilla 3: bloquear el entrenamiento de IA, permitir la búsqueda con IA
Una configuración con matices: permite Perplexity (que usa tu contenido para citarlo en tiempo real), pero bloquea los rastreadores de entrenamiento (que usan tu contenido para entrenar modelos). Es un punto intermedio habitual entre los editores que quieren aparecer citados en la búsqueda con IA, pero no aceptan que su contenido se use para entrenar modelos.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - citas en tiempo real, permitir
User-agent: PerplexityBot
Allow: /

# Funciones de IA de Google - permitir para AI Overviews
User-agent: Google-Extended
Allow: /

# Entrenamiento de OpenAI - bloquear
User-agent: GPTBot
Disallow: /

# Entrenamiento de Anthropic - bloquear
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml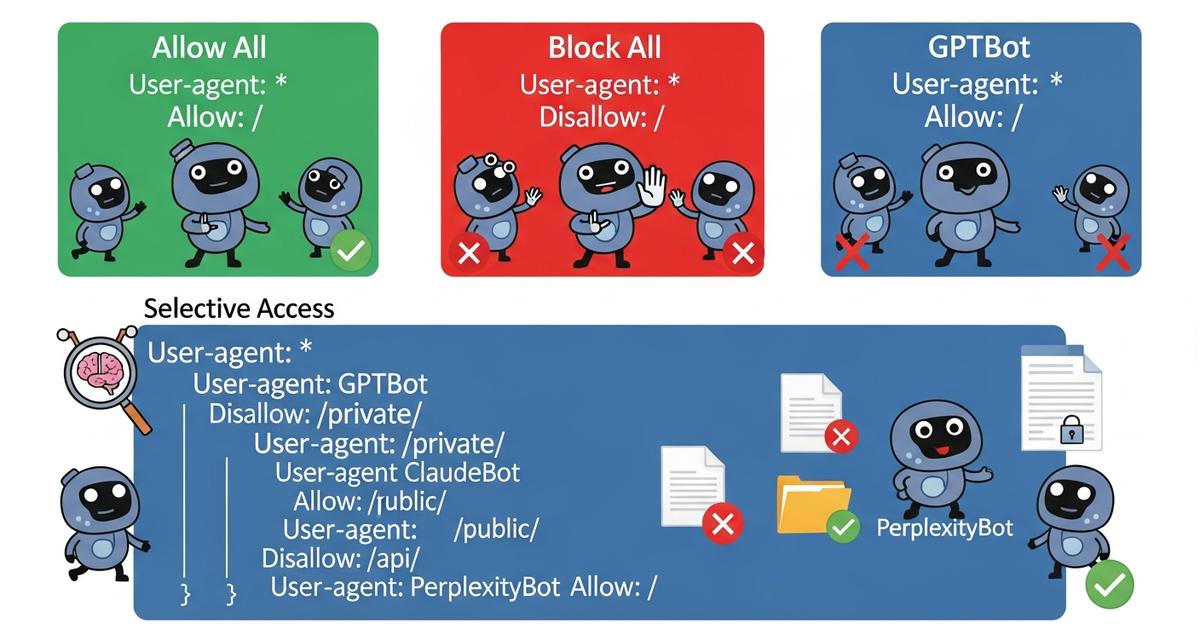
Cómo elegir la configuración adecuada para ti
La configuración de robots.txt correcta depende de tu tipo de contenido, tu modelo de negocio y tus objetivos de visibilidad en la búsqueda con IA. Usa este esquema para decidir:
Permite todos los rastreadores de IA si:
- Tu sitio publica contenido de acceso libre (blog, documentación, recursos)
- Buscas la máxima visibilidad en la búsqueda con IA y las citas son una fuente de tráfico
- No tienes contenido restringido o premium que necesite protección
- Tu contenido es informativo y sale ganando con una distribución amplia
Usa el acceso selectivo si:
- Combinas contenido gratuito y premium
- Hay páginas que no deberían citarse (páginas de cuenta, procesos de pago, contenido solo para miembros)
- Quieres que los rastreadores de IA se centren en tu mejor contenido en lugar de rastrearlo todo
Bloquea los rastreadores de entrenamiento (y permite solo la búsqueda) si:
- Eres un editor al que le preocupa el uso de su contenido para entrenar IA
- Aun así quieres aparecer en Perplexity y en AI Overviews de Google (citas en tiempo real)
- Quieres conservar la opción de licenciar tu contenido a empresas de IA por separado
Bloquea todos los rastreadores de IA solo si:
- Tienes motivos legales o competitivos claros para mantener tu contenido fuera de los sistemas de IA
- Tienes un acuerdo de licencia con empresas de IA concretas y quieres hacer valer la exclusividad
- Asumes las consecuencias: visibilidad cero en la búsqueda con IA para tu dominio
Errores comunes que debes evitar
Error 1: usar un bloqueo comodín para los bots desconocidos
Configuraciones como User-agent: * / Disallow: / seguidas de reglas de permiso específicas para Googlebot bloquearán a todos los rastreadores de IA, porque estos no tienen reglas de permiso explícitas. Sé siempre explícito con el acceso de los rastreadores de IA.
Error 2: no saber cuál es tu configuración actual
Muchos equipos no saben qué dice ahora mismo su robots.txt sobre los rastreadores de IA. Compruébalo ya en yoursite.com/robots.txt. Las herramientas de AI Rank Lab también te ayudan: la auditoría gratuita del sitio comprueba que tu robots.txt existe y es accesible.
Error 3: confundir Googlebot con Google-Extended
Permitir Googlebot no permite automáticamente Google-Extended (el rastreador de las funciones de IA). Si quieres aparecer en AI Overviews y AI Mode de Google, necesitas una regla explícita que permita Google-Extended.
Error 4: no hacer pruebas después de los cambios
Después de actualizar tu robots.txt, verifica que los cambios se han aplicado revisando el archivo publicado y usando una herramienta de prueba de robots.txt. Google Search Console tiene un probador de robots.txt integrado para Googlebot, pero las reglas de los rastreadores de IA tendrás que verificarlas a mano.
Error 5: configurarlo y olvidarte
Cada dos por tres aparecen nuevos rastreadores de IA. La lista de user agents de IA de 2023 ya está incompleta en 2026. Revisa tu robots.txt al menos una vez por trimestre y consulta la documentación de los nuevos rastreadores que publiquen las grandes empresas de IA.
Más allá del robots.txt: todas las piezas para controlar los rastreadores de IA
El robots.txt es la palanca más importante para controlar el acceso de los rastreadores de IA, pero no la única. Una configuración técnica de AEO completa incluye:
- robots.txt: reglas de acceso para los rastreadores (lo que hemos visto arriba)
- llms.txt: un archivo de orientación para los LLM sobre qué cubre tu sitio y cómo debería usarse el contenido; complementa al robots.txt, no lo sustituye
- Metaetiquetas noindex: control a nivel de página que impide que se indexen páginas concretas, y que algunos rastreadores de IA respetan
- Monitorización de bots de IA: controla qué rastreadores acceden a tu sitio y con qué frecuencia; la función de seguimiento de bots de AI Rank Lab te da esa visibilidad sin analizar logs
Usa el generador de robots.txt gratis
En lugar de escribir tu robots.txt desde cero, usa el generador de robots.txt gratis de AI Rank Lab. Elige el tipo de configuración (acceso total, selectivo, bloqueo del entrenamiento o personalizado), indica las rutas que quieras proteger y generará un archivo con el formato correcto que incluye todos los user agents actuales de los rastreadores de IA. Puedes copiar el resultado directamente a tu servidor o descargarlo como archivo.
El generador se mantiene al día a medida que salen nuevos user agents de rastreadores de IA, así que obtienes una configuración que tiene en cuenta bots que ni existían cuando se escribió este artículo.
Conclusión
Tu robots.txt es un panel de control directo de tu visibilidad en la búsqueda con IA. Si lo configuras bien, los rastreadores de IA pueden acceder a tu contenido y aprender de él, y eso se traduce en citas en las respuestas de ChatGPT, Perplexity, Claude y Gemini. Si lo configuras mal, o dejas un archivo desactualizado, levantas barreras invisibles entre tu contenido y los motores de IA que cada vez tienen más peso en cómo la gente descubre marcas y contenidos.
Dedicar cinco minutos a revisar tu robots.txt actual y a crear una configuración lista para la IA con el generador gratuito es una de las acciones técnicas con más retorno que puedes hacer por tu visibilidad en la búsqueda con IA. Hazlo hoy y ponte un recordatorio para revisarlo cada trimestre, a medida que entren nuevos rastreadores de IA en el ecosistema.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


