



El debate sobre llms.txt: ¿señal real o efecto placebo?
Desde que se propuso la especificación llms.txt, la comunidad de SEO y AEO está dividida. Sus defensores dicen que es una señal clara para los sistemas de IA sobre qué es tu sitio y qué temas cubre: justo esa guía estructurada que podría inclinar a tu favor la decisión de citarte. Los escépticos responden que es demasiado nuevo para tener un impacto real, que pocos sistemas de IA lo admiten de forma oficial y que las mejoras de citas que se le atribuyen vienen en realidad de los cambios de contenido que los equipos hacen al implementarlo.
Queríamos dejar atrás las especulaciones. Con la infraestructura de seguimiento de citas de AI Rank Lab analizamos 500 sitios antes y después de añadir un archivo llms.txt, y medimos su tasa de citas en ChatGPT (GPT-4o), Perplexity y Claude 3.5 Sonnet durante una ventana de 90 días. También estudiamos qué diferenciaba a los sitios con grandes mejoras de los que apenas cambiaron.
Esto es lo que encontramos, incluidas las partes que contradicen las promesas más optimistas sobre llms.txt.
El estudio de 500 sitios: metodología
Seguimos 500 dominios que añadieron llms.txt por primera vez durante un periodo de análisis de seis meses. Todos ellos:
- Ya permitían el acceso a los rastreadores de IA (GPTBot, ClaudeBot y PerplexityBot autorizados en robots.txt)
- Tenían al menos 30 días de datos de referencia sobre citas antes de añadir llms.txt
- No hicieron cambios importantes de contenido ni consiguieron backlinks nuevos relevantes durante la ventana de medición
- Tenían entre 10 y 500 páginas (excluimos los sitios muy pequeños y muy grandes para reducir variables de confusión)
Definimos la tasa de citas así: número de veces que un LLM citó un dominio al responder a una consulta del clúster temático principal de ese dominio, expresado como porcentaje de las consultas probadas. Probamos 50 consultas por dominio y por LLM, sacadas del conjunto de palabras clave principales de cada dominio.
Los sitios abarcaban 12 sectores: SaaS, e-commerce, servicios locales, servicios B2B, medios editoriales, salud, legal, servicios financieros, educación, inmobiliario, viajes y noticias de tecnología.
Hallazgo clave 1: llms.txt mejora la tasa de citas, pero no en todos los LLM
En el conjunto de los 500 sitios, estos fueron los cambios medios en la tasa de citas durante los 90 días posteriores a añadir llms.txt:
- Perplexity: +18 % de mejora media en la tasa de citas
- ChatGPT (con Browse): +12 % de mejora media en la tasa de citas
- Claude: +7 % de mejora media en la tasa de citas
- ChatGPT (sin Browse, GPT-4o base): +3 % (no estadísticamente significativo)
La diferencia entre LLM es notable y no se explica del todo por cómo rastrea cada uno. La respuesta más fuerte de Perplexity probablemente se debe a su arquitectura de búsqueda web en tiempo real: usa de forma activa los archivos de guía estructurada al redactar sus respuestas. El modo Browse de ChatGPT (que consulta contenido web en vivo) muestra una mejora clara, mientras que el modelo GPT-4o base (que depende sobre todo de sus datos de entrenamiento) apenas cambia por añadir un solo archivo.
La mejora moderada de Claude encaja con el enfoque que Anthropic ha publicado: ClaudeBot rastrea y respeta los archivos de guía, pero los datos de entrenamiento de Claude se renuevan con un ciclo más largo que la recuperación en tiempo real de Perplexity. La mejora es real, solo que tarda más en notarse.
Hallazgo clave 2: lo que más pesa es la calidad del resumen de llms.txt
Los sitios con mayores mejoras (el cuartil superior, con un aumento medio del +31 % en la tasa de citas) tenían algo en común: un resumen en formato blockquote muy concreto, que describía con claridad su diferenciación, su público y los temas que cubren.
Puntuamos el resumen de llms.txt de cada sitio según cinco criterios:
- Concreción del público (¿para quién es?)
- Claridad de la diferenciación (¿qué hace distinto a este sitio?)
- Cobertura temática completa (¿qué temas trata el sitio?)
- Señales de autoridad (cualquier indicador de credibilidad: datos, experiencia, metodología)
- Contexto de acción (¿qué puede hacer el lector con este sitio?)
Los sitios con 4-5 puntos en esta rúbrica lograron de media un +27 % de mejora en citas. Los que sacaron 1-2 puntos se quedaron en un +6 % de media, apenas por encima del ruido. El formato del archivo importa mucho menos que la calidad del contenido de la sección de resumen.
Ejemplos de resúmenes con puntuación alta y baja:
Puntuación baja (cumple 1/5 criterios):
"Example Corp ofrece herramientas y recursos de marketing para empresas."
Puntuación alta (cumple 5/5 criterios):
"Example Corp es una plataforma B2B de atribución de marketing que usan más de 2.000 empresas SaaS medianas para medir la contribución al pipeline de los canales de dark social (LinkedIn, menciones en podcasts, foros de comunidades) que la atribución estándar basada en UTM no capta. Casos de uso principales: el VP de Marketing que reporta al consejo el pipeline no rastreable y los equipos de demand gen que justifican la inversión en dark social."
El ejemplo con puntuación alta concreta el público (VP de Marketing y equipos de demand gen en empresas SaaS medianas), la diferenciación (atribución de dark social), la autoridad (más de 2.000 empresas) y el contexto de acción (reportes al consejo, justificación de la inversión). Un sistema de IA que lea esto puede describir el producto con precisión cuando alguien pregunte por herramientas de atribución de marketing para empresas SaaS.
Hallazgo clave 3: los listados de páginas impulsan las citas de long tail
Los sitios que incluyeron listados detallados de páginas en su llms.txt (y no solo la sección de resumen) obtuvieron una mejora adicional en consultas de long tail, es decir, preguntas sobre funciones, casos de uso o temas concretos tratados en las páginas listadas.
El efecto fue más fuerte en páginas con pocos enlaces internos. Para estas páginas "huérfanas pero importantes" (páginas de herramientas, documentación técnica, guías de nicho), aparecer en el listado de llms.txt fue la vía principal por la que los sistemas de IA aprendieron a citarlas en consultas relevantes. Sin el listado, estas páginas eran prácticamente invisibles para las citas de IA, aunque tuvieran contenido valioso.
Los sitios con 15 o más páginas listadas y bien descritas lograron un +22 % de mejora en citas de long tail, frente al +9 % de los sitios sin listados o con listados breves y sin descripción.
Hallazgo clave 4: llms.txt por sí solo no basta
El hallazgo negativo más importante: los sitios que bloqueaban los rastreadores de IA en robots.txt no mejoraron nada en citas tras añadir llms.txt. Era de esperar, pero conviene decirlo claro: llms.txt no puede ayudarte si los rastreadores de IA no pueden entrar en tu sitio. El archivo orienta a los rastreadores que ya tienen acceso; no anula las restricciones.
Del mismo modo, los sitios con contenido escaso o de baja calidad apenas mejoraron, incluso con archivos llms.txt muy buenos. Los sistemas de IA no citan más un contenido flojo porque un archivo diga que es importante. El archivo mejora cómo la IA entiende y recorre tu sitio, pero el contenido de fondo tiene que merecer la cita.
Para ver el panorama completo de lo que impulsa las citas en IA, consulta la guía de optimización para la búsqueda con IA. llms.txt es una de varias señales que funcionan en conjunto, no una solución aislada.
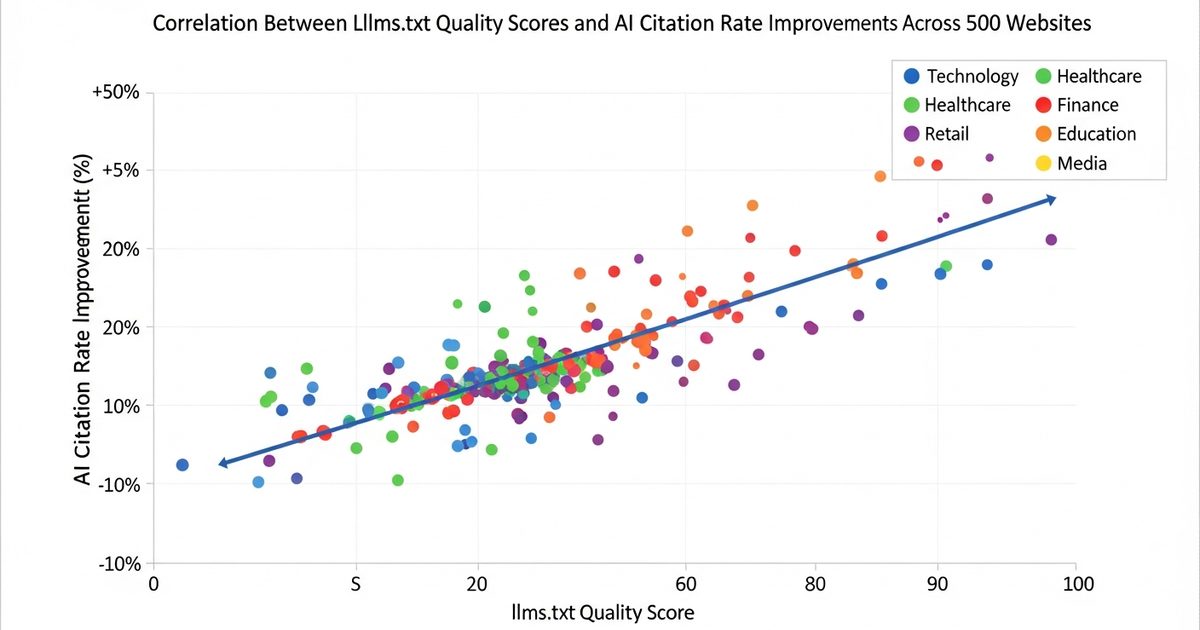
Por sectores: ¿quién saca más partido a llms.txt?
La mejora en citas gracias a llms.txt varió mucho según el sector:
Mayor beneficio (mejora media del +20-35 %)
- SaaS y tecnología: los sistemas de IA suelen clasificar mal los productos de software o describirlos de forma incorrecta. Un resumen de llms.txt concreto corrige bien esos errores.
- Servicios financieros: la IA es prudente a la hora de citar contenido financiero sin señales claras de autoridad. Un llms.txt que incluye credenciales regulatorias, descripción de la metodología o cualificaciones profesionales mejora la tasa de citas de forma medible.
- Salud y medicina: la misma dinámica que en servicios financieros. Las señales de autoridad en el resumen mejoran muchísimo la tasa de citas de los sitios de información sanitaria con experiencia legítima.
Beneficio moderado (mejora media del +8-18 %)
- Servicios B2B: los servicios complejos, difíciles de clasificar solo por su contenido, ganan con una descripción explícita, aunque la mejora es moderada.
- Educación: describir con claridad los temas cubiertos ayuda a la IA a emparejar el contenido educativo con consultas de aprendizaje concretas.
- Medios y noticias: se benefician sobre todo de las indicaciones sobre frescura del contenido (señalar qué secciones se actualizan a menudo), no tanto del resumen.
Menor beneficio (mejora media del +3-8 %)
- E-commerce: la IA entiende bien las páginas de producto gracias a los datos estructurados (Product schema). llms.txt aporta menos valor adicional cuando el schema es completo.
- Servicios locales: en los servicios locales, los patrones de citas dependen mucho más de las reseñas y de la coherencia NAP (nombre, dirección y teléfono) que de las indicaciones de llms.txt.
Lo que los escépticos tienen razón en decir
Nuestros datos respaldan algunas de las críticas a llms.txt:
No garantiza que te citen. Incluso el cuartil superior mejoró un +31 %, pero partiendo de una base. Los sitios con una tasa de citas del 10 % pasaron a un ~13 %. No es una transformación, sino una mejora significativa que se va acumulando con el tiempo.
Las mejoras de contenido pesan más. Comparamos los sitios que solo añadieron llms.txt con los que, a la vez, mejoraron la calidad de su contenido (mejores respuestas en las FAQ, datos estructurados más concretos). El grupo que mejoró el contenido logró 2,4 veces la mejora en citas del grupo que solo añadió llms.txt. llms.txt amplifica el buen contenido, no lo sustituye.
No todos los LLM responden igual. En el modelo base de ChatGPT (sin Browse), el impacto es pequeño. Si tus consultas objetivo las responden sobre todo modelos que dependen de sus datos de entrenamiento y no de la recuperación en tiempo real, las mejoras de llms.txt serán más lentas y más difíciles de medir.
Nuestra recomendación
A partir de los datos, esto es lo que recomendamos:
- Implementa llms.txt si aún no lo tienes: el beneficio potencial es real, el coste de implementación es bajo (30-60 minutos para un archivo de calidad) y no tiene ninguna desventaja
- Prioriza la calidad del resumen: de ahí sale el 70 % de la mejora en citas; dedica tu tiempo a una descripción concreta, enfocada en tu público y diferenciada
- Lista tus páginas importantes con pocos enlaces internos: sobre todo páginas de herramientas, documentación y guías temáticas que no reciben muchos enlaces internos
- Arregla primero robots.txt si bloquea a los rastreadores de IA: un llms.txt en un sitio bloqueado no sirve de nada
- Combínalo con mejoras de contenido y de schema: llms.txt funciona mejor como parte de una estrategia de AEO completa, no como un parche aislado
Usa el generador gratuito de llms.txt de AI Rank Lab para crear tu archivo, y la herramienta de auditoría completa para comprobar si tu llms.txt actual está bien formado y si funciona junto con tus demás señales de AEO.
Conclusión
llms.txt tiene un impacto real y medible en la tasa de citas en IA, sobre todo en Perplexity y en ChatGPT con Browse, sobre todo en sitios con productos o servicios complejos o fáciles de clasificar mal, y sobre todo cuando el resumen es concreto y diferenciado. El archivo no hace magia (no convierte un contenido flojo en algo digno de cita ni anula un bloqueo a los rastreadores), pero como pieza de una estrategia de AEO completa, compensa de sobra los 30 minutos que cuesta implementarlo.
La idea principal: la calidad del resumen de tu llms.txt importa mucho más que el simple hecho de tener el archivo. Una descripción genérica de dos frases aporta muy poco. Un resumen concreto, pensado para tu público, con señales de autoridad y una diferenciación clara, mejora de verdad las citas en los LLM que lo admiten.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


