



Pourquoi votre robots.txt compte plus que jamais en 2026
Le fichier robots.txt a été conçu en 1994 pour indiquer aux robots d'exploration les pages à éviter. Pendant 30 ans, les webmasters n'avaient qu'une grande famille de robots à surveiller : Googlebot. En 2026, la liste s'est considérablement allongée. Les acteurs de l'IA – OpenAI, Anthropic, Perplexity, Google – font tous tourner leurs propres crawlers, qui lisent vos contenus pour entraîner leurs modèles, alimenter leurs bases de connaissances et générer leurs réponses de recherche IA.
Autoriser ou bloquer ces robots a des conséquences directes sur votre visibilité dans la recherche IA. Si GPTBot ne peut pas explorer votre site, vos contenus ne nourrissent pas les réponses de ChatGPT. Si vous bloquez PerplexityBot, Perplexity ne peut pas citer vos pages. Et si Google-Extended est bloqué, vos contenus risquent de ne pas apparaître dans les AI Overviews (les aperçus générés par IA de Google) ni dans les réponses d'AI Mode.
Pour bien configurer son robots.txt à l'ère des crawlers IA, il faut savoir quels robots existent, ce qu'ils font, et comment régler leur accès de façon à protéger vos contenus tout en maximisant vos chances d'être cité par l'IA. Ce guide fait le tour de la question, avec en prime un générateur de robots.txt gratuit pour créer une configuration prête pour l'IA en quelques minutes.
L'annuaire complet des crawlers IA
Avant de toucher à quoi que ce soit, il faut savoir à quels robots vous adresser. Voici les principaux crawlers IA et leurs user agents en 2026 :
OpenAI – ChatGPT
- User-agent : GPTBot
- Rôle : collecte de données d'entraînement et fonction Browse de ChatGPT
- Si vous le bloquez : vos contenus ne nourriront pas les réponses de ChatGPT et n'apparaîtront pas dans les citations de ChatGPT Browse
- Documentation : OpenAI publie la liste des plages d'adresses IP de GPTBot
Anthropic – Claude
- User-agent : ClaudeBot (également identifié comme anthropic-ai)
- Rôle : données d'entraînement et base de connaissances de Claude
- Si vous le bloquez : vos contenus ne nourrissent pas les réponses de Claude quand les utilisateurs l'interrogent sur votre domaine
- Documentation : Anthropic a publié sa politique d'exploration et respecte les directives du robots.txt
Perplexity AI
- User-agent : PerplexityBot
- Rôle : recherche web en temps réel pour les réponses et les citations de Perplexity AI
- Si vous le bloquez : vos pages ne seront pas citées dans les réponses de Perplexity, même si elles sont très pertinentes
- Documentation : Perplexity respecte le robots.txt et a publié ses consignes d'exploration
Google – fonctionnalités IA
- User-agent : Google-Extended
- Rôle : entraînement de Google Bard/Gemini et contenus des AI Overviews
- Si vous le bloquez : vos contenus risquent de ne pas apparaître dans les AI Overviews, AI Mode ou les réponses de Gemini
- À noter : il est distinct de Googlebot. Vous pouvez autoriser Googlebot (recherche classique) tout en bloquant Google-Extended (fonctionnalités IA)
Microsoft – Copilot
- User-agent : Bingbot (partagé) ; les crawlers propres à Copilot varient
- Rôle : alimente Microsoft Copilot et les réponses IA de Bing
- Si vous le bloquez : visibilité réduite dans Microsoft Copilot et les fonctionnalités IA de Bing
Meta – Llama
- User-agent : FacebookBot, Meta-ExternalAgent
- Rôle : données d'entraînement pour Meta AI et les modèles Llama
- Si vous le bloquez : vos contenus ne nourrissent pas les réponses de Meta AI
Apple – Applebot
- User-agent : Applebot, Applebot-Extended
- Rôle : Siri, Apple Intelligence et les fonctions de recherche d'Apple
- Si vous le bloquez : visibilité réduite dans Siri et les fonctionnalités IA d'Apple
Le problème : la plupart des robots.txt datent d'avant les crawlers IA
Un robots.txt typique des années 2020-2023 ressemble à ceci :
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Cette configuration autorise Googlebot mais s'en remet à la règle générique (wildcard) pour tous les autres robots. Selon l'interprétation, cette règle peut bloquer les crawlers IA sur certaines sections de votre site… ou au contraire les laisser passer partout, y compris sur des pages que vous préféreriez protéger.
Pire encore : certains sites ont ajouté des blocages musclés au début de l'ère des crawlers IA (2022-2023), quand la levée de boucliers des éditeurs contre l'utilisation de leurs contenus pour l'entraînement était à son comble. Si votre site a ajouté Disallow: / pour tous les robots, vous avez peut-être fermé la porte aux crawlers IA… puis oublié. Les conséquences ne se voient qu'au moment où vous remarquez que votre marque est sous-représentée dans les réponses de la recherche IA.
La fonctionnalité de suivi des bots IA d'AI Rank Lab vous montre quels robots IA visitent réellement vos pages et quels assistants IA vous envoient du trafic référent, sans analyse manuelle des logs. Si un crawler que vous pensiez autoriser ne se montre jamais, vérifiez ses règles dans votre robots.txt.
Des modèles de robots.txt pour chaque situation
Utilisez notre générateur de robots.txt gratuit pour adapter ces modèles à votre site. Voici les configurations les plus courantes :
Modèle 1 : accès IA complet (recommandé pour la plupart des sites)
Autorisez tous les crawlers IA à accéder à vos contenus. C'est le bon choix pour les sites qui visent une visibilité maximale dans la recherche IA et qui acceptent que leurs contenus servent à entraîner les modèles.
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Modèle 2 : accès IA sélectif (protection des contenus)
Autorisez les crawlers IA sur vos pages publiques, mais bloquez les contenus premium, les articles payants et les espaces membres. Idéal pour les éditeurs sur abonnement et les sites aux contenus réservés.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Modèle 3 : bloquer l'entraînement, autoriser la recherche IA
Une configuration plus nuancée : autoriser Perplexity (qui utilise vos contenus pour des citations en temps réel) mais bloquer les crawlers d'entraînement (qui s'en servent pour entraîner des modèles). C'est un compromis fréquent chez les éditeurs qui veulent être cités par la recherche IA sans que leurs contenus servent à l'entraînement.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml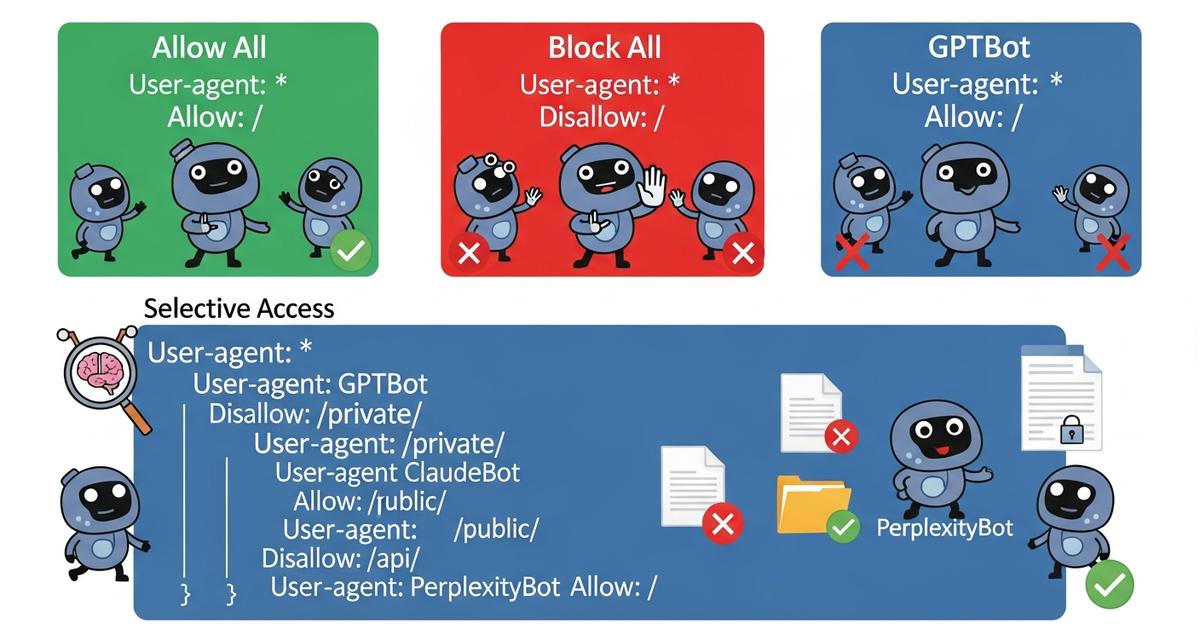
Quelle configuration choisir pour votre site ?
La bonne configuration du robots.txt dépend de votre type de contenu, de votre modèle économique et de vos objectifs de visibilité dans la recherche IA. Voici une grille de décision :
Autorisez tous les crawlers IA si :
- votre site publie des contenus en libre accès (blog, documentation, ressources) ;
- vous visez une visibilité maximale dans la recherche IA et les citations vous apportent du trafic ;
- vous n'avez pas de contenus réservés ou premium à protéger ;
- vos contenus sont informatifs et gagnent à être largement diffusés.
Optez pour un accès sélectif si :
- vous mélangez contenus gratuits et premium ;
- certaines pages ne doivent pas être citées (pages de compte, tunnels de paiement, contenus réservés aux membres) ;
- vous voulez que les crawlers IA se concentrent sur vos meilleurs contenus plutôt que de tout explorer.
Bloquez les crawlers d'entraînement (et autorisez seulement la recherche) si :
- vous êtes un éditeur préoccupé par l'utilisation de vos contenus pour l'entraînement de l'IA ;
- vous voulez quand même apparaître dans Perplexity et les AI Overviews de Google (citations en temps réel) ;
- vous souhaitez garder la possibilité de concéder séparément des licences sur vos contenus aux entreprises d'IA.
Ne bloquez tous les crawlers IA que si :
- vous avez des raisons juridiques ou concurrentielles explicites de tenir vos contenus à l'écart des systèmes d'IA ;
- vous avez un accord de licence avec certaines entreprises d'IA et voulez en faire respecter l'exclusivité ;
- vous acceptez le prix à payer : zéro visibilité dans la recherche IA pour votre domaine.
Les erreurs classiques à éviter
Erreur n° 1 : bloquer tous les robots inconnus avec un wildcard
Une configuration du type User-agent: * / Disallow: / suivie de règles d'autorisation spécifiques pour Googlebot bloquera tous les crawlers IA, puisqu'ils n'ont pas de règle d'autorisation explicite. Soyez toujours explicite sur l'accès des crawlers IA.
Erreur n° 2 : ignorer ce que dit votre configuration actuelle
Beaucoup d'équipes ne savent pas ce que leur robots.txt dit aujourd'hui des crawlers IA. Vérifiez-le dès maintenant à l'adresse yoursite.com/robots.txt. Les outils d'AI Rank Lab peuvent aussi vous aider : l'audit de site gratuit vérifie que votre robots.txt est présent et accessible.
Erreur n° 3 : confondre Googlebot et Google-Extended
Autoriser Googlebot n'autorise pas automatiquement Google-Extended (le crawler des fonctionnalités IA). Si vous voulez apparaître dans les AI Overviews et AI Mode de Google, il vous faut une règle explicite qui autorise Google-Extended.
Erreur n° 4 : ne pas tester après modification
Après avoir mis à jour votre robots.txt, vérifiez que les changements sont bien pris en compte en consultant le fichier en ligne et en passant par un outil de test robots.txt. Google Search Console intègre un testeur de robots.txt pour Googlebot, mais vous devrez vérifier manuellement les règles des crawlers IA.
Erreur n° 5 : configurer une fois pour toutes et ne plus y penser
De nouveaux crawlers IA apparaissent régulièrement. La liste des user agents IA de 2023 est déjà incomplète en 2026. Relisez votre robots.txt au moins une fois par trimestre et surveillez la documentation des grandes entreprises d'IA sur leurs nouveaux crawlers.
Au-delà du robots.txt : la panoplie complète pour contrôler les crawlers IA
Le robots.txt est le levier le plus important pour contrôler l'accès des crawlers IA, mais ce n'est pas le seul. Une configuration technique AEO complète comprend :
- robots.txt : les règles d'accès des robots (voir ci-dessus)
- llms.txt : un fichier qui explique aux LLM ce que couvre votre site et comment vos contenus doivent être utilisés – un complément au robots.txt, pas un remplaçant
- Balises meta noindex : un contrôle page par page qui empêche l'indexation de pages précises, respecté par certains crawlers IA
- Suivi des bots IA : savoir quels crawlers accèdent à votre site et à quelle fréquence – la fonctionnalité de suivi des bots d'AI Rank Lab vous donne cette visibilité sans analyse de logs
Utilisez le générateur de robots.txt gratuit
Plutôt que d'écrire votre robots.txt de zéro, utilisez le générateur de robots.txt gratuit d'AI Rank Lab. Choisissez votre type de configuration (accès complet, sélectif, blocage de l'entraînement ou personnalisé), indiquez les chemins à protéger, et l'outil génère un fichier correctement formaté qui inclut tous les user agents IA actuels. Vous pouvez copier le résultat directement sur votre serveur ou le télécharger sous forme de fichier.
Le générateur est mis à jour à mesure que de nouveaux user agents IA apparaissent : vous obtenez ainsi une configuration qui tient compte de robots qui n'existaient pas encore au moment où cet article a été écrit.
Conclusion
Votre robots.txt est un véritable tableau de bord de votre visibilité dans la recherche IA. Bien configuré, il permet aux crawlers IA d'accéder à vos contenus et d'en tirer des connaissances, ce qui se traduit par des citations dans les réponses de ChatGPT, Perplexity, Claude et Gemini. Mal configuré – ou laissé en l'état alors qu'il est obsolète –, il dresse des barrières invisibles entre vos contenus et les moteurs d'IA qui pèsent de plus en plus dans la découverte en ligne.
Prendre cinq minutes pour vérifier votre robots.txt actuel et utiliser le générateur gratuit pour créer une configuration prête pour l'IA, c'est l'une des actions techniques les plus rentables qui soient pour votre visibilité dans la recherche IA. Faites-le aujourd'hui, puis programmez un rappel pour le relire chaque trimestre, à mesure que de nouveaux crawlers IA entrent dans la danse.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


