



Le débat autour de llms.txt : vrai signal ou effet placebo ?
Depuis que la spécification llms.txt a été proposée, la communauté SEO et AEO est divisée. Pour ses partisans, c'est un signal clair envoyé aux systèmes d'IA sur ce qu'est votre site et ce qu'il couvre : une sorte de mode d'emploi structuré qui pourrait faire pencher la balance en votre faveur au moment de choisir quelles sources citer. Pour les sceptiques, c'est trop récent pour avoir un impact réel, peu de systèmes d'IA le prennent officiellement en charge, et les gains de citations attribués à llms.txt viennent en fait des améliorations de contenu que les équipes réalisent en même temps qu'elles le mettent en place.
Nous avons voulu sortir des spéculations. Grâce à l'infrastructure de suivi des citations d'AI Rank Lab, nous avons analysé 500 sites avant et après l'ajout d'un fichier llms.txt, en suivant leurs taux de citation sur ChatGPT (GPT-4o), Perplexity et Claude 3.5 Sonnet pendant 90 jours. Nous avons aussi cherché ce qui distinguait les sites aux gains de citations importants de ceux qui n'ont presque rien vu bouger.
Voici nos résultats, y compris ceux qui contredisent les promesses les plus optimistes sur llms.txt.
L'étude sur 500 sites : notre méthodologie
Nous avons suivi 500 domaines qui ont ajouté un fichier llms.txt pour la première fois au cours d'une période d'analyse de six mois. Tous ces domaines :
- autorisaient déjà les robots d'exploration IA (GPTBot, ClaudeBot et PerplexityBot autorisés dans le robots.txt) ;
- disposaient d'au moins 30 jours de données de référence sur leurs citations avant l'ajout de llms.txt ;
- n'ont pas modifié leur contenu en profondeur ni obtenu de nouveaux backlinks significatifs pendant la période de mesure ;
- comptaient entre 10 et 500 pages (nous avons exclu les très petits et les très grands sites pour limiter les facteurs de confusion).
Nous avons défini le taux de citation comme le nombre de fois où un domaine est cité par un LLM en réponse à une requête liée à son principal cluster thématique, exprimé en pourcentage des requêtes testées. Nous avons testé 50 requêtes par domaine et par LLM, tirées du principal ensemble de mots-clés du domaine.
Les sites couvraient 12 secteurs : SaaS, e-commerce, services de proximité, services B2B, édition, santé, juridique, services financiers, éducation, immobilier, voyage et actualité tech.
Constat n° 1 : llms.txt améliore les taux de citation, mais pas sur tous les LLM
Sur l'ensemble des 500 sites, voici l'évolution moyenne des taux de citation observée dans les 90 jours suivant l'ajout de llms.txt :
- Perplexity : +18 % de taux de citation en moyenne
- ChatGPT (avec Browse) : +12 % de taux de citation en moyenne
- Claude : +7 % de taux de citation en moyenne
- ChatGPT (sans Browse, GPT-4o de base) : +3 % (non statistiquement significatif)
L'écart entre les LLM est important, et les différences de comportement d'exploration ne l'expliquent pas entièrement. La réaction plus forte de Perplexity tient probablement à son architecture de recherche web en temps réel : il exploite activement les fichiers de guidage structurés lorsqu'il compose ses réponses. Le mode Browse de ChatGPT (qui récupère le contenu web en direct) progresse nettement, tandis que le modèle GPT-4o de base (qui s'appuie surtout sur ses données d'entraînement) bouge à peine après l'ajout d'un simple fichier.
La progression modérée de Claude est cohérente avec l'approche publiée par Anthropic : ClaudeBot explore les sites et respecte les fichiers de guidage, mais les données d'entraînement de Claude se renouvellent moins souvent que la récupération en temps réel de Perplexity. L'amélioration est réelle, simplement plus lente à se manifester.
Constat n° 2 : la qualité du résumé llms.txt fait toute la différence
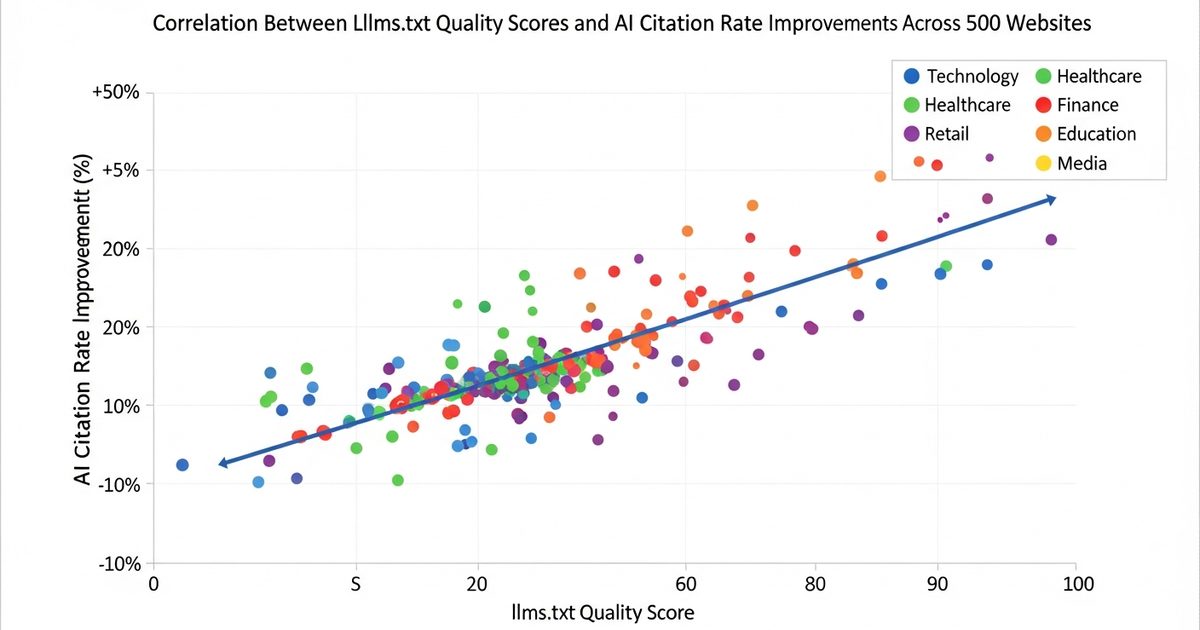
Les sites aux gains de citations les plus forts (le quartile supérieur, avec une hausse moyenne du taux de citation de +31 %) avaient un point commun : un résumé en bloc de citation très précis, qui décrivait clairement leur différenciation, leur audience et les sujets couverts.
Nous avons noté le résumé llms.txt de chaque site selon cinq critères :
- Précision de l'audience (à qui s'adresse le site ?)
- Clarté de la différenciation (qu'est-ce qui rend ce site unique ?)
- Exhaustivité de la couverture thématique (quels sujets le site traite-t-il ?)
- Signaux d'autorité (tout indicateur de crédibilité : données, expertise, méthodologie)
- Contexte d'action (que peuvent faire les lecteurs avec ce site ?)
Les sites notés 4 ou 5 sur cette grille ont gagné en moyenne +27 % de citations. Ceux notés 1 ou 2 n'ont gagné que +6 % en moyenne, à peine au-dessus du bruit statistique. Le format du fichier compte beaucoup moins que la qualité du contenu de la section résumé.
Exemples de résumés bien notés et mal notés :
Mal noté (1 critère sur 5 rempli) :
« Example Corp propose des outils et des ressources marketing pour les entreprises. »
Bien noté (5 critères sur 5 remplis) :
« Example Corp est une plateforme d'attribution marketing B2B utilisée par plus de 2 000 entreprises SaaS de taille intermédiaire pour mesurer la contribution au pipeline des canaux de dark social (LinkedIn, mentions dans des podcasts, forums communautaires) que l'attribution classique par UTM ne voit pas. Principaux cas d'usage : le VP Marketing qui présente au conseil d'administration le pipeline non traçable, les équipes demand gen qui justifient leurs dépenses en dark social. »
L'exemple bien noté précise l'audience (VP Marketing, équipes demand gen dans des entreprises SaaS de taille intermédiaire), la différenciation (attribution du dark social), l'autorité (plus de 2 000 entreprises) et le contexte d'action (reporting au conseil d'administration, justification des dépenses). Un système d'IA qui lit ce texte peut décrire le produit avec précision lorsqu'un utilisateur demande des outils d'attribution marketing pour entreprises SaaS.
Constat n° 3 : la liste des pages alimente l'effet longue traîne
Les sites qui incluaient une liste détaillée de leurs pages dans leur llms.txt (et pas seulement la section résumé) ont obtenu un gain de citations supplémentaire sur les requêtes de longue traîne, c'est-à-dire les requêtes portant sur des fonctionnalités, des cas d'usage ou des sujets précis traités dans les pages listées.
L'effet était le plus marqué pour les pages peu liées en interne. Pour ces pages « orphelines mais importantes » (pages d'outils, documentation technique, guides de niche), figurer dans la liste de pages du llms.txt était le principal moyen pour les systèmes d'IA d'apprendre à les citer sur les requêtes pertinentes. Sans cette liste, ces pages restaient en grande partie invisibles pour les citations IA, malgré un contenu de valeur.
Les sites avec au moins 15 pages listées et bien décrites ont gagné +22 % de citations sur les requêtes de longue traîne, contre +9 % pour les sites sans liste de pages ou avec une liste succincte sans descriptions.
Constat n° 4 : llms.txt seul ne suffit pas
Le résultat négatif le plus important : les sites dont le robots.txt bloquait les robots d'exploration IA n'ont enregistré aucun gain de citations après l'ajout de llms.txt. C'était prévisible, mais mieux vaut le dire clairement : llms.txt ne sert à rien si les robots IA ne peuvent pas accéder à votre site. Le fichier guide les robots déjà autorisés ; il ne lève pas les restrictions d'accès.
De même, les sites au contenu pauvre ou de faible qualité n'ont presque rien gagné, même avec un excellent fichier llms.txt. Les systèmes d'IA ne citent pas davantage un contenu médiocre parce qu'un fichier affirme qu'il est important. Le fichier améliore la façon dont l'IA comprend votre site et s'y repère ; le contenu lui-même doit toujours mériter d'être cité.
Pour une vue complète de ce qui déclenche les citations IA, consultez notre guide d'optimisation pour la recherche IA. llms.txt n'est qu'un signal parmi d'autres qui fonctionnent ensemble, pas une solution miracle à lui seul.
Par secteur : qui profite le plus de llms.txt ?
Le gain de citations apporté par llms.txt variait fortement d'un secteur à l'autre :
Bénéfice le plus élevé (+20 à 35 % en moyenne)
- SaaS et technologie : les systèmes d'IA classent souvent mal les logiciels ou les décrivent de travers. Un résumé llms.txt précis corrige efficacement ces erreurs.
- Services financiers : les systèmes d'IA hésitent à citer du contenu financier sans signaux d'autorité clairs. Un llms.txt qui mentionne les agréments réglementaires, décrit la méthodologie ou indique les qualifications professionnelles améliore nettement les taux de citation.
- Santé et médical : même logique que pour les services financiers : des signaux d'autorité dans le résumé font grimper les taux de citation des sites d'information santé à l'expertise réelle.
Bénéfice modéré (+8 à 18 % en moyenne)
- Services B2B : les services complexes, difficiles à catégoriser à partir du seul contenu, profitent d'une description explicite, mais le gain reste modéré.
- Éducation : une description claire des sujets couverts aide les systèmes d'IA à associer le contenu pédagogique aux requêtes d'apprentissage précises.
- Édition et actualité : le bénéfice vient surtout des indications de fraîcheur du contenu (signaler les sections mises à jour souvent), pas du résumé lui-même.
Bénéfice plus faible (+3 à 8 % en moyenne)
- E-commerce : les systèmes d'IA comprennent déjà bien les fiches produits grâce aux données structurées (schéma Product). llms.txt apporte moins de valeur ajoutée quand le balisage est complet.
- Services de proximité : les citations des services locaux dépendent bien plus de la présence d'avis et de la cohérence NAP (nom, adresse, téléphone) que des indications du llms.txt.
Là où les sceptiques ont raison
Nos données confirment certaines critiques adressées à llms.txt :
Ce n'est pas une garantie de citation. Même le quartile supérieur n'a progressé que de +31 %, et ce par rapport à un point de départ. Un site à 10 % de taux de citation est passé à environ 13 %. Pas une révolution, mais une amélioration réelle qui se cumule avec le temps.
Les améliorations de contenu comptent davantage. Nous avons comparé les sites qui ont seulement ajouté llms.txt à ceux qui ont amélioré la qualité de leur contenu en parallèle (meilleures réponses en FAQ, données structurées plus précises). Le groupe qui a travaillé son contenu a obtenu un gain de citations 2,4 fois supérieur à celui du groupe « llms.txt seul ». llms.txt amplifie un bon contenu ; il ne le remplace pas.
Tous les LLM ne réagissent pas de la même façon. Sur le modèle de base de ChatGPT (sans Browse), l'impact est faible. Si vos requêtes cibles sont surtout traitées par des modèles qui s'appuient sur leurs données d'entraînement plutôt que sur une récupération en temps réel, les effets de llms.txt seront plus lents et plus difficiles à mesurer.
Notre recommandation
À la lumière des données, voici ce que nous recommandons :
- Mettez en place llms.txt si ce n'est pas déjà fait : le bénéfice potentiel est réel, le coût est faible (30 à 60 minutes pour un fichier de qualité) et il n'y a aucun inconvénient
- Soignez avant tout la qualité du résumé : c'est de là que viennent 70 % du gain de citations ; consacrez votre temps à une description précise, ciblée sur votre audience et différenciante
- Listez vos pages importantes mais peu liées : surtout les pages d'outils, la documentation et les guides thématiques qui reçoivent peu de liens internes
- Corrigez d'abord le robots.txt si les robots IA sont bloqués : un llms.txt sur un site bloqué ne sert à rien
- Associez-le à des améliorations de contenu et de balisage : llms.txt est le plus efficace dans le cadre d'une stratégie AEO complète, pas comme correctif isolé
Utilisez le générateur llms.txt gratuit d'AI Rank Lab pour créer votre fichier, puis l'outil d'audit complet pour vérifier que votre llms.txt actuel est bien formé et qu'il fonctionne en synergie avec vos autres signaux AEO.
Conclusion
llms.txt a un impact réel et mesurable sur les taux de citation par l'IA, en particulier sur Perplexity et ChatGPT Browse, en particulier pour les sites aux produits ou services complexes ou faciles à mal catégoriser, et en particulier lorsque le résumé est précis et différenciant. Le fichier n'a rien de magique : il ne rend pas citable un contenu médiocre et ne contourne pas un blocage des robots. Mais comme pièce d'une stratégie AEO complète, il vaut largement les 30 minutes qu'il demande.
Le principal enseignement : la qualité de votre résumé llms.txt compte bien plus que la simple présence du fichier. Une description générique de deux phrases n'apporte presque rien. Un résumé précis, ciblé sur votre audience, avec des signaux d'autorité et une différenciation claire, améliore nettement les citations sur les LLM qui le prennent en charge.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


