



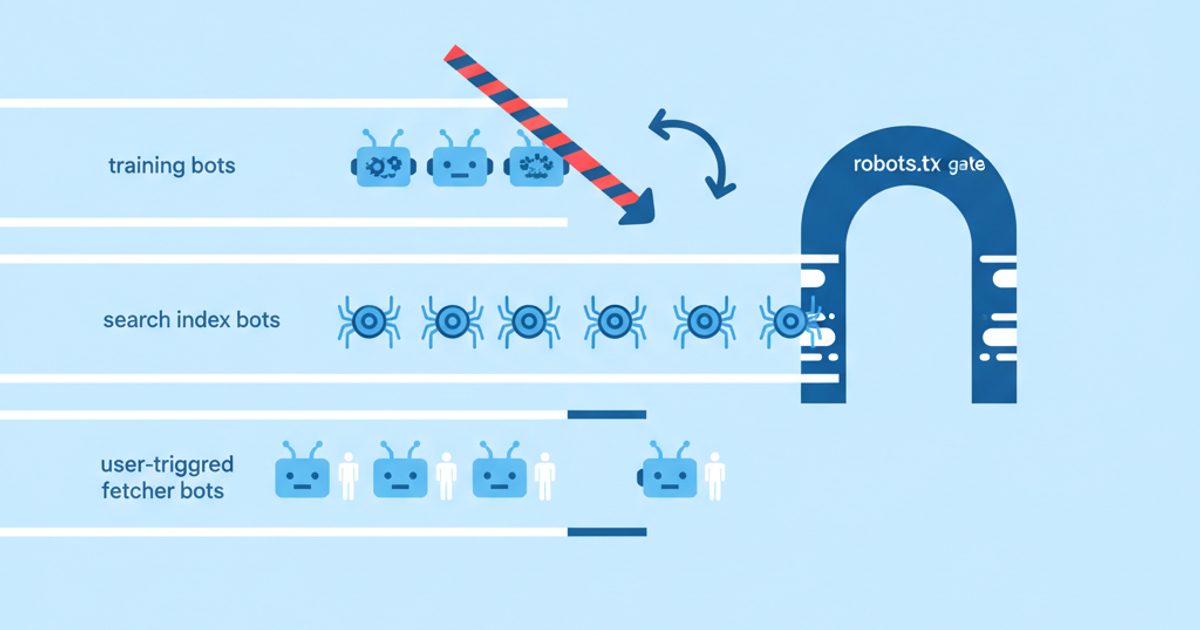
AI क्रॉलर वे ऑटोमेटेड बॉट हैं जिन्हें AI कंपनियाँ चलाती हैं, और ये वेब पेज तीन में से किसी एक काम के लिए उठाते हैं: मॉडल की ट्रेनिंग के लिए डेटा इकट्ठा करना (GPTBot, ClaudeBot), वह सर्च इंडेक्स बनाना जिसे AI जवाब साइट करते हैं (OAI-SearchBot, Claude-SearchBot, PerplexityBot), या किसी पेज को उसी पल खोलना क्योंकि किसी यूज़र ने असिस्टेंट से उसके बारे में पूछा है (ChatGPT-User, Claude-User, Perplexity-User)। ट्रेनिंग क्रॉलर को ब्लॉक करने से आपका कंटेंट आने वाले मॉडलों से बाहर रहता है; लेकिन सर्च क्रॉलर या यूज़र फ़ेचर को ब्लॉक किया, तो आप AI जवाबों और साइटेशन से ही गायब हो जाते हैं। पूरा फ़ैसला बस इसी फ़र्क पर टिका है।
यह पेज एक ऐसा रेफ़रेंस है जिस पर आप सीधे अमल कर सकते हैं। नीचे दिया हर यूज़र एजेंट 18 अक्टूबर 2026 को ऑपरेटर के अपने डॉक्यूमेंटेशन से मिलाकर जाँचा गया है, और साथ में उस पेज का लिंक भी है। इसके अलावा आपको बिज़नेस लक्ष्य के हिसाब से एक डिसीज़न मैट्रिक्स, कॉपी करके इस्तेमाल करने लायक robots.txt ग्रुप, हर ऑपरेटर का वेरिफ़िकेशन तरीका (हर पब्लिश्ड IP लिस्ट के अंदर लिखी तारीख के साथ), और इसकी ईमानदार पड़ताल मिलेगी कि JavaScript एनालिटिक्स आपको ज़्यादातर क्रॉलर ट्रैफ़िक क्यों नहीं दिखा सकता।
मुख्य बातें
- हर AI बॉट को ट्रेनिंग, सर्च/इंडेक्स या यूज़र-ट्रिगर्ड कैटेगरी में बाँटें। OpenAI, Anthropic, Amazon, Meta और Mistral हर कैटेगरी के लिए अलग टोकन पब्लिश करते हैं, इसलिए आप एक को ब्लॉक करके बाकी को चालू रख सकते हैं।
- GPTBot को ब्लॉक करने से आप ChatGPT सर्च से नहीं हटते। OpenAI के मुताबिक इसे सिर्फ़ OAI-SearchBot कंट्रोल करता है, और जिन साइटों ने OAI-SearchBot से ऑप्ट-आउट किया है, वे भी नेविगेशनल लिंक के रूप में दिख सकती हैं।
- Google-Extended और Applebot-Extended कंट्रोल टोकन हैं, क्रॉलर नहीं। ये आपके लॉग में कभी नहीं दिखते, और Google कहता है कि Google-Extended का Google Search पर कोई असर नहीं पड़ता, जिसमें AI Overviews और AI Mode भी शामिल हैं।
- यूज़र-ट्रिगर्ड फ़ेचर जान-बूझकर robots.txt को नज़रअंदाज़ कर सकते हैं: OpenAI, Perplexity, Google, Meta और Amazon सभी अपने डॉक्यूमेंटेशन में यह बात कहते हैं। पक्का ब्लॉक चाहिए, तो WAF इस्तेमाल करें।
- ज़्यादातर AI क्रॉलर JavaScript नहीं चलाते, इसलिए JS एनालिटिक्स टैग उन्हें कम गिनेगा। क्रॉलर एक्टिविटी का असली हिसाब सर्वर या CDN लॉग में ही मिलता है।
- बॉट्स को रिवर्स DNS (Google, Apple, Common Crawl) से या IP को ऑपरेटर की पब्लिश्ड JSON लिस्ट से मिलाकर वेरिफ़ाई करें। इनमें से कुछ लिस्ट सालों पुरानी हैं, इसलिए उन्हें तय अंतराल पर दोबारा डाउनलोड करते रहें।
AI क्रॉलर क्या होते हैं, और इनकी तीन कैटेगरी कौन-सी हैं?
AI क्रॉलर ऐसा कोई भी ऑटोमेटेड क्लाइंट है जिससे कोई AI कंपनी आपके पेज माँगती है। अब ऑपरेटर अपने बॉट्स को मकसद के हिसाब से अलग-अलग रखते हैं, और यही मकसद तय करता है कि ब्लॉक करने की आपको क्या कीमत चुकानी पड़ेगी। Cloudflare का नेटवर्क डेटा बताता है कि यह मिक्स कितना एकतरफ़ा है: 2025 के मध्य तक के 12 महीनों में 80% AI क्रॉलिंग ट्रेनिंग के लिए थी, 18% सर्च के लिए और 2% यूज़र एक्शन के लिए, और उस अवधि के आख़िरी छह महीनों में ट्रेनिंग का हिस्सा बढ़कर 82% हो गया।
ट्रेनिंग क्रॉलर
ट्रेनिंग क्रॉलर ऐसा कंटेंट इकट्ठा करते हैं जिसका इस्तेमाल फ़ाउंडेशन मॉडल को ट्रेन या फ़ाइन-ट्यून करने में हो सकता है। GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training और CCBot (Common Crawl का ओपन डेटासेट, जिसे कई मॉडल बनाने वाले इस्तेमाल करते हैं) इसी कैटेगरी में आते हैं। इन्हें ब्लॉक करना यह संकेत देता है कि आपका आगे का कंटेंट ट्रेनिंग सेट से बाहर रहना चाहिए। इससे पहले से इकट्ठा किया गया कंटेंट नहीं हटता, और इसका इस पर भी कोई असर नहीं पड़ता कि AI सर्च आपको साइट कर सकता है या नहीं।
सर्च और इंडेक्स क्रॉलर
सर्च क्रॉलर वह रिट्रीवल इंडेक्स बनाते हैं जिस पर AI जवाब आधारित होते हैं और जिसकी ओर साइटेशन लिंक करते हैं। OAI-SearchBot (ChatGPT सर्च), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index और DuckAssistBot खास तौर पर AI के लिए बने हैं। Googlebot, Bingbot और Applebot पारंपरिक सर्च क्रॉलर हैं, जिनका इंडेक्स अब AI फ़ीचर्स को भी डेटा देता है: Google AI Overviews और AI Mode, Microsoft Copilot, और Siri के जवाब। सर्च क्रॉलर को ब्लॉक करना सबसे महँगी गलती है, क्योंकि इससे आप उन्हीं जवाबों से बाहर हो जाते हैं जिन्हें आपके खरीदार पढ़ते हैं। इनमें से किसी एक इंडेक्स का इस्तेमाल कैसे होता है, यह समझना हो तो देखें ChatGPT सर्च कैसे काम करता है।
यूज़र-ट्रिगर्ड फ़ेचर और एजेंट
यूज़र-ट्रिगर्ड फ़ेचर किसी एक URL पर तब जाते हैं जब कोई व्यक्ति असिस्टेंट से उसे पढ़ने, उसका सार बताने या उस पर कोई काम करने को कहता है। ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User और MistralAI-User इसी कैटेगरी में आते हैं, साथ ही ChatGPT के Cloud browser जैसे साइन किए हुए ब्राउज़र एजेंट भी। कई ऑपरेटर साफ़ कहते हैं कि इन पर robots.txt लागू न भी हो, क्योंकि रिक्वेस्ट किसी इंसान ने शुरू की है।
कंट्रोल टोकन, जो क्रॉलर नहीं हैं
हर लिस्ट में दो नाम ऐसे होते हैं जो खुद कभी कुछ फ़ेच नहीं करते। Google-Extended एक robots.txt प्रोडक्ट टोकन है जिसे Google अपने सामान्य यूज़र एजेंट से क्रॉल करते समय पढ़ता है; यह तय करता है कि कंटेंट का इस्तेमाल आने वाले Gemini मॉडलों की ट्रेनिंग में और Gemini Apps व Vertex AI में ग्राउंडिंग के लिए हो सकता है या नहीं। Applebot-Extended यही काम Apple के फ़ाउंडेशन मॉडलों के लिए करता है। ये दोनों स्ट्रिंग आपको अपने एक्सेस लॉग में नहीं मिलेंगी, इसलिए "मैंने Google-Extended ब्लॉक किया, फिर भी Google ट्रैफ़िक दिख रहा है" वाली स्थिति बिल्कुल सामान्य है।
AI क्रॉलर लिस्ट: हर बड़ा यूज़र एजेंट, 18 अक्टूबर 2026 को वेरिफ़ाइड
इस टेबल में वह टोकन है जो आप User-agent: लाइन में लिखते हैं, उसे कौन चलाता है, उसकी कैटेगरी, robots.txt के बारे में ऑपरेटर का अपना डॉक्यूमेंटेशन क्या कहता है, आप उसे कैसे वेरिफ़ाई कर सकते हैं, और वह आधिकारिक पेज जिसे हमने जाँचा। "डॉक के मुताबिक" का मतलब है कि robots.txt कॉलम में ऑपरेटर की बात अपने शब्दों में लिखी गई है; जहाँ डॉक्यूमेंटेशन चुप है, वहाँ हमने अंदाज़ा लगाने के बजाय यही लिखा है।
| टोकन | ऑपरेटर | कैटेगरी | यह क्या करता है | Robots.txt (डॉक के मुताबिक) | वेरिफ़ाई कैसे करें | आधिकारिक डॉक |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | ट्रेनिंग | ऐसा कंटेंट क्रॉल करता है जो OpenAI फ़ाउंडेशन मॉडलों की ट्रेनिंग में इस्तेमाल हो सकता है | हाँ | gptbot.json | OpenAI क्रॉलर |
| OAI-SearchBot | OpenAI | सर्च | ChatGPT सर्च जवाबों में साइटें दिखाता है; ट्रेनिंग के लिए नहीं | हाँ, बदलाव में लगभग 24 घंटे लगते हैं | searchbot.json | OpenAI क्रॉलर |
| ChatGPT-User | OpenAI | यूज़र-ट्रिगर्ड | ChatGPT और Custom GPTs में यूज़र एक्शन के लिए पेज खोलता है | लागू न भी हो | chatgpt-user.json | OpenAI क्रॉलर |
| OAI-AdsBot | OpenAI | विशेष | ChatGPT विज्ञापन के रूप में सबमिट किए गए लैंडिंग पेज जाँचता है; ट्रेनिंग के लिए नहीं | नहीं बताया गया; सिर्फ़ सबमिट किए गए विज्ञापन पेज पर जाता है | adsbot.json | OpenAI क्रॉलर |
| ClaudeBot | Anthropic | ट्रेनिंग | ऐसा कंटेंट इकट्ठा करता है जो Claude मॉडल की ट्रेनिंग में काम आ सकता है | हाँ; Crawl-delay सपोर्ट करता है | bots.json (साझा) | Anthropic हेल्प सेंटर |
| Claude-SearchBot | Anthropic | सर्च | Claude के सर्च नतीजे बेहतर करने के लिए कंटेंट इंडेक्स करता है | हाँ | bots.json (साझा) | Anthropic हेल्प सेंटर |
| Claude-User | Anthropic | यूज़र-ट्रिगर्ड | जब कोई Claude यूज़र सवाल पूछता है, तब पेज फ़ेच करता है | हाँ, बंद करने पर यूज़र के कहने पर होने वाली रिट्रीवल रुक जाती है | bots.json (साझा) | Anthropic हेल्प सेंटर |
| PerplexityBot | Perplexity | सर्च | Perplexity नतीजों में साइटें दिखाता और लिंक करता है; ट्रेनिंग के लिए नहीं | हाँ, 24 घंटे तक | perplexitybot.json | Perplexity क्रॉलर |
| Perplexity-User | Perplexity | यूज़र-ट्रिगर्ड | यूज़र के सवाल का जवाब देने के लिए पेज खोलता है | आम तौर पर नज़रअंदाज़ करता है | perplexity-user.json | Perplexity क्रॉलर |
| Googlebot | सर्च | Google Search, जिसमें AI Overviews और AI Mode भी शामिल हैं | हाँ, ऑटोमैटिक क्रॉल में हमेशा | रिवर्स DNS या common-crawlers.json | Google कॉमन क्रॉलर | |
| Google-Extended | कंट्रोल टोकन | Gemini ट्रेनिंग, और Gemini Apps व Vertex AI में ग्राउंडिंग | सिर्फ़ टोकन; अपना कोई यूज़र एजेंट नहीं | लागू नहीं | Google कॉमन क्रॉलर | |
| Google-CloudVertexBot | सर्च (साइट मालिक के अनुरोध पर) | उन साइटों को क्रॉल करता है जिन पर उनके मालिक Vertex AI Agents बनाते हैं | हाँ | रिवर्स DNS या common-crawlers.json | Google कॉमन क्रॉलर | |
| Google-Agent | यूज़र-ट्रिगर्ड एजेंट | Google इन्फ़्रास्ट्रक्चर पर चलने वाले एजेंट, जो यूज़र के कहने पर ब्राउज़ करते और काम करते हैं | आम तौर पर नज़रअंदाज़ करता है (यूज़र-ट्रिगर्ड) | user-triggered-agents.json; कुछ रिक्वेस्ट Web Bot Auth से साइन होती हैं | Google यूज़र-ट्रिगर्ड फ़ेचर | |
| Google-GeminiNotebook | यूज़र-ट्रिगर्ड | वे URL फ़ेच करता है जिन्हें यूज़र Gemini Notebook में सोर्स के रूप में जोड़ते हैं (पुराना एजेंट Google-NotebookLM, अगस्त 2026 तक सपोर्टेड) | आम तौर पर नज़रअंदाज़ करता है (यूज़र-ट्रिगर्ड) | यूज़र-ट्रिगर्ड फ़ेचर की JSON लिस्ट | Google यूज़र-ट्रिगर्ड फ़ेचर | |
| Bingbot | Microsoft | सर्च | Bing इंडेक्स, जो Copilot के जवाबों को भी ग्राउंड करता है | हाँ; AI इस्तेमाल पेज-लेवल noarchive/nocache से कंट्रोल होता है | bingbot.json या Bing का Verify Bingbot टूल | Bing Webmaster ब्लॉग |
| Applebot | Apple | सर्च (ट्रेनिंग भी संभव) | Spotlight, Siri और Safari सर्च; डेटा से Apple मॉडलों की ट्रेनिंग भी हो सकती है | हाँ; अगर Applebot का नाम नहीं है तो Googlebot के नियम मानता है; Crawl-delay नज़रअंदाज़ करता है | रिवर्स DNS (*.applebot.apple.com) या applebot.json | Applebot के बारे में |
| Applebot-Extended | Apple | कंट्रोल टोकन | कंटेंट को Apple फ़ाउंडेशन मॉडल की ट्रेनिंग से बाहर रखता है | सिर्फ़ टोकन | लागू नहीं | Applebot के बारे में |
| Meta-ExternalAgent | Meta | ट्रेनिंग | फ़ाउंडेशन AI मॉडल की ट्रेनिंग या कंटेंट को सीधे इंडेक्स करना | हाँ | यूज़र एजेंट और Meta के पब्लिश्ड IP | Meta वेब क्रॉलर |
| Meta-WebIndexer | Meta | सर्च | Meta AI के सर्च नतीजे बेहतर करता है, ताकि Meta AI आपको साइट और लिंक कर सके | हाँ | यूज़र एजेंट और Meta के पब्लिश्ड IP | Meta वेब क्रॉलर |
| Meta-ExternalFetcher | Meta | यूज़र-ट्रिगर्ड | यूज़र के कहने पर लिंक फ़ेच करता है, एजेंटिक कामों के लिए भी | बायपास कर सकता है | यूज़र एजेंट और Meta के पब्लिश्ड IP | Meta वेब क्रॉलर |
| Amazonbot | Amazon | ट्रेनिंग | Amazon प्रोडक्ट्स बेहतर करता है; Amazon AI मॉडल की ट्रेनिंग में इस्तेमाल हो सकता है | हाँ (RFC 9309); Crawl-delay नज़रअंदाज़ करता है | पब्लिश्ड IP पेज | Amazonbot |
| Amzn-SearchBot | Amazon | सर्च | Alexa जैसे सर्च अनुभव; ट्रेनिंग के लिए नहीं | हाँ; नाम न होने पर दूसरे सर्च बॉट्स के नियम अपना लेता है | पब्लिश्ड IP पेज | Amazonbot |
| Amzn-User | Amazon | यूज़र-ट्रिगर्ड | Alexa सवालों के लिए लाइव जानकारी फ़ेच करता है; ट्रेनिंग के लिए नहीं | हो सकता है सभी निर्देश न माने | पब्लिश्ड IP पेज | Amazonbot |
| MistralAI-Training | Mistral | ट्रेनिंग | Mistral मॉडलों की ट्रेनिंग के लिए डेटासेट बनाता है | हाँ, disallow किया जा सकता है | यूज़र एजेंट | Mistral क्रॉलर |
| MistralAI-Index | Mistral | सर्च | Vibe में Mistral सर्च के लिए कंटेंट इंडेक्स करता है; ट्रेनिंग के लिए नहीं | हाँ | mistralai-index-ips.json | Mistral क्रॉलर |
| MistralAI-User | Mistral | यूज़र-ट्रिगर्ड | जब Vibe यूज़र सवाल पूछते हैं, तब पेज खोलता है | हाँ, तय करता है कि यूज़र रिक्वेस्ट किन साइटों तक पहुँच सकती हैं | mistralai-user-ips.json | Mistral क्रॉलर |
| DuckAssistBot | DuckDuckGo | सर्च (रियल-टाइम) | DuckDuckGo के AI-असिस्टेड जवाबों के लिए पेज क्रॉल करता है; ट्रेनिंग के लिए नहीं | हाँ, 72 घंटे बाद लागू होता है | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | ट्रेनिंग (ओपन डेटासेट) | ओपन Common Crawl कॉर्पस बनाता है, जिसका मॉडल ट्रेनिंग में खूब इस्तेमाल होता है | हाँ | रिवर्स DNS (*.crawl.commoncrawl.org, सिर्फ़ IPv4) | CCBot |
यह टेबल दो बातें साफ़ कर देती है। पहली, Anthropic के मौजूदा पेज पर ठीक तीन बॉट हैं: ClaudeBot, Claude-SearchBot और Claude-User। पुरानी लिस्टों में अब भी "anthropic-ai" और "Claude-Web" दिखते हैं, जो अक्टूबर 2026 तक Anthropic के डॉक्यूमेंटेशन में कहीं नहीं हैं। दूसरी, OpenAI के वर्ज़न नंबर बदलते रहते हैं: जिस दिन हमने जाँचा, OpenAI की उदाहरण स्ट्रिंग में GPTBot/1.4 और OAI-SearchBot/1.4 थे, इसलिए हमेशा टोकन पर मैच करें, पूरी स्ट्रिंग पर कभी नहीं।
बिना आधिकारिक डॉक्यूमेंटेशन वाले बॉट
लॉग में दिखने वाले कुछ बॉट ऐसे हैं जिनका कोई ऑपरेटर पेज हमें 18 अक्टूबर 2026 को नहीं मिला। इनमें ByteDance का Bytespider सबसे जाना-माना है; xAI के Grok से जुड़े एजेंट भी इसी श्रेणी में हैं। थर्ड-पार्टी डायरेक्टरी इनके व्यवहार पर एकमत नहीं हैं, इसलिए हमने इन्हें वेरिफ़ाइड टेबल से बाहर रखा है। Cloudflare के मैनेज्ड robots.txt में Bytespider के लिए disallow ज़रूर है, और Cloudflare के मुताबिक 2024 के मध्य से 2025 के मध्य के बीच AI क्रॉलिंग में Bytespider का हिस्सा 14.1% से गिरकर 2.4% रह गया। अगर इनमें से कोई बॉट आपके लिए मायने रखता है, तो robots.txt के भरोसे रहने के बजाय WAF रूल से अपनी पॉलिसी लागू करें।
क्या AI क्रॉलर robots.txt मानते हैं?
डॉक्यूमेंटेड ट्रेनिंग और सर्च क्रॉलर कहते हैं कि वे मानते हैं; यूज़र-ट्रिगर्ड फ़ेचर अक्सर कहते हैं कि नहीं मानते; और robots.txt कभी भी एक्सेस कंट्रोल नहीं है। खुद इसका स्टैंडर्ड, RFC 9309, कहता है कि "ये नियम एक्सेस ऑथराइज़ेशन का कोई रूप नहीं हैं"। यह क्रॉलरों को आपकी फ़ाइल 24 घंटे तक कैश करने की छूट भी देता है, इसीलिए हर ऑपरेटर बताता है कि बदलाव लागू होने में कुछ समय लगेगा।
नियम मानने का दावा और असल व्यवहार, दोनों एक बात नहीं हैं। अगस्त 2025 में Cloudflare ने एक टेस्ट पब्लिश किया, जिसमें बिल्कुल नए डोमेन, जिन्होंने सब कुछ disallow कर रखा था, उनका भी Perplexity ने विस्तार से ब्योरा दे दिया। Cloudflare ने बताया कि उसने घोषित Perplexity-User एजेंट को रोज़ 20-25 मिलियन रिक्वेस्ट और एक अघोषित, Chrome जैसे दिखने वाले एजेंट को 3-6 मिलियन रिक्वेस्ट करते देखा, और फिर Perplexity को वेरिफ़ाइड बॉट की लिस्ट से हटा दिया। यह एक वेंडर की एक ऑपरेटर के बारे में खोज है, लेकिन इससे साफ़ है कि सिर्फ़ यूज़र एजेंट स्ट्रिंग कुछ भी साबित नहीं करती।
| ऑपरेटर | robots.txt बदलाव लागू होने में कितना समय (डॉक के मुताबिक) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | लगभग 24 घंटे | नहीं बताया गया |
| Perplexity | 24 घंटे तक | नहीं बताया गया |
| Amazon | लगभग 24 घंटे; 30 दिन तक पुरानी कैश कॉपी इस्तेमाल कर सकता है | सपोर्टेड नहीं |
| Meta | 24 घंटे तक | नहीं बताया गया |
| DuckDuckGo (DuckAssistBot) | 72 घंटे | नहीं बताया गया |
| Anthropic | नहीं बताया गया | सपोर्टेड |
| Apple | नहीं बताया गया | सपोर्टेड नहीं |
हर कैटेगरी के AI क्रॉलर को ब्लॉक करने की क्या कीमत चुकानी पड़ती है?
ट्रेनिंग क्रॉलर ब्लॉक करने से आज की विज़िबिलिटी पर ज़्यादा फ़र्क नहीं पड़ता; लेकिन सर्च क्रॉलर या यूज़र फ़ेचर ब्लॉक करते ही साइटेशन हाथ से निकल जाते हैं। नीचे की टेबल हर कैटेगरी के साथ वह कीमत दिखाती है जो खुद ऑपरेटर बताते हैं।
| अगर आप ब्लॉक करते हैं... | आप इससे बाहर रहते हैं | आप क्या खोते हैं | आप फिर भी यहाँ दिखते हैं |
|---|---|---|---|
| ट्रेनिंग क्रॉलर (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | उस ऑपरेटर के आने वाले ट्रेनिंग डेटासेट | शॉर्ट-टर्म विज़िबिलिटी पर मामूली असर; शायद यह कि आने वाले मॉडल बिना सर्च किए आपके ब्रांड को कितना "जानते" हैं | ChatGPT सर्च, Claude सर्च, Perplexity, Google Search और AI Overviews, बशर्ते उनके सर्च बॉट्स को अनुमति हो |
| AI सर्च क्रॉलर (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | उस इंजन का रिट्रीवल इंडेक्स | उस इंजन के जवाबों में साइटेशन और लिंक; OpenAI सिर्फ़ नेविगेशनल लिंक रखता है | पारंपरिक सर्च इंजन, जब तक आप उन्हें भी ब्लॉक न करें |
| यूज़र-ट्रिगर्ड फ़ेचर (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | यूज़र की माँग पर होने वाले लाइव फ़ेच, जहाँ ऑपरेटर इसे मानता हो | वे जवाब जब कोई यूज़र आपका URL पेस्ट करता है या उसके बारे में पूछता है; चेकआउट या बुकिंग जैसे एजेंट वाले काम | इंडेक्स पर आधारित जवाब, अगर सर्च बॉट को अनुमति है |
| Googlebot | पूरा Google Search | ऑर्गेनिक रैंकिंग, AI Overviews और AI Mode, सब एक साथ | Google पर कुछ भी नहीं; आप शायद ही कभी यह चाहेंगे |
इस लेन-देन का पैमाना भी मायने रखता है। Cloudflare ने मापा कि हर AI प्लेटफ़ॉर्म, बदले में भेजे गए हर एक विज़िटर पर कितने पेज क्रॉल करता है: जुलाई 2025 में Anthropic हर रेफ़र्ड विज़िटर पर लगभग 38,000 क्रॉल कर रहा था और Perplexity 194। यही अनुपात वह आर्थिक तर्क है जिसके दम पर पब्लिशर्स ट्रेनिंग क्रॉलर ब्लॉक करते हैं और सर्च क्रॉलर खुले रखते हैं।
किन AI क्रॉलर को अनुमति दें और किन्हें ब्लॉक करें? बिज़नेस लक्ष्य के हिसाब से डिसीज़न मैट्रिक्स
शुरुआत इस बात से करें कि आप बेचते क्या हैं। अगर AI असिस्टेंट की सिफ़ारिश से आपको ग्राहक मिल सकता है, तो हर सर्च क्रॉलर और यूज़र फ़ेचर को अनुमति दें, और ट्रेनिंग को एक अलग, छोटा फ़ैसला मानें।
| आपकी स्थिति | ट्रेनिंग क्रॉलर | सर्च क्रॉलर | यूज़र फ़ेचर और एजेंट | क्यों |
|---|---|---|---|---|
| B2B SaaS, एजेंसियाँ, लोकल सर्विसेज़ | अनुमति दें (या ब्लॉक करें, कीमत कम है) | अनुमति दें | अनुमति दें | खरीदार AI जवाबों में ही vendor की शॉर्टलिस्ट बनाते हैं; मॉडल की जानकारी में होना बिना पूछे होने वाले ज़िक्र में भी मदद करता है |
| ई-कॉमर्स | आपकी मर्ज़ी | अनुमति दें | अनुमति दें, और अपने WAF में साइन किए हुए एजेंट्स को allowlist करें | शॉपिंग वाले जवाब प्रोडक्ट पेज साइट करते हैं, और एजेंट्स को कार्ट व चेकआउट तक पहुँचना होता है |
| न्यूज़ और विज्ञापन पर चलने वाले पब्लिशर्स | ब्लॉक करें | अनुमति दें, या विज्ञापन वाले पेजों पर ब्लॉक करें | हर ऑपरेटर के हिसाब से तय करें | कंटेंट ही प्रोडक्ट है; साइटेशन फिर भी कुछ पाठकों को वापस भेजते हैं |
| डेवलपर डॉक्स और ओपन-सोर्स प्रोजेक्ट | अनुमति दें | अनुमति दें | अनुमति दें | डेवलपर असिस्टेंट से पूछते हैं कि आपका API कैसे इस्तेमाल करें; मॉडल की सही जानकारी से सपोर्ट का बोझ घटता है |
| पेवॉल या लाइसेंस वाला कंटेंट | ब्लॉक करें | सिर्फ़ इंडेक्स पेजों को अनुमति दें | लाइसेंसिंग की ज़रूरत हो तो WAF से ब्लॉक करें | टीज़र साइट होने लायक रखें, पूरा टेक्स्ट बाहर रखें |
| स्टेजिंग, इंट्रानेट, प्राइवेट ऐप | ब्लॉक करें | ब्लॉक करें | ब्लॉक करें | ऑथेंटिकेशन इस्तेमाल करें; robots.txt एक अनुरोध है, ताला नहीं |
| क्रॉल के दबाव में सर्वर | रेट-लिमिट या ब्लॉक करें | अनुमति दें, CDN पर रेट-लिमिट करें | अनुमति दें | साइटेशन गँवाने के बजाय लोड की समस्या एज पर ठीक करें |
robots.txt में AI ट्रेनिंग क्रॉलर ब्लॉक करके AI सर्च को अनुमति कैसे दें?
हर ट्रेनिंग टोकन को Disallow: / के साथ उसका अपना ग्रुप दें, और सर्च क्रॉलरों को अपने सामान्य नियमों के तहत रहने दें। क्रॉलर सिर्फ़ उसी सबसे खास ग्रुप को मानता है जिसमें उसका नाम हो, इसलिए ट्रेनिंग वाला ब्लॉक कभी सर्च बॉट्स पर लागू नहीं होता।
स्निपेट 1: ट्रेनिंग ब्लॉक करें, AI सर्च और यूज़र फ़ेचर चालू रखें
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 कई User-agent लाइनों को एक ही ग्रुप शेयर करने देता है, और मैचिंग केस-इनसेंसिटिव होती है। OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot और Bingbot अपने-आप * ग्रुप में आ जाते हैं और उन्हें अनुमति बनी रहती है।
स्निपेट 2: AI सर्च के लिए साफ़-साफ़ दरवाज़ा खोलें
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
सर्च बॉट्स का नाम साफ़ लिख देने से आप भविष्य में किसी और के लिखे किसी व्यापक नियम से बचे रहते हैं, जैसे कोई प्लगइन जो User-agent: * के साथ Disallow: / जोड़ दे। प्राइवेट पाथ उस ग्रुप के अंदर भी disallow रखें, क्योंकि नाम वाला ग्रुप उस बॉट के लिए * ग्रुप में जुड़ता नहीं, बल्कि उसकी जगह ले लेता है।
स्निपेट 3: तीन गड़बड़ियाँ जो असली फ़ाइलें बिगाड़ देती हैं
- Applebot, Googlebot के नियम अपना लेता है। Apple कहता है कि अगर आपकी फ़ाइल में Applebot का ज़िक्र नहीं है लेकिन Googlebot का है, तो Applebot, Googlebot वाले ग्रुप को फ़ॉलो करता है। यानी सिर्फ़ Googlebot के लिए लगाया गया ब्लॉक चुपचाप आपको Siri और Spotlight से हटा सकता है।
- Amzn-SearchBot नाम न होने पर दूसरे सर्च बॉट्स के नियम अपना लेता है, Amazon के मुताबिक। अलग नतीजा चाहिए तो इसका नाम लिखें।
- सबडोमेन को अपनी अलग फ़ाइल चाहिए। Anthropic और Amazon दोनों कहते हैं कि वे हर होस्ट का robots.txt अलग से पढ़ते हैं, इसलिए
docs.example.comके लिए उसकी अपनी कॉपी चाहिए।
ये ग्रुप आप AI Rank Lab के मुफ़्त robots.txt जनरेटर से बना और जाँच सकते हैं, और फ़ुल-एक्सेस व सेलेक्टिव-एक्सेस सेटअप की गहराई में जाने के लिए हमारे पिछले AI क्रॉलर के लिए robots.txt टेम्पलेट देखें।
कैसे वेरिफ़ाई करें कि AI क्रॉलर असली है, नकली नहीं?
सिर्फ़ यूज़र एजेंट पर कभी भरोसा न करें: हेडर में "GPTBot" कोई भी भेज सकता है, और Common Crawl अपने पेज पर ही चेतावनी देता है कि कुछ क्रॉलर खुद को झूठमूठ CCBot बताते हैं। ऑपरेटर तीन वेरिफ़िकेशन तरीके सपोर्ट करते हैं, और कौन-सा तरीका इस्तेमाल करें, यह ऑपरेटर पर निर्भर है।
- पहले रिवर्स DNS, फिर फ़ॉरवर्ड DNS। अपने लॉग वाले IP पर
hostचलाएँ, देखें कि होस्टनेम ऑपरेटर के डोमेन पर खत्म होता है, फिर उस होस्टनेम परhostचलाकर पक्का करें कि वही IP लौटता है। Google अपनी वेरिफ़िकेशन गाइड मेंgooglebot.com,google.comऔरgoogleusercontent.comके लिए यह तरीका बताता है; Apple*.applebot.apple.comइस्तेमाल करता है; Common Crawl*.crawl.commoncrawl.org(सिर्फ़ IPv4)। - IP को ऑपरेटर की पब्लिश्ड लिस्ट से मिलाएँ। OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral और Amazon अपनी IP रेंज पब्लिश करते हैं। OpenAI, Anthropic और Perplexity के लिए यही इकलौता तरीका है, क्योंकि वे कोई रिवर्स DNS पैटर्न डॉक्यूमेंट नहीं करते।
- क्रिप्टोग्राफ़िक सिग्नेचर जाँचें (Web Bot Auth)। OpenAI का ChatGPT Cloud browser अपनी रिक्वेस्ट साइन करता है, RFC 9421 के तहत,
"https://chatgpt.com"वालेSignature-Agentहेडर के साथ। Google भी कुछ Google-Agent रिक्वेस्ट के लिए इसी IETF ड्राफ़्ट को टेस्ट कर रहा है, जोhttps://agent.bot.googके रूप में साइन होती हैं, और उसका Web Bot Auth पेज कहता है कि IP जाँच को बैकअप के तौर पर रखें, क्योंकि हर रिक्वेस्ट साइन नहीं होती।
# पहले रिवर्स, फिर फ़ॉरवर्ड लुकअप (Google का उदाहरण)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# OpenAI के सर्च क्रॉलर के लिए IP-लिस्ट जाँच
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
पब्लिश्ड IP लिस्ट कितनी ताज़ा हैं?
हमने 18 अक्टूबर 2026 को AI क्रॉलर की हर पब्लिश्ड IP फ़ाइल डाउनलोड की और उसमें हर ऑपरेटर का लिखा creationTime फ़ील्ड पढ़ा। पुरानी तारीख का मतलब बस इतना भी हो सकता है कि रेंज नहीं बदलीं, लेकिन इससे पता चलता है कि हार्ड-कोड किए गए allowlist पर कितना भरोसा करें, और यह भी कि कौन-सी लिस्ट उस ट्रैफ़िक का हिसाब नहीं दे सकतीं जिसे ऑपरेटर ने कभी घोषित ही नहीं किया।
| पब्लिश्ड लिस्ट | फ़ाइल में creationTime | IPv4 / IPv6 प्रीफ़िक्स |
|---|---|---|
| Google कॉमन क्रॉलर (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Google यूज़र-ट्रिगर्ड एजेंट (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (तीनों बॉट, एक लिस्ट) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
इससे दो काम की सीख मिलती हैं। Google की और OpenAI की ChatGPT-User लिस्ट पिछले दो हफ़्तों में बदली हैं, इसलिए गर्मियों में कॉपी किया गया फ़ायरवॉल allowlist शायद अब तक गलत हो चुका है; इसके बजाय इन फ़ाइलों को रोज़ या हर हफ़्ते फ़ेच करें। और Anthropic कहता है कि उसके IP ब्लॉक करना "शायद ठीक से काम न करे या लगातार ऑप्ट-आउट की गारंटी न दे", क्योंकि इससे Anthropic आपका robots.txt ही नहीं पढ़ पाता, इसलिए ऑप्ट-आउट के लिए robots.txt इस्तेमाल करें और IP सिर्फ़ वेरिफ़ाई करने के लिए।
AI क्रॉलर एक्टिविटी कैसे देखें: सर्वर लॉग से या JavaScript टैग से?
क्रॉलर के लिए सर्वर या CDN लॉग इस्तेमाल करें, और AI असिस्टेंट से आने वाले इंसानी विज़िटर्स के लिए JavaScript एनालिटिक्स। JS टैग तभी चलता है जब कोई पेज का JavaScript एक्ज़ीक्यूट करे, और ज़्यादातर AI क्रॉलर ऐसा नहीं करते। Vercel ने अपने नेटवर्क के विश्लेषण में पाया कि कोई भी बड़ा AI क्रॉलर JavaScript रेंडर नहीं करता था; ChatGPT और Claude के क्रॉलरों ने JS फ़ाइलें फ़ेच तो कीं (उनकी रिक्वेस्ट का 11.50% और 23.84%), पर उन्हें चलाया नहीं। अपवाद थे Gemini, जो Googlebot की रेंडरिंग इस्तेमाल करता है, और Applebot। यह स्टडी दिसंबर 2024 की है, इसलिए अपनी साइट पर दोबारा टेस्ट करें, लेकिन हमें भी यही देखने को मिलता है।
Google Analytics इस फ़ासले को जान-बूझकर और बढ़ा देता है। GA4 जाने-पहचाने बॉट्स और स्पाइडर्स का ट्रैफ़िक अपने-आप बाहर कर देता है, और न आप इसे बंद कर सकते हैं, न यह देख सकते हैं कि कितना हटाया गया। AI रेफ़रल ट्रैफ़िक के लिए GA4 सही टूल है, जिसके बारे में हमने GA4 में AI रेफ़रल ट्रैफ़िक कैसे ट्रैक करें में लिखा है, लेकिन क्रॉलर गिनने के लिए यह गलत टूल है।
AI Rank Lab के अपने ट्रैकिंग डेटा में भी हमें यही पैटर्न दिखता है। हमारा JavaScript टैग ChatGPT, Gemini, Perplexity और Claude से क्लिक करके आने वाले लोगों को भरोसेमंद तरीके से रिकॉर्ड करता है, लेकिन क्रॉलर ट्रैफ़िक का उसे सिर्फ़ एक छोटा और गैर-प्रतिनिधि हिस्सा दिखता है, इसीलिए हम उससे क्रॉलर की गिनती पब्लिश नहीं करते।
पाँच मिनट वाली लॉग जाँच
- अपने होस्ट या CDN से एक दिन के रॉ एक्सेस लॉग डाउनलोड करें (Nginx और Apache दोनों डिफ़ॉल्ट combined फ़ॉर्मैट में यूज़र एजेंट लॉग करते हैं)।
- हर AI टोकन की रिक्वेस्ट गिनें:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - सबसे ऊपर वाले टोकन के स्टेटस कोड देखें। ढेर सारे 403 या 429 का आम तौर पर मतलब है कि कोई WAF या CDN रूल उस बॉट को ब्लॉक कर रहा है जिसे आपका robots.txt अनुमति देता है।
- किसी भी गिनती पर भरोसा करने से पहले ऊपर बताए तरीकों से कुछ IP का सैंपल वेरिफ़ाई करें।
- देखें कि सर्च बॉट्स कौन-से URL माँगते हैं। अगर OAI-SearchBot या Claude-SearchBot सिर्फ़ आपका होमपेज फ़ेच करते हैं, तो इंटरनल लिंकिंग और अपना साइटमैप जाँचें।
AI क्रॉलर एक्टिविटी दिखाने वाले टूल
डिस्क्लोज़र: AI Rank Lab हमारा अपना प्रोडक्ट है। यह हमारी साइट है, इसलिए हमने इसे सबसे पहले रखा है, और नीचे दिए हर टूल को हमने एक ही कसौटी पर परखा है।
- AI Rank Lab - AI बॉट ट्रैकिंग हर पेज के लिए AI असिस्टेंट रेफ़रल और वे AI बॉट विज़िट रिकॉर्ड करती है जो उसका टैग देख पाता है, और यह सब आपकी AI विज़िबिलिटी और साइटेशन ट्रैकिंग के साथ दिखता है। ऊपर बताई वजहों से, क्रॉलर की पूरी गिनती के लिए इसे लॉग के साथ इस्तेमाल करें।
- Cloudflare AI Crawl Control - अगर आपकी साइट Cloudflare से प्रॉक्सी होती है, तो यह क्रॉलर का सबसे पूरा व्यू है, क्योंकि यह एज पर हर रिक्वेस्ट देखता है, उन बॉट्स समेत जो कभी JavaScript नहीं चलाते। यह हर क्रॉलर का robots.txt कंप्लायंस भी दिखाता है।
- लॉग फ़ाइल एनालाइज़र, जैसे Screaming Frog का Log File Analyser या GoAccess - किसी भी होस्ट के रॉ लॉग पर काम करते हैं और एक बार के ऑडिट के लिए बढ़िया हैं।
- रॉ लॉग और ऊपर वाला grep - मुफ़्त, सटीक, और वह बेसलाइन जिससे हर दूसरे टूल के आँकड़े मिलने चाहिए।
तीन सबसे बड़े बॉट्स के इर्द-गिर्द बनी गहरी मॉनिटरिंग रूटीन के लिए हमारी GPTBot, ClaudeBot और PerplexityBot मॉनिटरिंग गाइड देखें।
Cloudflare और दूसरे CDN, AI बॉट्स को कैसे कंट्रोल करते हैं?
robots.txt जो सिर्फ़ अनुरोध कर सकता है, CDN उसे नेटवर्क एज पर लागू कर देते हैं। Cloudflare का AI Crawl Control, जो सभी प्लान पर उपलब्ध है, दिखाता है कि कौन-सी AI सेवाएँ आपकी साइट पर आ रही हैं, हर क्रॉलर को अनुमति देने या ब्लॉक करने देता है, robots.txt उल्लंघन ट्रैक करता है, और प्राइवेट बीटा में pay per crawl भी देता है।
Cloudflare की AI बॉट पॉलिसी अब वही तीन हिस्सों वाला बँटवारा इस्तेमाल करती है जो इस लेख में है। इसकी Block AI Bots सेटिंग्स में Search, Agent और Training के अलग-अलग प्रीसेट हैं, और हर एक में "सभी पेजों पर ब्लॉक", "विज्ञापन वाले पेजों पर ब्लॉक" या "अनुमति दें" का विकल्प है। डॉक्यूमेंटेशन के मुताबिक 15 सितंबर 2026 से नए डोमेन को अपडेटेड डिफ़ॉल्ट मिलते हैं: विज्ञापन दिखाने वाले पेजों पर Training और Agent बॉट ब्लॉक, Search को अनुमति, और सर्च व ट्रेनिंग दोनों करने वाले मिक्स्ड-पर्पज़ क्रॉलर किसी भी ट्रेनिंग ब्लॉक से ब्लॉक। अगर आपने उस तारीख के बाद कोई साइट Cloudflare पर डाली है और सोच रहे हैं कि आपके ब्लॉग पर ChatGPT-User या Claude-User को 403 क्यों मिल रहा है, तो सबसे पहले यही सेटिंग देखें।
Cloudflare आपके लिए robots.txt मैनेज भी कर सकता है। Bot Preference Sync चालू होने पर उसका मैनेज्ड robots.txt आपके मौजूदा नियमों से पहले Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot और meta-externalagent के लिए disallow ग्रुप जोड़ देता है, साथ में एक Content Signals लाइन (search=yes, ai-train=no) भी। Content Signals, Cloudflare की प्रस्तावित शब्दावली (search, ai-input, ai-train) है, जो बताती है कि फ़ेच होने के बाद कंटेंट का इस्तेमाल कैसे हो सकता है; कोई ऑपरेटर इन्हें मानेगा या नहीं, यह उसी पर निर्भर है।
दूसरे प्रोवाइडर भी यही तरीका सपोर्ट करते हैं। Perplexity के डॉक्यूमेंटेशन में उसकी IP लिस्ट के साथ Cloudflare और AWS WAF के लिए WAF गाइडेंस है, और OpenAI का हेल्प सेंटर बताता है कि उसके साइन किए हुए Cloud browser को Akamai (बॉट नाम "ChatGPT Agent") और Cloudflare (डिटेक्शन ID 129220581) में allowlist कैसे करें। आपका CDN कोई भी हो, क्रम वही रहता है: हर कैटेगरी के लिए फ़ैसला करें, उसे robots.txt में लिखें, जहाँ पक्का ब्लॉक चाहिए सिर्फ़ वहीं एज पर लागू करें, और CDN में कोई भी बदलाव करने के बाद अपने लॉग दोबारा जाँचें।
Google और Bing: दो खास मामले
क्या Google-Extended ब्लॉक करने से Google Search या AI Overviews पर असर पड़ता है?
नहीं। Google कहता है कि Google-Extended "Google Search में किसी साइट के शामिल होने पर असर नहीं डालता और न ही इसे रैंकिंग सिग्नल के रूप में इस्तेमाल किया जाता है"। उसका AI फ़ीचर्स डॉक्यूमेंटेशन साफ़ कहता है कि AI Overviews और AI Mode समेत Search का कंट्रोल Googlebot के robots.txt नियमों से होता है, और जो दिखता है उसे आप nosnippet, data-nosnippet, max-snippet या noindex से सीमित करते हैं। Google-Extended, Gemini मॉडल की ट्रेनिंग और Gemini Apps व Vertex AI में ग्राउंडिंग को कवर करता है, जो Search से अलग हैं।
Microsoft Copilot आपके कंटेंट का इस्तेमाल करे या नहीं, यह कैसे कंट्रोल करें?
Microsoft का कोई अलग AI क्रॉलर टोकन नहीं है; क्रॉलिंग Bingbot ही करता है, और AI इस्तेमाल आप पेज-लेवल robots मेटा टैग से कंट्रोल करते हैं। हमें मिली सबसे हालिया आधिकारिक गाइडेंस Bing टीम की 2023 की घोषणा है, जो तब लिखी गई थी जब Copilot का नाम अभी Bing Chat था: noarchive टैग वाला कंटेंट Bing के चैट जवाबों में शामिल या लिंक नहीं होता और Microsoft के फ़ाउंडेशन मॉडल की ट्रेनिंग में इस्तेमाल नहीं होता; nocache टैग वाला कंटेंट सिर्फ़ URL, टाइटल और स्निपेट के साथ दिख सकता है; और जिस कंटेंट पर दोनों में से कोई टैग नहीं है, उसका पूरा इस्तेमाल हो सकता है। दोनों टैग के साथ आप सामान्य Bing नतीजों में बने रहते हैं। robots.txt में Bingbot ब्लॉक करने से आप Bing सर्च से भी हट जाएँगे, इसलिए उसकी जगह मेटा टैग इस्तेमाल करें।
सीमाएँ, और हमने कैसे जाँचा
18 अक्टूबर 2026 को हमने ऊपर दिया हर ऑपरेटर का क्रॉलर पेज पढ़ा, हर पब्लिश्ड IP लिस्ट डाउनलोड की, और हर फ़ाइल के अंदर का creationTime दर्ज किया। Microsoft का क्रॉलर हेल्प पेज सिर्फ़ JavaScript से चलता है और हम उसे रेंडर नहीं कर पाए, इसलिए Bingbot वाली पंक्ति Microsoft के Bing Webmaster ब्लॉग, उसके Verify Bingbot टूल और उसकी पब्लिश्ड bingbot.json पर आधारित है। robots.txt कॉलम वही बताते हैं जो हर ऑपरेटर कहता है, वह नहीं जो हमने खुद मापा; Cloudflare की Perplexity वाली खोज इस बात का मुख्य सार्वजनिक सबूत है कि ये दोनों अलग हो सकते हैं। ऑपरेटर अक्सर बॉट्स के नाम बदलते और नए जोड़ते रहते हैं (उदाहरण के लिए, Google ने अपने Google-NotebookLM फ़ेचर टोकन की जगह Google-GeminiNotebook कर दिया है), इसलिए किसी भी लिस्ट को, इस लिस्ट को भी, सिर्फ़ उसकी जाँच की तारीख तक सही मानें।
अगर आप देखना चाहते हैं कि आपकी क्रॉलर पॉलिसी सच में साइटेशन दिला रही है या नहीं, तो AI Rank Lab ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews और AI Mode में आपके ज़िक्र और साइट किए गए पेजों को ट्रैक करता है, और साथ में वह AI रेफ़रल ट्रैफ़िक भी दिखाता है जो ये जवाब आपकी साइट पर भेजते हैं।
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


