



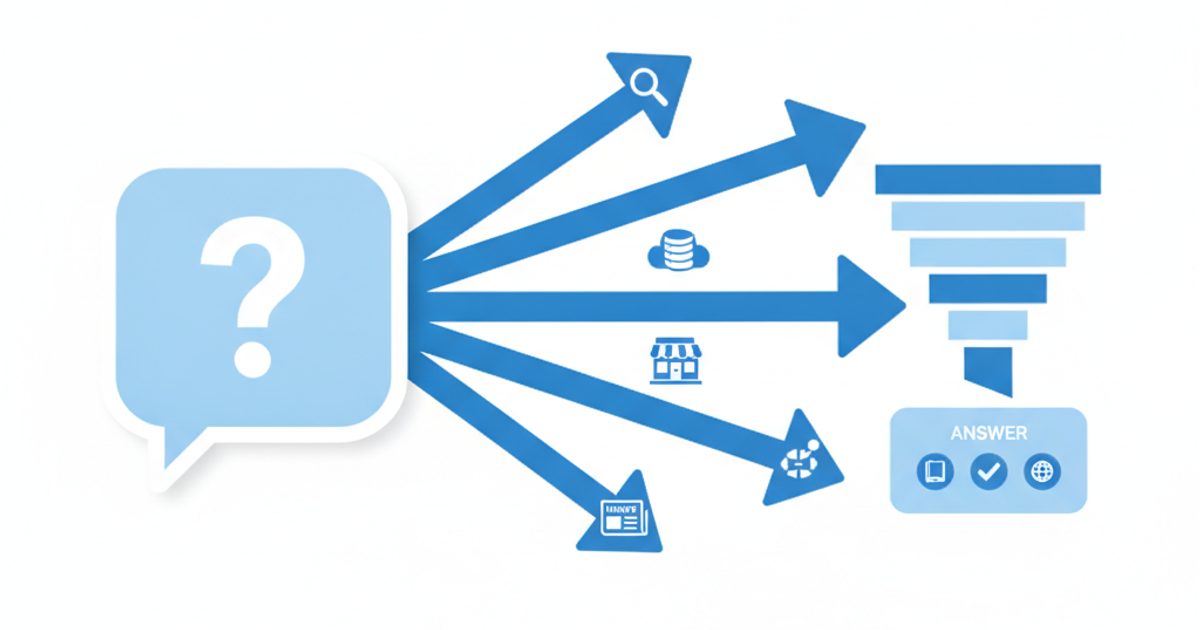
ChatGPT सर्च पाँच स्टेप में काम करता है: पहले यह तय करता है कि आपके सवाल को ताज़ा जानकारी चाहिए या नहीं, फिर सवाल को एक या ज़्यादा सर्च क्वेरी में दोबारा लिखता है, OpenAI के अपने इंडेक्स और कैश के साथ पार्टनर सर्च प्रोवाइडर्स से संभावित पेज निकालता है, जो मिला उसकी रैंकिंग करता है, और आख़िर में ऐसा जवाब लिखता है जिसमें इस्तेमाल किए गए पेजों के लिंक होते हैं। OpenAI ने इनमें से हर हिस्से को डॉक्यूमेंट किया है। जो उसने नहीं बताया, वह यह है कि किस सोर्स का कितना वज़न है, और सारा कन्फ़्यूज़न (और ज़्यादातर अटकलें) यहीं से आता है।
यह गाइड साफ़-साफ़ अलग करती है कि OpenAI ने अपने डॉक्स में क्या पुष्ट किया है और रिसर्चर्स ने रिवर्स इंजीनियरिंग से क्या निकाला है। इसमें OpenAI के चार यूज़र एजेंट और हर एक क्या कंट्रोल करता है, यह समझाया गया है, और एक चेकलिस्ट दी गई है कि वेबसाइट मालिक किस चीज़ पर असर डाल सकते हैं और किस पर नहीं। साथ में हमारा अपना ट्रैकिंग डेटा भी है कि ChatGPT से आने वाला रेफ़रल ट्रैफ़िक कैसा दिखता है, जिसमें 8-16 अक्टूबर 2026 की UTM टैगिंग वाली गड़बड़ी भी शामिल है। सभी सोर्स 18 अक्टूबर 2026 को जाँचे गए।
मुख्य बातें
- पुष्ट: ChatGPT, OpenAI के अपने “इंडेक्स और कैश किए गए वेब कंटेंट” (indexed and cached web content) के साथ-साथ थर्ड-पार्टी सर्च प्रोवाइडर्स और पार्टनर कंटेंट का इस्तेमाल करता है। जिन प्रोवाइडर्स को वह दोबारा लिखी गई क्वेरी भेज सकता है, उनमें OpenAI ने Microsoft और Shopify का नाम लिया है।
- सार्वजनिक नहीं: इनका अनुपात। “Labrador” नाम के एक इंटरनल इंडेक्स और उसे बाहरी नतीजों से तौलने वाले टेस्ट की रिपोर्ट थर्ड-पार्टी रिसर्च से आई हैं, OpenAI से नहीं।
- सर्च के लिए असली स्विच OAI-SearchBot है। इसे ब्लॉक किया तो आपके पेज ChatGPT सर्च के जवाबों में दिखने बंद हो जाएँगे। GPTBot को ब्लॉक करने से आप सिर्फ़ मॉडल ट्रेनिंग से बाहर होते हैं।
- साइटेशन टिकते नहीं। हमारी ट्रैकिंग में, किसी प्रॉम्प्ट के लिए ChatGPT ने जिन डोमेन को साइट किया, उनमें से मीडियन सिर्फ़ 7.7% उस प्रॉम्प्ट के हर रन में दिखे।
- रेफ़रर नहीं, UTM गिनिए। हमारे टैग ने ChatGPT-टैग वाले जितने पेज व्यू रिकॉर्ड किए, उनमें से 39% बिना किसी रेफ़रर के आए।
यह आर्टिकल कैसे पढ़ें: पुष्ट बनाम रिपोर्टेड
नीचे हर दावे पर तीन में से एक लेबल लगा है, क्योंकि ChatGPT सर्च पर होने वाली चर्चा में ये तीनों आपस में बुरी तरह घुल-मिल जाते हैं, और गलत सलाह ऐसे ही फैलती है:
- पुष्ट - OpenAI ने अपने हेल्प सेंटर, डेवलपर डॉक्स, रिलीज़ नोट्स या घोषणाओं में खुद कहा है।
- रिपोर्टेड - थर्ड-पार्टी रिसर्च, ChatGPT के नेटवर्क ट्रैफ़िक की रिवर्स इंजीनियरिंग, पत्रकारों के ज़रिए सामने आई अदालती गवाही या सुनी-सुनाई बातें। अक्सर भरोसेमंद, लेकिन कभी आधिकारिक नहीं।
- हमारा डेटा - AI Rank Lab की प्रॉम्प्ट ट्रैकिंग और JavaScript टैग से मिले एग्रीगेटेड, गुमनाम आँकड़े, हर आँकड़े के साथ उसका तरीका और सैंपल साइज़।
ChatGPT सर्च स्टेप बाय स्टेप कैसे काम करता है?
छोटा जवाब: यह एक रिट्रीवल पाइपलाइन है। पहले सर्च करने का फ़ैसला, फिर क्वेरी को दोबारा लिखना, कई सोर्स से रिट्रीवल, रैंकिंग और फिर साइटेशन के साथ लिखा हुआ जवाब। हर स्टेप उसके सबूत के स्तर के साथ:
- सर्च करना है या नहीं, यह तय करना। पुष्ट: OpenAI के हेल्प आर्टिकल Searching the web with ChatGPT के मुताबिक, जब किसी सवाल को ताज़ा जानकारी से फ़ायदा हो, तो ChatGPT अपने आप सर्च कर सकता है। आप टूल्स मेन्यू से Search चुनकर या कंपोज़र में "/" टाइप करके इसे ज़बरदस्ती भी चालू कर सकते हैं। रिपोर्टेड: RESONEO की फ़रवरी 2026 की रिवर्स इंजीनियरिंग एक क्लासिफ़ायर के बारे में बताती है जो हर प्रॉम्प्ट को स्कोर देता है और एक तय सीमा से ऊपर स्कोर होने पर सर्च चालू करता है।
- प्रॉम्प्ट को सर्च क्वेरी में दोबारा लिखना। पुष्ट: जब ChatGPT पार्टनर सर्च प्रोवाइडर्स का इस्तेमाल करता है, तो आम तौर पर वह आपके सवाल को एक या ज़्यादा टारगेटेड क्वेरी में बदलता है, पहले नतीजे पढ़ने के बाद और ज़्यादा सटीक फ़ॉलो-अप क्वेरी भेज सकता है, आपके IP एड्रेस से अंदाज़ा लगाई गई मोटी-मोटी लोकेशन जोड़ सकता है (IP खुद नहीं), और क्वेरी लिखते समय सेव की गई मेमोरी का इस्तेमाल कर सकता है। इसे query fan-out कहते हैं, जिसे हमने अपनी query fan-out गाइड में विस्तार से समझाया है।
- संभावित पेज निकालना। पुष्ट: नतीजे थर्ड-पार्टी सर्च प्रोवाइडर्स, पार्टनर्स के सीधे दिए गए कंटेंट और OpenAI के अपने इंडेक्स व कैश किए गए वेब कंटेंट से आते हैं। रिपोर्टेड: कौन-कौन से प्रोवाइडर हैं और किसका कितना हिस्सा है (अगला सेक्शन देखें)।
- संभावित पेजों की रैंकिंग। पुष्ट: OpenAI कहता है कि ChatGPT कई फ़ैक्टर के आधार पर सर्च नतीजों की रैंकिंग करता है, ताकि प्रासंगिक और भरोसेमंद जानकारी ऊपर आए, और किसी जगह की गारंटी नहीं है। फ़ैक्टर उसने सार्वजनिक नहीं किए हैं। रिपोर्टेड: RESONEO के मुताबिक कई इंजनों के नतीजे Reciprocal Rank Fusion से मिलाए जाते हैं, जो रैंक की गई लिस्टों को जोड़ने की एक आम तकनीक है।
- जवाब लिखना और सोर्स साइट करना। पुष्ट: सर्च का इस्तेमाल करने वाले जवाबों में इनलाइन साइटेशन, साइट किए गए सोर्स और दूसरे काम के लिंक दिखाने वाला Sources बटन, इमेज के सोर्स लिंक और मोबाइल पर मैप्स हो सकते हैं। जवाब लिखने वाला मॉडल समय के साथ बदला है: 2024 के लॉन्च में फ़ाइन-ट्यून किया गया GPT-4o था, और 7 अक्टूबर 2026 की रिलीज़ से ChatGPT का चैट एक्सपीरियंस GPT-6 पर चलता है (पेड प्लान पर Sol, Free और Go पर Luna), साथ में नया “Intelligent UI” है जो चार्ट, तुलना और इंटरैक्टिव एलिमेंट के साथ जवाब दे सकता है।
ChatGPT मेमोरी से जवाब देने के बजाय वेब सर्च कब करता है?
ChatGPT तब सर्च करता है जब उसे लगता है कि सवाल के लिए ताज़ा या ख़ास जानकारी चाहिए, जैसे न्यूज़, कीमतें, स्कोर, लोकल नतीजे या कोई भी हाल की बात। बाकी मामलों में वह अपने ट्रेनिंग डेटा से जवाब देता है। आप Search को मैन्युअली चुनकर या ChatGPT से वेब सर्च करने को कहकर उसका यह फ़ैसला बदल सकते हैं।
असल में ऐसा कितनी बार होता है? रिपोर्टेड: अमेरिका की अंग्रेज़ी ChatGPT बातचीत पर Profound की स्टडी (अक्टूबर से दिसंबर 2025; लगभग 730,000 बातचीत में कम से कम एक वेब साइटेशन था) में पाया गया कि लगभग 18% बातचीत में कम से कम एक वेब सर्च हुआ, और बातचीत जितनी आगे बढ़ती है, साइटेशन वाले जवाब की संभावना उतनी घटती जाती है: पहले टर्न में 12.6% जवाबों में साइटेशन थे, जबकि दसवें टर्न तक यह 4.5% रह गया।
इससे दो काम की बातें निकलती हैं। पहली, जब ChatGPT सर्च नहीं करता, तो आज आप अपनी साइट पर जो भी बदलें, उस जवाब पर कोई असर नहीं पड़ता, क्योंकि वह ट्रेनिंग डेटा से आता है; यही वह हिस्सा है जिसे GPTBot कंट्रोल करता है। दूसरी, बातचीत का पहला सवाल ही वह जगह है जहाँ सर्च, और इसलिए साइटेशन, होने की संभावना सबसे ज़्यादा है।
ChatGPT सर्च के नतीजे आते कहाँ से हैं?
ChatGPT सर्च के नतीजे तीन चीज़ों के मिश्रण से आते हैं: OpenAI का अपना इंडेक्स और कैश, थर्ड-पार्टी सर्च प्रोवाइडर्स, और लाइसेंस या पार्टनरशिप वाला डेटा। OpenAI ने तीनों के होने की पुष्टि की है, लेकिन यह नहीं बताया कि किसका इस्तेमाल कितनी बार होता है। और यह हिस्सा शायद न्यूज़, शॉपिंग, लोकल और आम क्वेरी के लिए अलग-अलग होता है।
OpenAI ने क्या पुष्ट किया है
- थर्ड-पार्टी प्रोवाइडर्स और पार्टनर कंटेंट। 31 अक्टूबर 2024 की लॉन्च पोस्ट के मुताबिक ChatGPT सर्च थर्ड-पार्टी सर्च प्रोवाइडर्स के साथ पार्टनर्स के सीधे दिए गए कंटेंट का इस्तेमाल करता है, और मौसम, स्टॉक, खेल, न्यूज़ और मैप्स के पीछे न्यूज़ और डेटा पार्टनर हैं।
- नामित प्रोवाइडर्स। मौजूदा हेल्प आर्टिकल यूज़र्स को Microsoft और Shopify की प्राइवेसी पॉलिसी की ओर भेजता है, क्योंकि ये ऐसे सर्च प्रोवाइडर हैं जिन्हें दोबारा लिखी गई क्वेरी मिल सकती हैं। रेस्टोरेंट रिज़र्वेशन के लिए यह OpenTable, Resy और Yelp से उपलब्धता दिखाता है।
- OpenAI का अपना इंडेक्स और कैश। ChatGPT वर्कस्पेस के लिए ऑफ़लाइन वेब सर्च पर OpenAI का हेल्प आर्टिकल एक ऐसे मोड के बारे में बताता है जिसमें ChatGPT किसी लाइव प्रोवाइडर को कॉल करने के बजाय “OpenAI के इंडेक्स और कैश किए गए वेब कंटेंट” में सर्च करता है। इसमें यह भी लिखा है कि किसी ख़ास URL के रिफ़्रेश होने की कोई गारंटी नहीं है और कवरेज साइट, भाषा, क्षेत्र और कंटेंट टाइप के हिसाब से बदलती है।
क्या ChatGPT का अपना सर्च इंडेक्स है?
हाँ। OpenAI के अपने डॉक्यूमेंटेशन में उसके बनाए इंडेक्स और कैश का ज़िक्र है, और इसे भरने के लिए OpenAI एक अलग सर्च क्रॉलर, OAI-SearchBot, चलाता है। जो अभी पुष्ट नहीं है, वह यह कि आम यूज़र की रोज़मर्रा की ChatGPT सर्च का कितना हिस्सा बाहरी प्रोवाइडर्स के बजाय इस इंडेक्स से जवाब पाता है।
इस सवाल पर सबसे अच्छे सार्वजनिक सबूत थर्ड-पार्टी से हैं:
- रिपोर्टेड: अप्रैल 2025 में Google सर्च एंटीट्रस्ट रेमेडीज़ ट्रायल के दौरान ChatGPT के हेड ऑफ़ प्रोडक्ट, OpenAI के Nick Turley ने गवाही दी कि OpenAI अपना इंडेक्स बना रहा है, उस पर पूरी तरह निर्भर होने में शायद कई साल लगेंगे, और Google ने 2024 में OpenAI की सर्च API एक्सेस की माँग ठुकरा दी थी (Tech Policy Press)।
- रिपोर्टेड: Peec AI के सितंबर 2026 के विश्लेषण में 21 मई से 21 जुलाई 2026 के बीच ChatGPT के सर्वर-सेंट इवेंट्स में
result_sourceनाम का एक फ़ील्ड मिला, जिसकी चार वैल्यू थीं: Labrador, Bright, Oxylabs और SERP। Peec के हिसाब से Labrador, OpenAI के वर्टिकल इंडेक्स का एक परिवार है (वेब, PDF, YouTube, न्यूज़, Wikipedia, arXiv, लोकल, फ़ाइनेंस, लीगल, मेडिकल, शॉपिंग, इमेज), और बाकी तीन बाहरी स्क्रैपिंग चैनल हैं। Peec यह नहीं बताता कि हर वैल्यू कितनी बार दिखी। - रिपोर्टेड: Peec और Otterly AI
prefer-index-over-serp-v3नाम के एक एक्सपेरिमेंट के बारे में बताते हैं, जो OpenAI के इंडेक्स को थर्ड-पार्टी नतीजों के मुकाबले परखता दिखता है; Otterly के अनुसार अगस्त 2026 में यह लगभग 8% बातचीत में था। Search Engine Watch ने OpenAI से टिप्पणी माँगी, पर पब्लिश होने तक कोई जवाब नहीं आया।
क्या ChatGPT सर्च Bing या Google का इस्तेमाल करता है?
Microsoft एक घोषित सर्च प्रोवाइडर है; Google नहीं। OpenAI का हेल्प सेंटर सर्च के लिए Microsoft का प्राइवेसी स्टेटमेंट लिस्ट करता है, और Otterly और Peec ने रिपोर्ट किया है कि जून 2026 में घोषित Microsoft का Web IQ ग्राउंडिंग प्लेटफ़ॉर्म ChatGPT को सपोर्ट करता है। हमें यह बात Microsoft के किसी प्राइमरी सोर्स में नहीं मिली, इसलिए इसे रिपोर्टेड ही मानिए। Turley की गवाही के मुताबिक Google की OpenAI से कोई पार्टनरशिप नहीं है, फिर भी कई रिसर्चर्स (RESONEO, Peec) रिपोर्ट करते हैं कि Google के नतीजे स्क्रैपिंग प्रोवाइडर्स के ज़रिए ChatGPT तक पहुँचते हैं। OpenAI ने इसकी पुष्टि नहीं की है।
काम की बात: Bing या Google में अच्छी रैंकिंग से आपके पेज उन प्रोवाइडर्स को मिलने में मदद मिलती है जिनका ChatGPT इस्तेमाल कर सकता है, लेकिन इनमें से कोई भी रैंकिंग ChatGPT विज़िबिलिटी का भरोसेमंद पैमाना नहीं है। ChatGPT को आपको सीधे मापना होगा।
| दावा | स्टेटस | सोर्स | तारीख |
|---|---|---|---|
| ChatGPT थर्ड-पार्टी सर्च प्रोवाइडर्स और पार्टनर कंटेंट का इस्तेमाल करता है | पुष्ट | OpenAI की लॉन्च पोस्ट | 31 अक्टूबर 2024 |
| Microsoft और Shopify ऐसे सर्च प्रोवाइडर हैं जिन्हें क्वेरी मिल सकती हैं | पुष्ट | OpenAI हेल्प सेंटर | 18 अक्टूबर 2026 को जाँचा |
| OpenAI अपना इंडेक्स और कैश किया हुआ वेब कंटेंट रखता है | पुष्ट | OpenAI हेल्प सेंटर (ऑफ़लाइन वेब सर्च) | 18 अक्टूबर 2026 को जाँचा |
| OAI-SearchBot साइट्स को ChatGPT सर्च में दिखाने के लिए क्रॉल करता है | पुष्ट | OpenAI डेवलपर डॉक्स | 18 अक्टूबर 2026 को जाँचा |
| OpenAI अपना इंडेक्स बना रहा है; पूरी निर्भरता में अभी कई साल हैं | रिपोर्टेड (अदालती गवाही) | Tech Policy Press | अप्रैल 2025 |
| “Labrador” नाम का इंटरनल इंडेक्स परिवार, साथ में Bright, Oxylabs और SERP चैनल | रिपोर्टेड (नेटवर्क विश्लेषण) | Peec AI | सितंबर 2026 |
| OpenAI के इंडेक्स को बाहरी नतीजों के मुकाबले परखने वाला एक्सपेरिमेंट (~8% चैट) | रिपोर्टेड | Peec AI, Otterly AI | अगस्त-सितंबर 2026 |
| Microsoft Web IQ, ChatGPT के जवाबों को ग्राउंड करता है | रिपोर्टेड, Microsoft के सोर्स में हमने पुष्टि नहीं की | Otterly AI, Peec AI | जून 2026 |
| Google के नतीजे स्क्रैपिंग प्रोवाइडर्स के ज़रिए ChatGPT तक पहुँचते हैं | रिपोर्टेड, अपुष्ट | RESONEO, Peec AI | 2026 |
OAI-SearchBot, GPTBot और ChatGPT-User में क्या फ़र्क है?
OAI-SearchBot तय करता है कि आप ChatGPT सर्च में दिख सकते हैं या नहीं, GPTBot तय करता है कि आपका कंटेंट OpenAI के मॉडल की ट्रेनिंग में इस्तेमाल हो सकता है या नहीं, और ChatGPT-User वह एजेंट है जो तब पेज खोलता है जब कोई व्यक्ति ChatGPT से उसे खोलने को कहता है। तीनों एक-दूसरे से अलग हैं: आप एक को अनुमति देकर दूसरे को ब्लॉक कर सकते हैं। OpenAI के क्रॉलर डॉक्यूमेंटेशन में एक चौथा एजेंट भी है, OAI-AdsBot, जो ChatGPT विज्ञापनों के लिए है।
| यूज़र एजेंट | यह क्या करता है (OpenAI के मुताबिक) | robots.txt से क्या कंट्रोल होता है | IP लिस्ट |
|---|---|---|---|
| OAI-SearchBot | वेबसाइट्स को ChatGPT के सर्च फ़ीचर्स में दिखाने के लिए क्रॉल करता है | इसे Disallow करेंगे तो आपके पेज ChatGPT सर्च के जवाबों में नहीं दिखेंगे, हालाँकि साधारण नेविगेशनल लिंक के रूप में दिख सकते हैं। बदलाव में लगभग 24 घंटे लगते हैं। | openai.com/searchbot.json |
| GPTBot | ऐसा कंटेंट क्रॉल करता है जो OpenAI के फ़ाउंडेशन मॉडल की ट्रेनिंग में इस्तेमाल हो सकता है | इसे Disallow करके आप संकेत देते हैं कि आपका कंटेंट ट्रेनिंग में इस्तेमाल न हो। सर्च में आने की योग्यता पर इसका कोई असर नहीं। | openai.com/gptbot.json |
| ChatGPT-User | यूज़र की शुरू की गई विज़िट, जैसे कोई ChatGPT से पेज पढ़ने को कहे, या GPT Actions | robots.txt के नियम लागू न हों, यह मुमकिन है, क्योंकि विज़िट यूज़र ने शुरू की। सर्च में शामिल करने का फ़ैसला इससे नहीं होता। | openai.com/chatgpt-user.json |
| OAI-AdsBot | ChatGPT विज्ञापन के तौर पर सबमिट किए गए लैंडिंग पेज जाँचता है; सिर्फ़ उन्हीं पेजों पर जाता है | तभी काम का है जब आप ChatGPT पर विज्ञापन देते हैं। इसका डेटा फ़ाउंडेशन मॉडल की ट्रेनिंग में इस्तेमाल नहीं होता। | openai.com/adsbot.json |
जो साइट ChatGPT सर्च में दिखना चाहती है लेकिन ट्रेनिंग में इस्तेमाल नहीं होना चाहती, उसका एक आम सेटअप ऐसा दिखता है:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
OpenAI के डॉक्स की दो बातें लोग अक्सर मिस कर देते हैं: अगर आप दोनों बॉट को अनुमति देते हैं, तो OpenAI दोनों कामों के लिए एक ही क्रॉल इस्तेमाल कर सकता है, और खुद robots.txt फ़ेच करते समय यूज़र-एजेंट स्ट्रिंग में एक अतिरिक्त "robots.txt" मार्कर हो सकता है। सभी AI क्रॉलर के लिए पूरे नियमों के लिए हमारी AI क्रॉलर के लिए robots.txt गाइड या मुफ़्त robots.txt जनरेटर देखिए, और अपने लॉग में असली बॉट ट्रैफ़िक वेरिफ़ाई करने के लिए हमारी GPTBot, ClaudeBot और PerplexityBot मॉनिटरिंग गाइड।
ChatGPT किन सोर्स को साइट करना है, यह कैसे चुनता है?
OpenAI बस इतना कहता है कि ChatGPT प्रासंगिकता और भरोसे को ध्यान में रखकर कई फ़ैक्टर पर नतीजों की रैंकिंग करता है, और किसी जगह की गारंटी नहीं है। रैंकिंग फ़ैक्टर की कोई सार्वजनिक लिस्ट नहीं है, और न ही कोई सबमिशन टूल। हम जो माप सकते हैं, वह है साइटेशन का पैटर्न।
रिपोर्टेड: Profound की तीन महीने की स्टडी में, साइटेशन वाले एक जवाब में औसतन लगभग चार यूनीक सोर्स थे, और साइटेशन वाले 66% टर्न में एक से चार सोर्स इस्तेमाल हुए। साइटेशन काफ़ी बिखरे हुए थे: टॉप दस डोमेन को कुल साइटेशन का सिर्फ़ 12% मिला, जिसमें Wikipedia लगभग 5% और Reddit लगभग 3% पर था।
हमारा डेटा: AI Rank Lab ने 11 ChatGPT प्रॉम्प्ट को कम से कम पाँच-पाँच बार चलाया (239 सफल रन, 13 फ़रवरी से 14 अक्टूबर 2026)। एक ही प्रॉम्प्ट के लगातार दो रन के बीच साइट किए गए डोमेन का मीडियन ओवरलैप 0.54 रहा (Jaccard similarity, जहाँ 1 का मतलब बिल्कुल एक जैसा)। किसी प्रॉम्प्ट के लिए ChatGPT ने जिन डोमेन को साइट किया, उनमें से मीडियन सिर्फ़ 7.7% हर रन में दिखे, और 11 में से 6 प्रॉम्प्ट कम से कम एक बार ट्रैक किए गए ब्रांड का ज़िक्र करने और न करने के बीच पलटे। ये ऑटोमेटेड रन हैं, इसलिए लॉग-इन यूज़र के पर्सनलाइज़्ड नतीजों से मेल न खाएँ, यह मुमकिन है; पूरा तरीका हमारी AI जवाबों की स्थिरता वाली स्टडी में है।
मतलब यह कि “क्या ChatGPT हमें साइट करता है?” गलत सवाल है। काम का सवाल है: “बार-बार चलाए गए रन में से कितने हिस्से में हमें साइट किया जाता है, और किन प्रॉम्प्ट के लिए?” एक बार मैन्युअली चेक कर लेने से लगभग कुछ पता नहीं चलता।
ChatGPT सर्च से आने वाले ट्रैफ़िक को कैसे ट्रैक करें?
ChatGPT विज़िट को रेफ़रर से नहीं, बल्कि utm_source=chatgpt.com पैरामीटर से ट्रैक कीजिए, जिसे ChatGPT बाहर जाने वाले लिंक में जोड़ता है। OpenAI के पब्लिशर FAQ में इस पैरामीटर का ज़िक्र रहा है (18 अक्टूबर 2026 को हम वह पेज लोड नहीं कर पाए, इसलिए हम उसकी पुरानी कॉपी और अपने ऑब्ज़र्वेशन पर भरोसा कर रहे हैं), और असली ट्रैफ़िक में यह साफ़ दिखता है।
हमारा डेटा: 27 जुलाई 2025 से 18 अक्टूबर 2026 के बीच AI Rank Lab के JavaScript टैग ने 29 साइट्स पर utm_source=chatgpt.com वाले 2,710 पेज व्यू रिकॉर्ड किए, जबकि 26 साइट्स पर chatgpt.com रेफ़रर वाले 2,087 पेज व्यू थे। टैग वाले 2,710 पेज व्यू में से 1,048 (39%) बिना किसी रेफ़रर के आए। सिर्फ़ रेफ़रर पर चलने वाला एनालिटिक्स इन विज़िट को Direct में डाल देता।
GA4 में session source = chatgpt.com देखिए, जो UTM को पकड़ता है, और एक ऐसा चैनल ग्रुप बनाइए जिसमें यह शामिल हो। हमारा GA4 के लिए AI रेफ़रल ट्रैकिंग पेज सेटअप दिखाता है, और AI बॉट ट्रैकिंग GA4 पर बिल्कुल निर्भर हुए बिना हर पेज के लिए AI असिस्टेंट से आए रेफ़रल रिकॉर्ड करता है।
अक्टूबर 2026 में ChatGPT के UTM टैग के साथ क्या हुआ?
GPT-6 लॉन्च होने के बाद लगभग एक हफ़्ते तक ChatGPT के कई लिंक बिना UTM टैग के गए, इसलिए जो विज़िट पहले ChatGPT के खाते में जाती थीं, वे Direct में दिखने लगीं। 15-16 अक्टूबर को टैग वापस आ गए। GPT-6 की लॉन्च तारीख को छोड़कर इसकी हर जानकारी थर्ड-पार्टी से आई है; OpenAI ने कोई सार्वजनिक बयान नहीं दिया है, और उसके रिलीज़ नोट्स में इसका ज़िक्र नहीं है।
| तारीख (2026) | क्या हुआ | स्टेटस | सोर्स |
|---|---|---|---|
| 7-8 अक्टूबर | GPT-6 और Intelligent UI पहले पेड प्लान पर, फिर Free और Go पर रोल आउट हुए | पुष्ट | OpenAI रिलीज़ नोट्स |
| 8 अक्टूबर, ~18:30 UTC | टैग वाले लिंक वाले जवाबों का हिस्सा लगभग 99% से फिसलना शुरू हुआ | रिपोर्टेड | Profound |
| 9-13 अक्टूबर | लगभग 500 पेजों पर ChatGPT विज़िट रोज़ ~31,000 घटीं, जबकि Direct रोज़ ~26,000 बढ़ा | रिपोर्टेड | Adobe के Cedric Huesler, SEJ के ज़रिए |
| 14 अक्टूबर | Huesler के मुताबिक OpenAI ने उन्हें बताया कि यह एक जाना-पहचाना बग है | रिपोर्टेड (सुनी-सुनाई) | SEJ |
| 14 अक्टूबर, ~19:00 UTC | Intelligent UI वाले जवाब 92-96% तक पहुँचे और टैग वाले जवाब गिरकर 5-10% रह गए | रिपोर्टेड | Profound |
| 15-16 अक्टूबर | फ़िक्स रोल आउट हुआ; 16 अक्टूबर को 06:30 UTC तक टैग वाले जवाब फिर लगभग 99% | रिपोर्टेड | Profound, SEJ |
सोर्स: Search Engine Journal, 15 अक्टूबर 2026 और Profound की इंसिडेंट टाइमलाइन।
हमारा डेटा: इस अवधि के लिए हमारा सैंपल छोटा है, इसलिए इसे माप नहीं, बस एक कंसिस्टेंसी चेक समझिए। 9 से 18 अक्टूबर तक हमारे टैग ने दो साइट्स पर ChatGPT-टैग वाले 52 पेज व्यू देखे, और उनमें से किसी में भी chatgpt.com रेफ़रर नहीं था। उससे पहले के 30 दिनों (9 सितंबर से 8 अक्टूबर) में सात साइट्स पर टैग वाले 368 पेज व्यू में से 236 (64%) में रेफ़रर था। यह उन रिपोर्ट्स से मेल खाता है कि टैग लौटने के बाद भी ChatGPT से आने वाले ज़्यादातर क्लिक बिना रेफ़रर के आते हैं।
क्या करें: अपनी रिपोर्ट में 8-16 अक्टूबर पर नोट लगाइए, इसे खोया हुआ ट्रैफ़िक मानने से पहले उन लैंडिंग पेजों का Direct ट्रैफ़िक मिलाइए जिन पर ChatGPT आम तौर पर लोगों को भेजता है, और रेफ़रर के बजाय UTM ही गिनते रहिए।
अपनी वेबसाइट को ChatGPT सर्च के लिए योग्य कैसे बनाएँ?
योग्यता का मतलब बस इतना है कि OAI-SearchBot आपके पेजों तक पहुँच सके और उन्हें पढ़ सके। OpenAI का हेल्प सेंटर साफ़ कहता है: robots.txt में OAI-SearchBot को अनुमति दीजिए और पक्का कीजिए कि आपका होस्ट या CDN OpenAI के प्रकाशित सर्च बॉट IP एड्रेस से आने वाला ट्रैफ़िक आने दे। इस लिस्ट की बाकी हर चीज़ आपकी योग्यता नहीं, आपके मौके बढ़ाती है।
- robots.txt में OAI-SearchBot को अनुमति दीजिए, और GPTBot का फ़ैसला अलग से कीजिए। ऐसे बड़े
User-agent: *नियम ज़रूर चेक कीजिए जो इसे गलती से ब्लॉक कर देते हैं। - CDN, फ़ायरवॉल या बॉट-प्रोटेक्शन लेयर पर OpenAI की IP रेंज को अनुमति दीजिए। “AI बॉट ब्लॉक करें” वाले कई टॉगल OAI-SearchBot को भी ब्लॉक कर देते हैं। अपने लॉग में 403 या 429 रिस्पॉन्स को openai.com/searchbot.json से मिलाइए।
- मुख्य कंटेंट HTML में रखिए। OpenAI के मुताबिक स्क्रिप्ट पर भारी निर्भरता, डायनैमिक लोडिंग, लॉगिन और पर्सनलाइज़ेशन उन कारणों में हैं जिनसे उसका इंडेक्स कोई पेज मिस कर सकता है। ज़रूरी पेजों को सर्वर-रेंडर या प्री-रेंडर कीजिए।
- गहराई वाले पेजों को आसानी से खोजने लायक बनाइए। OpenAI ऐसे साइट स्ट्रक्चर को भी एक कारण बताता है जो गहरे पेजों को छिपा देता है। ज़रूरी पेजों को हब पेजों से लिंक कीजिए और अपना XML साइटमैप अपडेट रखिए।
- पेजों को ताज़ा रखिए और उन पर तारीख दिखाइए। OpenAI हर URL के लिए कोई रिफ़्रेश शेड्यूल नहीं देता, और कहता है कि ताज़गी साइट, क्रॉल एक्सेस, कैशिंग और लोकप्रियता पर निर्भर करती है। दिखने वाली “अपडेटेड” तारीख पाठकों के भी काम आती है और उस हर सिस्टम के भी जो ताज़गी को महत्व देता है।
- जवाब पहले देने वाले, अपने आप में पूरे पैराग्राफ़ लिखिए। यह OpenAI की गाइडेंस नहीं, बल्कि प्रैक्टिशनर्स की आम राय है: जो सेक्शन पहले ही वाक्य में अपनी हेडिंग का जवाब दे दे, उसे कोट करना आसान होता है। कंटेंट वाले पहलू के लिए हमारी 30 दिन की ChatGPT साइटेशन प्लेबुक देखिए।
- अपनी कैटेगरी के लिए ChatGPT जो डेटा खींचता है, उसमें मौजूद रहिए। रेस्टोरेंट के लिए OpenTable, Resy और Yelp से उपलब्धता दिखती है; शॉपिंग के लिए Shopify एक घोषित प्रोवाइडर है। अगर ये आप पर लागू होते हैं, तो वहाँ की आपकी लिस्टिंग आपकी ChatGPT विज़िबिलिटी का हिस्सा है।
- पक्का कीजिए कि OAI-SearchBot सच में आता है। सर्वर लॉग में OAI-SearchBot टोकन फ़िल्टर कीजिए और IP वेरिफ़ाई कीजिए, फिर ट्रैक कीजिए कि आपके टारगेट प्रॉम्प्ट के लिए ChatGPT कौन-से URL साइट करता है।
पूरी साइट पर स्टेप 3 से 5 चेक करने के लिए AEO ऑडिट आपके पेज क्रॉल करता है और SEO, आंसर इंजन और जनरेटिव इंजन की तैयारी से जुड़ी दिक्कतों को सुझाए गए फ़िक्स के साथ फ़्लैग करता है। स्टेप 8 के दूसरे हिस्से के लिए साइटेशन ट्रैकिंग रिकॉर्ड करती है कि आपके प्रॉम्प्ट के लिए ChatGPT आपके कौन-से URL साइट करता है।
मेरा पेज ChatGPT सर्च में क्यों नहीं दिख रहा?
सबसे आम कारण हैं: क्रॉल ब्लॉक, CDN या फ़ायरवॉल का कोई नियम, ऐसा कंटेंट जो JavaScript चलने के बाद ही दिखता है, और ऐसे पेज जो नए हैं, बहुत गहराई में हैं या जिन पर कम लिंक हैं। OpenAI ने अपने ऑफ़लाइन वेब सर्च डॉक्यूमेंटेशन में ठीक यही कारण बताए हैं कि उसके इंडेक्स में पेज क्यों गायब या पुराने हो सकते हैं। यह लिस्ट उसने वर्कस्पेस एडमिन के लिए लिखी थी, लेकिन OpenAI सिर्फ़ यहीं समझाता है कि उसका इंडेक्स पेज क्यों मिस करता है, इसलिए यह एक डायग्नॉस्टिक चेकलिस्ट का काम भी करती है।
| OpenAI का बताया कारण | कैसे चेक करें | फ़िक्स |
|---|---|---|
| robots.txt या ऐसे ही कंट्रोल क्रॉलिंग ब्लॉक करते हैं | /robots.txt खोलिए; OAI-SearchBot या सब पर लागू Disallow ढूँढिए | OAI-SearchBot को अनुमति दीजिए; लगभग 24 घंटे इंतज़ार कीजिए |
| CDN या बॉट-ब्लॉकिंग का व्यवहार | लॉग में 403, 429 या चैलेंज पेज वाली OAI-SearchBot रिक्वेस्ट खोजिए | openai.com/searchbot.json की रेंज को allowlist कीजिए |
| पेज के लिए लॉगिन या पर्सनलाइज़ेशन ज़रूरी है | प्राइवेट विंडो में, लॉग-आउट होकर पेज खोलिए | मुख्य कंटेंट का एक पब्लिक वर्ज़न पब्लिश कीजिए |
| कंटेंट स्क्रिप्ट या डायनैमिक लोडिंग पर निर्भर है | curl से रॉ HTML निकालिए और देखिए कि मुख्य टेक्स्ट उसमें है या नहीं | सर्वर-साइड रेंडर या प्री-रेंडर कीजिए |
| पेज नया है, कम खुलता है या उसके सिग्नल कमज़ोर हैं | पब्लिश की तारीख और उस पर आने वाले इंटरनल व एक्सटर्नल लिंक चेक कीजिए | मज़बूत पेजों से इसे लिंक कीजिए; रेफ़रेंस कमाइए; थोड़ा समय दीजिए |
| साइट स्ट्रक्चर गहरे पेजों को छिपा देता है | होमपेज से क्लिक गिनिए; साइटमैप चेक कीजिए | हब लिंक जोड़िए और साइटमैप अपडेट रखिए |
अगर हर लाइन ठीक है और फिर भी आपको साइट नहीं किया जा रहा, तो दिक्कत आम तौर पर एक्सेस की नहीं, प्रासंगिकता या मुकाबले की होती है: कोई दूसरा पेज प्रॉम्प्ट का ज़्यादा सीधा जवाब देता है, या ChatGPT उस प्रॉम्प्ट के लिए सर्च ही नहीं कर रहा।
ChatGPT सर्च में आप किन चीज़ों को कंट्रोल नहीं कर सकते?
आप एक्सेस और कंटेंट की क्वालिटी कंट्रोल करते हैं। उसके बाद जो होता है, उसका ज़्यादातर हिस्सा आपके हाथ में नहीं। ख़ास तौर पर, आप इन्हें कंट्रोल नहीं कर सकते:
- ChatGPT सर्च करेगा या नहीं। जब तक यूज़र खुद Search चालू न करे, यह फ़ैसला ChatGPT का है।
- कौन-सा प्रोवाइडर जवाब देगा। OpenAI का इंडेक्स, Microsoft, Shopify, पार्टनर्स या रिपोर्ट किए गए स्क्रैपिंग चैनल, एक ऐसे अनुपात में जो बताया नहीं गया और जिसे OpenAI सक्रिय रूप से टेस्ट करता दिखता है।
- रैंकिंग और साइटेशन। न कोई सार्वजनिक फ़ैक्टर लिस्ट है, न गारंटी, और हमारा डेटा दिखाता है कि साइटेशन हर रन में बदलते हैं।
- इंडेक्सिंग की रफ़्तार। OpenAI किसी URL सबमिशन टूल, इंडेक्स कवरेज रिपोर्ट या किसी ख़ास URL के रिफ़्रेश की गारंटी का कोई डॉक्यूमेंटेशन नहीं देता।
- ट्रेनिंग डेटा वाले जवाब। जब ChatGPT मेमोरी से जवाब देता है, तो आज के पेज एडिट उस पर लागू नहीं होते।
- ChatGPT-User विज़िट। यूज़र की शुरू की गई फ़ेच पर robots.txt लागू न हो, यह मुमकिन है।
- नेविगेशनल लिंक। OAI-SearchBot को ब्लॉक करने के बाद भी आपकी साइट नेविगेशनल लिंक के रूप में दिख सकती है।
- लिंक टैगिंग। जैसा अक्टूबर 2026 ने दिखाया, एट्रिब्यूशन बिना किसी सूचना के टूट सकता है।
ChatGPT कौन-से URL साइट करता है, इसकी मॉनिटरिंग कैसे करें?
क्योंकि नतीजे हर रन में बदलते हैं, मॉनिटरिंग का मतलब है एक ही प्रॉम्प्ट बार-बार चलाना और समय के साथ ज़िक्र और साइट किए गए URL रिकॉर्ड करना। कुछ गिने-चुने प्रॉम्प्ट के लिए आप यह लॉग-आउट ब्राउज़र में हाथ से कर सकते हैं; उससे ज़्यादा के लिए कोई टूल समय बचाता है।
डिस्क्लोज़र: AI Rank Lab हमारा प्रोडक्ट है। हमने इसे सबसे ऊपर रखा है क्योंकि यह हमारी साइट है, और नीचे के हर टूल के लिए हमने एक जैसे पैमाने रखे हैं।
- AI Rank Lab - आपके प्रॉम्प्ट ChatGPT, Claude, Gemini और Perplexity पर शेड्यूल से चलाता है, साथ में Google AI Overviews और AI Mode पर भी, और ज़िक्र, पोज़िशन, कॉम्पिटिटर और साइट किए गए URL रिकॉर्ड करता है। यह ऑडिट, एक Action Plan और कंटेंट पब्लिशिंग के ज़रिए ट्रैकिंग को फ़िक्स से भी जोड़ता है। देखिए ब्रांड विज़िबिलिटी ट्रैकिंग।
- Profound - एंटरप्राइज़ पर फ़ोकस, और ChatGPT साइटेशन पर कुछ सबसे बड़े सार्वजनिक डेटासेट पब्लिश करता है, जैसे ऊपर बताई गई स्टडी।
- Peec AI - मैकेनिज़्म रिसर्च में मज़बूत, जिसमें ChatGPT के इंडेक्स का अब तक का सबसे विस्तृत सार्वजनिक विश्लेषण भी शामिल है।
- Otterly AI - अक्सर GEO एक्सपेरिमेंट पब्लिश करता है और कई AI इंजन कवर करता है।
तरीका और सीमाएँ
18 अक्टूबर 2026 को हमने वेब सर्च, ऑफ़लाइन वेब सर्च और रिलीज़ नोट्स पर OpenAI के हेल्प सेंटर आर्टिकल, OpenAI का क्रॉलर डॉक्यूमेंटेशन और उसकी 2024 की लॉन्च पोस्ट पढ़ी, और ChatGPT सर्च कैसे काम करता है, इस पर रैंक करने वाले 15 आर्टिकल और रिपोर्ट का विश्लेषण किया। थर्ड-पार्टी नतीजों पर “रिपोर्टेड” लेबल है, क्योंकि OpenAI ने इनमें से किसी की पुष्टि नहीं की है; इनमें से कई ऐसी कंपनियों से हैं जो हमारी तरह AI विज़िबिलिटी टूल बेचती हैं। लिखने के दिन हम OpenAI का पब्लिशर FAQ लोड नहीं कर पाए, और ChatGPT में Microsoft Web IQ की भूमिका की पुष्टि Microsoft के किसी प्राइमरी सोर्स में नहीं कर पाए। हमारे फ़र्स्ट-पार्टी आँकड़े कुछ ही साइट्स और प्रॉम्प्ट से आते हैं, एग्रीगेटेड और गुमनाम हैं, और उनके सैंपल साइज़ के साथ दिए गए हैं; ये हमारे ग्राहकों के ट्रैफ़िक के बारे में बताते हैं, पूरे वेब के बारे में नहीं।
अगर आप देखना चाहते हैं कि आपके लिए अहम प्रॉम्प्ट पर ChatGPT असल में आपके कौन-से पेज साइट करता है, और यह हफ़्ते-दर-हफ़्ते कैसे बदलता है, तो AI Rank Lab के साथ ट्रैकिंग शुरू कीजिए।
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


