



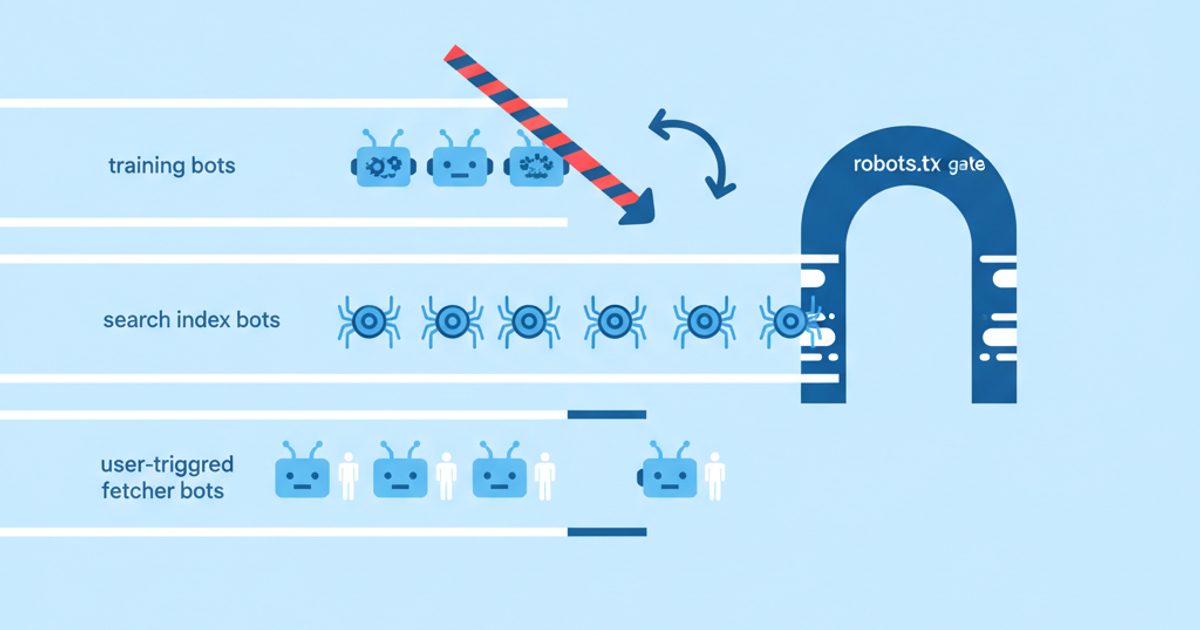
AI 크롤러는 AI 기업이 운영하는 자동화 봇으로, 세 가지 중 한 가지 목적으로 웹페이지를 가져가요. 모델 학습용 데이터를 모으거나(GPTBot, ClaudeBot), AI 답변이 인용하는 검색 인덱스를 만들거나(OAI-SearchBot, Claude-SearchBot, PerplexityBot), 사용자가 어시스턴트에게 어떤 페이지에 대해 물었을 때 그 페이지를 실시간으로 가져오는 것(ChatGPT-User, Claude-User, Perplexity-User)이죠. 학습용 크롤러를 차단하면 앞으로 나올 모델에 내 콘텐츠가 들어가지 않고, 검색 크롤러나 사용자 요청형 페처를 차단하면 AI 답변과 인용에서 사라져요. 결국 판단의 핵심은 이 차이 하나예요.
이 글은 바로 적용할 수 있는 레퍼런스예요. 아래 모든 사용자 에이전트는 2026년 10월 18일에 운영사의 공식 문서와 대조해 확인했고, 해당 페이지 링크도 달아 두었어요. 그 밖에 비즈니스 목표별 판단 매트릭스, 바로 복사해 쓸 수 있는 robots.txt 그룹, 운영사별로 지원하는 검증 방법(공개된 IP 목록 안에 찍힌 날짜 포함), 그리고 자바스크립트 기반 분석 도구로는 왜 크롤러 트래픽 대부분을 볼 수 없는지에 대한 솔직한 설명까지 담았어요.
핵심 요약
- 모든 AI 봇을 학습용, 검색/인덱스용, 사용자 요청형으로 분류하세요. OpenAI, Anthropic, Amazon, Meta, Mistral은 분류마다 별도의 토큰을 공개하기 때문에, 하나만 골라서 차단할 수 있어요.
- GPTBot을 차단해도 ChatGPT 검색에서 빠지지 않아요. OpenAI에 따르면 이를 결정하는 건 OAI-SearchBot뿐이고, OAI-SearchBot을 거부한 사이트도 탐색용 링크로는 여전히 노출될 수 있어요.
- Google-Extended와 Applebot-Extended는 크롤러가 아니라 제어용 토큰이에요. 로그에는 절대 나타나지 않고, Google은 Google-Extended가 AI Overviews와 AI Mode를 포함한 Google 검색에 아무 영향도 주지 않는다고 밝혔어요.
- 사용자 요청형 페처는 설계상 robots.txt를 건너뛸 수 있어요. OpenAI, Perplexity, Google, Meta, Amazon 모두 문서에 그렇게 적어 두었죠. 확실하게 막아야 한다면 WAF를 쓰세요.
- 대부분의 AI 크롤러는 자바스크립트를 실행하지 않기 때문에 JS 분석 태그로는 실제보다 적게 잡혀요. 크롤러 활동의 기준이 되는 데이터는 서버 로그나 CDN 로그예요.
- 봇은 역방향 DNS(Google, Apple, Common Crawl)로 검증하거나, IP를 운영사가 공개한 JSON 목록과 대조해 검증하세요. 그중 일부 목록은 몇 년 전 것이니 주기적으로 다시 내려받으세요.
AI 크롤러란 무엇이고, 세 가지 유형은 어떻게 나뉠까요?
AI 크롤러는 AI 기업이 내 페이지를 요청할 때 쓰는 모든 자동화 클라이언트를 말해요. 요즘 운영사들은 봇을 목적별로 나누고 있고, 그 목적에 따라 차단했을 때 잃는 것이 달라져요. Cloudflare의 네트워크 데이터를 보면 그 비중이 얼마나 한쪽으로 쏠려 있는지 알 수 있어요. 2025년 중반까지 12개월 동안 AI 크롤링의 80%는 학습용, 18%는 검색용, 2%는 사용자 액션용이었고, 그 기간의 최근 6개월만 보면 학습용 비중이 82%까지 올라갔어요.
학습용 크롤러
학습용 크롤러는 파운데이션 모델을 학습하거나 파인튜닝하는 데 쓰일 수 있는 콘텐츠를 수집해요. GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training, 그리고 CCBot(많은 모델 개발사가 쓰는 Common Crawl의 공개 데이터셋)이 여기에 속해요. 이들을 차단하는 건 앞으로 올리는 콘텐츠를 학습 데이터셋에서 빼 달라는 신호예요. 이미 수집된 콘텐츠가 지워지지는 않고, AI 검색이 나를 인용할 수 있는지에도 영향을 주지 않아요.
검색 및 인덱스 크롤러
검색 크롤러는 AI 답변의 근거가 되고 인용 링크가 연결되는 검색 인덱스를 만들어요. OAI-SearchBot(ChatGPT 검색), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot은 AI 전용이에요. Googlebot, Bingbot, Applebot은 전통적인 검색 크롤러인데, 이들의 인덱스가 이제 Google AI Overviews와 AI Mode, Microsoft Copilot, Siri 답변 같은 AI 기능에도 쓰여요. 검색 크롤러를 차단하는 건 대가가 큰 실수예요. 구매자가 읽는 답변에서 내가 통째로 빠지니까요. 이런 인덱스가 실제로 어떻게 쓰이는지 궁금하다면 ChatGPT 검색이 작동하는 방식을 참고하세요.
사용자 요청형 페처와 에이전트
사용자 요청형 페처는 사람이 어시스턴트에게 페이지를 읽거나, 요약하거나, 그 페이지에서 무언가를 해 달라고 요청했을 때 해당 URL 하나를 방문해요. ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User, MistralAI-User가 여기에 속하고, ChatGPT의 Cloud browser처럼 서명된 브라우저 에이전트도 포함돼요. 여러 운영사가 사람이 시작한 요청이기 때문에 이들에게는 robots.txt가 적용되지 않을 수 있다고 밝히고 있어요.
크롤러가 아닌 제어용 토큰
어느 목록에나 등장하는 이름 중 두 개는 스스로 아무것도 가져가지 않아요. Google-Extended는 Google이 일반 사용자 에이전트로 크롤링하면서 읽는 robots.txt 제품 토큰으로, 콘텐츠를 향후 Gemini 모델 학습과 Gemini 앱 및 Vertex AI의 그라운딩에 써도 되는지를 제어해요. Applebot-Extended는 Apple의 파운데이션 모델에 대해 같은 역할을 해요. 둘 다 접속 로그에서는 찾을 수 없어요. 그래서 "Google-Extended를 막았는데도 Google 트래픽이 보인다"는 건 지극히 정상적인 현상이에요.
AI 크롤러 목록: 주요 사용자 에이전트 총정리(2026년 10월 18일 확인)
아래 표에는 User-agent: 줄에 넣는 토큰, 운영 주체, 유형, robots.txt에 대해 운영사 공식 문서가 말하는 내용, 검증 방법, 그리고 저희가 확인한 공식 페이지를 정리했어요. "문서 기준"은 robots.txt 열이 운영사 설명을 요약했다는 뜻이고, 문서에 언급이 없는 경우에는 추측하지 않고 언급이 없다고 적었어요.
| 토큰 | 운영사 | 유형 | 하는 일 | robots.txt(문서 기준) | 검증 방법 | 공식 문서 |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | 학습용 | OpenAI 파운데이션 모델 학습에 쓰일 수 있는 콘텐츠를 크롤링 | 준수 | gptbot.json | OpenAI 크롤러 |
| OAI-SearchBot | OpenAI | 검색용 | ChatGPT 검색 답변에 사이트를 노출, 학습용 아님 | 준수, 변경 반영까지 약 24시간 | searchbot.json | OpenAI 크롤러 |
| ChatGPT-User | OpenAI | 사용자 요청형 | ChatGPT와 Custom GPTs에서 사용자 액션을 위해 페이지 방문 | 적용되지 않을 수 있음 | chatgpt-user.json | OpenAI 크롤러 |
| OAI-AdsBot | OpenAI | 특수 | ChatGPT 광고로 제출된 랜딩 페이지 확인, 학습용 아님 | 명시 없음, 제출된 광고 페이지만 방문 | adsbot.json | OpenAI 크롤러 |
| ClaudeBot | Anthropic | 학습용 | Claude 모델 학습에 활용될 수 있는 콘텐츠 수집 | 준수, Crawl-delay 지원 | bots.json(공용) | Anthropic 고객센터 |
| Claude-SearchBot | Anthropic | 검색용 | Claude 검색 결과 개선을 위해 콘텐츠 인덱싱 | 준수 | bots.json(공용) | Anthropic 고객센터 |
| Claude-User | Anthropic | 사용자 요청형 | Claude 사용자가 질문할 때 페이지를 가져옴 | 준수, 차단하면 사용자 요청에 따른 수집이 멈춤 | bots.json(공용) | Anthropic 고객센터 |
| PerplexityBot | Perplexity | 검색용 | Perplexity 결과에 사이트를 노출하고 링크, 학습용 아님 | 준수, 최대 24시간 | perplexitybot.json | Perplexity 크롤러 |
| Perplexity-User | Perplexity | 사용자 요청형 | 사용자 질문에 답하기 위해 페이지 방문 | 일반적으로 무시 | perplexity-user.json | Perplexity 크롤러 |
| Googlebot | 검색용 | AI Overviews와 AI Mode를 포함한 Google 검색 | 준수, 자동 크롤링에는 항상 적용 | 역방향 DNS 또는 common-crawlers.json | Google 일반 크롤러 | |
| Google-Extended | 제어용 토큰 | Gemini 학습, Gemini 앱 및 Vertex AI의 그라운딩 | 토큰 전용, 자체 사용자 에이전트 없음 | 해당 없음 | Google 일반 크롤러 | |
| Google-CloudVertexBot | 검색용(사이트 소유자 요청) | 사이트 소유자가 Vertex AI Agents를 구축한 사이트를 크롤링 | 준수 | 역방향 DNS 또는 common-crawlers.json | Google 일반 크롤러 | |
| Google-Agent | 사용자 요청형 에이전트 | 사용자 요청에 따라 Google 인프라에서 웹을 탐색하고 작업을 수행하는 에이전트 | 일반적으로 무시(사용자 요청형) | user-triggered-agents.json, 일부 요청은 Web Bot Auth로 서명 | Google 사용자 요청형 페처 | |
| Google-GeminiNotebook | 사용자 요청형 | 사용자가 Gemini Notebook에 소스로 추가한 URL을 가져옴(이전 에이전트 Google-NotebookLM은 2026년 8월까지 지원) | 일반적으로 무시(사용자 요청형) | 사용자 요청형 페처 JSON 목록 | Google 사용자 요청형 페처 | |
| Bingbot | Microsoft | 검색용 | Copilot 답변의 근거로도 쓰이는 Bing 인덱스 | 준수, AI 활용은 페이지 단위 noarchive/nocache로 제어 | bingbot.json 또는 Bing의 Verify Bingbot 도구 | Bing Webmaster 블로그 |
| Applebot | Apple | 검색용(학습에도 쓰일 수 있음) | Spotlight, Siri, Safari 검색. 데이터가 Apple 모델 학습에 쓰일 수도 있음 | 준수, Applebot이 명시되지 않으면 Googlebot 규칙을 따름, Crawl-delay 무시 | 역방향 DNS(*.applebot.apple.com) 또는 applebot.json | Applebot 정보 |
| Applebot-Extended | Apple | 제어용 토큰 | Apple 파운데이션 모델 학습에서 콘텐츠를 제외 | 토큰 전용 | 해당 없음 | Applebot 정보 |
| Meta-ExternalAgent | Meta | 학습용 | 파운데이션 AI 모델 학습 또는 콘텐츠 직접 인덱싱 | 준수 | 사용자 에이전트 + Meta가 공개한 IP | Meta 웹 크롤러 |
| Meta-WebIndexer | Meta | 검색용 | Meta AI가 나를 인용하고 링크할 수 있도록 Meta AI 검색 결과 개선 | 준수 | 사용자 에이전트 + Meta가 공개한 IP | Meta 웹 크롤러 |
| Meta-ExternalFetcher | Meta | 사용자 요청형 | 에이전트 작업을 포함해 사용자 요청에 따라 링크를 가져옴 | 우회할 수 있음 | 사용자 에이전트 + Meta가 공개한 IP | Meta 웹 크롤러 |
| Amazonbot | Amazon | 학습용 | Amazon 제품 개선, Amazon AI 모델 학습에 쓰일 수 있음 | 준수(RFC 9309), Crawl-delay 무시 | 공개 IP 페이지 | Amazonbot |
| Amzn-SearchBot | Amazon | 검색용 | Alexa 같은 검색 경험, 학습용 아님 | 준수, 명시되지 않으면 다른 검색 봇에 준 규칙을 따름 | 공개 IP 페이지 | Amazonbot |
| Amzn-User | Amazon | 사용자 요청형 | Alexa 질문에 필요한 실시간 정보를 가져옴, 학습용 아님 | 모든 지시를 따르지는 않을 수 있음 | 공개 IP 페이지 | Amazonbot |
| MistralAI-Training | Mistral | 학습용 | Mistral 모델 학습용 데이터셋 구축 | 준수, 거부 가능 | 사용자 에이전트 | Mistral 크롤러 |
| MistralAI-Index | Mistral | 검색용 | Vibe의 Mistral 검색을 위해 콘텐츠 인덱싱, 학습용 아님 | 준수 | mistralai-index-ips.json | Mistral 크롤러 |
| MistralAI-User | Mistral | 사용자 요청형 | Vibe 사용자가 질문할 때 페이지 방문 | 준수, 사용자 요청이 접근할 수 있는 사이트를 결정 | mistralai-user-ips.json | Mistral 크롤러 |
| DuckAssistBot | DuckDuckGo | 검색용(실시간) | DuckDuckGo의 AI 지원 답변을 위해 페이지 크롤링, 학습용 아님 | 준수, 72시간 후 반영 | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | 학습용(공개 데이터셋) | 모델 학습에 널리 쓰이는 공개 Common Crawl 코퍼스 구축 | 준수 | 역방향 DNS(*.crawl.commoncrawl.org, IPv4 전용) | CCBot |
이 표로 정리되는 두 가지가 있어요. 첫째, Anthropic의 현재 페이지에 올라 있는 봇은 ClaudeBot, Claude-SearchBot, Claude-User 딱 세 개예요. 오래된 목록에는 아직 "anthropic-ai"와 "Claude-Web"이 남아 있지만, 2026년 10월 기준 Anthropic 문서에는 등장하지 않아요. 둘째, OpenAI의 버전 번호는 계속 바뀌어요. 저희가 확인한 날 OpenAI의 예시 문자열은 GPTBot/1.4와 OAI-SearchBot/1.4였어요. 그러니 전체 문자열이 아니라 반드시 토큰으로 매칭하세요.
공식 문서가 없는 봇
로그에 보이는 봇 중에는 2026년 10월 18일 기준으로 운영사 페이지를 찾을 수 없는 것도 있어요. 가장 잘 알려진 건 ByteDance의 Bytespider이고, xAI의 Grok 관련 에이전트도 그래요. 서드파티 디렉터리마다 이들의 동작에 대한 설명이 엇갈려서, 검증된 표에서는 뺐어요. Cloudflare의 관리형 robots.txt에는 Bytespider 거부 규칙이 들어 있고, Cloudflare는 2024년 중반부터 2025년 중반 사이 AI 크롤링에서 Bytespider가 차지하는 비중이 14.1%에서 2.4%로 줄었다고 보고했어요. 이런 봇 중 하나가 신경 쓰인다면 robots.txt에 기대지 말고 WAF 규칙으로 정책을 강제하세요.
AI 크롤러는 robots.txt를 지킬까요?
공식 문서가 있는 학습용·검색용 크롤러는 지킨다고 말하고, 사용자 요청형 페처는 지키지 않는다고 말하는 경우가 많아요. 그리고 robots.txt는 결코 접근 통제 수단이 아니에요. 표준 문서인 RFC 9309 자체가 "이 규칙은 접근 권한 부여의 한 형태가 아니다"라고 밝히고 있어요. 또 크롤러가 이 파일을 최대 24시간까지 캐시하는 것도 허용하는데, 그래서 운영사마다 변경이 반영되기까지 걸리는 시간을 따로 안내하는 거예요.
준수한다는 주장과 실제 동작은 다를 수 있어요. 2025년 8월 Cloudflare는 모든 크롤링을 거부한 신규 도메인들을 Perplexity가 여전히 자세히 설명해 냈다는 테스트 결과를 발표했어요. Cloudflare는 신원을 밝힌 Perplexity-User 에이전트가 하루 2,000만~2,500만 건, 신원을 밝히지 않은 Chrome 유사 에이전트가 하루 300만~600만 건의 요청을 보내는 것을 관찰했다고 밝혔고, 이후 Perplexity를 검증된 봇 목록에서 제외했어요. 한 업체가 한 운영사에 대해 내놓은 결과이긴 하지만, 사용자 에이전트 문자열 하나만으로는 아무것도 증명되지 않는다는 걸 잘 보여 주죠.
| 운영사 | robots.txt 변경 반영까지 걸리는 시간(문서 기준) | Crawl-delay |
|---|---|---|
| OpenAI(OAI-SearchBot) | 약 24시간 | 명시 없음 |
| Perplexity | 최대 24시간 | 명시 없음 |
| Amazon | 약 24시간, 최대 30일 지난 캐시 사본을 쓸 수 있음 | 지원 안 함 |
| Meta | 최대 24시간 | 명시 없음 |
| DuckDuckGo(DuckAssistBot) | 72시간 | 명시 없음 |
| Anthropic | 명시 없음 | 지원 |
| Apple | 명시 없음 | 지원 안 함 |
AI 크롤러 유형별로 차단하면 무엇을 잃을까요?
학습용 크롤러를 차단해도 지금 당장의 노출에는 손해가 거의 없어요. 반면 검색 크롤러나 사용자 요청형 페처를 차단하면 곧바로 인용을 잃어요. 아래 표는 유형별로 운영사들이 직접 설명하는 대가를 정리한 거예요.
| 차단 대상 | 빠지게 되는 곳 | 잃는 것 | 여전히 노출되는 곳 |
|---|---|---|---|
| 학습용 크롤러(GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | 해당 운영사의 향후 학습 데이터셋 | 단기 노출 손실은 적음. 다만 향후 모델이 검색 없이도 내 브랜드를 얼마나 잘 "알고" 있을지는 영향받을 수 있음 | 각 검색 봇을 허용하는 한 ChatGPT 검색, Claude 검색, Perplexity, Google 검색과 AI Overviews |
| AI 검색 크롤러(OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | 해당 엔진의 검색 인덱스 | 해당 엔진 답변 속 인용과 링크. OpenAI는 탐색용 링크만 유지 | 함께 차단하지 않는 한 전통적인 검색엔진 |
| 사용자 요청형 페처(ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | 운영사가 차단을 존중하는 경우, 사용자가 요청한 실시간 페치 | 사용자가 내 URL을 붙여 넣거나 그에 대해 물었을 때의 답변, 결제나 예약 같은 에이전트 작업 | 검색 봇을 허용했다면 인덱스 기반 답변 |
| Googlebot | Google 검색 전체 | 자연 검색 순위, AI Overviews, AI Mode 모두 | Google에서는 아무 데도 없음. 원하는 결과일 가능성은 거의 없음 |
주고받는 규모도 중요해요. Cloudflare는 AI 플랫폼이 방문자 한 명을 되돌려 보낼 때마다 페이지를 몇 번 크롤링하는지 측정했어요. 2025년 7월 기준 Anthropic은 유입 방문자 1명당 약 38,000회, Perplexity는 194회였어요. 이 비율이 바로 퍼블리셔들이 검색 크롤러는 열어 두고 학습용 크롤러는 막자고 주장하는 경제적 근거예요.
어떤 AI 크롤러를 허용하고 어떤 걸 차단할까요? 비즈니스 목표별 판단 매트릭스
무엇을 파는지부터 생각하세요. AI 어시스턴트의 추천이 고객 확보로 이어질 수 있다면 모든 검색 크롤러와 사용자 요청형 페처를 허용하고, 학습 여부는 별개의 더 작은 결정으로 다루세요.
| 내 상황 | 학습용 크롤러 | 검색 크롤러 | 사용자 요청형 페처 및 에이전트 | 이유 |
|---|---|---|---|---|
| B2B SaaS, 에이전시, 지역 서비스 | 허용(차단해도 손해는 적음) | 허용 | 허용 | 구매자가 AI 답변에서 업체 후보를 추리고, 모델 지식에 들어가 있으면 질문받지 않아도 언급될 가능성이 높아짐 |
| 이커머스 | 자유롭게 결정 | 허용 | 허용, WAF에서 서명된 에이전트를 허용 목록에 추가 | 쇼핑 답변이 상품 페이지를 인용하고, 에이전트가 장바구니와 결제 단계까지 접근해야 함 |
| 뉴스 및 광고 수익형 퍼블리셔 | 차단 | 허용, 또는 광고 페이지에서 차단 | 운영사별로 결정 | 콘텐츠가 곧 상품이지만, 인용을 통해 일부 독자가 돌아옴 |
| 개발자 문서 및 오픈소스 프로젝트 | 허용 | 허용 | 허용 | 개발자가 어시스턴트에게 API 사용법을 물어보고, 정확한 모델 지식이 지원 부담을 줄여 줌 |
| 유료 구독 또는 라이선스 콘텐츠 | 차단 | 인덱스 페이지만 허용 | 라이선스상 필요하면 WAF로 차단 | 미리보기는 인용 가능하게, 전문은 비공개로 |
| 스테이징, 인트라넷, 비공개 앱 | 차단 | 차단 | 차단 | 인증을 쓰세요. robots.txt는 요청일 뿐 자물쇠가 아님 |
| 크롤링 부하가 큰 서버 | 속도 제한 또는 차단 | 허용, CDN에서 속도 제한 | 허용 | 인용을 잃지 말고 엣지에서 부하를 해결 |
robots.txt에서 AI 학습용 크롤러는 막고 AI 검색은 허용하려면?
학습용 토큰마다 Disallow: /를 넣은 그룹을 만들고, 검색 크롤러는 평소 규칙이 적용되도록 그대로 두세요. 크롤러는 자신을 지정한 그룹 중 가장 구체적인 그룹만 따르기 때문에, 학습용 차단 규칙이 검색 봇으로 번지지 않아요.
스니펫 1: 학습은 차단하고 AI 검색과 사용자 요청형 페처는 유지
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309에서는 여러 User-agent 줄이 하나의 그룹을 공유할 수 있고, 매칭할 때 대소문자를 구분하지 않아요. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot, Bingbot은 * 그룹으로 넘어가서 계속 허용돼요.
스니펫 2: AI 검색에 명시적으로 문 열어 두기
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
검색 봇을 명시적으로 지정해 두면, 나중에 다른 사람이 쓴 일괄 규칙으로부터 보호받을 수 있어요. 예를 들어 어떤 플러그인이 User-agent: *와 Disallow: /를 추가하는 경우죠. 비공개 경로는 그룹 안에서도 계속 거부해 두세요. 이름을 지정한 그룹은 해당 봇에 대해 * 그룹에 더해지는 게 아니라 그것을 대체하거든요.
스니펫 3: 실제 파일을 망가뜨리는 세 가지 함정
- Applebot은 Googlebot 규칙을 물려받아요. Apple에 따르면 파일에 Applebot은 없고 Googlebot만 있으면 Applebot은 Googlebot 그룹을 따라요. Googlebot 전용 차단 규칙 때문에 나도 모르게 Siri와 Spotlight에서 빠질 수 있어요.
- Amzn-SearchBot은 이름이 지정되지 않으면 다른 검색 봇의 규칙을 물려받아요. Amazon의 설명이에요. 다른 결과를 원한다면 이름을 지정하세요.
- 서브도메인에는 별도 파일이 필요해요. Anthropic과 Amazon 모두 robots.txt를 호스트별로 읽는다고 밝혔으니,
docs.example.com에도 별도의 파일이 있어야 해요.
이런 그룹은 AI Rank Lab의 무료 robots.txt 생성기로 만들고 점검할 수 있어요. 전체 허용과 선택적 허용 설정을 더 자세히 알고 싶다면 이전에 정리한 AI 크롤러용 robots.txt 템플릿을 참고하세요.
AI 크롤러가 진짜인지, 위장한 건지 어떻게 검증할까요?
사용자 에이전트만 믿으면 절대 안 돼요. 누구든 헤더에 "GPTBot"이라고 적어 보낼 수 있고, Common Crawl도 자기 페이지에서 CCBot을 사칭하는 크롤러가 있다고 경고하고 있어요. 운영사들이 지원하는 검증 방법은 세 가지이고, 어떤 방법을 쓸지는 운영사에 따라 달라요.
- 역방향 DNS 조회 후 정방향 DNS 조회. 로그에 있는 IP로
host를 실행해 호스트 이름이 운영사 도메인으로 끝나는지 확인하고, 다시 그 호스트 이름으로host를 실행해 같은 IP가 나오는지 확인하세요. Google은 검증 가이드에서googlebot.com,google.com,googleusercontent.com에 대해 이 방법을 안내하고 있어요. Apple은*.applebot.apple.com, Common Crawl은*.crawl.commoncrawl.org(IPv4 전용)를 써요. - IP를 운영사가 공개한 목록과 대조. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral, Amazon이 IP 대역을 공개하고 있어요. 역방향 DNS 패턴을 문서화하지 않은 OpenAI, Anthropic, Perplexity는 이 방법이 유일해요.
- 암호화 서명 확인(Web Bot Auth). OpenAI의 ChatGPT Cloud browser는 요청에 서명해요. RFC 9421에 따라
Signature-Agent헤더 값으로"https://chatgpt.com"을 써요. Google도 일부 Google-Agent 요청에 같은 IETF 초안을 시험 적용하고 있고, 서명은https://agent.bot.goog로 표시돼요. Google의 Web Bot Auth 페이지는 모든 요청이 서명되는 건 아니니 IP 확인을 예비 수단으로 유지하라고 안내해요.
# Reverse then forward lookup (Google example)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# IP-list check for OpenAI's search crawler
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
공개된 IP 목록은 얼마나 최신일까요?
저희는 2026년 10월 18일에 공개된 AI 크롤러 IP 파일을 모두 내려받아, 운영사가 파일 안에 적어 둔 creationTime 필드를 확인했어요. 날짜가 오래됐다고 해서 단순히 대역이 바뀌지 않았다는 뜻일 수도 있지만, 하드코딩한 허용 목록을 얼마나 믿어도 될지는 알려 주죠. 또 운영사가 신고하지 않은 트래픽은 어떤 목록으로도 설명할 수 없다는 점도 보여 줘요.
| 공개 목록 | 파일 내 creationTime | IPv4 / IPv6 프리픽스 |
|---|---|---|
| Google 일반 크롤러(Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Google 사용자 요청형 에이전트(Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic(봇 3개 모두, 단일 목록) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
여기서 얻을 수 있는 실전 교훈은 두 가지예요. Google 목록과 OpenAI의 ChatGPT-User 목록은 최근 2주 안에 바뀌었어요. 여름에 복사해 둔 방화벽 허용 목록이라면 이미 틀렸을 가능성이 높으니, 이 파일들을 매일 또는 매주 다시 가져오세요. 그리고 Anthropic은 자사 IP를 차단하면 robots.txt를 읽을 수 없게 되기 때문에 "제대로 작동하지 않거나 거부 상태를 지속적으로 보장하지 못할 수 있다"고 밝혔어요. 거부 의사는 robots.txt로 표시하고, IP는 검증에만 쓰세요.
AI 크롤러 활동은 어디서 봐야 할까요? 서버 로그 vs 자바스크립트 태그
크롤러는 서버 로그나 CDN 로그로, AI 어시스턴트를 통해 들어온 사람 방문자는 자바스크립트 분석 도구로 보세요. JS 태그는 무언가가 페이지의 자바스크립트를 실행할 때만 작동하는데, 대부분의 AI 크롤러는 실행하지 않아요. Vercel이 자사 네트워크를 분석한 결과 주요 AI 크롤러 중 자바스크립트를 렌더링하는 곳은 하나도 없었어요. ChatGPT와 Claude의 크롤러는 JS 파일을 가져가긴 했지만(각각 요청의 11.50%와 23.84%) 실행하지는 않았어요. 예외는 Googlebot의 렌더링을 쓰는 Gemini와 Applebot이었어요. 2024년 12월 연구이니 내 사이트에서 다시 테스트해 보는 게 좋지만, 저희가 보는 현상과도 일치해요.
Google Analytics는 설계상 이 격차를 더 벌려요. GA4는 알려진 봇과 스파이더의 트래픽을 자동으로 제외하고, 이 기능은 끌 수도 없고 얼마나 제외됐는지 볼 수도 없어요. GA4는 AI 유입 트래픽을 보기에는 딱 맞는 도구이고(GA4에서 AI 유입 트래픽을 추적하는 방법에서 다뤘어요), 크롤러 수를 세기에는 맞지 않는 도구예요.
AI Rank Lab의 자체 추적 데이터에서도 같은 패턴이 보여요. 저희 자바스크립트 태그는 ChatGPT, Gemini, Perplexity, Claude에서 클릭해 들어온 사람은 안정적으로 기록하지만, 크롤러 트래픽은 작고 대표성 없는 일부만 보여요. 그래서 이 데이터로는 크롤러 수를 공개하지 않아요.
5분이면 끝나는 로그 점검
- 호스팅이나 CDN에서 하루치 원본 접속 로그를 내려받으세요(Nginx와 Apache 모두 기본 combined 형식에 사용자 에이전트를 기록해요).
- AI 토큰별 요청 수를 세세요:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - 상위 토큰의 상태 코드를 확인하세요. 403이나 429가 잔뜩 찍혀 있다면 보통 robots.txt에서 허용한 봇을 WAF나 CDN 규칙이 막고 있다는 뜻이에요.
- 어떤 수치든 믿기 전에 위의 방법으로 IP 샘플을 검증하세요.
- 검색 봇이 어떤 URL을 요청하는지 확인하세요. OAI-SearchBot이나 Claude-SearchBot이 홈페이지만 가져간다면 내부 링크와 사이트맵을 살펴보세요.
AI 크롤러 활동을 보여 주는 도구
공개: AI Rank Lab은 저희 제품이에요. 저희 사이트라서 가장 먼저 소개하지만, 아래 모든 도구에 같은 기준을 적용했어요.
- AI Rank Lab - AI 봇 추적 기능이 AI 어시스턴트 유입과 태그로 볼 수 있는 AI 봇 방문을 페이지별로, AI 가시성 및 인용 추적 데이터와 나란히 기록해요. 앞서 설명한 이유로, 크롤러 수를 빠짐없이 보려면 로그와 함께 쓰세요.
- Cloudflare AI Crawl Control - 사이트가 Cloudflare 프록시를 거친다면 가장 완전한 크롤러 현황을 볼 수 있어요. 자바스크립트를 전혀 실행하지 않는 봇을 포함해 엣지에서 모든 요청을 보기 때문이에요. 크롤러별 robots.txt 준수 여부도 보여 줘요.
- 로그 파일 분석기 - Screaming Frog의 Log File Analyser나 GoAccess 같은 도구로, 어떤 호스팅의 원본 로그든 분석할 수 있고 일회성 점검에 강해요.
- 원본 로그 + 위의 grep - 무료이고 정확하며, 다른 모든 도구가 맞춰야 할 기준값이에요.
가장 큰 세 봇을 중심으로 한 더 깊이 있는 모니터링 루틴은 GPTBot, ClaudeBot, PerplexityBot 모니터링 가이드를 참고하세요.
Cloudflare 같은 CDN은 AI 봇을 어떻게 제어할까요?
CDN은 robots.txt가 요청만 할 수 있는 것을 네트워크 엣지에서 강제해요. 모든 요금제에서 쓸 수 있는 Cloudflare의 AI Crawl Control은 어떤 AI 서비스가 내 사이트에 접근하는지 보여 주고, 크롤러별로 허용하거나 차단할 수 있게 해 주며, robots.txt 위반을 추적하고, 비공개 베타로 크롤링당 과금(pay per crawl)도 제공해요.
Cloudflare의 AI 봇 정책도 이제 이 글과 같은 세 갈래 구분을 써요. Block AI Bots 설정에는 Search, Agent, Training 프리셋이 따로 있고, 각각 "모든 페이지에서 차단", "광고가 있는 페이지에서 차단", "허용" 중에서 고를 수 있어요. 문서에 따르면 2026년 9월 15일부터 새 도메인에는 바뀐 기본값이 적용돼요. 광고를 보여 주는 페이지에서는 Training 봇과 Agent 봇을 차단하고, Search는 허용하며, 검색과 학습을 겸하는 혼합형 크롤러는 학습 차단이 하나라도 있으면 차단돼요. 그 이후에 사이트를 Cloudflare에 올렸는데 블로그에서 ChatGPT-User나 Claude-User가 403을 받는다면, 이 설정부터 확인하세요.
Cloudflare는 robots.txt 관리도 대신해 줄 수 있어요. Bot Preference Sync를 켜면 관리형 robots.txt가 기존 규칙 앞에 Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot, meta-externalagent에 대한 거부 그룹과 Content Signals 줄(search=yes, ai-train=no)을 붙여 줘요. Content Signals는 Cloudflare가 제안한 어휘(search, ai-input, ai-train)로, 콘텐츠를 가져간 뒤 어떻게 써도 되는지를 밝히는 것이에요. 이를 존중할지는 각 운영사의 몫이고요.
다른 업체들도 같은 방식을 지원해요. Perplexity 문서에는 자사 IP 목록을 활용한 Cloudflare 및 AWS WAF 설정 안내가 있고, OpenAI 고객센터에는 서명된 Cloud browser를 Akamai(봇 이름 "ChatGPT Agent")와 Cloudflare(탐지 ID 129220581)에서 허용 목록에 넣는 방법이 나와 있어요. 어떤 CDN을 쓰든 순서는 같아요. 유형별로 결정하고, robots.txt로 표현하고, 확실한 차단이 필요한 곳에서만 엣지에서 강제하고, CDN 설정을 바꾼 뒤에는 로그를 다시 확인하세요.
Google과 Bing: 따로 봐야 하는 두 가지 경우
Google-Extended를 차단하면 Google 검색이나 AI Overviews에 영향이 있을까요?
없어요. Google은 Google-Extended가 "사이트의 Google 검색 포함 여부에 영향을 주지 않으며 순위 신호로도 사용되지 않는다"고 밝혔어요. AI 기능 관련 문서도 AI Overviews와 AI Mode를 포함한 검색은 Googlebot에 대한 robots.txt 규칙으로 제어하고, 노출되는 내용은 nosnippet, data-nosnippet, max-snippet, noindex로 제한한다고 분명히 적고 있어요. Google-Extended가 다루는 건 Gemini 모델 학습과 Gemini 앱 및 Vertex AI의 그라운딩으로, 검색과는 별개예요.
Microsoft Copilot이 내 콘텐츠를 쓰는지는 어떻게 제어할까요?
Microsoft에는 별도의 AI 크롤러 토큰이 없어요. 크롤링은 Bingbot이 하고, AI 활용 여부는 페이지 단위 robots 메타 태그로 제어해요. 저희가 찾은 가장 최근의 공식 안내는 Copilot이 아직 Bing Chat으로 불리던 2023년에 Bing 팀이 낸 발표예요. noarchive 태그가 달린 콘텐츠는 Bing의 채팅 답변에 포함되거나 링크되지 않고 Microsoft의 파운데이션 모델 학습에도 쓰이지 않아요. nocache 태그가 달린 콘텐츠는 URL, 제목, 스니펫만 노출될 수 있고, 둘 다 없으면 전부 활용될 수 있어요. 두 태그 모두 일반 Bing 검색 결과에는 그대로 남아요. robots.txt에서 Bingbot을 차단하면 Bing 검색에서도 사라지니, 메타 태그를 쓰세요.
한계와 확인 방법
저희는 2026년 10월 18일에 위에 나열한 각 운영사의 크롤러 페이지를 읽고, 공개된 IP 목록을 모두 내려받아 파일마다 들어 있는 creationTime을 기록했어요. 자바스크립트로만 렌더링되는 Microsoft의 크롤러 도움말 페이지는 열 수 없어서, Bingbot 항목은 Microsoft의 Bing Webmaster 블로그, Verify Bingbot 도구, 공개된 bingbot.json을 근거로 했어요. robots.txt 열은 저희가 직접 측정한 결과가 아니라 각 운영사의 설명을 요약한 것이에요. 둘이 다를 수 있다는 대표적인 공개 증거가 Cloudflare의 Perplexity 관련 결과예요. 운영사들은 봇 이름을 자주 바꾸고 새로 추가하기 때문에(예를 들어 Google은 Google-NotebookLM 페처 토큰을 Google-GeminiNotebook으로 교체했어요), 이 글을 포함한 어떤 목록이든 확인한 날짜 기준으로만 정확하다고 보세요.
내 크롤러 정책이 실제로 인용으로 이어지고 있는지 확인하고 싶다면, AI Rank Lab이 ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews, AI Mode 전반에서 내 브랜드 언급과 인용된 페이지를, 그 답변들이 보내 주는 AI 유입 트래픽과 함께 추적해 드려요.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


