



Поиск в ChatGPT устроен в пять шагов: модель решает, нужна ли для вашего вопроса свежая информация, переписывает вопрос в один или несколько поисковых запросов, собирает страницы-кандидаты из собственного индекса и кэша OpenAI и у партнёрских поисковых провайдеров, ранжирует найденное и пишет ответ со ссылками на использованные страницы. Каждый из этих элементов OpenAI описала в своей документации. А вот какой вес у каждого источника, компания не раскрывает, и именно отсюда берётся большая часть путаницы (и почти все домыслы).
В этом гайде мы отделяем то, что OpenAI подтвердила в собственных документах, от того, что исследователи выяснили методом обратной разработки, разбираем четыре user agent OpenAI и то, за что отвечает каждый, и даём чек-лист: на что владелец сайта может повлиять, а на что нет. Здесь же — что показывают наши собственные данные о реферальном трафике из ChatGPT, включая сбой с UTM-метками 8–16 октября 2026 года. Все источники проверены 18 октября 2026 года.
Главное
- Подтверждено: ChatGPT опирается на собственный «проиндексированный и кэшированный веб-контент» OpenAI, а также на сторонних поисковых провайдеров и контент партнёров. Среди провайдеров, которым могут уходить переписанные запросы, OpenAI называет Microsoft и Shopify.
- Не раскрывается: пропорция. Сведения о внутреннем индексе под названием «Labrador» и о тестах, где его сравнивают с внешней выдачей, взяты из сторонних исследований, а не от OpenAI.
- Для поиска решает OAI-SearchBot. Заблокируете его — и ваши страницы перестанут появляться в ответах поиска ChatGPT. Блокировка GPTBot лишь исключает ваш контент из обучения моделей.
- Цитирование нестабильно. По нашим замерам, лишь медианные 7,7 % доменов, которые ChatGPT цитировал по промпту, встречались в каждом прогоне этого промпта.
- Считайте по UTM, а не по реферу. 39 % просмотров страниц с меткой ChatGPT, которые зафиксировал наш тег, пришли вообще без реферера.
Как читать эту статью: подтверждено или «сообщается»
У каждого утверждения ниже одна из трёх пометок. В разговорах о поиске ChatGPT факты и догадки постоянно смешивают, и вредные советы распространяются именно так:
- Подтверждено — сказано самой OpenAI в справочном центре, документации для разработчиков, release notes или анонсах.
- Сообщается — сторонние исследования, разбор сетевого трафика ChatGPT, показания в суде в пересказе журналистов или слова из вторых рук. Часто заслуживает доверия, но официальным не является.
- Наши данные — агрегированные анонимизированные цифры из трекинга промптов и JavaScript-тега AI Rank Lab; рядом с каждой цифрой указаны метод и размер выборки.
Как работает поиск в ChatGPT по шагам?
Если коротко, это конвейер извлечения (retrieval): решение искать, переписывание запроса, сбор из нескольких источников, ранжирование и, наконец, готовый ответ с цитатами. Ниже каждый шаг с уровнем доказательности.
- Решить, нужен ли поиск. Подтверждено: согласно справочной статье OpenAI Searching the web with ChatGPT, ChatGPT может искать автоматически, если вопросу пойдёт на пользу актуальная информация. Поиск можно и включить принудительно: выбрать Search в меню инструментов или набрать «/» в поле ввода. Сообщается: обратная разработка RESONEO от февраля 2026 года описывает классификатор, который оценивает каждый промпт и запускает поиск при превышении порога.
- Переписать промпт в поисковые запросы. Подтверждено: когда ChatGPT обращается к партнёрским поисковым провайдерам, он обычно переписывает ваш вопрос в один или несколько точечных запросов, может отправить более конкретные уточняющие запросы после чтения первых результатов, может добавить примерное местоположение, определённое по вашему IP-адресу (но не сам IP), и может учитывать сохранённые воспоминания (memory) при переписывании. Это и есть query fan-out — подробно мы разбираем его в нашем гайде по query fan-out.
- Собрать страницы-кандидаты. Подтверждено: результаты приходят от сторонних поисковых провайдеров, из контента, который партнёры передают напрямую, и из собственного проиндексированного и кэшированного веб-контента OpenAI. Сообщается: конкретные провайдеры и их доля (см. следующий раздел).
- Отранжировать кандидатов. Подтверждено: OpenAI говорит, что ChatGPT ранжирует результаты по множеству факторов, чтобы показывать релевантную и надёжную информацию, и что место в выдаче не гарантировано. Сами факторы не опубликованы. Сообщается: RESONEO описывает, как результаты нескольких движков объединяются методом Reciprocal Rank Fusion — стандартным приёмом слияния ранжированных списков.
- Написать ответ и процитировать источники. Подтверждено: ответы с поиском могут содержать встроенные цитаты, кнопку Sources со списком процитированных источников и других релевантных ссылок, ссылки на источники изображений, а на мобильных — карты. Модель, которая пишет ответ, со временем менялась: на запуске в 2024 году это была дообученная GPT-4o, а с релиза 7 октября 2026 года чат ChatGPT работает на GPT-6 (Sol на платных тарифах, Luna на Free и Go) с новым «Intelligent UI», который умеет отвечать графиками, сравнениями и интерактивными элементами.
Когда ChatGPT ищет в интернете, а когда отвечает по памяти?
ChatGPT идёт в поиск, когда считает, что вопросу нужна свежая или конкретная информация: новости, цены, счёт матчей, локальные результаты, всё недавнее. В остальных случаях он отвечает по обучающим данным. Это решение можно переиграть: вручную выбрать Search или просто попросить ChatGPT поискать в интернете.
Как часто это происходит на практике? Сообщается: исследование Profound по англоязычным диалогам ChatGPT в США (с октября по декабрь 2025 года; около 730 000 диалогов содержали хотя бы одну веб-цитату) показало, что примерно 18 % диалогов запускали хотя бы один веб-поиск, а вероятность ответа с цитатами падает по ходу разговора: цитаты были у 12,6 % первых реплик против 4,5 % к десятой.
Отсюда два практических вывода. Во-первых, если ChatGPT не ищет, то никакие сегодняшние правки на сайте на этот ответ не повлияют: он берётся из обучающих данных, а это как раз зона GPTBot. Во-вторых, именно на первом вопросе в диалоге поиск, а значит и цитирование, наиболее вероятны.
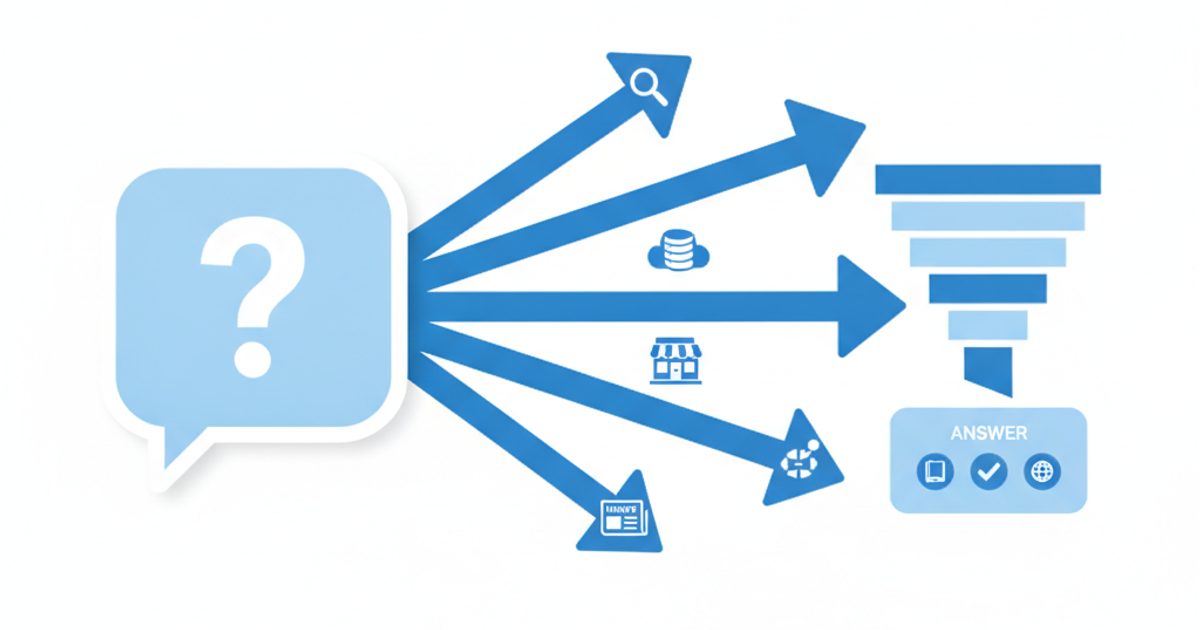
Откуда берутся результаты поиска ChatGPT?
Результаты поиска ChatGPT собираются из собственного индекса и кэша OpenAI, у сторонних поисковых провайдеров и из лицензированных или партнёрских данных. Что все три источника существуют, OpenAI подтвердила. Как часто используется каждый, компания не раскрывает, и для новостных, товарных, локальных и общих запросов эта доля, скорее всего, разная.
Что подтвердила OpenAI
- Сторонние провайдеры и партнёрский контент. В анонсе запуска от 31 октября 2024 года сказано, что поиск ChatGPT использует сторонних поисковых провайдеров плюс контент, который партнёры передают напрямую; за погодой, акциями, спортом, новостями и картами стоят новостные партнёры и поставщики данных.
- Названные провайдеры. Текущая справочная статья отсылает пользователей к политикам конфиденциальности Microsoft и Shopify как поисковых провайдеров, которым могут уходить переписанные запросы. Для бронирования ресторанов показывается доступность из OpenTable, Resy и Yelp.
- Собственный индекс и кэш OpenAI. Справочная статья OpenAI об офлайн-веб-поиске для рабочих пространств ChatGPT описывает режим, в котором ChatGPT ищет по «проиндексированному и кэшированному веб-контенту OpenAI», а не обращается к живому провайдеру. Там же уточняется, что обновление конкретного URL не гарантируется, а охват зависит от сайта, языка, региона и типа контента.
Есть ли у ChatGPT собственный поисковый индекс?
Да. В документации OpenAI описаны индекс и кэш, которые компания поддерживает сама, а наполняет их отдельный поисковый краулер OAI-SearchBot. Не подтверждено другое: какая часть повседневного пользовательского поиска в ChatGPT обслуживается из этого индекса, а какая — внешними провайдерами.
Лучшие публичные данные на этот счёт — сторонние:
- Сообщается: в апреле 2025 года на антимонопольном процессе о мерах в отношении поиска Google Ник Терли (Nick Turley), руководитель продукта ChatGPT в OpenAI, дал показания, что OpenAI строит собственный индекс, что полностью опереться на него, скорее всего, удастся лишь через годы и что Google отклонила запрос OpenAI 2024 года на доступ к поисковому API (Tech Policy Press).
- Сообщается: анализ Peec AI от сентября 2026 года обнаружил в server-sent events ChatGPT с 21 мая по 21 июля 2026 года поле
result_sourceс четырьмя значениями: Labrador, Bright, Oxylabs и SERP. Peec трактует Labrador как семейство вертикальных индексов OpenAI (веб, PDF, YouTube, новости, Wikipedia, arXiv, локальный поиск, финансы, право, медицина, товары, изображения), а остальные три — как внешние каналы парсинга. Как часто встречалось каждое значение, Peec не сообщает. - Сообщается: Peec и Otterly AI описывают эксперимент под названием
prefer-index-over-serp-v3, который, судя по всему, сравнивает индекс OpenAI со сторонней выдачей; по оценке Otterly, в августе 2026 года он охватывал около 8 % диалогов. Search Engine Watch запросил комментарий у OpenAI, но на момент публикации ответа не получил.
Поиск ChatGPT работает на Bing или на Google?
Microsoft — официально названный поисковый провайдер, Google — нет. В справочном центре OpenAI для поиска указано заявление о конфиденциальности Microsoft, а про платформу граундинга Microsoft Web IQ, анонсированную в июне 2026 года, Otterly и Peec пишут, что она работает на ChatGPT. В первоисточниках Microsoft мы этого заявления не нашли, так что считайте его неподтверждённым («сообщается»). Партнёрства с OpenAI у Google нет — так следует из показаний Терли, — однако ряд исследователей (RESONEO, Peec) сообщает, что результаты Google попадают в ChatGPT через провайдеров парсинга. OpenAI этого не подтверждала.
Практический вывод: высокие позиции в Bing или Google помогают провайдерам, которыми может пользоваться ChatGPT, найти ваши страницы, но ни те ни другие не являются надёжной заменой видимости в ChatGPT. Её нужно измерять напрямую.
| Утверждение | Статус | Источник | Дата |
|---|---|---|---|
| ChatGPT использует сторонних поисковых провайдеров и партнёрский контент | Подтверждено | Анонс запуска OpenAI | 31 окт. 2024 |
| Microsoft и Shopify — поисковые провайдеры, которым могут уходить запросы | Подтверждено | Справочный центр OpenAI | Проверено 18 окт. 2026 |
| OpenAI хранит собственный проиндексированный и кэшированный веб-контент | Подтверждено | Справочный центр OpenAI (офлайн-веб-поиск) | Проверено 18 окт. 2026 |
| OAI-SearchBot сканирует сайты, чтобы показывать их в поиске ChatGPT | Подтверждено | Документация OpenAI для разработчиков | Проверено 18 окт. 2026 |
| OpenAI строит собственный индекс; полностью опереться на него удастся через годы | Сообщается (показания в суде) | Tech Policy Press | Апр. 2025 |
| Внутреннее семейство индексов «Labrador» плюс каналы Bright, Oxylabs и SERP | Сообщается (анализ сетевого трафика) | Peec AI | Сент. 2026 |
| Эксперимент, сравнивающий индекс OpenAI с внешней выдачей (~8 % чатов) | Сообщается | Peec AI, Otterly AI | Авг.–сент. 2026 |
| Microsoft Web IQ обеспечивает граундинг ответов ChatGPT | Сообщается; мы не нашли подтверждения в источниках Microsoft | Otterly AI, Peec AI | Июнь 2026 |
| Результаты Google попадают в ChatGPT через провайдеров парсинга | Сообщается, не подтверждено | RESONEO, Peec AI | 2026 |
Чем отличаются OAI-SearchBot, GPTBot и ChatGPT-User?
OAI-SearchBot решает, можете ли вы появляться в поиске ChatGPT; GPTBot — можно ли использовать ваш контент для обучения моделей OpenAI; ChatGPT-User — это агент, который загружает страницу, когда человек просит ChatGPT её открыть. Они независимы: одного можно пустить, а другого заблокировать. В документации OpenAI по краулерам есть и четвёртый агент — OAI-AdsBot для рекламы в ChatGPT.
| User agent | Что делает (по данным OpenAI) | Что регулирует robots.txt | Список IP |
|---|---|---|---|
| OAI-SearchBot | Сканирует сайты, чтобы показывать их в поисковых функциях ChatGPT | Если запретить его, ваши страницы не будут показываться в ответах поиска ChatGPT, хотя могут по-прежнему появляться как обычные навигационные ссылки. Изменения вступают в силу примерно за 24 часа. | openai.com/searchbot.json |
| GPTBot | Сканирует контент, который может использоваться для обучения базовых моделей OpenAI | Запрет сигнализирует, что ваш контент не следует использовать для обучения. На право попасть в поиск это не влияет. | openai.com/gptbot.json |
| ChatGPT-User | Визиты по инициативе пользователя: например, человек просит ChatGPT прочитать страницу, или срабатывают GPT Actions | Правила robots.txt могут не применяться, потому что визит запустил пользователь. Для решения о включении в поиск не используется. | openai.com/chatgpt-user.json |
| OAI-AdsBot | Проверяет посадочные страницы, отправленные как реклама в ChatGPT; заходит только на них | Важен, только если вы рекламируетесь в ChatGPT. Его данные не используются для обучения базовых моделей. | openai.com/adsbot.json |
Типичная настройка для сайта, которому нужна видимость в поиске ChatGPT, но не нужно участие в обучении, выглядит так:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Две детали из документации OpenAI, которые часто упускают: если вы разрешили обоих ботов, OpenAI может использовать один обход для обеих целей, а сам запрос robots.txt может нести в строке user-agent дополнительную пометку «robots.txt». Полный набор правил для ИИ-краулеров — в нашем гайде по robots.txt для ИИ-краулеров и в бесплатном генераторе robots.txt, а как проверить в логах, что к вам ходят настоящие боты, рассказывает наш гайд по мониторингу GPTBot, ClaudeBot и PerplexityBot.
Как ChatGPT выбирает, какие источники цитировать?
OpenAI говорит лишь, что ChatGPT ранжирует результаты по множеству факторов, нацеленных на релевантность и надёжность, и что место в выдаче не гарантировано. Опубликованного списка факторов ранжирования нет, инструмента для отправки страниц тоже. Измерить можно другое — закономерности цитирования.
Сообщается: в трёхмесячном исследовании Profound ответ с цитатами опирался в среднем примерно на четыре уникальных источника, а в 66 % реплик с цитатами их было от одного до четырёх. Цитаты сильно распылены: на топ-10 доменов пришлось лишь 12 % всех цитирований, из них Wikipedia — около 5 %, Reddit — около 3 %.
Наши данные: по 11 промптам ChatGPT, которые AI Rank Lab прогнал как минимум по пять раз каждый (239 успешных прогонов, с 13 февраля по 14 октября 2026 года), медианное пересечение процитированных доменов между соседними прогонами одного промпта составило 0,54 (коэффициент Жаккара, где 1 означает полное совпадение). Лишь медианные 7,7 % доменов, процитированных ChatGPT по промпту, встречались в каждом прогоне, а 6 из 11 промптов хотя бы раз переключались между упоминанием отслеживаемого бренда и его отсутствием. Это автоматические прогоны, поэтому они могут не совпадать с персонализированными результатами залогиненного пользователя; полная методика — в нашем исследовании стабильности ответов ИИ.
Вывод: вопрос «Цитирует ли нас ChatGPT?» поставлен неверно. Полезный вопрос звучит так: «В какой доле повторных прогонов нас цитируют и по каким промптам?» Одна ручная проверка не говорит почти ни о чём.
Как отслеживать трафик из поиска ChatGPT?
Отслеживайте визиты из ChatGPT по параметру utm_source=chatgpt.com, который ChatGPT добавляет к исходящим ссылкам, а не по рефереру. Параметр описан в FAQ OpenAI для издателей (18 октября 2026 года эта страница у нас не открылась, поэтому мы опираемся на более ранние копии и на собственные наблюдения), и в реальном трафике он хорошо виден.
Наши данные: с 27 июля 2025 года по 18 октября 2026 года JavaScript-тег AI Rank Lab зафиксировал 2 710 просмотров страниц с utm_source=chatgpt.com на 29 сайтах против 2 087 просмотров с реферером chatgpt.com на 26 сайтах. Из 2 710 размеченных просмотров 1 048 (39 %) пришли вообще без реферера. Аналитика, которая смотрит только на реферер, записала бы эти визиты в Direct.
В GA4 смотрите источник сеанса, равный chatgpt.com (он подхватывает UTM), и создайте группу каналов, которая его включает. Настройка описана на странице отслеживание реферального трафика от ИИ в GA4, а трекинг ИИ-ботов фиксирует переходы от ИИ-ассистентов постранично, вообще не завися от GA4.
Что случилось с UTM-метками ChatGPT в октябре 2026 года?
Примерно неделю после запуска GPT-6 многие ссылки из ChatGPT уходили без UTM-метки, и визиты, которые раньше приписывались ChatGPT, оказались в Direct. Метки вернулись 15–16 октября. Всё, кроме даты запуска GPT-6, известно со слов третьих сторон: OpenAI публично ничего не заявляла, в release notes об этом тоже ни слова.
| Дата (2026) | Что произошло | Статус | Источник |
|---|---|---|---|
| 7–8 окт. | GPT-6 и Intelligent UI выкатываются на платные тарифы, затем на Free и Go | Подтверждено | Release notes OpenAI |
| 8 окт., ~18:30 UTC | Доля ответов с размеченными ссылками начинает снижаться с примерно 99 % | Сообщается | Profound |
| 9–13 окт. | На примерно 500 страницах визиты из ChatGPT падают на ~31 000 в день, а Direct растёт на ~26 000 в день | Сообщается | Седрик Хюслер (Cedric Huesler) из Adobe, через SEJ |
| 14 окт. | Хюслер говорит, что OpenAI назвала это известным багом | Сообщается (из вторых рук) | SEJ |
| 14 окт., ~19:00 UTC | Доля размеченных ответов падает до 5–10 %, а ответы в Intelligent UI достигают 92–96 % | Сообщается | Profound |
| 15–16 окт. | Выкатывается исправление; к 06:30 UTC 16 окт. доля размеченных ответов снова около 99 % | Сообщается | Profound, SEJ |
Источники: Search Engine Journal, 15 октября 2026 года и хронология инцидента от Profound.
Наши данные: наша выборка за этот период невелика, так что воспринимайте её как проверку на согласованность, а не как измерение. С 9 по 18 октября наш тег увидел 52 просмотра страниц с меткой ChatGPT на двух сайтах, и ни у одного не было реферера chatgpt.com. За 30 дней до этого (с 9 сентября по 8 октября) реферер был у 236 из 368 размеченных просмотров на семи сайтах (64 %). Это согласуется с сообщениями о том, что большинство кликов из ChatGPT приходят без реферера даже после возвращения меток.
Что делать: отметьте 8–16 октября в отчётах аннотацией, прежде чем списывать трафик как потерянный, сравните Direct на тех посадочных страницах, куда обычно приходит трафик из ChatGPT, и продолжайте считать по UTM, а не по рефереру.
Как сделать сайт доступным для поиска ChatGPT?
Всё сводится к тому, чтобы OAI-SearchBot мог добраться до ваших страниц и прочитать их. Справочный центр OpenAI говорит об этом прямо: разрешите OAI-SearchBot в robots.txt и убедитесь, что хостинг или CDN пропускают трафик с опубликованных IP-адресов поискового бота OpenAI. Всё остальное в этом списке повышает ваши шансы, но на саму допустимость не влияет.
- Разрешите OAI-SearchBot в robots.txt, а решение по GPTBot принимайте отдельно. Проверьте, нет ли широких правил
User-agent: *, которые блокируют его случайно. - Пропустите диапазоны IP OpenAI на уровне CDN, файрвола или защиты от ботов. Многие переключатели «блокировать ИИ-ботов» заодно режут и OAI-SearchBot. Сверьте ответы 403 и 429 в логах со списком openai.com/searchbot.json.
- Отдавайте основной контент в HTML. Среди причин, по которым индекс OpenAI может пропустить страницу, компания называет сильную зависимость от скриптов, динамическую подгрузку, логины и персонализацию. Важные страницы рендерите на сервере или пререндерите.
- Сделайте глубокие страницы легко находимыми. OpenAI также указывает на структуру сайта, которая прячет глубокие страницы. Ссылайтесь на важные страницы из хабов и держите XML-карту сайта актуальной.
- Обновляйте страницы и показывайте даты. OpenAI не даёт графика обновления по отдельным URL и говорит, что свежесть зависит от сайта, доступа для краулера, кэширования и популярности. Видимые даты «обновлено» помогают и читателям, и любой системе, которая учитывает актуальность.
- Пишите самодостаточные блоки, начиная с ответа. Это консенсус практиков, а не рекомендация OpenAI: раздел, который отвечает на свой заголовок в первом же предложении, проще процитировать. Контентную сторону разбирает наш 30-дневный план по цитированию в ChatGPT.
- Присутствуйте в данных, которые ChatGPT подтягивает для вашей ниши. Для ресторанов доступность берётся из OpenTable, Resy и Yelp; для покупок Shopify — официально названный провайдер. Если это про вас, ваши карточки на этих площадках — часть вашей видимости в ChatGPT.
- Убедитесь, что OAI-SearchBot действительно заходит. Отфильтруйте серверные логи по токену OAI-SearchBot и проверьте IP, а затем отслеживайте, какие URL ChatGPT цитирует по вашим целевым промптам.
Чтобы проверить шаги 3–5 по всему сайту, AEO-аудит обходит ваши страницы и отмечает проблемы с готовностью к SEO, к ответным движкам (AEO) и к генеративным движкам (GEO), предлагая исправления. Для второй половины шага 8 есть отслеживание цитирований: оно фиксирует, какие ваши URL ChatGPT цитирует по вашим промптам.
Почему моей страницы нет в поиске ChatGPT?
Самые частые причины — блокировка сканирования, правило CDN или файрвола, контент, который появляется только после выполнения JavaScript, и страницы новые, глубоко спрятанные или с малым числом ссылок. Именно их OpenAI перечисляет в документации по офлайн-веб-поиску как причины, по которым страниц может не быть в индексе или они там устарели. Список написан для администраторов рабочих пространств, но это единственное место, где OpenAI объясняет, почему её индекс пропускает страницы, так что он заодно служит чек-листом для диагностики.
| Причина по версии OpenAI | Как проверить | Как исправить |
|---|---|---|
| Сканирование блокирует robots.txt или похожие механизмы | Откройте /robots.txt; ищите OAI-SearchBot или общий Disallow | Разрешите OAI-SearchBot; подождите около 24 часов |
| Блокировка на стороне CDN или защиты от ботов | Найдите в логах запросы OAI-SearchBot с ответами 403, 429 или страницами-челленджами | Добавьте в allowlist диапазоны из openai.com/searchbot.json |
| Страница требует входа или персонализации | Откройте страницу в приватном окне без авторизации | Опубликуйте публичную версию ключевого контента |
| Контент зависит от скриптов или динамической подгрузки | Загрузите сырой HTML через curl и проверьте, что основной текст на месте | Серверный рендеринг или пререндер |
| Страница новая, редко посещается или даёт слабые сигналы | Проверьте дату публикации и внутренние и внешние ссылки на неё | Поставьте на неё ссылки с сильных страниц; зарабатывайте упоминания; дайте ей время |
| Структура сайта прячет глубокие страницы | Посчитайте клики от главной; проверьте карту сайта | Добавьте ссылки из хабов и держите карту сайта актуальной |
Если по всем строкам всё в порядке, а цитирований по-прежнему нет, проблема обычно в релевантности или конкуренции, а не в доступе: другая страница отвечает на промпт точнее, или ChatGPT по этому промпту вообще не ищет.
На что в поиске ChatGPT повлиять нельзя?
В ваших руках доступ и качество контента. Большая часть того, что происходит дальше, от вас не зависит. В частности, вы не управляете:
- Тем, пойдёт ли ChatGPT в поиск. Решает ChatGPT, если только пользователь не включит Search принудительно.
- Тем, какой провайдер ответит. Индекс OpenAI, Microsoft, Shopify, партнёры или каналы парсинга, о которых сообщают исследователи, — в нераскрытой пропорции, которую OpenAI, судя по всему, активно тестирует.
- Ранжированием и цитированием. Опубликованного списка факторов нет, гарантий нет, а наши данные показывают, что цитаты меняются от прогона к прогону.
- Скоростью индексации. OpenAI не документирует ни инструмента отправки URL, ни отчёта о покрытии индекса, ни гарантии обновления конкретного URL.
- Ответами из обучающих данных. Когда ChatGPT отвечает по памяти, сегодняшние правки страниц не действуют.
- Визитами ChatGPT-User. robots.txt может не применяться к загрузкам по инициативе пользователя.
- Навигационными ссылками. Даже после блокировки OAI-SearchBot ваш сайт может появляться как навигационная ссылка.
- Разметкой ссылок. Как показал октябрь 2026 года, атрибуция может сломаться без предупреждения.
Как отслеживать, какие URL цитирует ChatGPT?
Раз результаты меняются от прогона к прогону, мониторинг — это регулярные прогоны одних и тех же промптов с записью упоминаний и процитированных URL во времени. Для пары-тройки промптов это можно делать вручную в браузере без авторизации; дальше инструмент экономит время.
Раскрытие информации: AI Rank Lab — наш продукт. Мы ставим его первым, потому что это наш сайт, и применяем одни и те же критерии ко всем инструментам ниже.
- AI Rank Lab — прогоняет ваши промпты в ChatGPT, Claude, Gemini и Perplexity по расписанию, плюс Google AI Overviews (ИИ-обзоры в Google) и AI Mode, и фиксирует упоминания, позицию, конкурентов и процитированные URL. Также связывает трекинг с исправлениями через аудиты, Action Plan и публикацию контента. См. отслеживание видимости бренда.
- Profound — ориентирован на enterprise и публикует одни из крупнейших открытых датасетов по цитированию в ChatGPT, например исследование, процитированное выше.
- Peec AI — силён в исследовании механизмов, включая самый подробный публичный анализ индекса ChatGPT.
- Otterly AI — регулярно публикует GEO-эксперименты и охватывает несколько ИИ-движков.
Методология и ограничения
18 октября 2026 года мы изучили справочные статьи OpenAI о веб-поиске, офлайн-веб-поиске и release notes, документацию OpenAI по краулерам и анонс запуска 2024 года, а также проанализировали 15 ранжирующихся статей и отчётов о том, как работает поиск ChatGPT. Сторонние выводы помечены как «сообщается», потому что ни один из них OpenAI не подтвердила; некоторые исходят от компаний, которые, как и мы, продают инструменты для отслеживания видимости в ИИ. В день написания нам не удалось открыть FAQ OpenAI для издателей, а роль Microsoft Web IQ в ChatGPT мы не смогли подтвердить по первоисточникам Microsoft. Наши собственные цифры получены на небольшом числе сайтов и промптов, агрегированы и анонимизированы, а размеры выборок указаны; они описывают трафик наших клиентов, а не интернет в целом.
Хотите увидеть, какие ваши страницы ChatGPT действительно цитирует по важным для вас промптам и как это меняется от недели к неделе? Начните отслеживание с AI Rank Lab.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


