



为什么到了 2026 年,robots.txt 比以往任何时候都更重要
robots.txt 文件诞生于 1994 年,最初的用途很简单:告诉网络爬虫哪些页面不要抓。此后整整 30 年,站长们基本只需要操心一类主要爬虫——Googlebot。到了 2026 年,这份名单已经大大变长。OpenAI、Anthropic、Perplexity、Google 这些 AI 公司都在运行各自的专用爬虫,读取你的内容,用来训练模型、构建知识库、生成 AI 搜索的回答。
放行还是屏蔽这些爬虫,会直接影响你在 AI 搜索中的可见度。GPTBot 抓不到你的网站,你的内容就无法影响 ChatGPT 的回答;屏蔽了 PerplexityBot,Perplexity 就没法引用你的页面;如果 Google-Extended 被拦住,你的内容可能就不会出现在 Google 的 AI Overviews(AI 摘要)和 AI Mode(AI 模式)回答里。
要在 AI 爬虫时代把 robots.txt 配对,你得先弄清楚有哪些爬虫、它们各自做什么,以及怎样设置访问规则,既保护内容,又尽可能争取 AI 引用。本指南会把这些一一讲清楚,还附上一个免费的 robots.txt 生成器,几分钟就能生成一份适配 AI 的配置。
AI 爬虫完整名录
动手配置之前,先要知道该针对哪些爬虫。以下是截至 2026 年主要的 AI 爬虫及其 User-agent:
OpenAI - ChatGPT
- User-agent:GPTBot
- 用途:收集训练数据,以及 ChatGPT 的 Browse(联网浏览)功能
- 屏蔽后的影响:你的内容不会影响 ChatGPT 的回答,也不会出现在 ChatGPT Browse 的引用中
- 官方文档:OpenAI 公开维护了一份 GPTBot 的 IP 段列表
Anthropic - Claude
- User-agent:ClaudeBot(也会以 anthropic-ai 的标识出现)
- 用途:为 Claude AI 提供训练数据和知识库
- 屏蔽后的影响:用户询问你所在领域的问题时,你的内容不会影响 Claude 的回答
- 官方文档:Anthropic 已公布其抓取政策,并遵守 robots.txt 指令
Perplexity AI
- User-agent:PerplexityBot
- 用途:为 Perplexity AI 的回答和引用做实时网页搜索
- 屏蔽后的影响:即使你的页面高度相关,也不会被 Perplexity 的回答引用
- 官方文档:Perplexity 遵守 robots.txt,并已发布抓取指南
Google - AI 功能
- User-agent:Google-Extended
- 用途:用于 Google Bard/Gemini 训练和 AI Overviews 内容
- 屏蔽后的影响:你的内容可能不会出现在 Google 的 AI Overviews、AI Mode 或 Gemini 的回答中
- 注意:它和 Googlebot 是两回事。你可以放行 Googlebot(传统搜索),同时屏蔽 Google-Extended(AI 功能)
Microsoft - Copilot
- User-agent:Bingbot(共用),Copilot 专属爬虫因情况而异
- 用途:为 Microsoft Copilot 和 Bing AI 回答提供支持
- 屏蔽后的影响:在 Microsoft Copilot 和 Bing AI 功能中的可见度下降
Meta - Llama
- User-agent:FacebookBot、Meta-ExternalAgent
- 用途:为 Meta AI 和 Llama 模型提供训练数据
- 屏蔽后的影响:你的内容不会影响 Meta AI 的回答
Apple - Applebot
- User-agent:Applebot、Applebot-Extended
- 用途:Siri、Apple Intelligence 和 Apple 搜索功能
- 屏蔽后的影响:在 Siri 和 Apple AI 功能中的可见度下降
问题所在:大多数 robots.txt 写于 AI 爬虫出现之前
一份典型的 2020-2023 年的 robots.txt 大概长这样:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
这份配置明确放行了 Googlebot,其他爬虫则全靠通配符规则来管。根据解读方式不同,这条通配符规则可能把 AI 爬虫挡在网站的部分板块之外,也可能让它们畅通无阻,连你本想保护的页面也一并放开。
更麻烦的是,在 AI 爬虫刚兴起的那段时间(2022-2023 年),出版方对 AI 使用训练数据的反弹正处于高峰,不少网站当时加上了激进的屏蔽规则。如果你的网站给所有爬虫都加了 Disallow: /,很可能已经把 AI 爬虫拒之门外,自己却早就忘了。往往要等到你发现品牌在 AI 搜索回答里存在感很低时,问题才会暴露出来。
AI Rank Lab 的 AI 爬虫追踪功能可以告诉你,哪些 AI 爬虫真正访问了你的页面,哪些 AI 助手给你带来了引荐流量,无需手动分析日志。如果某个你本想放行的爬虫一直没出现,就去检查一下 robots.txt 里针对它的规则。
不同场景下的 robots.txt 模板
你可以用我们的免费 robots.txt 生成器,按自己网站的情况定制这些模板。以下是最常见的几种配置:
模板一:全面开放 AI 访问(推荐大多数网站使用)
允许所有 AI 爬虫访问你的内容。适合希望最大化 AI 搜索可见度、也不介意内容被用于 AI 模型训练的网站。
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
模板二:有选择地开放 AI 访问(保护内容)
允许 AI 爬虫抓取公开内容页面,但屏蔽付费内容、付费墙文章和会员专区。适合订阅制出版方和有门槛内容的网站。
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
模板三:屏蔽 AI 训练,放行 AI 搜索
这是一种更精细的配置:放行 Perplexity(它用你的内容做实时引用),屏蔽训练类爬虫(它们用你的内容训练模型)。对于希望获得 AI 搜索引用、但反对内容被用于模型训练的出版方来说,这是常见的折中方案。
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml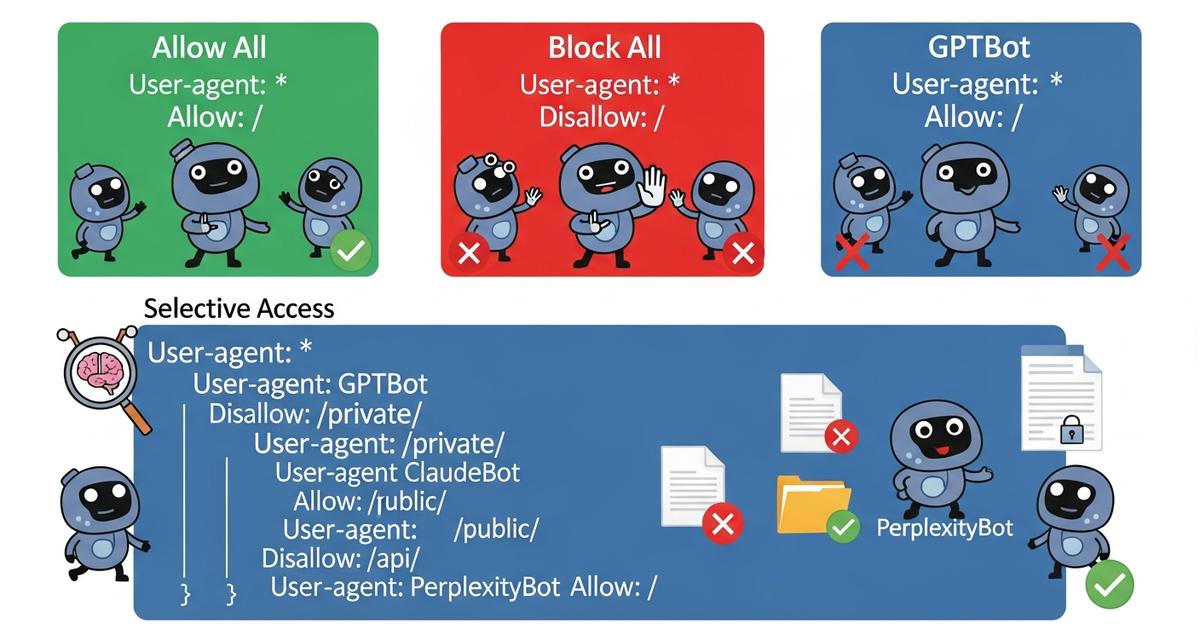
哪种配置适合你?这样判断
合适的 robots.txt 配置取决于你的内容类型、商业模式和 AI 搜索可见度目标。可以参考下面这套判断框架:
以下情况,放行所有 AI 爬虫:
- 你的网站发布的是公开可访问的内容(博客、文档、资源)
- 你希望最大化 AI 搜索可见度,而且 AI 引用本身就是流量来源
- 你没有需要保护的门槛内容或付费内容
- 你的内容偏信息类,传播越广越有利
以下情况,采用选择性访问:
- 你同时有免费内容和付费内容
- 有些页面不应该被引用(账户页面、结账流程、会员专属内容)
- 你希望 AI 爬虫集中抓取你最好的内容,而不是什么都抓
以下情况,屏蔽训练类爬虫(只放行搜索):
- 你是出版方,对内容被用作 AI 训练数据有顾虑
- 你仍然希望出现在 Perplexity 和 Google AI Overviews 中(实时引用)
- 你想保留日后单独向 AI 公司授权内容的可能
只有以下情况,才屏蔽所有 AI 爬虫:
- 你有明确的法律或竞争方面的理由,需要让内容远离 AI 系统
- 你和特定 AI 公司签有授权协议,需要保证排他性
- 你清楚其中的代价:你的域名在 AI 搜索中的可见度将归零
需要避开的常见错误
错误一:用通配符一刀切屏蔽未知爬虫
像 User-agent: * / Disallow: / 这样的配置,后面只给 Googlebot 加了放行规则,结果就是所有 AI 爬虫都被挡住,因为它们没有明确的放行规则。AI 爬虫能不能访问,一定要写明白。
错误二:不清楚当前的配置
很多团队根本不知道自己的 robots.txt 目前对 AI 爬虫是怎么规定的。现在就去 yoursite.com/robots.txt 看一眼。AI Rank Lab 的工具也能帮上忙:免费的网站审计会检查你的 robots.txt 是否存在、能否正常访问。
错误三:把 Googlebot 和 Google-Extended 混为一谈
放行 Googlebot 并不等于自动放行 Google-Extended(负责 AI 功能的爬虫)。如果你想出现在 Google AI Overviews 和 AI Mode 中,就需要一条明确放行 Google-Extended 的规则。
错误四:改完不测试
更新 robots.txt 之后,要检查线上文件,并用 robots.txt 测试工具确认改动已经生效。Google Search Console 自带针对 Googlebot 的 robots.txt 测试工具,但 AI 爬虫的规则需要你手动核对。
错误五:设置完就撒手不管
新的 AI 爬虫隔三岔五就会冒出来。2023 年的 AI User-agent 清单放到 2026 年已经不完整了。至少每季度检查一次 robots.txt,并留意各大 AI 公司新发布的爬虫文档。
不止 robots.txt:完整的 AI 爬虫管控体系
robots.txt 是管控 AI 爬虫访问最重要的手段,但不是唯一的手段。一套完整的 AEO 技术配置包括:
- robots.txt:爬虫访问规则(上文已介绍)
- llms.txt:写给大语言模型的指引文件,说明你的网站涵盖哪些内容、内容应如何使用——它是 robots.txt 的补充,而不是替代
- noindex 元标签:页面级别的控制,阻止特定页面被编入索引,部分 AI 爬虫会遵守
- AI 爬虫监测:追踪哪些爬虫在访问你的网站、访问频率如何——AI Rank Lab 的爬虫追踪功能无需分析日志就能让你一目了然
试试免费的 robots.txt 生成器
与其从零开始手写 robots.txt,不如直接用 AI Rank Lab 的免费 robots.txt 生成器。选好配置类型(全面开放、选择性访问、屏蔽训练或自定义),填上需要保护的路径,它就会生成一份格式正确的文件,并包含当前所有 AI 爬虫的 User-agent。生成结果可以直接复制到服务器上,也可以下载为文件。
每当有新的 AI 爬虫 User-agent 发布,生成器都会及时更新,所以你拿到的配置连本文写作时还不存在的爬虫也能覆盖到。
结语
robots.txt 就是你掌控 AI 搜索可见度的直接控制面板。配对了,AI 爬虫就能访问并学习你的内容,进而转化为 ChatGPT、Perplexity、Claude 和 Gemini 回答中的引用。配错了,或者一直沿用一份过时的文件,就等于在你的内容和越来越主导信息发现的 AI 引擎之间筑起了一道看不见的墙。
花五分钟检查一下现有的 robots.txt,再用免费生成器做一份适配 AI 的配置,这是提升 AI 搜索可见度投入产出比最高的技术动作之一。今天就动手,然后设个提醒,每季度复查一次,因为新的 AI 爬虫还在不断加入这个生态。
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


