



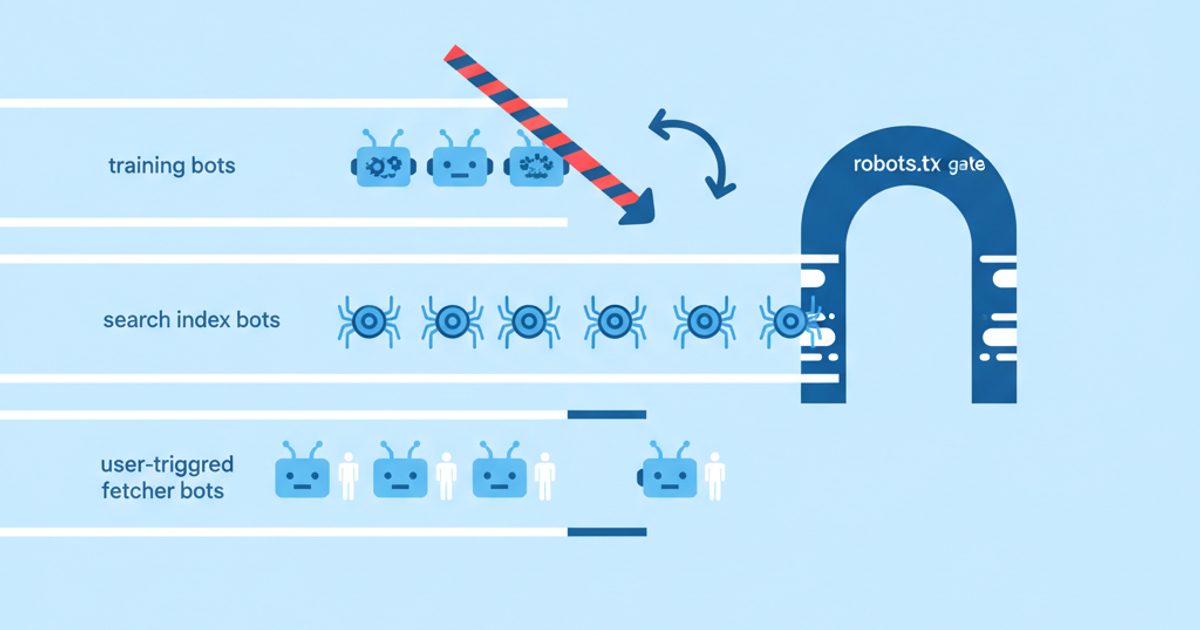
زواحف الذكاء الاصطناعي هي روبوتات آلية تشغّلها شركات الذكاء الاصطناعي لجلب صفحات الويب لأداء واحدة من ثلاث مهام: جمع بيانات لتدريب النماذج (GPTBot وClaudeBot)، أو بناء فهرس البحث الذي تستشهد به إجابات الذكاء الاصطناعي (OAI-SearchBot وClaude-SearchBot وPerplexityBot)، أو جلب صفحة مباشرةً لأن مستخدمًا سأل مساعدًا عنها (ChatGPT-User وClaude-User وPerplexity-User). حظر زاحف التدريب يُبقي محتواك خارج النماذج المستقبلية، أما حظر زاحف البحث أو أداة الجلب التي يطلقها المستخدم فيُخرجك من إجابات الذكاء الاصطناعي والاستشهادات. وعلى هذا الفرق يقوم القرار كله.
هذه الصفحة مرجع عملي يمكنك البناء عليه مباشرةً. راجعنا كل وكيل مستخدم (user agent) أدناه مقابل الوثائق الرسمية للجهة المشغّلة في 18 أكتوبر 2026، مع رابط لتلك الصفحة. وستجد أيضًا مصفوفة قرار حسب هدف عملك، ومجموعات robots.txt جاهزة للنسخ، وطريقة التحقق التي تدعمها كل جهة (مع التاريخ المسجّل داخل كل قائمة IP منشورة)، ونظرة صريحة على سبب عجز أدوات التحليلات المعتمدة على JavaScript عن إظهار معظم حركة الزواحف.
أهم النقاط
- صنّف كل روبوت ذكاء اصطناعي ضمن إحدى ثلاث فئات: تدريب أو بحث/فهرسة أو يطلقه المستخدم. تنشر OpenAI وAnthropic وAmazon وMeta وMistral رمزًا منفصلًا لكل فئة، فتستطيع حظر واحدة دون الأخريين.
- حظر GPTBot لا يُخرجك من بحث ChatGPT. تقول OpenAI إن OAI-SearchBot وحده يتحكم في ذلك، وإن المواقع التي ترفض OAI-SearchBot قد تظل تظهر كروابط تنقّل.
- Google-Extended وApplebot-Extended رمزا تحكم وليسا زاحفين. لن يظهرا في سجلاتك أبدًا، وتقول Google إن Google-Extended لا تأثير له في بحث Google، بما في ذلك AI Overviews (ملخصات Google المولّدة بالذكاء الاصطناعي) وAI Mode.
- أدوات الجلب التي يطلقها المستخدم قد تتجاهل robots.txt عن قصد: هذا ما تقوله OpenAI وPerplexity وGoogle وMeta وAmazon في وثائقها. استخدم WAF إذا احتجت إلى حظر صارم.
- معظم زواحف الذكاء الاصطناعي لا تشغّل JavaScript، لذا سيُقلّل أي وسم تحليلات قائم على JS من عددها. سجلات الخادم أو CDN هي المرجع الحقيقي لنشاط الزواحف.
- تحقّق من الروبوتات عبر DNS العكسي (Google وApple وCommon Crawl) أو بمطابقة عنوان IP مع قائمة JSON التي تنشرها الجهة المشغّلة. بعض هذه القوائم عمرها سنوات، فأعد تنزيلها وفق جدول منتظم.
ما زواحف الذكاء الاصطناعي، وما فئاتها الثلاث؟
زاحف الذكاء الاصطناعي هو أي عميل آلي تستخدمه شركة ذكاء اصطناعي لطلب صفحاتك. باتت الجهات المشغّلة تفصل روبوتاتها حسب الغرض، والغرض هو ما يحدد كلفة الحظر عليك. وتكشف بيانات شبكة Cloudflare مدى اختلال هذا المزيج: خلال الأشهر الاثني عشر حتى منتصف 2025، كان 80% من زحف الذكاء الاصطناعي للتدريب، و18% للبحث، و2% لإجراءات المستخدمين، مع ارتفاع حصة التدريب إلى 82% في الأشهر الستة الأخيرة من تلك الفترة.
زواحف التدريب
تجمع زواحف التدريب محتوى قد يُستخدم في تدريب النماذج الأساسية أو ضبطها. ينتمي إلى هذه الفئة GPTBot وClaudeBot وMeta-ExternalAgent وAmazonbot وMistralAI-Training وCCBot (مجموعة البيانات المفتوحة من Common Crawl التي يعتمد عليها كثير من مطوّري النماذج). حظرها إشارة إلى أنك لا تريد دخول محتواك المستقبلي في مجموعات التدريب. لكنه لا يحذف المحتوى الذي جُمع سابقًا، ولا يؤثر في قدرة البحث بالذكاء الاصطناعي على الاستشهاد بك.
زواحف البحث والفهرسة
تبني زواحف البحث فهرس الاسترجاع الذي تستند إليه إجابات الذكاء الاصطناعي وتشير إليه الاستشهادات بروابطها. من الزواحف الخاصة بالذكاء الاصطناعي: OAI-SearchBot (بحث ChatGPT) وClaude-SearchBot وPerplexityBot وMeta-WebIndexer وAmzn-SearchBot وMistralAI-Index وDuckAssistBot. أما Googlebot وBingbot وApplebot فزواحف بحث تقليدية صار فهرسها يغذّي أيضًا ميزات الذكاء الاصطناعي: AI Overviews وAI Mode من Google، وMicrosoft Copilot، وإجابات Siri. حظر زاحف بحث هو الخطأ المكلف، لأنه يُخرجك من الإجابات التي يقرؤها المشترون. وإذا أردت فهم آلية استخدام أحد هذه الفهارس، فاطّلع على كيف يعمل بحث ChatGPT.
أدوات الجلب والوكلاء التي يطلقها المستخدم
تزور أدوات الجلب التي يطلقها المستخدم رابطًا واحدًا لأن شخصًا طلب من المساعد قراءته أو تلخيصه أو تنفيذ إجراء عليه. ينتمي إلى هذه الفئة ChatGPT-User وClaude-User وPerplexity-User وGoogle-Agent وMeta-ExternalFetcher وAmzn-User وMistralAI-User، إضافةً إلى وكلاء المتصفح الموقَّعين مثل Cloud browser في ChatGPT. وتصرّح عدة جهات مشغّلة بأن robots.txt قد لا ينطبق على هذه الأدوات، لأن إنسانًا هو من بدأ الطلب.
رموز تحكم ليست زواحف
اسمان يظهران في كل قائمة لا يجلبان أي شيء بأنفسهما. Google-Extended رمز منتج في robots.txt تقرؤه Google أثناء الزحف بوكلاء المستخدم المعتادين لديها، ويحدد ما إذا كان يجوز استخدام المحتوى في تدريب نماذج Gemini المستقبلية وفي الإسناد (grounding) داخل تطبيقات Gemini وVertex AI. ويؤدي Applebot-Extended الدور نفسه لنماذج Apple الأساسية. لن تجد أيًّا من هذين الاسمين في سجلات الوصول لديك، ولهذا فإن عبارة «حظرت Google-Extended لكنني ما زلت أرى زيارات من Google» تصف سلوكًا متوقعًا تمامًا.
قائمة زواحف الذكاء الاصطناعي: كل وكلاء المستخدم الرئيسيين، موثّقة في 18 أكتوبر 2026
يعرض الجدول الرمز الذي تضعه في سطر User-agent:، والجهة التي تشغّله، وفئته، وما تقوله وثائق الجهة المشغّلة نفسها عن robots.txt، وطريقة التحقق منه، والصفحة الرسمية التي راجعناها. وعبارة «حسب الوثائق» تعني أن عمود robots.txt يعيد صياغة كلام الجهة المشغّلة؛ وحيث تسكت الوثائق نقول ذلك صراحةً بدل التخمين.
| الرمز | الجهة المشغّلة | الفئة | ما الذي يفعله | robots.txt (حسب الوثائق) | التحقق عبر | الوثائق الرسمية |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | تدريب | يزحف إلى محتوى قد يُستخدم في تدريب النماذج الأساسية لدى OpenAI | نعم | gptbot.json | زواحف OpenAI |
| OAI-SearchBot | OpenAI | بحث | يُظهر المواقع في إجابات بحث ChatGPT؛ لا يُستخدم للتدريب | نعم، وتستغرق التعديلات نحو 24 ساعة | searchbot.json | زواحف OpenAI |
| ChatGPT-User | OpenAI | يطلقه المستخدم | يزور الصفحات لتنفيذ إجراءات المستخدمين في ChatGPT وCustom GPTs | قد لا ينطبق | chatgpt-user.json | زواحف OpenAI |
| OAI-AdsBot | OpenAI | خاص | يفحص صفحات الهبوط المقدَّمة كإعلانات في ChatGPT؛ لا يُستخدم للتدريب | غير مذكور؛ يزور صفحات الإعلانات المقدَّمة فقط | adsbot.json | زواحف OpenAI |
| ClaudeBot | Anthropic | تدريب | يجمع محتوى قد يساهم في تدريب نماذج Claude | نعم؛ يدعم Crawl-delay | bots.json (مشتركة) | مركز مساعدة Anthropic |
| Claude-SearchBot | Anthropic | بحث | يفهرس المحتوى لتحسين نتائج البحث في Claude | نعم | bots.json (مشتركة) | مركز مساعدة Anthropic |
| Claude-User | Anthropic | يطلقه المستخدم | يجلب الصفحات عندما يطرح مستخدم Claude سؤالًا | نعم، والتعطيل يوقف الاسترجاع الذي يوجّهه المستخدم | bots.json (مشتركة) | مركز مساعدة Anthropic |
| PerplexityBot | Perplexity | بحث | يُظهر المواقع ويربط إليها في نتائج Perplexity؛ لا يُستخدم للتدريب | نعم، خلال 24 ساعة كحد أقصى | perplexitybot.json | زواحف Perplexity |
| Perplexity-User | Perplexity | يطلقه المستخدم | يزور الصفحات للإجابة عن سؤال المستخدم | يتجاهله عمومًا | perplexity-user.json | زواحف Perplexity |
| Googlebot | بحث | بحث Google، بما في ذلك AI Overviews وAI Mode | نعم، دائمًا في الزحف التلقائي | DNS العكسي أو common-crawlers.json | زواحف Google الشائعة | |
| Google-Extended | رمز تحكم | تدريب Gemini والإسناد في تطبيقات Gemini وVertex AI | رمز فقط؛ لا وكيل مستخدم خاص به | لا ينطبق | زواحف Google الشائعة | |
| Google-CloudVertexBot | بحث (بطلب من مالك الموقع) | يزحف إلى المواقع التي يبني أصحابها عليها وكلاء Vertex AI Agents | نعم | DNS العكسي أو common-crawlers.json | زواحف Google الشائعة | |
| Google-Agent | وكيل يطلقه المستخدم | وكلاء على بنية Google التحتية يتصفحون وينفّذون إجراءات بطلب المستخدم | يتجاهله عمومًا (يطلقه المستخدم) | user-triggered-agents.json؛ بعض الطلبات موقَّعة بـWeb Bot Auth | أدوات الجلب التي يطلقها المستخدم لدى Google | |
| Google-GeminiNotebook | يطلقه المستخدم | يجلب الروابط التي يضيفها المستخدمون كمصادر في Gemini Notebook (الوكيل السابق Google-NotebookLM، مدعوم حتى أغسطس 2026) | يتجاهله عمومًا (يطلقه المستخدم) | قوائم JSON لأدوات الجلب التي يطلقها المستخدم | أدوات الجلب التي يطلقها المستخدم لدى Google | |
| Bingbot | Microsoft | بحث | فهرس Bing، الذي يُسند إليه Copilot إجاباته أيضًا | نعم؛ واستخدام الذكاء الاصطناعي يُضبط على مستوى الصفحة بـnoarchive/nocache | bingbot.json أو أداة Verify Bingbot من Bing | مدوّنة Bing Webmaster |
| Applebot | Apple | بحث (وقد يُستخدم للتدريب) | بحث Spotlight وSiri وSafari؛ وقد تُستخدم البيانات أيضًا في تدريب نماذج Apple | نعم؛ يتبع قواعد Googlebot إن لم يُذكر Applebot بالاسم؛ يتجاهل Crawl-delay | DNS العكسي (*.applebot.apple.com) أو applebot.json | عن Applebot |
| Applebot-Extended | Apple | رمز تحكم | يستثني المحتوى من تدريب نماذج Apple الأساسية | رمز فقط | لا ينطبق | عن Applebot |
| Meta-ExternalAgent | Meta | تدريب | تدريب نماذج الذكاء الاصطناعي الأساسية أو فهرسة المحتوى مباشرةً | نعم | وكيل المستخدم مع عناوين IP المنشورة من Meta | زواحف الويب لدى Meta |
| Meta-WebIndexer | Meta | بحث | يحسّن نتائج البحث في Meta AI كي يستشهد بك Meta AI ويربط إليك | نعم | وكيل المستخدم مع عناوين IP المنشورة من Meta | زواحف الويب لدى Meta |
| Meta-ExternalFetcher | Meta | يطلقه المستخدم | يجلب الروابط بطلب المستخدم، بما في ذلك المهام الوكيلية | قد يتجاوزه | وكيل المستخدم مع عناوين IP المنشورة من Meta | زواحف الويب لدى Meta |
| Amazonbot | Amazon | تدريب | يحسّن منتجات Amazon؛ وقد يُستخدم في تدريب نماذج الذكاء الاصطناعي لدى Amazon | نعم (RFC 9309)؛ يتجاهل Crawl-delay | صفحة عناوين IP المنشورة | Amazonbot |
| Amzn-SearchBot | Amazon | بحث | تجارب البحث مثل Alexa؛ لا يُستخدم للتدريب | نعم؛ يرث القواعد المحددة لروبوتات البحث الأخرى إن لم يُذكر بالاسم | صفحة عناوين IP المنشورة | Amazonbot |
| Amzn-User | Amazon | يطلقه المستخدم | يجلب معلومات حيّة لاستفسارات Alexa؛ لا يُستخدم للتدريب | قد لا يلتزم بكل التوجيهات | صفحة عناوين IP المنشورة | Amazonbot |
| MistralAI-Training | Mistral | تدريب | يبني مجموعات بيانات لتدريب نماذج Mistral | نعم، ويمكن حظره | وكيل المستخدم | زواحف Mistral |
| MistralAI-Index | Mistral | بحث | يفهرس المحتوى لبحث Mistral داخل Vibe؛ لا يُستخدم للتدريب | نعم | mistralai-index-ips.json | زواحف Mistral |
| MistralAI-User | Mistral | يطلقه المستخدم | يزور الصفحات عندما يطرح مستخدمو Vibe سؤالًا | نعم، ويحدد المواقع التي تصل إليها طلبات المستخدمين | mistralai-user-ips.json | زواحف Mistral |
| DuckAssistBot | DuckDuckGo | بحث (فوري) | يزحف إلى الصفحات لإجابات DuckDuckGo المدعومة بالذكاء الاصطناعي؛ لا يُستخدم للتدريب | نعم، ويسري بعد 72 ساعة | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | تدريب (مجموعة بيانات مفتوحة) | يبني مدوّنة Common Crawl المفتوحة المستخدمة على نطاق واسع في تدريب النماذج | نعم | DNS العكسي (*.crawl.commoncrawl.org، IPv4 فقط) | CCBot |
يحسم الجدول أمرين. أولًا، تذكر صفحة Anthropic الحالية ثلاثة روبوتات بالضبط: ClaudeBot وClaude-SearchBot وClaude-User. وما زالت قوائم قديمة تتضمن «anthropic-ai» و«Claude-Web»، وهما غير موجودين في وثائق Anthropic حتى أكتوبر 2026. ثانيًا، أرقام الإصدارات لدى OpenAI تتغير: يوم مراجعتنا كانت سلاسل OpenAI النموذجية تُظهر GPTBot/1.4 وOAI-SearchBot/1.4، لذا طابِق على الرمز، وليس على السلسلة كاملة أبدًا.
روبوتات بلا وثائق رسمية
بعض الروبوتات التي ستراها في السجلات لم نجد لها صفحة من الجهة المشغّلة في 18 أكتوبر 2026. أشهرها Bytespider من ByteDance، وكذلك الوكلاء المرتبطون بـGrok من xAI. والأدلة الصادرة عن جهات خارجية تختلف في وصف سلوكها، لذا استبعدناها من الجدول الموثّق. يتضمن ملف robots.txt المُدار من Cloudflare قاعدة حظر لـBytespider، وأفادت Cloudflare بأن حصة Bytespider من زحف الذكاء الاصطناعي انخفضت من 14.1% إلى 2.4% بين منتصف 2024 ومنتصف 2025. إذا كان أحد هذه الروبوتات يهمّك، فطبّق سياستك بقاعدة في WAF بدل الاعتماد على robots.txt.
هل تحترم زواحف الذكاء الاصطناعي ملف robots.txt؟
زواحف التدريب والبحث الموثّقة تقول إنها تحترمه، وأدوات الجلب التي يطلقها المستخدم تقول في الغالب إنها لا تحترمه، وrobots.txt ليس في أي حال أداةً للتحكم في الوصول. فالمعيار نفسه، RFC 9309، ينص على أن «هذه القواعد ليست شكلًا من أشكال تفويض الوصول». كما يسمح للزواحف بتخزين ملفك مؤقتًا لمدة تصل إلى 24 ساعة، ولهذا تذكر كل جهة مشغّلة مهلة قبل أن تسري التعديلات.
لكن ادعاءات الالتزام شيء والسلوك الفعلي شيء آخر. في أغسطس 2025 نشرت Cloudflare اختبارًا وصفت فيه Perplexity بالتفصيل نطاقات جديدة كليًا تحظر كل شيء. وقالت Cloudflare إنها رصدت وكيل Perplexity-User المُعلن ينفّذ ما بين 20 و25 مليون طلب يوميًا، ووكيلًا غير مُعلن يشبه Chrome ينفّذ ما بين 3 و6 ملايين، ثم أزالت Perplexity من قائمة الروبوتات الموثّقة. هذه نتيجة توصّل إليها مزوّد واحد بشأن جهة مشغّلة واحدة، لكنها توضح لماذا لا تثبت سلسلة وكيل المستخدم وحدها أي شيء.
| الجهة المشغّلة | المدة حتى تسري تعديلات robots.txt (حسب الوثائق) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | نحو 24 ساعة | غير مذكور |
| Perplexity | حتى 24 ساعة | غير مذكور |
| Amazon | نحو 24 ساعة؛ وقد تستخدم نسخة مخزّنة يصل عمرها إلى 30 يومًا | غير مدعوم |
| Meta | حتى 24 ساعة | غير مذكور |
| DuckDuckGo (DuckAssistBot) | 72 ساعة | غير مذكور |
| Anthropic | غير مذكور | مدعوم |
| Apple | غير مذكور | غير مدعوم |
ما الذي تخسره عند حظر كل فئة من زواحف الذكاء الاصطناعي؟
حظر زواحف التدريب لا يكلّفك اليوم إلا القليل من الظهور، أما حظر زواحف البحث أو أدوات الجلب التي يطلقها المستخدم فيكلّفك الاستشهادات فورًا. يربط الجدول كل فئة بالكلفة التي تصفها الجهات المشغّلة نفسها.
| إذا حظرت... | فأنت تبقى خارج | وتخسر | وتظل تظهر في |
|---|---|---|---|
| زواحف التدريب (GPTBot وClaudeBot وMeta-ExternalAgent وAmazonbot وCCBot وGoogle-Extended وApplebot-Extended) | مجموعات التدريب المستقبلية لدى تلك الجهة | القليل من الظهور على المدى القصير؛ وربما مدى «معرفة» النماذج المستقبلية بعلامتك التجارية دون بحث | بحث ChatGPT وبحث Claude وPerplexity وبحث Google وAI Overviews، ما دامت روبوتات البحث لديها مسموحة |
| زواحف البحث بالذكاء الاصطناعي (OAI-SearchBot وClaude-SearchBot وPerplexityBot وMeta-WebIndexer وAmzn-SearchBot وMistralAI-Index وDuckAssistBot) | فهرس الاسترجاع لذلك المحرك | الاستشهادات والروابط في إجابات ذلك المحرك؛ وتُبقي OpenAI روابط التنقّل فقط | محركات البحث التقليدية، ما لم تحظرها أيضًا |
| أدوات الجلب التي يطلقها المستخدم (ChatGPT-User وClaude-User وPerplexity-User وMistralAI-User) | عمليات الجلب المباشرة التي يطلبها المستخدمون، حيث تلتزم الجهة المشغّلة بذلك | الإجابات حين يلصق مستخدم رابطك أو يسأل عنه؛ ومهام الوكلاء مثل إتمام الشراء أو الحجز | الإجابات المستندة إلى الفهرس، إذا كان روبوت البحث مسموحًا |
| Googlebot | بحث Google بالكامل | الترتيب العضوي وAI Overviews وAI Mode معًا | لا شيء على Google؛ ونادرًا ما يكون هذا ما تريده |
وحجم هذه المقايضة مهم أيضًا. قاست Cloudflare عدد الصفحات التي تزحف إليها كل منصة ذكاء اصطناعي مقابل كل زائر تُحيله إلى الموقع: في يوليو 2025 كانت Anthropic عند نحو 38,000 عملية زحف لكل زائر مُحال، وPerplexity عند 194. هذه النسب هي الحجة الاقتصادية التي يسوقها الناشرون لحظر زواحف التدريب مع إبقاء زواحف البحث مفتوحة.
أي زواحف الذكاء الاصطناعي تسمح بها وأيّها تحظر؟ مصفوفة قرار حسب هدف عملك
ابدأ مما تبيعه. إذا كانت توصية مساعد ذكاء اصطناعي بك قادرة على جلب عميل، فاسمح لكل زواحف البحث وأدوات الجلب التي يطلقها المستخدم، وتعامل مع التدريب كقرار منفصل وأقل أهمية.
| وضعك | زواحف التدريب | زواحف البحث | أدوات الجلب والوكلاء | السبب |
|---|---|---|---|---|
| شركات B2B SaaS والوكالات والخدمات المحلية | اسمح (أو احظر، الكلفة منخفضة) | اسمح | اسمح | المشترون يضعون قوائمهم المختصرة من المزوّدين عبر إجابات الذكاء الاصطناعي؛ ووجودك في معرفة النماذج يساعد أيضًا في الإشارات التلقائية إليك |
| التجارة الإلكترونية | القرار لك | اسمح | اسمح، وأضف الوكلاء الموقَّعين إلى قائمة السماح في WAF | إجابات التسوّق تستشهد بصفحات المنتجات، والوكلاء يحتاجون إلى الوصول إلى السلة وإتمام الشراء |
| المواقع الإخبارية والناشرون الممولون بالإعلانات | احظر | اسمح، أو احظر في صفحات الإعلانات | قرّر لكل جهة مشغّلة على حدة | المحتوى هو المنتج؛ والاستشهادات ما زالت تعيد بعض القرّاء |
| وثائق المطوّرين والمشاريع مفتوحة المصدر | اسمح | اسمح | اسمح | المطوّرون يسألون المساعدين عن طريقة استخدام واجهتك البرمجية؛ ومعرفة النماذج الدقيقة تخفف عبء الدعم |
| محتوى خلف جدار دفع أو مرخّص | احظر | اسمح لصفحات الفهرسة فقط | احظر عبر WAF إذا تطلّب الترخيص ذلك | اجعل المقتطفات التشويقية قابلة للاستشهاد، وأبقِ النص الكامل خارجًا |
| بيئات الاختبار والشبكات الداخلية والتطبيقات الخاصة | احظر | احظر | احظر | استخدم المصادقة؛ فـrobots.txt طلب وليس قفلًا |
| خادم تحت ضغط الزحف | قيّد المعدّل أو احظر | اسمح، وقيّد المعدّل على CDN | اسمح | عالج الحمل على الحافة بدل أن تخسر الاستشهادات |
كيف تحظر زواحف تدريب الذكاء الاصطناعي وتسمح للبحث في robots.txt؟
خصّص لكل رمز تدريب مجموعته الخاصة مع Disallow: /، واترك زواحف البحث تحت قواعدك المعتادة. فالزاحف لا يطيع إلا المجموعة الأكثر تحديدًا التي تذكره بالاسم، ولذلك لا يمتد حظر التدريب إلى روبوتات البحث.
المقتطف 1: احظر التدريب، وأبقِ البحث بالذكاء الاصطناعي وأدوات الجلب
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
يسمح RFC 9309 بأن تتشارك عدة أسطر User-agent مجموعة واحدة، والمطابقة لا تميّز بين الأحرف الكبيرة والصغيرة. أما OAI-SearchBot وClaude-SearchBot وPerplexityBot وGooglebot وBingbot فتنتقل إلى مجموعة * وتبقى مسموحة.
المقتطف 2: صرّح بانفتاحك على البحث بالذكاء الاصطناعي
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
ذكر روبوتات البحث بأسمائها يحميك من قاعدة شاملة قد يكتبها غيرك مستقبلًا، كإضافة تضيف User-agent: * مع Disallow: /. وأبقِ المسارات الخاصة محظورة داخل المجموعة، لأن المجموعة المسمّاة تحلّ محل مجموعة * بالنسبة لذلك الروبوت ولا تُضاف إليها.
المقتطف 3: ثلاثة أخطاء شائعة تُفسد الملفات الحقيقية
- Applebot يرث قواعد Googlebot. تقول Apple إنه إذا لم يذكر ملفك Applebot لكنه ذكر Googlebot، فإن Applebot يتبع مجموعة Googlebot. أي حظر خاص بـGooglebot قد يُخرجك بصمت من Siri وSpotlight.
- Amzn-SearchBot يرث قواعد روبوتات البحث الأخرى إذا لم يُذكر بالاسم، بحسب Amazon. اذكره بالاسم إن أردت نتيجة مختلفة.
- النطاقات الفرعية تحتاج إلى ملف خاص بها. تقول Anthropic وAmazon كلتاهما إنهما تقرآن robots.txt لكل مضيف على حدة، لذا يحتاج
docs.example.comإلى نسخته الخاصة.
يمكنك بناء هذه المجموعات وفحصها باستخدام مولّد robots.txt المجاني من AI Rank Lab، كما تتعمق قوالب robots.txt لزواحف الذكاء الاصطناعي التي نشرناها سابقًا في إعدادات الوصول الكامل والوصول الانتقائي.
كيف تتحقق من أن زاحف الذكاء الاصطناعي حقيقي وليس منتحلًا؟
لا تثق بوكيل المستخدم وحده أبدًا: يستطيع أي أحد أن يرسل «GPTBot» في ترويسة الطلب، وتحذّر Common Crawl في صفحتها نفسها من زواحف تنتحل هوية CCBot. وتدعم الجهات المشغّلة ثلاث طرق للتحقق، وتختار بينها حسب الجهة.
- DNS العكسي ثم DNS الأمامي. شغّل الأمر
hostعلى عنوان IP من سجلك، وتأكد من أن اسم المضيف ينتهي بنطاق الجهة المشغّلة، ثم شغّلhostعلى اسم المضيف هذا وتأكد من أنه يعيد العنوان نفسه. توثّق Google ذلك لنطاقاتgooglebot.comوgoogle.comوgoogleusercontent.comفي دليل التحقق الخاص بها؛ وتستخدم Apple النطاق*.applebot.apple.com؛ وتستخدم Common Crawl النطاق*.crawl.commoncrawl.org(IPv4 فقط). - طابِق عنوان IP مع القائمة التي تنشرها الجهة المشغّلة. تنشر OpenAI وAnthropic وPerplexity وGoogle وApple وMicrosoft وDuckDuckGo وMistral وAmazon نطاقات عناوين IP. وهذه هي الطريقة الوحيدة مع OpenAI وAnthropic وPerplexity، لأنها لا توثّق نمطًا لـDNS العكسي.
- افحص التوقيع التشفيري (Web Bot Auth). يوقّع Cloud browser في ChatGPT طلباته وفق RFC 9421 بترويسة
Signature-Agentقيمتها"https://chatgpt.com". وتختبر Google مسودة IETF نفسها مع بعض طلبات Google-Agent، الموقَّعة باسمhttps://agent.bot.goog، وتنصح صفحة Web Bot Auth لديها بالإبقاء على فحص عناوين IP كخطة بديلة لأن الطلبات ليست كلها موقَّعة.
# بحث عكسي ثم أمامي (مثال Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# فحص قائمة IP لزاحف البحث لدى OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
ما مدى حداثة قوائم عناوين IP المنشورة؟
نزّلنا كل ملفات عناوين IP المنشورة لزواحف الذكاء الاصطناعي في 18 أكتوبر 2026 وقرأنا حقل creationTime الذي تكتبه كل جهة مشغّلة داخله. قد يعني التاريخ القديم ببساطة أن النطاقات لم تتغير، لكنه يخبرك بمدى الثقة التي يمكن منحها لقائمة سماح مكتوبة يدويًا، ويُظهر القوائم العاجزة عن تفسير حركة لم تُعلن عنها الجهة المشغّلة قط.
| القائمة المنشورة | قيمة creationTime في الملف | بادئات IPv4 / IPv6 |
|---|---|---|
| زواحف Google الشائعة (Googlebot وGoogle-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| وكلاء Google التي يطلقها المستخدم (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (الروبوتات الثلاثة في قائمة واحدة) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
درسان عمليان. قوائم Google وقائمة ChatGPT-User لدى OpenAI تغيّرت خلال الأسبوعين الماضيين، لذا فإن قائمة السماح التي نسختها إلى جدار الحماية في الصيف غالبًا ما أصبحت خاطئة الآن؛ اجلب هذه الملفات يوميًا أو أسبوعيًا بدلًا من ذلك. كما تقول Anthropic إن حظر عناوين IP الخاصة بها «قد لا يعمل بشكل صحيح أو لا يضمن الاستثناء بشكل دائم» لأنه يمنع Anthropic من قراءة ملف robots.txt لديك، لذا استخدم robots.txt للاستثناء، وعناوين IP للتحقق فقط.
كيف ترى نشاط زواحف الذكاء الاصطناعي: سجلات الخادم أم وسوم JavaScript؟
استخدم سجلات الخادم أو CDN للزواحف، وتحليلات JavaScript للزوار البشر القادمين من مساعدي الذكاء الاصطناعي. فوسم JS لا يعمل إلا إذا نفّذ شيءٌ ما كود JavaScript في الصفحة، ومعظم زواحف الذكاء الاصطناعي لا تفعل ذلك. وقد وجد تحليل Vercel لشبكتها أن لا أحد من زواحف الذكاء الاصطناعي الكبرى يعرض JavaScript؛ فزواحف ChatGPT وClaude جلبت ملفات JS (بنسبة 11.50% و23.84% من طلباتها) لكنها لم تنفّذها. والاستثناءان هما Gemini، الذي يعتمد على العرض لدى Googlebot، وApplebot. تعود تلك الدراسة إلى ديسمبر 2024، فأعد الاختبار على موقعك، لكنها تتطابق مع ما نراه.
ويوسّع Google Analytics هذه الفجوة بحكم تصميمه. إذ يستبعد GA4 تلقائيًا الزيارات الصادرة عن الروبوتات والعناكب المعروفة، ولا يمكنك إيقاف ذلك ولا معرفة حجم ما استُبعد. GA4 هو الأداة المناسبة لزيارات الإحالة من الذكاء الاصطناعي، التي نشرحها في كيف تتتبع زيارات الإحالة من الذكاء الاصطناعي في GA4، وهو الأداة الخطأ لعدّ الزواحف.
ونرى النمط نفسه في بيانات التتبع لدى AI Rank Lab. فوسم JavaScript الخاص بنا يسجّل بدقة الأشخاص الذين ينقرون قادمين من ChatGPT وGemini وPerplexity وClaude، لكنه لا يرى إلا شريحة صغيرة وغير ممثِّلة من حركة الزواحف، ولهذا لا ننشر أعداد الزواحف المستندة إليه.
فحص للسجلات في خمس دقائق
- نزّل سجلات الوصول الخام ليوم واحد من الاستضافة أو CDN (يسجّل كل من Nginx وApache وكيل المستخدم في تنسيق combined الافتراضي).
- احسب الطلبات لكل رمز ذكاء اصطناعي:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - افحص رموز الحالة للرموز الأكثر ظهورًا. سيلٌ من أخطاء 403 أو 429 يعني عادةً أن قاعدة في WAF أو CDN تحظر روبوتًا يسمح به ملف robots.txt لديك.
- تحقّق من عيّنة من عناوين IP بالطرق المذكورة أعلاه قبل أن تثق بأي رقم.
- افحص الروابط التي تطلبها روبوتات البحث. إذا كان OAI-SearchBot أو Claude-SearchBot لا يجلبان إلا صفحتك الرئيسية، فراجع الربط الداخلي وخريطة الموقع.
أدوات تُظهر نشاط زواحف الذكاء الاصطناعي
إفصاح: AI Rank Lab منتجنا. نضعه أولًا لأن هذا موقعنا، والتزمنا بالمعايير نفسها مع كل الأدوات أدناه.
- AI Rank Lab - تسجّل ميزة تتبع روبوتات الذكاء الاصطناعي الإحالات من مساعدي الذكاء الاصطناعي وزيارات روبوتات الذكاء الاصطناعي التي يستطيع وسمها رؤيتها، لكل صفحة، بجانب تتبع ظهورك واستشهاداتك في الذكاء الاصطناعي. اجمعها مع السجلات للحصول على أعداد الزواحف كاملة، للأسباب المذكورة أعلاه.
- Cloudflare AI Crawl Control - إذا كان موقعك يمرّ عبر Cloudflare، فهذه أكمل رؤية متاحة للزواحف، لأنها ترى كل طلب على الحافة، بما في ذلك الروبوتات التي لا تشغّل JavaScript إطلاقًا. كما تعرض مدى التزام كل زاحف بـrobots.txt.
- محلّلات ملفات السجلات مثل Log File Analyser من Screaming Frog أو GoAccess - تعمل على السجلات الخام من أي استضافة، وهي قوية في عمليات التدقيق لمرة واحدة.
- السجلات الخام مع أمر grep أعلاه - مجانية ودقيقة، وهي خط الأساس الذي يجب أن تطابقه كل أداة أخرى.
ولروتين مراقبة أعمق مبني حول أكبر ثلاثة روبوتات، راجع دليلنا لمراقبة GPTBot وClaudeBot وPerplexityBot.
كيف تتحكم Cloudflare وشبكات CDN الأخرى في روبوتات الذكاء الاصطناعي؟
تفرض شبكات CDN على حافة الشبكة ما لا يستطيع robots.txt إلا أن يطلبه. فأداة AI Crawl Control من Cloudflare، المتاحة في جميع الخطط، تُظهر خدمات الذكاء الاصطناعي التي تزور موقعك، وتتيح لك السماح لكل زاحف أو حظره، وتتتبع مخالفات robots.txt، وتقدّم ميزة الدفع مقابل الزحف (pay per crawl) في نسخة تجريبية خاصة.
وتعتمد سياسات Cloudflare لروبوتات الذكاء الاصطناعي الآن التقسيم الثلاثي نفسه الذي يعتمده هذا المقال. إذ تقدّم إعدادات Block AI Bots إعدادات مسبقة منفصلة للبحث والوكلاء والتدريب، ولكل منها خيار «الحظر في كل الصفحات» أو «الحظر في الصفحات التي تحتوي إعلانات» أو «السماح». وتقول الوثائق إنه بدءًا من 15 سبتمبر 2026 تحصل النطاقات الجديدة على إعدادات افتراضية محدّثة: حظر روبوتات التدريب والوكلاء في الصفحات التي تعرض إعلانات، والسماح للبحث، وحظر الزواحف متعددة الأغراض التي تجمع البحث والتدريب بموجب أي حظر للتدريب. فإذا نقلت موقعًا إلى Cloudflare بعد هذا التاريخ وتساءلت لماذا يتلقى ChatGPT-User أو Claude-User أخطاء 403 في مدوّنتك، فابدأ بفحص هذا الإعداد.
ويمكن لـCloudflare أيضًا إدارة robots.txt نيابةً عنك. فعند تفعيل Bot Preference Sync، يضيف ملف robots.txt المُدار في بداية ملفك، قبل قواعدك الحالية، مجموعات حظر لـAmazonbot وApplebot-Extended وBytespider وCCBot وClaudeBot وGoogle-Extended وGPTBot وmeta-externalagent، إضافةً إلى سطر Content Signals (search=yes, ai-train=no). وContent Signals مفردات اقترحتها Cloudflare (search وai-input وai-train) تحدد كيف يجوز استخدام المحتوى بعد جلبه؛ أما التزام جهة مشغّلة بعينها بها فأمر يعود إليها.
ويدعم مزوّدون آخرون النمط نفسه. تتضمن وثائق Perplexity إرشادات لـWAF في Cloudflare وAWS WAF باستخدام قوائم IP الخاصة بها، ويشرح مركز مساعدة OpenAI كيفية إضافة Cloud browser الموقَّع إلى قائمة السماح في Akamai (اسم الروبوت «ChatGPT Agent») وفي Cloudflare (معرّف الكشف 129220581). وأيًّا كانت شبكة CDN لديك، فترتيب الخطوات واحد: قرّر لكل فئة، وعبّر عن قرارك في robots.txt، وطبّقه على الحافة فقط حيث تحتاج إلى حظر صارم، ثم أعد فحص سجلاتك بعد أي تغيير في CDN.
Google وBing: الحالتان الخاصتان
هل يؤثر حظر Google-Extended في بحث Google أو AI Overviews؟
لا. تقول Google إن Google-Extended «لا يؤثر في ظهور الموقع في بحث Google ولا يُستخدم كإشارة ترتيب». ووثائق ميزات الذكاء الاصطناعي لديها واضحة في أن قواعد robots.txt الخاصة بـGooglebot هي أداة التحكم في البحث، بما في ذلك AI Overviews وAI Mode، وأنك تحدّ مما يظهر باستخدام nosnippet أو data-nosnippet أو max-snippet أو noindex. أما Google-Extended فيخص تدريب نماذج Gemini والإسناد في تطبيقات Gemini وVertex AI، وهي منفصلة عن البحث.
كيف تتحكم في استخدام Microsoft Copilot لمحتواك؟
لا تملك Microsoft رمزًا منفصلًا لزاحف ذكاء اصطناعي؛ فـBingbot هو من يزحف، وأنت تتحكم في استخدام الذكاء الاصطناعي عبر وسوم robots الوصفية على مستوى الصفحة. وأحدث إرشاد رسمي وجدناه هو إعلان فريق Bing عام 2023، الذي كُتب حين كان Copilot لا يزال يُسمّى Bing Chat: المحتوى الموسوم بـnoarchive لا يُضمَّن ولا يُربط إليه في إجابات الدردشة في Bing ولا يُستخدم في تدريب نماذج Microsoft الأساسية؛ والمحتوى الموسوم بـnocache قد يظهر بالرابط والعنوان والمقتطف فقط؛ والمحتوى الخالي من الوسمين يمكن استخدامه بالكامل. وكلا الوسمين يُبقيانك في نتائج Bing العادية. أما حظر Bingbot في robots.txt فسيُخرجك أيضًا من بحث Bing، لذا استخدم الوسوم الوصفية بدلًا منه.
حدود هذا المرجع وكيف أجرينا الفحص
في 18 أكتوبر 2026 قرأنا صفحة الزواحف لدى كل جهة مشغّلة مذكورة أعلاه، ونزّلنا كل قائمة IP منشورة، وسجّلنا قيمة creationTime داخل كل ملف. لم نتمكن من عرض صفحة مساعدة الزواحف لدى Microsoft المبنية بـJavaScript فقط، لذا يعتمد صف Bingbot على مدوّنة Bing Webmaster من Microsoft، وأداتها Verify Bingbot، وملف bingbot.json المنشور. وأعمدة robots.txt تعيد صياغة ما تقوله كل جهة مشغّلة، لا ما قسناه بأنفسنا بشكل مستقل؛ ونتائج Cloudflare بشأن Perplexity هي الدليل العلني الرئيسي على أن الأمرين قد يختلفان. وتعيد الجهات المشغّلة تسمية روبوتاتها وتضيف روبوتات جديدة كثيرًا (فقد استبدلت Google مثلًا رمز أداة الجلب Google-NotebookLM بـGoogle-GeminiNotebook)، لذا اعتبر أي قائمة، بما فيها هذه، دقيقة في تاريخ فحصها.
وإذا أردت أن ترى هل تكسب سياستك تجاه الزواحف استشهادات فعلًا، فإن AI Rank Lab يتتبع الإشارات إليك وصفحاتك المستشهد بها في ChatGPT وClaude وGemini وPerplexity وGoogle AI Overviews وAI Mode، بجانب زيارات الإحالة من الذكاء الاصطناعي التي ترسلها إليك تلك الإجابات.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


