



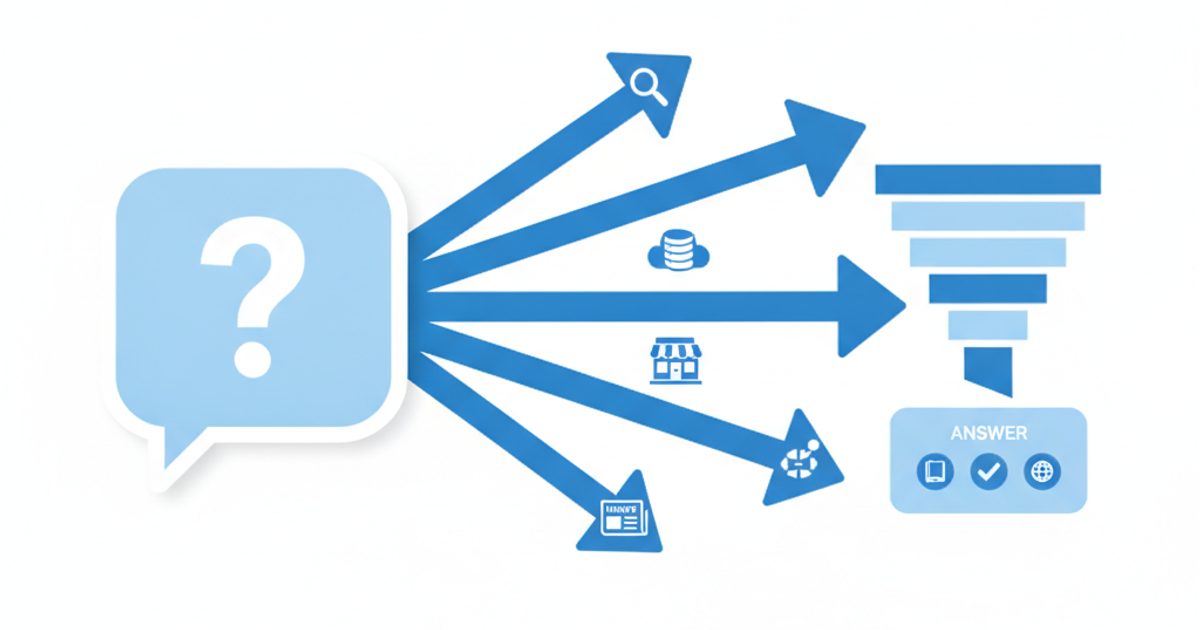
Die ChatGPT-Suche läuft in fünf Schritten ab: Zuerst entscheidet ChatGPT, ob deine Frage aktuelle Informationen braucht. Dann formuliert es die Frage in eine oder mehrere Suchanfragen um, holt passende Seiten aus OpenAIs eigenem Index und Cache sowie von Partner-Suchanbietern, bringt die Treffer in eine Reihenfolge und schreibt eine Antwort mit Links zu den genutzten Seiten. Jeden dieser Bausteine hat OpenAI dokumentiert. Nicht veröffentlicht hat OpenAI, wie stark welche Quelle ins Gewicht fällt – und genau daher kommen die meisten Missverständnisse (und die meisten Spekulationen).
Dieser Leitfaden trennt sauber, was OpenAI in der eigenen Dokumentation bestätigt hat und was Forschende per Reverse Engineering herausgefunden haben. Er erklärt die vier User-Agents von OpenAI und was jeder davon steuert, und er gibt dir eine Checkliste, was du als Website-Betreiber beeinflussen kannst und was nicht. Dazu kommt, was unsere eigenen Tracking-Daten über Referral-Traffic aus ChatGPT zeigen, inklusive der UTM-Lücke vom 8. bis 16. Oktober 2026. Alle Quellen haben wir am 18. Oktober 2026 geprüft.
Das Wichtigste in Kürze
- Bestätigt: ChatGPT greift auf OpenAIs eigene „indexierte und gecachte Webinhalte“ zurück, außerdem auf externe Suchanbieter und Partnerinhalte. OpenAI nennt Microsoft und Shopify unter den Anbietern, an die umformulierte Anfragen gehen können.
- Nicht öffentlich: der Mix. Berichte über einen internen Index namens „Labrador“ und über Tests, die ihn gegen externe Ergebnisse abwägen, stammen aus Drittanbieter-Analysen, nicht von OpenAI.
- OAI-SearchBot ist der entscheidende Schalter für die Suche. Sperrst du ihn, tauchen deine Seiten nicht mehr in Antworten der ChatGPT-Suche auf. Wer GPTBot blockiert, widerspricht nur dem Modelltraining.
- Zitationen sind instabil. In unserem Tracking erschienen im Median nur 7,7 % der Domains, die ChatGPT für einen Prompt zitierte, in jedem Durchlauf dieses Prompts.
- Zähl die UTM, nicht den Referrer. 39 % der ChatGPT-getaggten Seitenaufrufe, die unser Tag erfasst hat, kamen ganz ohne Referrer an.
So liest du diesen Artikel: bestätigt vs. berichtet
Jede Aussage unten trägt eines von drei Labels. Denn in der Diskussion über die ChatGPT-Suche wird beides munter vermischt – und genau so verbreiten sich schlechte Tipps:
- Bestätigt – von OpenAI selbst im Help Center, in der Entwicklerdokumentation, in Release Notes oder Ankündigungen.
- Berichtet – Drittanbieter-Forschung, Reverse Engineering des Netzwerkverkehrs von ChatGPT, von Journalisten wiedergegebene Zeugenaussagen vor Gericht oder Aussagen aus zweiter Hand. Oft glaubwürdig, aber nie offiziell.
- Unsere Daten – aggregierte, anonymisierte Zahlen aus dem Prompt-Tracking und dem JavaScript-Tag von AI Rank Lab, jeweils mit Methode und Stichprobengröße direkt neben der Zahl.
Wie funktioniert die ChatGPT-Suche Schritt für Schritt?
Kurz gesagt ist es eine Retrieval-Pipeline: Entscheidung für die Suche, Umformulierung der Anfrage, Abruf aus mehreren Quellen, Ranking und schließlich eine geschriebene Antwort mit Quellenangaben. Hier jeder Schritt mit seinem Beleggrad.
- Entscheiden, ob gesucht wird. Bestätigt: Laut OpenAIs Hilfeartikel Searching the web with ChatGPT kann ChatGPT automatisch suchen, wenn eine Frage von aktuellen Informationen profitiert. Du kannst die Suche auch erzwingen, indem du im Tools-Menü „Search“ wählst oder im Eingabefeld „/“ tippst. Berichtet: Das Reverse Engineering von RESONEO aus dem Februar 2026 beschreibt einen Klassifikator, der jeden Prompt bewertet und ab einem Schwellenwert die Suche auslöst.
- Den Prompt in Suchanfragen umschreiben. Bestätigt: Nutzt ChatGPT Partner-Suchanbieter, formuliert es deine Frage meist in eine oder mehrere gezielte Anfragen um. Nach dem Lesen der ersten Ergebnisse kann es spezifischere Folgeanfragen schicken, einen ungefähren Standort ergänzen, der aus deiner IP-Adresse abgeleitet wird (nicht die IP selbst), und beim Umformulieren gespeicherte Erinnerungen verwenden. Das ist Query Fan-out, den wir in unserem Leitfaden zu Query Fan-out ausführlich erklären.
- Kandidatenseiten abrufen. Bestätigt: Die Ergebnisse stammen von externen Suchanbietern, von Inhalten, die Partner direkt liefern, und aus OpenAIs eigenen indexierten und gecachten Webinhalten. Berichtet: welche Anbieter genau und mit welchem Anteil (siehe nächster Abschnitt).
- Die Kandidaten ranken. Bestätigt: OpenAI sagt, ChatGPT ordnet Suchergebnisse nach mehreren Faktoren, die relevante und verlässliche Informationen nach oben bringen sollen, und eine Platzierung ist nicht garantiert. Die Faktoren selbst hat OpenAI nicht veröffentlicht. Berichtet: RESONEO beschreibt, dass Ergebnisse mehrerer Engines per Reciprocal Rank Fusion zusammengeführt werden, einer gängigen Technik zum Kombinieren gerankter Listen.
- Antwort schreiben und Quellen zitieren. Bestätigt: Antworten mit Websuche können Inline-Zitationen enthalten, einen Sources-Button mit den zitierten Quellen und weiteren relevanten Links, Quellenlinks zu Bildern und auf dem Smartphone Karten. Das Modell, das die Antwort schreibt, hat sich mit der Zeit geändert: Zum Start 2024 war es ein feinabgestimmtes GPT-4o, und seit dem Release vom 7. Oktober 2026 läuft der Chat in ChatGPT mit GPT-6 (Sol in den Bezahltarifen, Luna in Free und Go) und einer neuen „Intelligent UI“, die mit Diagrammen, Vergleichen und interaktiven Elementen antworten kann.
Wann sucht ChatGPT im Web, statt aus dem Gedächtnis zu antworten?
ChatGPT sucht, wenn es meint, dass eine Frage frische oder sehr konkrete Informationen braucht – etwa News, Preise, Spielstände, lokale Ergebnisse oder alles, was gerade erst passiert ist. Ansonsten antwortet es aus seinen Trainingsdaten. Du kannst diese Einschätzung übergehen, indem du die Suche manuell auswählst oder ChatGPT ausdrücklich bittest, im Web zu suchen.
Wie oft passiert das in der Praxis? Berichtet: Profounds Studie zu US-englischen ChatGPT-Unterhaltungen (Oktober bis Dezember 2025; rund 730.000 der Unterhaltungen enthielten mindestens eine Web-Zitation) ergab, dass etwa 18 % der Unterhaltungen mindestens eine Websuche auslösten. Außerdem sinkt die Chance auf eine Antwort mit Quellen, je länger ein Gespräch dauert: 12,6 % der ersten Antworten enthielten Zitationen, bei der zehnten waren es nur noch 4,5 %.
Daraus folgen zwei praktische Dinge. Erstens: Wenn ChatGPT nicht sucht, ändert nichts, was du heute an deiner Website anpasst, etwas an dieser Antwort, denn sie stammt aus den Trainingsdaten – und genau diesen Teil steuert GPTBot. Zweitens: Die Eröffnungsfrage eines Gesprächs ist der Moment, in dem eine Suche und damit eine Zitation am wahrscheinlichsten ist.
Woher kommen die Ergebnisse der ChatGPT-Suche?
Die Ergebnisse der ChatGPT-Suche stammen aus einer Mischung aus OpenAIs eigenem Index und Cache, externen Suchanbietern und lizenzierten oder Partnerdaten. Dass es alle drei gibt, hat OpenAI bestätigt. Wie oft welche Quelle genutzt wird, hat OpenAI nicht offengelegt – und der Anteil dürfte bei News, Shopping, lokalen und allgemeinen Anfragen unterschiedlich sein.
Was OpenAI bestätigt hat
- Externe Anbieter und Partnerinhalte. Der Launch-Post vom 31. Oktober 2024 sagt, dass die ChatGPT-Suche externe Suchanbieter nutzt sowie Inhalte, die Partner direkt bereitstellen. Hinter Wetter, Aktien, Sport, News und Karten stehen News- und Datenpartner.
- Namentlich genannte Anbieter. Der aktuelle Hilfeartikel verweist auf die Datenschutzrichtlinien von Microsoft und Shopify als Suchanbieter, die umformulierte Anfragen erhalten können. Bei Restaurantreservierungen zeigt ChatGPT die Verfügbarkeit von OpenTable, Resy und Yelp.
- OpenAIs eigener Index und Cache. OpenAIs Hilfeartikel zur Offline-Websuche für ChatGPT-Workspaces beschreibt einen Modus, in dem ChatGPT „OpenAIs indexierte und gecachte Webinhalte“ durchsucht, statt einen Live-Anbieter abzufragen. Dort steht auch, dass es für keine bestimmte URL eine Aktualisierungsgarantie gibt und die Abdeckung je nach Website, Sprache, Region und Inhaltstyp schwankt.
Hat ChatGPT einen eigenen Suchindex?
Ja. OpenAIs eigene Dokumentation beschreibt einen Index und Cache, den OpenAI pflegt, und für das Befüllen betreibt OpenAI einen eigenen Such-Crawler: OAI-SearchBot. Unbestätigt ist, wie viel der alltäglichen ChatGPT-Suche für Endnutzer aus diesem Index beantwortet wird und wie viel von externen Anbietern.
Die besten öffentlichen Belege dazu stammen von Dritten:
- Berichtet: Im Verfahren um Abhilfemaßnahmen im Google-Kartellprozess zur Suche sagte Nick Turley, Head of Product für ChatGPT bei OpenAI, im April 2025 aus, dass OpenAI einen eigenen Index aufbaue, dass es wohl Jahre dauern werde, bis man sich voll darauf verlassen könne, und dass Google OpenAIs Anfrage nach Zugang zur Such-API aus dem Jahr 2024 abgelehnt habe (Tech Policy Press).
- Berichtet: Die Analyse von Peec AI aus dem September 2026 fand zwischen dem 21. Mai und dem 21. Juli 2026 in den Server-Sent Events von ChatGPT ein Feld
result_sourcemit vier Werten: Labrador, Bright, Oxylabs und SERP. Peec deutet Labrador als Familie vertikaler OpenAI-Indizes (Web, PDF, YouTube, News, Wikipedia, arXiv, Lokal, Finanzen, Recht, Medizin, Shopping, Bilder) und die anderen drei als externe Scraping-Kanäle. Wie oft welcher Wert auftrat, gibt Peec nicht an. - Berichtet: Peec und Otterly AI beschreiben ein Experiment namens
prefer-index-over-serp-v3, das offenbar OpenAIs Index gegen Ergebnisse von Drittanbietern testet; Otterly beziffert es für August 2026 auf etwa 8 % der Unterhaltungen. Search Engine Watch bat OpenAI um eine Stellungnahme und hatte bis zur Veröffentlichung keine Antwort.
Nutzt die ChatGPT-Suche Bing oder Google?
Microsoft ist ein offengelegter Suchanbieter, Google nicht. OpenAIs Help Center verweist für die Suche auf die Datenschutzerklärung von Microsoft, und laut Otterly und Peec unterstützt Microsofts im Juni 2026 angekündigte Grounding-Plattform Web IQ auch ChatGPT. Diese Aussage haben wir in keiner Primärquelle von Microsoft gefunden, behandle sie also als berichtet. Laut Turleys Aussage gibt es keine Partnerschaft zwischen Google und OpenAI, trotzdem berichten mehrere Forschende (RESONEO, Peec), dass Google-Ergebnisse über Scraping-Anbieter bei ChatGPT landen. Bestätigt hat OpenAI das nicht.
Was das für dich heißt: Gute Rankings in Bing oder Google helfen, dass die Anbieter, die ChatGPT nutzen kann, deine Seiten finden. Ein verlässlicher Ersatz für Sichtbarkeit in ChatGPT ist aber keins von beiden. Du musst ChatGPT direkt messen.
| Aussage | Status | Quelle | Datum |
|---|---|---|---|
| ChatGPT nutzt externe Suchanbieter und Partnerinhalte | Bestätigt | OpenAI-Launch-Post | 31. Okt. 2024 |
| Microsoft und Shopify sind Suchanbieter, die Anfragen erhalten können | Bestätigt | OpenAI Help Center | Geprüft am 18. Okt. 2026 |
| OpenAI pflegt eigene indexierte und gecachte Webinhalte | Bestätigt | OpenAI Help Center (Offline-Websuche) | Geprüft am 18. Okt. 2026 |
| OAI-SearchBot crawlt, um Websites in der ChatGPT-Suche anzuzeigen | Bestätigt | OpenAI-Entwicklerdokumentation | Geprüft am 18. Okt. 2026 |
| OpenAI baut einen eigenen Index auf; volle Abhängigkeit davon liegt Jahre entfernt | Berichtet (Zeugenaussage vor Gericht) | Tech Policy Press | Apr. 2025 |
| Interne Index-Familie „Labrador“ plus die Kanäle Bright, Oxylabs und SERP | Berichtet (Netzwerkanalyse) | Peec AI | Sep. 2026 |
| Experiment, das OpenAIs Index gegen externe Ergebnisse testet (~8 % der Chats) | Berichtet | Peec AI, Otterly AI | Aug.–Sep. 2026 |
| Microsoft Web IQ liefert das Grounding für ChatGPT-Antworten | Berichtet, von uns nicht in einer Microsoft-Quelle bestätigt | Otterly AI, Peec AI | Jun. 2026 |
| Google-Ergebnisse gelangen über Scraping-Anbieter zu ChatGPT | Berichtet, unbestätigt | RESONEO, Peec AI | 2026 |
Was ist der Unterschied zwischen OAI-SearchBot, GPTBot und ChatGPT-User?
OAI-SearchBot entscheidet, ob du in der ChatGPT-Suche auftauchen kannst. GPTBot entscheidet, ob deine Inhalte zum Training von OpenAIs Modellen verwendet werden dürfen. ChatGPT-User ist der Agent, der eine Seite abruft, wenn jemand ChatGPT bittet, sie zu öffnen. Die drei sind unabhängig voneinander: Du kannst einen zulassen und einen anderen sperren. OpenAIs Crawler-Dokumentation nennt außerdem einen vierten Agenten, OAI-AdsBot, für Anzeigen in ChatGPT.
| User-Agent | Was er tut (laut OpenAI) | Was robots.txt steuert | IP-Liste |
|---|---|---|---|
| OAI-SearchBot | Crawlt, um Websites in den Suchfunktionen von ChatGPT anzuzeigen | Sperrst du ihn per Disallow, werden deine Seiten nicht in Antworten der ChatGPT-Suche gezeigt, können aber weiterhin als einfache Navigationslinks erscheinen. Änderungen greifen nach etwa 24 Stunden. | openai.com/searchbot.json |
| GPTBot | Crawlt Inhalte, die zum Training von OpenAIs Foundation Models genutzt werden können | Per Disallow signalisierst du, dass deine Inhalte nicht fürs Training verwendet werden sollen. Auf die Sichtbarkeit in der Suche hat das keinen Einfluss. | openai.com/gptbot.json |
| ChatGPT-User | Von Nutzern ausgelöste Besuche, etwa wenn jemand ChatGPT bittet, eine Seite zu lesen, oder bei GPT Actions | robots.txt-Regeln gelten unter Umständen nicht, weil ein Mensch den Besuch ausgelöst hat. Wird nicht genutzt, um über die Aufnahme in die Suche zu entscheiden. | openai.com/chatgpt-user.json |
| OAI-AdsBot | Prüft Landingpages, die als ChatGPT-Anzeigen eingereicht wurden; besucht nur diese Seiten | Nur relevant, wenn du in ChatGPT wirbst. Seine Daten werden nicht zum Training von Foundation Models verwendet. | openai.com/adsbot.json |
Ein typisches Setup für eine Website, die in der ChatGPT-Suche sichtbar sein will, aber kein Training erlaubt, sieht so aus:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Zwei Details aus OpenAIs Doku, die viele übersehen: Wenn du beide Bots zulässt, kann OpenAI einen einzigen Crawl für beide Zwecke nutzen. Und beim Abruf der robots.txt selbst kann der User-Agent-String einen zusätzlichen Vermerk „robots.txt“ enthalten. Ein vollständiges Regelwerk für alle KI-Crawler findest du in unserem robots.txt-Leitfaden für KI-Crawler oder im kostenlosen robots.txt-Generator. Wie du echten Bot-Traffic in deinen Logs verifizierst, zeigt unser Leitfaden zum Monitoring von GPTBot, ClaudeBot und PerplexityBot.
Wie wählt ChatGPT aus, welche Quellen es zitiert?
OpenAI sagt nur, dass ChatGPT Ergebnisse nach mehreren Faktoren rankt, die auf Relevanz und Verlässlichkeit zielen, und dass eine Platzierung nicht garantiert ist. Eine veröffentlichte Liste mit Rankingfaktoren gibt es nicht, ein Einreichungstool auch nicht. Messen lässt sich aber das Muster der Zitationen.
Berichtet: In Profounds dreimonatiger Studie nutzte eine Antwort mit Quellen im Schnitt etwa vier verschiedene Quellen, und 66 % der zitierenden Antworten nutzten zwischen einer und vier. Die Zitationen waren breit verteilt: Die zehn größten Domains kamen zusammen nur auf 12 % aller Zitationen, Wikipedia auf etwa 5 % und Reddit auf etwa 3 %.
Unsere Daten: Bei 11 ChatGPT-Prompts, die AI Rank Lab jeweils mindestens fünfmal ausgeführt hat (239 erfolgreiche Durchläufe, 13. Februar bis 14. Oktober 2026), lag die mediane Überschneidung der zitierten Domains zwischen aufeinanderfolgenden Durchläufen desselben Prompts bei 0,54 (Jaccard-Ähnlichkeit, wobei 1 identisch bedeutet). Im Median tauchten nur 7,7 % der Domains, die ChatGPT für einen Prompt zitierte, in jedem Durchlauf auf, und bei 6 der 11 Prompts wechselte mindestens einmal, ob die getrackte Marke erwähnt wurde oder nicht. Es handelt sich um automatisierte Durchläufe, die nicht unbedingt den personalisierten Ergebnissen eines eingeloggten Nutzers entsprechen; die vollständige Methode steht in unserer Studie zur Konsistenz von KI-Antworten.
Die Konsequenz: „Werden wir von ChatGPT zitiert?“ ist die falsche Frage. Hilfreich ist: „In welchem Anteil wiederholter Durchläufe werden wir zitiert, und bei welchen Prompts?“ Ein einzelner manueller Check sagt dir so gut wie nichts.
Wie trackst du Traffic aus der ChatGPT-Suche?
Erfasse Besuche aus ChatGPT über den Parameter utm_source=chatgpt.com, den ChatGPT an ausgehende Links hängt, und nicht über den Referrer. OpenAIs Publisher-FAQ hat den Parameter dokumentiert (am 18. Oktober 2026 konnten wir diese Seite nicht laden, wir stützen uns also auf frühere Fassungen und auf unsere eigenen Beobachtungen), und im echten Traffic ist er deutlich zu sehen.
Unsere Daten: Zwischen dem 27. Juli 2025 und dem 18. Oktober 2026 hat das JavaScript-Tag von AI Rank Lab auf 29 Websites 2.710 Seitenaufrufe mit utm_source=chatgpt.com erfasst, gegenüber 2.087 Seitenaufrufen mit chatgpt.com als Referrer auf 26 Websites. Von den 2.710 getaggten Seitenaufrufen kamen 1.048 (39 %) ganz ohne Referrer. Eine Analyse, die nur auf den Referrer schaut, hätte diese Besuche unter Direct verbucht.
Schau in GA4 auf die Sitzungsquelle gleich chatgpt.com, die die UTM erfasst, und lege eine Channel-Gruppe an, die sie einschließt. Unsere Seite zum Tracking von KI-Referral-Traffic in GA4 zeigt das Setup, und das KI-Bot-Tracking erfasst Verweise von KI-Assistenten pro Seite, ganz ohne GA4.
Was ist im Oktober 2026 mit den UTM-Tags von ChatGPT passiert?
Etwa eine Woche nach dem Start von GPT-6 gingen viele ChatGPT-Links ohne UTM-Tag raus, sodass Besuche, die vorher ChatGPT zugeordnet wurden, plötzlich als Direct auftauchten. Am 15. und 16. Oktober kamen die Tags zurück. Bis auf das Startdatum von GPT-6 stammt jedes Detail davon von Dritten; OpenAI hat sich nicht öffentlich geäußert, und die Release Notes erwähnen es nicht.
| Datum (2026) | Was passiert ist | Status | Quelle |
|---|---|---|---|
| 7.–8. Okt. | GPT-6 und Intelligent UI werden für Bezahltarife ausgerollt, danach für Free und Go | Bestätigt | OpenAI Release Notes |
| 8. Okt., ~18:30 UTC | Der Anteil der Antworten mit getaggten Links beginnt, von etwa 99 % abzurutschen | Berichtet | Profound |
| 9.–13. Okt. | Auf rund 500 Seiten sinken die ChatGPT-Besuche um ~31.000 pro Tag, während Direct um ~26.000 pro Tag steigt | Berichtet | Cedric Huesler von Adobe, via SEJ |
| 14. Okt. | Huesler sagt, OpenAI habe ihm gegenüber von einem bekannten Bug gesprochen | Berichtet (aus zweiter Hand) | SEJ |
| 14. Okt., ~19:00 UTC | Getaggte Antworten fallen auf 5–10 %, während Antworten mit Intelligent UI 92–96 % erreichen | Berichtet | Profound |
| 15.–16. Okt. | Fix wird ausgerollt; getaggte Antworten sind am 16. Okt. um 06:30 UTC wieder bei etwa 99 % | Berichtet | Profound, SEJ |
Quellen: Search Engine Journal, 15. Oktober 2026 und Profounds Timeline des Vorfalls.
Unsere Daten: Unsere Stichprobe für diesen Zeitraum ist klein, lies sie also als Plausibilitätscheck, nicht als Messung. Vom 9. bis 18. Oktober sah unser Tag 52 ChatGPT-getaggte Seitenaufrufe auf zwei Websites, und keiner davon hatte chatgpt.com als Referrer. In den 30 Tagen davor (9. September bis 8. Oktober) hatten 236 von 368 getaggten Seitenaufrufen auf sieben Websites (64 %) einen. Das passt zu Berichten, dass die meisten ChatGPT-Klicks auch nach der Rückkehr der Tags ohne Referrer ankommen.
Was du tun solltest: Markiere den 8. bis 16. Oktober in deinen Reports, vergleiche den Direct-Traffic auf den Landingpages, auf die ChatGPT normalerweise verweist, bevor du von verlorenem Traffic sprichst, und zähl weiterhin die UTM statt des Referrers.
Wie machst du deine Website fit für die ChatGPT-Suche?
Ob du überhaupt infrage kommst, hängt davon ab, dass OAI-SearchBot deine Seiten erreichen und lesen kann. OpenAIs Help Center sagt es ganz klar: OAI-SearchBot in der robots.txt zulassen und sicherstellen, dass dein Hoster oder CDN Traffic von den veröffentlichten IP-Adressen des Suchbots durchlässt. Alles Weitere auf dieser Liste verbessert deine Chancen, nicht deine grundsätzliche Eignung.
- OAI-SearchBot in der robots.txt zulassen und die Entscheidung zu GPTBot getrennt treffen. Prüfe, ob breite
User-agent: *-Regeln ihn versehentlich blockieren. - OpenAIs IP-Bereiche im CDN, in der Firewall oder im Bot-Schutz freigeben. Viele Schalter à la „KI-Bots blockieren“ sperren auch OAI-SearchBot. Gleiche 403- oder 429-Antworten in deinen Logs mit openai.com/searchbot.json ab.
- Den Hauptinhalt ins HTML packen. OpenAI nennt starke Abhängigkeit von Skripten, dynamisches Nachladen, Logins und Personalisierung als Gründe, warum der Index eine Seite verpassen kann. Rendere wichtige Seiten serverseitig oder per Prerendering.
- Tiefe Seiten leicht auffindbar machen. Auch eine Seitenstruktur, die tiefere Seiten versteckt, führt OpenAI auf. Verlinke wichtige Seiten von Hub-Seiten aus und halte deine XML-Sitemap aktuell.
- Seiten aktuell und datiert halten. OpenAI nennt keinen Aktualisierungsrhythmus pro URL und sagt, die Aktualität hänge von Website, Crawl-Zugriff, Caching und Popularität ab. Sichtbare „Aktualisiert am“-Daten helfen Lesern und jedem System, das Aktualität gewichtet.
- Antwort zuerst, in sich geschlossene Abschnitte schreiben. Das ist Konsens unter Praktikern, keine OpenAI-Empfehlung: Ein Abschnitt, der seine Überschrift im ersten Satz beantwortet, lässt sich leichter zitieren. Unser 30-Tage-Playbook für ChatGPT-Zitationen deckt die Content-Seite ab.
- In den Daten präsent sein, die ChatGPT für deine Branche abruft. Restaurants zeigen Verfügbarkeiten von OpenTable, Resy und Yelp; Shopify ist ein offengelegter Anbieter fürs Shopping. Wenn das auf dich zutrifft, gehören deine Einträge dort zu deiner Sichtbarkeit in ChatGPT.
- Prüfen, ob OAI-SearchBot wirklich vorbeikommt. Filtere deine Server-Logs nach dem Token OAI-SearchBot und verifiziere die IPs. Dann tracke, welche URLs ChatGPT für deine Ziel-Prompts zitiert.
Um die Schritte 3 bis 5 für eine ganze Website zu prüfen, crawlt das AEO-Audit deine Seiten und markiert Probleme bei SEO sowie bei der Eignung für Answer Engines und generative Engines, jeweils mit Lösungsvorschlägen. Für die zweite Hälfte von Schritt 8 erfasst das Citation-Tracking, welche deiner URLs ChatGPT für deine Prompts zitiert.
Warum taucht meine Seite nicht in der ChatGPT-Suche auf?
Die häufigsten Gründe sind eine Crawl-Sperre, eine CDN- oder Firewall-Regel, Inhalte, die erst nach dem Ausführen von JavaScript erscheinen, und Seiten, die neu, tief vergraben oder kaum verlinkt sind. Genau diese Punkte nennt OpenAI in der Dokumentation zur Offline-Websuche als Gründe, warum Seiten im Index fehlen oder veraltet sein können. Die Liste ist eigentlich für Workspace-Admins gedacht, aber sie ist die einzige Stelle, an der OpenAI erklärt, warum der Index Seiten verpasst – und taugt damit auch als Diagnose-Checkliste.
| Grund laut OpenAI | So prüfst du es | Lösung |
|---|---|---|
| robots.txt oder ähnliche Steuerungen blockieren das Crawling | /robots.txt öffnen; nach OAI-SearchBot oder einem pauschalen Disallow suchen | OAI-SearchBot zulassen; etwa 24 Stunden warten |
| CDN- oder Bot-Blocking-Verhalten | Logs nach OAI-SearchBot-Anfragen mit 403, 429 oder Challenge-Seiten durchsuchen | Die Bereiche aus openai.com/searchbot.json auf die Allowlist setzen |
| Seite erfordert Login oder Personalisierung | Seite im privaten Fenster und ausgeloggt laden | Eine öffentliche Version der wichtigsten Inhalte veröffentlichen |
| Inhalt hängt von Skripten oder dynamischem Nachladen ab | Rohes HTML mit curl abrufen und prüfen, ob der Haupttext enthalten ist | Serverseitiges Rendering oder Prerendering |
| Seite ist neu, wird selten aufgerufen oder sendet wenig Signale | Veröffentlichungsdatum sowie interne und externe Links auf die Seite prüfen | Von starken Seiten aus verlinken; Erwähnungen verdienen; Zeit geben |
| Seitenstruktur versteckt tiefere Seiten | Klicks ab der Startseite zählen; Sitemap prüfen | Hub-Links ergänzen und Sitemap aktuell halten |
Ist jede Zeile in Ordnung und wirst du trotzdem nicht zitiert, liegt das Problem meist bei Relevanz oder Wettbewerb, nicht beim Zugriff: Eine andere Seite beantwortet den Prompt direkter, oder ChatGPT sucht für diesen Prompt gar nicht erst.
Was kannst du bei der ChatGPT-Suche nicht kontrollieren?
Du kontrollierst den Zugang und die Qualität deiner Inhalte. Das meiste, was danach passiert, liegt nicht in deiner Hand. Konkret kannst du nicht steuern:
- Ob ChatGPT überhaupt sucht. Das entscheidet ChatGPT, es sei denn, der Nutzer erzwingt die Suche.
- Welcher Anbieter antwortet. OpenAIs Index, Microsoft, Shopify, Partner oder die berichteten Scraping-Kanäle – in einem nicht offengelegten Mix, den OpenAI offenbar aktiv testet.
- Ranking und Zitation. Es gibt keine veröffentlichte Faktorenliste und keine Garantie, und unsere Daten zeigen, dass sich Zitationen von Durchlauf zu Durchlauf ändern.
- Indexierungstempo. OpenAI dokumentiert kein Tool zum Einreichen von URLs, keinen Bericht zur Indexabdeckung und keine Aktualisierungsgarantie für eine bestimmte URL.
- Antworten aus Trainingsdaten. Wenn ChatGPT aus dem Gedächtnis antwortet, spielen deine heutigen Änderungen an der Seite keine Rolle.
- Besuche von ChatGPT-User. Für von Nutzern ausgelöste Abrufe gilt robots.txt unter Umständen nicht.
- Navigationslinks. Selbst wenn du OAI-SearchBot sperrst, kann deine Website weiterhin als Navigationslink erscheinen.
- Link-Tagging. Wie der Oktober 2026 gezeigt hat, kann die Attribution ohne Vorwarnung kaputtgehen.
Wie überwachst du, welche URLs ChatGPT zitiert?
Weil die Ergebnisse von Durchlauf zu Durchlauf schwanken, heißt Monitoring: dieselben Prompts immer wieder ausführen und Erwähnungen und zitierte URLs über die Zeit festhalten. Bei einer Handvoll Prompts klappt das von Hand in einem ausgeloggten Browser; darüber hinaus spart ein Tool Zeit.
Transparenzhinweis: AI Rank Lab ist unser Produkt. Wir nennen es zuerst, weil das hier unsere Website ist, und haben für jedes Tool unten dieselben Kriterien angelegt.
- AI Rank Lab – führt deine Prompts nach Zeitplan in ChatGPT, Claude, Gemini und Perplexity aus, dazu in Google AI Overviews und AI Mode, und erfasst Erwähnungen, Position, Wettbewerber und zitierte URLs. Außerdem verbindet es das Tracking über Audits, einen Action Plan und Content-Publishing mit konkreten Fixes. Mehr dazu beim Tracking der Markensichtbarkeit.
- Profound – auf Enterprise ausgerichtet und Herausgeber einiger der größten öffentlichen Datensätze zu ChatGPT-Zitationen, etwa der oben zitierten Studie.
- Peec AI – stark in der Erforschung der Mechanik, inklusive der detailliertesten öffentlichen Analyse von ChatGPTs Index.
- Otterly AI – veröffentlicht regelmäßig GEO-Experimente und deckt mehrere KI-Engines ab.
Methodik und Grenzen
Am 18. Oktober 2026 haben wir OpenAIs Help-Center-Artikel zu Websuche, Offline-Websuche und Release Notes, OpenAIs Crawler-Dokumentation und den Launch-Post von 2024 gelesen und 15 rankende Artikel und Berichte darüber ausgewertet, wie die ChatGPT-Suche funktioniert. Erkenntnisse von Dritten tragen das Label „berichtet“, weil keine davon von OpenAI bestätigt wurde; einige stammen von Unternehmen, die wie wir Tools für KI-Sichtbarkeit verkaufen. OpenAIs Publisher-FAQ konnten wir am Tag der Recherche nicht laden, und die Rolle von Microsoft Web IQ in ChatGPT konnten wir in keiner Primärquelle von Microsoft bestätigen. Unsere eigenen Zahlen stammen von einer kleinen Zahl an Websites und Prompts, sind aggregiert und anonymisiert und werden mit ihren Stichprobengrößen angegeben; sie beschreiben den Traffic unserer Kunden, nicht das Web als Ganzes.
Wenn du sehen willst, welche deiner Seiten ChatGPT für die Prompts, auf die es dir ankommt, tatsächlich zitiert und wie sich das von Woche zu Woche verändert, starte dein Tracking mit AI Rank Lab.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


