



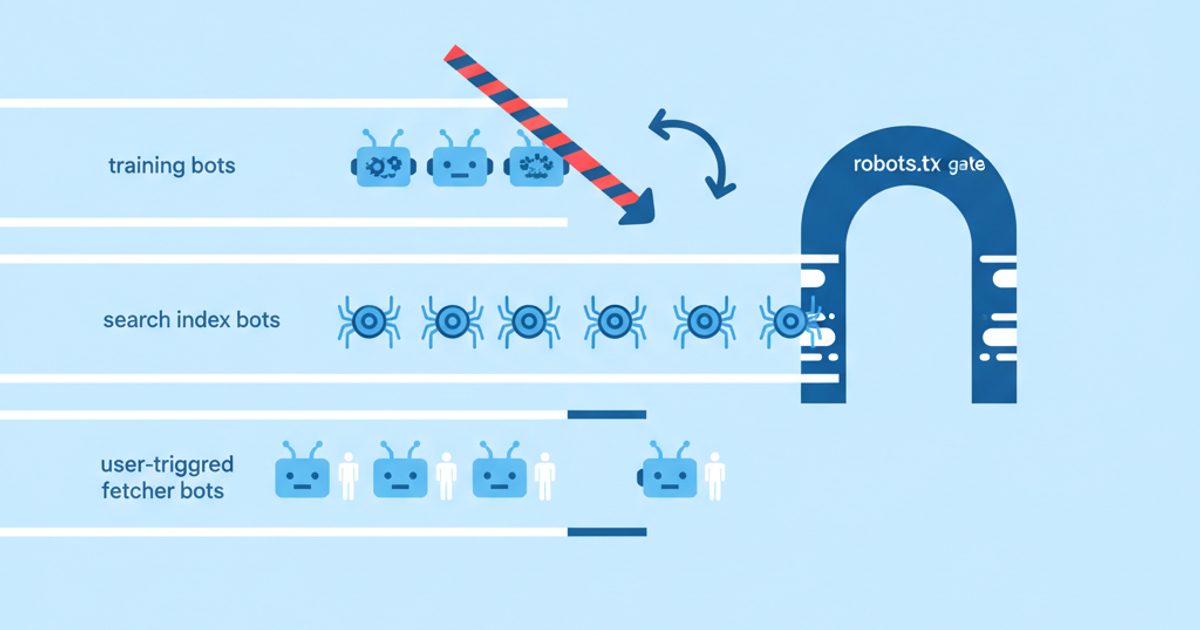
Les crawlers IA sont des robots automatisés, exploités par les entreprises d'IA, qui récupèrent vos pages pour l'une de ces trois missions : collecter des données d'entraînement pour leurs modèles (GPTBot, ClaudeBot), construire l'index de recherche sur lequel s'appuient les réponses des IA et leurs citations (OAI-SearchBot, Claude-SearchBot, PerplexityBot), ou lire une page en direct parce qu'un utilisateur a interrogé un assistant à son sujet (ChatGPT-User, Claude-User, Perplexity-User). Bloquer un crawler d'entraînement tient votre contenu à l'écart des futurs modèles ; bloquer un crawler de recherche ou un fetcher utilisateur vous fait disparaître des réponses et des citations des IA. Toute la décision tient dans cette nuance.
Cette page est une référence opérationnelle. Chaque user agent ci-dessous a été vérifié le 18 octobre 2026 dans la documentation officielle de son opérateur, avec le lien vers la page concernée. Vous y trouverez aussi une matrice de décision selon votre objectif business, des groupes robots.txt prêts à copier-coller, la méthode de vérification que propose chaque opérateur (avec la date inscrite dans chaque liste d'IP publiée), et une explication franche de la raison pour laquelle vos outils d'analytics en JavaScript ne voient pas la majeure partie du trafic des crawlers.
L'essentiel à retenir
- Rangez chaque bot IA dans l'une de trois catégories : entraînement, recherche/indexation ou déclenché par l'utilisateur. OpenAI, Anthropic, Amazon, Meta et Mistral publient un jeton distinct pour chaque catégorie : vous pouvez donc en bloquer une sans toucher aux autres.
- Bloquer GPTBot ne vous retire pas de la recherche ChatGPT. Selon OpenAI, seul OAI-SearchBot la contrôle, et les sites qui ont exclu OAI-SearchBot peuvent encore apparaître sous forme de liens de navigation.
- Google-Extended et Applebot-Extended sont des jetons de contrôle, pas des crawlers. Ils n'apparaissent jamais dans vos logs, et Google précise que Google-Extended n'a aucun effet sur Google Search, ce qui inclut les AI Overviews et l'AI Mode.
- Les fetchers déclenchés par l'utilisateur peuvent ignorer le robots.txt, et c'est voulu : OpenAI, Perplexity, Google, Meta et Amazon l'écrivent noir sur blanc dans leur documentation. Pour un blocage strict, passez par un WAF.
- La plupart des crawlers IA n'exécutent pas le JavaScript : un tag analytics en JS les sous-estime donc forcément. Pour mesurer l'activité des crawlers, ce sont les logs serveur ou CDN qui font foi.
- Vérifiez les bots par reverse DNS (Google, Apple, Common Crawl) ou en comparant l'IP à la liste JSON publiée par l'opérateur. Certaines de ces listes datent de plusieurs années : retéléchargez-les à intervalles réguliers.
Crawlers IA : de quoi parle-t-on, et quelles sont les trois catégories ?
Un crawler IA, c'est n'importe quel client automatisé qu'une entreprise d'IA utilise pour demander vos pages. Les opérateurs séparent désormais leurs bots selon leur finalité, et c'est cette finalité qui détermine ce qu'un blocage vous coûte. Les données réseau de Cloudflare montrent à quel point la répartition est déséquilibrée : sur les 12 mois précédant la mi-2025, 80 % du crawl IA servait à l'entraînement, 18 % à la recherche et 2 % aux actions des utilisateurs, la part de l'entraînement grimpant à 82 % sur les six derniers mois de cette période.
Les crawlers d'entraînement
Les crawlers d'entraînement collectent du contenu susceptible de servir à entraîner ou à affiner des modèles de fondation. On y trouve GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training et CCBot (le jeu de données ouvert de Common Crawl, utilisé par de nombreux concepteurs de modèles). Les bloquer signale que vos futurs contenus doivent rester hors des jeux d'entraînement. Cela ne supprime pas ce qui a déjà été collecté, et cela ne change rien à la possibilité pour la recherche IA de vous citer.
Les crawlers de recherche et d'indexation
Les crawlers de recherche construisent l'index de récupération sur lequel reposent les réponses des IA, et vers lequel pointent leurs citations. OAI-SearchBot (recherche ChatGPT), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index et DuckAssistBot sont spécifiques à l'IA. Googlebot, Bingbot et Applebot sont des crawlers de recherche classiques dont l'index alimente désormais aussi des fonctionnalités IA : les AI Overviews (les Aperçus IA de Google) et l'AI Mode, Microsoft Copilot et les réponses de Siri. Bloquer un crawler de recherche, c'est l'erreur qui coûte cher, car elle vous efface des réponses que lisent vos acheteurs. Pour comprendre concrètement comment l'un de ces index est exploité, lisez comment fonctionne la recherche ChatGPT.
Les fetchers et agents déclenchés par l'utilisateur
Les fetchers déclenchés par l'utilisateur visitent une URL précise parce qu'une personne a demandé à un assistant de la lire, de la résumer ou d'agir dessus. ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User et MistralAI-User entrent dans cette catégorie, tout comme les agents de navigation signés, tels que le Cloud browser de ChatGPT. Plusieurs opérateurs indiquent que le robots.txt peut ne pas s'appliquer à ces bots, puisque c'est un humain qui a lancé la requête.
Les jetons de contrôle, qui ne sont pas des crawlers
Deux noms présents sur toutes les listes ne récupèrent jamais rien eux-mêmes. Google-Extended est un jeton produit du robots.txt que Google lit pendant qu'il explore avec ses user agents habituels ; il détermine si votre contenu peut servir à entraîner les futurs modèles Gemini et à ancrer les réponses (grounding) dans les applications Gemini et Vertex AI. Applebot-Extended joue le même rôle pour les modèles de fondation d'Apple. Vous ne trouverez aucune de ces deux chaînes dans vos logs d'accès : voilà pourquoi « j'ai bloqué Google-Extended mais je vois toujours du trafic Google » est un comportement parfaitement normal.
La liste des crawlers IA : tous les principaux user agents, vérifiés le 18 octobre 2026
Le tableau indique le jeton à placer sur une ligne User-agent:, l'opérateur qui l'exploite, sa catégorie, ce que la documentation de l'opérateur dit du robots.txt, le moyen de le vérifier et la page officielle que nous avons consultée. « Selon la doc » signifie que la colonne robots.txt reformule les propos de l'opérateur ; quand une doc ne dit rien, nous l'indiquons plutôt que de deviner.
| Jeton | Opérateur | Catégorie | Rôle | robots.txt (selon la doc) | Vérification | Doc officielle |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Entraînement | Explore du contenu susceptible de servir à entraîner les modèles de fondation d'OpenAI | Oui | gptbot.json | Crawlers OpenAI |
| OAI-SearchBot | OpenAI | Recherche | Fait apparaître les sites dans les réponses de la recherche ChatGPT ; pas d'entraînement | Oui, changements pris en compte en 24 heures environ | searchbot.json | Crawlers OpenAI |
| ChatGPT-User | OpenAI | Déclenché par l'utilisateur | Visite des pages pour les actions des utilisateurs dans ChatGPT et les Custom GPTs | Peut ne pas s'appliquer | chatgpt-user.json | Crawlers OpenAI |
| OAI-AdsBot | OpenAI | Spécial | Contrôle les pages de destination soumises comme publicités ChatGPT ; pas d'entraînement | Non précisé ; visite uniquement les pages publicitaires soumises | adsbot.json | Crawlers OpenAI |
| ClaudeBot | Anthropic | Entraînement | Collecte du contenu pouvant contribuer à l'entraînement des modèles Claude | Oui ; prend en charge Crawl-delay | bots.json (commun) | Centre d'aide Anthropic |
| Claude-SearchBot | Anthropic | Recherche | Indexe du contenu pour améliorer les résultats de recherche de Claude | Oui | bots.json (commun) | Centre d'aide Anthropic |
| Claude-User | Anthropic | Déclenché par l'utilisateur | Récupère des pages quand un utilisateur de Claude pose une question | Oui, le désactiver bloque la récupération à la demande des utilisateurs | bots.json (commun) | Centre d'aide Anthropic |
| PerplexityBot | Perplexity | Recherche | Fait apparaître et cite les sites dans les résultats de Perplexity ; pas d'entraînement | Oui, sous 24 heures maximum | perplexitybot.json | Crawlers Perplexity |
| Perplexity-User | Perplexity | Déclenché par l'utilisateur | Visite des pages pour répondre à la question d'un utilisateur | L'ignore en général | perplexity-user.json | Crawlers Perplexity |
| Googlebot | Recherche | Google Search, y compris les AI Overviews et l'AI Mode | Oui, toujours pour les explorations automatiques | Reverse DNS ou common-crawlers.json | Robots d'exploration courants de Google | |
| Google-Extended | Jeton de contrôle | Entraînement de Gemini et grounding dans les applications Gemini et Vertex AI | Jeton uniquement ; pas de user agent propre | Sans objet | Robots d'exploration courants de Google | |
| Google-CloudVertexBot | Recherche (à la demande du propriétaire du site) | Explore les sites dont les propriétaires construisent des agents Vertex AI à partir de ceux-ci | Oui | Reverse DNS ou common-crawlers.json | Robots d'exploration courants de Google | |
| Google-Agent | Agent déclenché par l'utilisateur | Agents hébergés sur l'infrastructure Google qui naviguent et agissent à la demande de l'utilisateur | L'ignore en général (déclenché par l'utilisateur) | user-triggered-agents.json ; certaines requêtes signées avec Web Bot Auth | Fetchers Google déclenchés par l'utilisateur | |
| Google-GeminiNotebook | Déclenché par l'utilisateur | Récupère les URL que les utilisateurs ajoutent comme sources dans Gemini Notebook (ancien agent Google-NotebookLM, pris en charge jusqu'en août 2026) | L'ignore en général (déclenché par l'utilisateur) | Listes JSON des fetchers déclenchés par l'utilisateur | Fetchers Google déclenchés par l'utilisateur | |
| Bingbot | Microsoft | Recherche | Index Bing, qui sert aussi de base aux réponses de Copilot | Oui ; l'usage IA se contrôle page par page avec noarchive/nocache | bingbot.json ou l'outil Verify Bingbot de Bing | Blog Bing Webmaster |
| Applebot | Apple | Recherche (peut aussi servir à l'entraînement) | Recherche Spotlight, Siri et Safari ; les données peuvent aussi entraîner les modèles d'Apple | Oui ; suit les règles de Googlebot si Applebot n'est pas nommé ; ignore Crawl-delay | Reverse DNS (*.applebot.apple.com) ou applebot.json | À propos d'Applebot |
| Applebot-Extended | Apple | Jeton de contrôle | Exclut le contenu de l'entraînement des modèles de fondation d'Apple | Jeton uniquement | Sans objet | À propos d'Applebot |
| Meta-ExternalAgent | Meta | Entraînement | Entraînement des modèles d'IA de fondation ou indexation directe du contenu | Oui | User agent et IP publiées par Meta | Crawlers web de Meta |
| Meta-WebIndexer | Meta | Recherche | Améliore les résultats de recherche de Meta AI pour qu'il puisse vous citer et pointer vers vous | Oui | User agent et IP publiées par Meta | Crawlers web de Meta |
| Meta-ExternalFetcher | Meta | Déclenché par l'utilisateur | Récupère des liens à la demande d'un utilisateur, y compris pour des tâches agentiques | Peut le contourner | User agent et IP publiées par Meta | Crawlers web de Meta |
| Amazonbot | Amazon | Entraînement | Améliore les produits Amazon ; peut servir à entraîner les modèles d'IA d'Amazon | Oui (RFC 9309) ; ignore Crawl-delay | Page des IP publiées | Amazonbot |
| Amzn-SearchBot | Amazon | Recherche | Expériences de recherche comme Alexa ; pas d'entraînement | Oui ; hérite des règles des autres bots de recherche s'il n'est pas nommé | Page des IP publiées | Amazonbot |
| Amzn-User | Amazon | Déclenché par l'utilisateur | Récupère des informations en temps réel pour les requêtes Alexa ; pas d'entraînement | Peut ne pas suivre toutes les directives | Page des IP publiées | Amazonbot |
| MistralAI-Training | Mistral | Entraînement | Constitue des jeux de données pour entraîner les modèles Mistral | Oui, peut être bloqué par Disallow | User agent | Crawlers Mistral |
| MistralAI-Index | Mistral | Recherche | Indexe du contenu pour la recherche Mistral dans Vibe ; pas d'entraînement | Oui | mistralai-index-ips.json | Crawlers Mistral |
| MistralAI-User | Mistral | Déclenché par l'utilisateur | Visite des pages quand les utilisateurs de Vibe posent une question | Oui, détermine les sites accessibles aux requêtes des utilisateurs | mistralai-user-ips.json | Crawlers Mistral |
| DuckAssistBot | DuckDuckGo | Recherche (temps réel) | Explore des pages pour les réponses assistées par IA de DuckDuckGo ; pas d'entraînement | Oui, effectif au bout de 72 heures | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Entraînement (jeu de données ouvert) | Construit le corpus ouvert Common Crawl, largement utilisé pour entraîner des modèles | Oui | Reverse DNS (*.crawl.commoncrawl.org, IPv4 uniquement) | CCBot |
Ce tableau tranche deux questions. D'abord, la page actuelle d'Anthropic recense exactement trois bots : ClaudeBot, Claude-SearchBot et Claude-User. Des listes plus anciennes mentionnent encore « anthropic-ai » et « Claude-Web », qui ne figurent plus dans la documentation d'Anthropic en octobre 2026. Ensuite, les numéros de version d'OpenAI évoluent : le jour de notre vérification, les chaînes d'exemple d'OpenAI affichaient GPTBot/1.4 et OAI-SearchBot/1.4. Filtrez donc sur le jeton, jamais sur la chaîne complète.
Les bots sans documentation officielle
Certains bots que vous croiserez dans vos logs n'avaient, au 18 octobre 2026, aucune page d'opérateur que nous ayons pu trouver. Bytespider, de ByteDance, est le plus connu ; les agents liés à Grok, chez xAI, en sont un autre exemple. Les annuaires tiers ne s'accordent pas sur leur comportement, c'est pourquoi nous les avons écartés du tableau vérifié. Le robots.txt géré de Cloudflare inclut bien un disallow pour Bytespider, et Cloudflare a constaté que la part de Bytespider dans le crawl IA était passée de 14,1 % à 2,4 % entre la mi-2024 et la mi-2025. Si l'un de ces bots vous concerne, faites respecter votre politique avec une règle WAF plutôt qu'en comptant sur le robots.txt.
Les crawlers IA respectent-ils le robots.txt ?
Les crawlers d'entraînement et de recherche documentés affirment que oui ; les fetchers déclenchés par l'utilisateur disent souvent que non ; et dans tous les cas, le robots.txt n'est jamais un contrôle d'accès. La norme elle-même, la RFC 9309, précise que « ces règles ne constituent pas une forme d'autorisation d'accès ». Elle permet aussi aux crawlers de mettre votre fichier en cache jusqu'à 24 heures, ce qui explique que chaque opérateur annonce un délai avant la prise en compte des modifications.
Ce qu'un opérateur promet n'est pas forcément ce qu'on observe. En août 2025, Cloudflare a publié un test dans lequel des domaines tout neufs, qui interdisaient tout via Disallow, étaient malgré tout décrits en détail par Perplexity. Cloudflare dit avoir observé un agent Perplexity-User déclaré envoyant 20 à 25 millions de requêtes par jour, et un agent non déclaré se faisant passer pour Chrome en envoyant 3 à 6 millions, avant de retirer Perplexity de sa liste de bots vérifiés. C'est le constat d'un seul fournisseur sur un seul opérateur, mais il montre bien qu'une chaîne user agent, à elle seule, ne prouve rien.
| Opérateur | Délai de prise en compte du robots.txt (selon la doc) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | 24 heures environ | Non précisé |
| Perplexity | Jusqu'à 24 heures | Non précisé |
| Amazon | 24 heures environ ; peut utiliser une copie en cache vieille de 30 jours maximum | Non pris en charge |
| Meta | Jusqu'à 24 heures | Non précisé |
| DuckDuckGo (DuckAssistBot) | 72 heures | Non précisé |
| Anthropic | Non précisé | Pris en charge |
| Apple | Non précisé | Non pris en charge |
Que vous coûte le blocage de chaque catégorie de crawler IA ?
Bloquer les crawlers d'entraînement ne vous coûte pas grand-chose en visibilité aujourd'hui ; bloquer les crawlers de recherche ou les fetchers utilisateur vous fait perdre des citations immédiatement. Le tableau associe chaque catégorie au coût que décrivent les opérateurs eux-mêmes.
| Si vous bloquez… | Vous restez hors de | Vous perdez | Vous apparaissez encore dans |
|---|---|---|---|
| Les crawlers d'entraînement (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | Les futurs jeux de données d'entraînement de cet opérateur | Peu de visibilité à court terme ; peut-être la capacité des futurs modèles à « connaître » votre marque sans faire de recherche | La recherche ChatGPT, la recherche Claude, Perplexity, Google Search et les AI Overviews, tant que leurs bots de recherche restent autorisés |
| Les crawlers de recherche IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | L'index de récupération de ce moteur | Les citations et les liens dans les réponses de ce moteur ; OpenAI ne conserve que les liens de navigation | Les moteurs de recherche classiques, sauf si vous les bloquez aussi |
| Les fetchers déclenchés par l'utilisateur (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | Les récupérations en direct demandées par les utilisateurs, quand l'opérateur respecte la règle | Les réponses quand un utilisateur colle votre URL ou pose une question à son sujet ; les tâches d'agent comme le paiement ou la réservation | Les réponses basées sur l'index, si le bot de recherche est autorisé |
| Googlebot | Google Search dans son ensemble | Le classement organique, les AI Overviews et l'AI Mode, d'un seul coup | Plus rien sur Google ; c'est rarement ce que vous voulez |
L'ampleur de l'échange compte aussi. Cloudflare a mesuré combien de pages chaque plateforme d'IA explore pour chaque visiteur qu'elle vous renvoie : en juillet 2025, Anthropic se situait à environ 38 000 crawls par visiteur référé, et Perplexity à 194. Ces ratios sont l'argument économique qu'avancent les éditeurs pour bloquer les crawlers d'entraînement tout en laissant la porte ouverte aux crawlers de recherche.
Quels crawlers IA autoriser ou bloquer ? Une matrice de décision selon votre objectif business
Partez de ce que vous vendez. Si une recommandation par un assistant IA peut vous rapporter un client, autorisez tous les crawlers de recherche et tous les fetchers utilisateur, et traitez l'entraînement comme une décision à part, de moindre importance.
| Votre situation | Crawlers d'entraînement | Crawlers de recherche | Fetchers et agents utilisateur | Pourquoi |
|---|---|---|---|---|
| SaaS B2B, agences, services locaux | Autoriser (ou bloquer, faible coût) | Autoriser | Autoriser | Les acheteurs présélectionnent leurs fournisseurs dans les réponses des IA ; être présent dans les connaissances des modèles favorise aussi les mentions spontanées |
| E-commerce | À vous de voir | Autoriser | Autoriser, et mettre les agents signés en liste blanche dans votre WAF | Les réponses shopping citent les fiches produits, et les agents doivent pouvoir accéder au panier et au paiement |
| Médias d'information et éditeurs financés par la publicité | Bloquer | Autoriser, ou bloquer sur les pages avec publicité | Décider opérateur par opérateur | Le contenu est le produit ; les citations renvoient tout de même quelques lecteurs |
| Documentation développeurs et projets open source | Autoriser | Autoriser | Autoriser | Les développeurs demandent aux assistants comment utiliser votre API ; des connaissances exactes dans les modèles allègent le support |
| Contenu payant ou sous licence | Bloquer | Autoriser uniquement les pages d'index | Bloquer via WAF si la licence l'exige | Gardez les accroches citables et le texte intégral hors de portée |
| Préproduction, intranets, applications privées | Bloquer | Bloquer | Bloquer | Utilisez l'authentification ; le robots.txt est une demande, pas un verrou |
| Serveur sous pression à cause du crawl | Limiter le débit ou bloquer | Autoriser, limiter le débit au niveau du CDN | Autoriser | Réglez la charge en bordure de réseau plutôt que de perdre des citations |
Comment bloquer les crawlers d'entraînement IA tout en autorisant la recherche IA dans le robots.txt ?
Donnez à chaque jeton d'entraînement son propre groupe avec Disallow: / et laissez vos règles habituelles s'appliquer aux crawlers de recherche. Un crawler n'obéit qu'au groupe le plus spécifique qui le nomme : un blocage de l'entraînement ne déborde donc jamais sur les bots de recherche.
Snippet 1 : bloquer l'entraînement, garder la recherche IA et les fetchers utilisateur
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
La RFC 9309 autorise plusieurs lignes User-agent à partager un même groupe, et la correspondance ne tient pas compte de la casse. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot et Bingbot retombent sur le groupe * et restent autorisés.
Snippet 2 : s'ouvrir explicitement à la recherche IA
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Nommer explicitement les bots de recherche vous protège d'une future règle générale écrite par quelqu'un d'autre, par exemple un plugin qui ajoute User-agent: * avec Disallow: /. Conservez les chemins privés en Disallow à l'intérieur du groupe : pour ce bot, un groupe nommé remplace le groupe *, il ne s'y ajoute pas.
Snippet 3 : trois pièges qui cassent de vrais fichiers
- Applebot hérite des règles de Googlebot. Apple indique que si votre fichier ne mentionne pas Applebot mais mentionne Googlebot, Applebot suit le groupe Googlebot. Un blocage visant spécifiquement Googlebot peut ainsi vous faire disparaître en silence de Siri et de Spotlight.
- Amzn-SearchBot hérite des règles des autres bots de recherche lorsqu'il n'est pas nommé, selon Amazon. Nommez-le si vous voulez un autre résultat.
- Chaque sous-domaine a besoin de son propre fichier. Anthropic et Amazon indiquent tous deux lire le robots.txt hôte par hôte :
docs.example.coma donc besoin de sa propre copie.
Vous pouvez créer et contrôler ces groupes avec le générateur de robots.txt gratuit d'AI Rank Lab, et nos modèles de robots.txt pour les crawlers IA, publiés précédemment, vont plus loin sur les configurations en accès complet et en accès sélectif.
Comment vérifier qu'un crawler IA est authentique et non usurpé ?
Ne vous fiez jamais au seul user agent : n'importe qui peut envoyer « GPTBot » dans un en-tête, et Common Crawl prévient sur sa propre page que des crawlers se font passer pour CCBot. Les opérateurs proposent trois méthodes de vérification, et celle à utiliser dépend de l'opérateur.
- Reverse DNS, puis DNS direct. Lancez
hostsur l'IP relevée dans votre log, vérifiez que le nom d'hôte se termine par le domaine de l'opérateur, puis lancezhostsur ce nom d'hôte et confirmez qu'il renvoie la même IP. Google documente cette méthode pourgooglebot.com,google.cometgoogleusercontent.comdans son guide de vérification ; Apple utilise*.applebot.apple.com; Common Crawl utilise*.crawl.commoncrawl.org(IPv4 uniquement). - Comparer l'IP à la liste publiée par l'opérateur. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral et Amazon publient leurs plages d'IP. C'est la seule méthode possible pour OpenAI, Anthropic et Perplexity, qui ne documentent aucun schéma de reverse DNS.
- Contrôler une signature cryptographique (Web Bot Auth). Le Cloud browser de ChatGPT signe ses requêtes selon la RFC 9421, avec un en-tête
Signature-Agentvalant"https://chatgpt.com". Google teste le même brouillon de l'IETF pour une partie des requêtes de Google-Agent, signéeshttps://agent.bot.goog, et sa page Web Bot Auth recommande de garder le contrôle des IP en solution de repli, car toutes les requêtes ne sont pas signées.
# Recherche inverse puis directe (exemple Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# Vérification par liste d'IP pour le crawler de recherche d'OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
Les listes d'IP publiées sont-elles à jour ?
Le 18 octobre 2026, nous avons téléchargé tous les fichiers d'IP de crawlers IA publiés et relevé le champ creationTime que chaque opérateur y inscrit. Une date ancienne peut simplement signifier que les plages n'ont pas bougé, mais elle vous dit quelle confiance accorder à une liste blanche codée en dur, et elle révèle quelles listes ne peuvent pas rendre compte du trafic que l'opérateur n'a jamais déclaré.
| Liste publiée | creationTime dans le fichier | Préfixes IPv4 / IPv6 |
|---|---|---|
| Robots d'exploration courants de Google (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Agents Google déclenchés par l'utilisateur (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (les trois bots, une seule liste) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Deux leçons pratiques. Les listes de Google et celle de ChatGPT-User chez OpenAI ont changé au cours des deux dernières semaines : une liste blanche de pare-feu copiée cet été est donc probablement déjà fausse. Récupérez plutôt ces fichiers chaque jour ou chaque semaine. Par ailleurs, Anthropic indique que bloquer ses IP « peut ne pas fonctionner correctement ni garantir durablement une exclusion », puisque cela l'empêche de lire votre robots.txt. Servez-vous donc du robots.txt pour vous exclure, et des IP uniquement pour vérifier.
Comment voir l'activité des crawlers IA : logs serveur ou tags JavaScript ?
Utilisez les logs serveur ou CDN pour les crawlers, et l'analytics JavaScript pour les visiteurs humains qui arrivent depuis des assistants IA. Un tag JS ne se déclenche que si quelque chose exécute le JavaScript de la page, ce que la plupart des crawlers IA ne font pas. L'analyse de Vercel sur son propre réseau a montré qu'aucun des grands crawlers IA n'effectuait le rendu du JavaScript ; les crawlers de ChatGPT et de Claude récupéraient bien des fichiers JS (11,50 % et 23,84 % de leurs requêtes), sans les exécuter. Les exceptions : Gemini, qui s'appuie sur le rendu de Googlebot, et Applebot. Cette étude date de décembre 2024, alors refaites le test sur votre propre site, mais elle correspond à ce que nous observons.
Google Analytics creuse l'écart, et c'est voulu. GA4 exclut automatiquement le trafic des robots et araignées connus, sans que vous puissiez désactiver ce filtre ni savoir ce qui a été retiré. GA4 est le bon outil pour le trafic référent issu de l'IA, que nous détaillons dans comment suivre le trafic référent IA dans GA4, mais le mauvais pour compter les crawlers.
Nous retrouvons le même schéma dans les données de suivi d'AI Rank Lab. Notre tag JavaScript enregistre de façon fiable les personnes qui cliquent depuis ChatGPT, Gemini, Perplexity et Claude, mais il ne voit qu'une petite part, non représentative, du trafic des crawlers. C'est pourquoi nous ne publions pas de chiffres de crawl issus de ce tag.
Un contrôle des logs en cinq minutes
- Téléchargez une journée de logs d'accès bruts depuis votre hébergeur ou votre CDN (Nginx et Apache enregistrent tous deux le user agent dans le format combined par défaut).
- Comptez les requêtes par jeton IA :
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Pour les jetons en tête, regardez les codes de statut. Une avalanche de 403 ou de 429 signifie généralement qu'une règle WAF ou CDN bloque un bot que votre robots.txt autorise.
- Vérifiez un échantillon d'IP avec les méthodes ci-dessus avant de vous fier au moindre chiffre.
- Regardez quelles URL demandent les bots de recherche. Si OAI-SearchBot ou Claude-SearchBot ne récupèrent que votre page d'accueil, penchez-vous sur votre maillage interne et votre sitemap.
Les outils qui montrent l'activité des crawlers IA
Transparence : AI Rank Lab est notre produit. Nous le citons en premier parce que vous êtes sur notre site, et nous avons appliqué les mêmes critères à tous les outils ci-dessous.
- AI Rank Lab - le suivi des bots IA enregistre, page par page, les visites référées par les assistants IA et les passages de bots IA que son tag peut voir, à côté du suivi de votre visibilité et de vos citations dans les IA. Associez-le à vos logs pour obtenir le décompte complet des crawlers, pour les raisons expliquées plus haut.
- Cloudflare AI Crawl Control - si votre site passe par le proxy de Cloudflare, c'est la vue la plus complète disponible sur les crawlers, car l'outil voit chaque requête en bordure de réseau, y compris celles des bots qui n'exécutent jamais de JavaScript. Il indique aussi le respect du robots.txt crawler par crawler.
- Les analyseurs de fichiers de logs, comme le Log File Analyser de Screaming Frog ou GoAccess - ils fonctionnent sur les logs bruts de n'importe quel hébergeur et sont très efficaces pour des audits ponctuels.
- Les logs bruts et la commande grep ci-dessus - gratuit, exact, et la référence à laquelle tous les autres outils devraient correspondre.
Pour une routine de surveillance plus poussée, centrée sur les trois plus gros bots, consultez notre guide de surveillance de GPTBot, ClaudeBot et PerplexityBot.
Comment Cloudflare et les autres CDN contrôlent-ils les bots IA ?
Les CDN imposent en bordure de réseau ce que le robots.txt ne peut que demander. AI Crawl Control, de Cloudflare, disponible sur toutes les formules, montre quels services d'IA visitent votre site, vous permet d'autoriser ou de bloquer chaque crawler, suit les violations du robots.txt et propose le paiement au crawl (pay per crawl) en bêta privée.
Les politiques de Cloudflare pour les bots IA reprennent désormais le même découpage en trois que cet article. Ses réglages Block AI Bots proposent des préréglages distincts Search, Agent et Training, chacun avec les options « bloquer sur toutes les pages », « bloquer sur les pages avec publicité » ou « autoriser ». D'après la documentation, à partir du 15 septembre 2026, les nouveaux domaines reçoivent des paramètres par défaut mis à jour : bots Training et Agent bloqués sur les pages qui affichent de la publicité, bots Search autorisés, et crawlers à double usage (recherche et entraînement) bloqués dès qu'un blocage de l'entraînement est actif. Si vous avez placé un site derrière Cloudflare après cette date et que vous vous demandez pourquoi ChatGPT-User ou Claude-User reçoivent des 403 sur votre blog, commencez par vérifier ce réglage.
Cloudflare peut aussi gérer votre robots.txt à votre place. Avec Bot Preference Sync activé, son robots.txt géré ajoute, avant vos règles existantes, des groupes disallow pour Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot et meta-externalagent, ainsi qu'une ligne Content Signals (search=yes, ai-train=no). Les Content Signals sont un vocabulaire proposé par Cloudflare (search, ai-input, ai-train) qui indique comment le contenu peut être utilisé une fois récupéré ; libre à chaque opérateur de les respecter ou non.
D'autres fournisseurs suivent la même logique. La documentation de Perplexity inclut des recommandations WAF pour Cloudflare et AWS WAF à partir de ses listes d'IP, et le centre d'aide d'OpenAI explique comment mettre en liste blanche son Cloud browser signé dans Akamai (nom du bot : « ChatGPT Agent ») et dans Cloudflare (ID de détection 129220581). Quel que soit votre CDN, la marche à suivre est la même : décidez catégorie par catégorie, traduisez ces choix dans le robots.txt, n'imposez un blocage en bordure de réseau que là où il doit être strict, et revérifiez vos logs après chaque changement côté CDN.
Google et Bing : deux cas à part
Bloquer Google-Extended a-t-il un effet sur Google Search ou les AI Overviews ?
Non. Google affirme que Google-Extended « n'a pas d'incidence sur l'inclusion d'un site dans la recherche Google et n'est pas utilisé comme signal de classement ». Sa documentation sur les fonctionnalités d'IA est sans ambiguïté : ce sont les règles robots.txt pour Googlebot qui contrôlent la recherche, AI Overviews et AI Mode compris, et vous limitez ce qui s'affiche avec nosnippet, data-nosnippet, max-snippet ou noindex. Google-Extended concerne l'entraînement des modèles Gemini et le grounding dans les applications Gemini et Vertex AI, qui sont distincts de la recherche.
Comment empêcher Microsoft Copilot d'utiliser votre contenu ?
Microsoft n'a pas de jeton dédié à un crawler IA : c'est Bingbot qui explore, et vous contrôlez l'usage IA avec des balises meta robots au niveau de la page. Les consignes officielles les plus récentes que nous ayons trouvées sont l'annonce de l'équipe Bing de 2023, rédigée quand Copilot s'appelait encore Bing Chat : un contenu balisé noarchive n'est ni inclus ni cité en lien dans les réponses du chat de Bing, et ne sert pas à entraîner les modèles de fondation de Microsoft ; un contenu balisé nocache peut apparaître avec seulement l'URL, le titre et l'extrait ; un contenu sans aucune de ces balises peut être utilisé pleinement. Les deux balises vous maintiennent dans les résultats Bing classiques. Bloquer Bingbot dans le robots.txt vous retirerait aussi de la recherche Bing : passez donc plutôt par les balises meta.
Limites et méthodologie
Le 18 octobre 2026, nous avons lu la page de chaque opérateur citée plus haut, téléchargé chaque liste d'IP publiée et relevé le creationTime de chaque fichier. Nous n'avons pas pu afficher la page d'aide de Microsoft sur ses crawlers, qui fonctionne uniquement en JavaScript : la ligne Bingbot s'appuie donc sur le blog Bing Webmaster de Microsoft, sur son outil Verify Bingbot et sur le fichier bingbot.json qu'il publie. Les colonnes robots.txt reformulent ce que dit chaque opérateur, pas ce que nous avons mesuré nous-mêmes ; les constats de Cloudflare sur Perplexity sont la principale preuve publique que les deux peuvent diverger. Les opérateurs renomment et ajoutent souvent des bots (Google a par exemple remplacé son jeton de fetcher Google-NotebookLM par Google-GeminiNotebook) : considérez donc toute liste, celle-ci comprise, comme exacte à sa date de vérification.
Si vous voulez savoir si votre politique d'accès aux crawlers vous rapporte réellement des citations, AI Rank Lab suit vos mentions et vos pages citées dans ChatGPT, Claude, Gemini, Perplexity, les AI Overviews de Google et l'AI Mode, à côté du trafic référent que ces réponses vous envoient.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


