



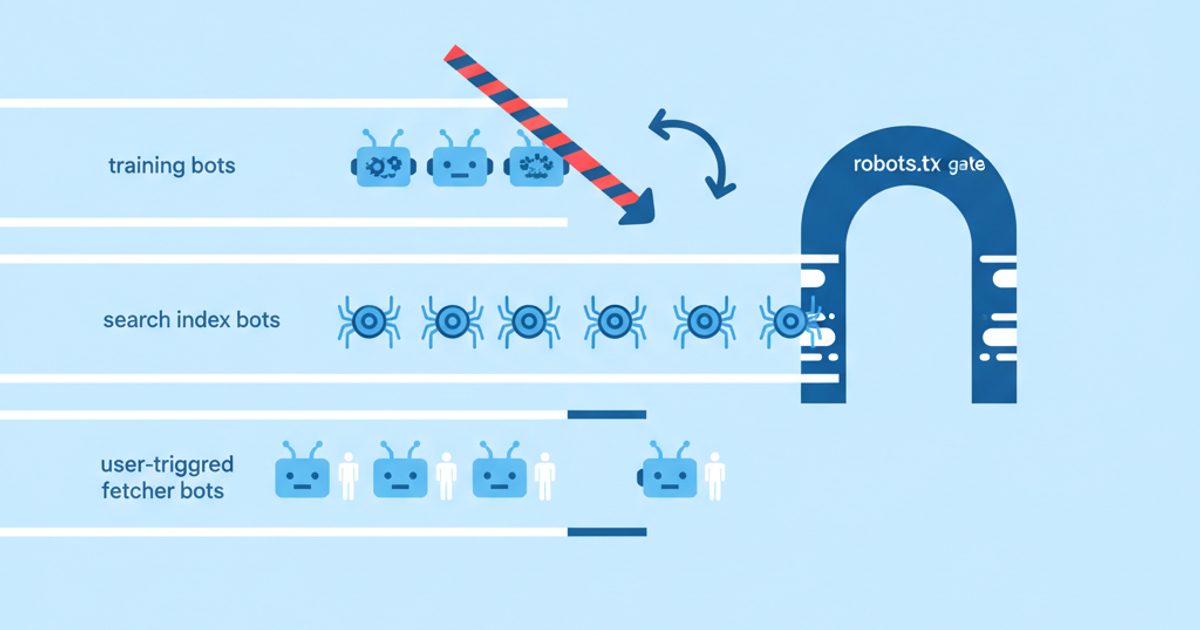
I crawler IA sono bot automatici gestiti dalle aziende di intelligenza artificiale che scaricano pagine web per uno di tre scopi: raccogliere dati per addestrare i modelli (GPTBot, ClaudeBot), costruire l’indice di ricerca da cui le risposte dell’IA prendono le citazioni (OAI-SearchBot, Claude-SearchBot, PerplexityBot), oppure leggere una pagina in tempo reale perché un utente ha chiesto qualcosa all’assistente (ChatGPT-User, Claude-User, Perplexity-User). Bloccare un crawler di addestramento tiene i tuoi contenuti fuori dai modelli futuri; bloccare un crawler di ricerca o un fetcher su richiesta dell’utente ti cancella dalle risposte e dalle citazioni dell’IA. Tutta la decisione si gioca su questa differenza.
Questa pagina è un riferimento su cui puoi agire subito. Ogni user agent qui sotto è stato verificato il 18 ottobre 2026 sulla documentazione ufficiale dell’operatore, con il link alla pagina. Trovi anche una matrice decisionale per obiettivo di business, blocchi robots.txt pronti da copiare, il metodo di verifica supportato da ciascun operatore (con la data riportata dentro ogni elenco di IP pubblicato) e uno sguardo onesto sul perché gli analytics in JavaScript non possono mostrarti la maggior parte del traffico dei crawler.
In sintesi
- Classifica ogni bot IA come addestramento, ricerca/indice o su richiesta dell’utente. OpenAI, Anthropic, Amazon, Meta e Mistral pubblicano un token separato per ogni classe, quindi puoi bloccarne uno senza toccare gli altri.
- Bloccare GPTBot non ti toglie dalla ricerca di ChatGPT. OpenAI dice che a controllarla è solo OAI-SearchBot, e i siti che escludono OAI-SearchBot possono comunque comparire come link di navigazione.
- Google-Extended e Applebot-Extended sono token di controllo, non crawler. Non compaiono mai nei tuoi log, e Google dice che Google-Extended non ha alcun effetto su Google Search, che comprende AI Overviews e AI Mode.
- I fetcher su richiesta dell’utente possono ignorare robots.txt per scelta progettuale: OpenAI, Perplexity, Google, Meta e Amazon lo scrivono nella loro documentazione. Se ti serve un blocco vero, usa un WAF.
- La maggior parte dei crawler IA non esegue JavaScript, quindi un tag di analytics in JS li sottostima. Per l’attività dei crawler la fonte attendibile sono i log del server o della CDN.
- Verifica i bot con il DNS inverso (Google, Apple, Common Crawl) o confrontando l’IP con l’elenco JSON pubblicato dall’operatore. Alcuni di questi elenchi hanno anni, quindi scaricali di nuovo a intervalli regolari.
Cosa sono i crawler IA e quali sono le tre classi?
Un crawler IA è qualsiasi client automatico che un’azienda di IA usa per richiedere le tue pagine. Oggi gli operatori dividono i propri bot per scopo, ed è lo scopo a decidere quanto ti costa bloccarli. I dati di rete di Cloudflare mostrano quanto sia sbilanciato il mix: nei 12 mesi fino a metà 2025, l’80% del crawling IA serviva all’addestramento, il 18% alla ricerca e il 2% ad azioni degli utenti, con l’addestramento salito all’82% negli ultimi sei mesi di quel periodo.
Crawler di addestramento
I crawler di addestramento raccolgono contenuti che possono essere usati per addestrare o fare fine-tuning dei modelli di base. Ne fanno parte GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training e CCBot (il dataset aperto di Common Crawl, usato da molti sviluppatori di modelli). Bloccarli è un segnale che i tuoi contenuti futuri devono restare fuori dai set di addestramento. Non rimuove i contenuti già raccolti e non incide sulla possibilità che la ricerca con IA ti citi.
Crawler di ricerca e indicizzazione
I crawler di ricerca costruiscono l’indice di recupero su cui si basano le risposte dell’IA e a cui rimandano le citazioni. OAI-SearchBot (ricerca di ChatGPT), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index e DuckAssistBot sono specifici dell’IA. Googlebot, Bingbot e Applebot sono crawler di ricerca classici, il cui indice ora alimenta anche funzioni di IA: Google AI Overviews e AI Mode, Microsoft Copilot e le risposte di Siri. Bloccare un crawler di ricerca è l’errore che costa caro, perché ti toglie dalle risposte che leggono i tuoi clienti. Se vuoi capire come viene usato concretamente uno di questi indici, leggi come funziona la ricerca di ChatGPT.
Fetcher e agenti su richiesta dell’utente
I fetcher su richiesta dell’utente visitano un singolo URL perché una persona ha chiesto all’assistente di leggerlo, riassumerlo o compiere un’azione. Ne fanno parte ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User e MistralAI-User, più gli agenti browser firmati come il Cloud browser di ChatGPT. Diversi operatori dichiarano che robots.txt potrebbe non valere per questi bot, perché la richiesta è partita da un essere umano.
Token di controllo che non sono crawler
Due nomi presenti in ogni elenco non scaricano mai nulla da soli. Google-Extended è un product token di robots.txt che Google legge mentre esegue la scansione con i suoi user agent normali; controlla se i contenuti possono essere usati per addestrare i futuri modelli Gemini e per il grounding nelle app Gemini e in Vertex AI. Applebot-Extended fa lo stesso per i modelli di base di Apple. Non troverai nessuna delle due stringhe nei tuoi access log, ed è per questo che «ho bloccato Google-Extended ma vedo ancora traffico da Google» è un comportamento del tutto normale.
L’elenco dei crawler IA: tutti i principali user agent, verificati il 18 ottobre 2026
La tabella riporta il token da scrivere in una riga User-agent:, chi lo gestisce, la sua classe, cosa dice la documentazione dell’operatore su robots.txt, come puoi verificarlo e la pagina ufficiale che abbiamo controllato. «Secondo la doc» significa che la colonna robots.txt riformula le parole dell’operatore; dove la documentazione tace, lo diciamo invece di tirare a indovinare.
| Token | Operatore | Classe | Cosa fa | Robots.txt (secondo la doc) | Verifica tramite | Documentazione ufficiale |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Addestramento | Scansiona contenuti che possono essere usati per addestrare i modelli di base di OpenAI | Sì | gptbot.json | Crawler di OpenAI |
| OAI-SearchBot | OpenAI | Ricerca | Fa comparire i siti nelle risposte della ricerca di ChatGPT; non per l’addestramento | Sì, le modifiche richiedono circa 24 ore | searchbot.json | Crawler di OpenAI |
| ChatGPT-User | OpenAI | Su richiesta dell’utente | Visita pagine per azioni degli utenti in ChatGPT e nei Custom GPT | Potrebbe non valere | chatgpt-user.json | Crawler di OpenAI |
| OAI-AdsBot | OpenAI | Speciale | Controlla le landing page inviate come annunci su ChatGPT; non per l’addestramento | Non indicato; visita solo le pagine degli annunci inviati | adsbot.json | Crawler di OpenAI |
| ClaudeBot | Anthropic | Addestramento | Raccoglie contenuti che potrebbero contribuire all’addestramento dei modelli Claude | Sì; supporta Crawl-delay | bots.json (condiviso) | Centro assistenza Anthropic |
| Claude-SearchBot | Anthropic | Ricerca | Indicizza contenuti per migliorare i risultati di ricerca di Claude | Sì | bots.json (condiviso) | Centro assistenza Anthropic |
| Claude-User | Anthropic | Su richiesta dell’utente | Scarica pagine quando un utente di Claude fa una domanda | Sì, disattivarlo blocca il recupero richiesto dagli utenti | bots.json (condiviso) | Centro assistenza Anthropic |
| PerplexityBot | Perplexity | Ricerca | Fa comparire e linka i siti nei risultati di Perplexity; non per l’addestramento | Sì, entro 24 ore | perplexitybot.json | Crawler di Perplexity |
| Perplexity-User | Perplexity | Su richiesta dell’utente | Visita pagine per rispondere alla domanda di un utente | In genere lo ignora | perplexity-user.json | Crawler di Perplexity |
| Googlebot | Ricerca | Google Search, compresi AI Overviews e AI Mode | Sì, sempre per le scansioni automatiche | DNS inverso o common-crawlers.json | Crawler comuni di Google | |
| Google-Extended | Token di controllo | Addestramento di Gemini e grounding nelle app Gemini e in Vertex AI | Solo token; nessuno user agent proprio | Non applicabile | Crawler comuni di Google | |
| Google-CloudVertexBot | Ricerca (su richiesta del proprietario del sito) | Scansiona i siti su cui i proprietari costruiscono agenti Vertex AI | Sì | DNS inverso o common-crawlers.json | Crawler comuni di Google | |
| Google-Agent | Agente su richiesta dell’utente | Agenti sull’infrastruttura di Google che navigano e agiscono su richiesta dell’utente | In genere lo ignora (su richiesta dell’utente) | user-triggered-agents.json; alcune richieste firmate con Web Bot Auth | Fetcher di Google su richiesta dell’utente | |
| Google-GeminiNotebook | Su richiesta dell’utente | Scarica gli URL che gli utenti aggiungono come fonti in Gemini Notebook (ex agente Google-NotebookLM, supportato fino ad agosto 2026) | In genere lo ignora (su richiesta dell’utente) | Elenchi JSON dei fetcher su richiesta dell’utente | Fetcher di Google su richiesta dell’utente | |
| Bingbot | Microsoft | Ricerca | Indice di Bing, che fa anche da base alle risposte di Copilot | Sì; l’uso per l’IA si controlla a livello di pagina con noarchive/nocache | bingbot.json o lo strumento Verify Bingbot di Bing | Blog di Bing Webmaster |
| Applebot | Apple | Ricerca (può anche addestrare) | Ricerca di Spotlight, Siri e Safari; i dati possono anche addestrare i modelli di Apple | Sì; segue le regole di Googlebot se Applebot non è nominato; ignora Crawl-delay | DNS inverso (*.applebot.apple.com) o applebot.json | Informazioni su Applebot |
| Applebot-Extended | Apple | Token di controllo | Esclude i contenuti dall’addestramento dei modelli di base di Apple | Solo token | Non applicabile | Informazioni su Applebot |
| Meta-ExternalAgent | Meta | Addestramento | Addestramento dei modelli di IA di base o indicizzazione diretta dei contenuti | Sì | User agent più gli IP pubblicati da Meta | Crawler web di Meta |
| Meta-WebIndexer | Meta | Ricerca | Migliora i risultati di ricerca di Meta AI, così Meta AI può citarti e linkarti | Sì | User agent più gli IP pubblicati da Meta | Crawler web di Meta |
| Meta-ExternalFetcher | Meta | Su richiesta dell’utente | Scarica link su richiesta di un utente, anche per attività agentiche | Può aggirarlo | User agent più gli IP pubblicati da Meta | Crawler web di Meta |
| Amazonbot | Amazon | Addestramento | Migliora i prodotti Amazon; può essere usato per addestrare i modelli di IA di Amazon | Sì (RFC 9309); ignora Crawl-delay | Pagina degli IP pubblicati | Amazonbot |
| Amzn-SearchBot | Amazon | Ricerca | Esperienze di ricerca come Alexa; non per l’addestramento | Sì; se non è nominato eredita le regole date agli altri bot di ricerca | Pagina degli IP pubblicati | Amazonbot |
| Amzn-User | Amazon | Su richiesta dell’utente | Recupera informazioni in tempo reale per le richieste ad Alexa; non per l’addestramento | Potrebbe non seguire tutte le direttive | Pagina degli IP pubblicati | Amazonbot |
| MistralAI-Training | Mistral | Addestramento | Costruisce dataset per addestrare i modelli Mistral | Sì, può essere bloccato con disallow | User agent | Crawler di Mistral |
| MistralAI-Index | Mistral | Ricerca | Indicizza contenuti per la ricerca di Mistral in Vibe; non per l’addestramento | Sì | mistralai-index-ips.json | Crawler di Mistral |
| MistralAI-User | Mistral | Su richiesta dell’utente | Visita pagine quando gli utenti di Vibe fanno una domanda | Sì, determina quali siti le richieste degli utenti possono raggiungere | mistralai-user-ips.json | Crawler di Mistral |
| DuckAssistBot | DuckDuckGo | Ricerca (in tempo reale) | Scansiona pagine per le risposte assistite dall’IA di DuckDuckGo; non per l’addestramento | Sì, ha effetto dopo 72 ore | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Addestramento (dataset aperto) | Costruisce il corpus aperto di Common Crawl, molto usato per addestrare modelli | Sì | DNS inverso (*.crawl.commoncrawl.org, solo IPv4) | CCBot |
La tabella chiarisce due cose. Primo: la pagina attuale di Anthropic elenca esattamente tre bot, ClaudeBot, Claude-SearchBot e Claude-User. Elenchi più vecchi riportano ancora «anthropic-ai» e «Claude-Web», che a ottobre 2026 non compaiono nella documentazione di Anthropic. Secondo: i numeri di versione di OpenAI cambiano. Il giorno del nostro controllo, le stringhe di esempio di OpenAI mostravano GPTBot/1.4 e OAI-SearchBot/1.4, quindi fai il match sul token, mai sulla stringa completa.
Bot senza documentazione ufficiale
Alcuni bot che vedrai nei log non hanno una pagina dell’operatore che siamo riusciti a trovare il 18 ottobre 2026. Bytespider di ByteDance è il più noto; gli agenti legati a Grok di xAI sono un altro caso. Le directory di terze parti non concordano sul loro comportamento, quindi li abbiamo lasciati fuori dalla tabella verificata. Il robots.txt gestito di Cloudflare include comunque un disallow per Bytespider, e Cloudflare ha riportato che la quota di Bytespider nel crawling IA è scesa dal 14,1% al 2,4% tra metà 2024 e metà 2025. Se uno di questi bot ti interessa, applica la tua policy con una regola WAF invece di affidarti a robots.txt.
I crawler IA rispettano robots.txt?
I crawler di addestramento e di ricerca documentati dicono di sì; i fetcher su richiesta dell’utente spesso dicono di no; e robots.txt non è mai un controllo degli accessi. Lo standard stesso, RFC 9309, afferma che «queste regole non sono una forma di autorizzazione all’accesso». Consente inoltre ai crawler di tenere in cache il tuo file fino a 24 ore, ed è per questo che ogni operatore indica un ritardo prima che le modifiche abbiano effetto.
Dichiarare di rispettare le regole non equivale a farlo davvero. Ad agosto 2025 Cloudflare ha pubblicato un test in cui domini nuovi di zecca, che bloccavano tutto, venivano comunque descritti nel dettaglio da Perplexity. Cloudflare ha detto di aver osservato un agente dichiarato Perplexity-User che faceva 20-25 milioni di richieste al giorno e un agente non dichiarato simile a Chrome che ne faceva 3-6 milioni, e ha poi tolto Perplexity dai bot verificati. È il risultato di un solo vendor su un solo operatore, ma mostra perché la stringa dello user agent, da sola, non dimostra niente.
| Operatore | Tempi di applicazione delle modifiche a robots.txt (secondo la doc) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | Circa 24 ore | Non indicato |
| Perplexity | Fino a 24 ore | Non indicato |
| Amazon | Circa 24 ore; può usare una copia in cache vecchia fino a 30 giorni | Non supportato |
| Meta | Fino a 24 ore | Non indicato |
| DuckDuckGo (DuckAssistBot) | 72 ore | Non indicato |
| Anthropic | Non indicato | Supportato |
| Apple | Non indicato | Non supportato |
Quanto ti costa bloccare ciascuna classe di crawler IA?
Bloccare i crawler di addestramento oggi ti costa poco in visibilità; bloccare i crawler di ricerca o i fetcher degli utenti ti costa subito le citazioni. La tabella abbina ogni classe al costo descritto dagli operatori stessi.
| Se blocchi... | Resti fuori da | Perdi | Continui a comparire in |
|---|---|---|---|
| Crawler di addestramento (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | I futuri dataset di addestramento di quell’operatore | Poca visibilità nel breve periodo; forse quanto bene i modelli futuri «conoscono» il tuo brand senza cercarlo | Ricerca di ChatGPT, ricerca di Claude, Perplexity, Google Search e AI Overviews, purché i loro bot di ricerca siano consentiti |
| Crawler di ricerca IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | L’indice di recupero di quel motore | Citazioni e link nelle risposte di quel motore; OpenAI mantiene solo i link di navigazione | I motori di ricerca classici, a meno che tu non blocchi anche quelli |
| Fetcher su richiesta dell’utente (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | I recuperi in tempo reale richiesti dagli utenti, dove l’operatore rispetta il blocco | Le risposte quando un utente incolla il tuo URL o chiede qualcosa su di esso; attività degli agenti come checkout o prenotazioni | Le risposte basate sull’indice, se il bot di ricerca è consentito |
| Googlebot | Google Search per intero | Posizionamento organico, AI Overviews e AI Mode, tutto insieme | Niente su Google; quasi mai è quello che vuoi |
Conta anche la proporzione dello scambio. Cloudflare ha misurato quante pagine scansiona ogni piattaforma di IA per ogni visitatore che rimanda al sito: a luglio 2025 Anthropic era a circa 38.000 scansioni per visitatore inviato e Perplexity a 194. Sono questi rapporti l’argomento economico con cui gli editori giustificano il blocco dei crawler di addestramento lasciando aperti quelli di ricerca.
Quali crawler IA consentire e quali bloccare? Una matrice decisionale per obiettivo di business
Parti da quello che vendi. Se essere consigliato da un assistente IA può farti guadagnare un cliente, consenti tutti i crawler di ricerca e tutti i fetcher degli utenti, e tratta l’addestramento come una decisione separata e meno importante.
| La tua situazione | Crawler di addestramento | Crawler di ricerca | Fetcher e agenti degli utenti | Perché |
|---|---|---|---|---|
| SaaS B2B, agenzie, servizi locali | Consenti (o blocca, costa poco) | Consenti | Consenti | I clienti fanno la shortlist dei fornitori nelle risposte dell’IA; essere nella conoscenza del modello aiuta anche le menzioni spontanee |
| E-commerce | A tua scelta | Consenti | Consenti, e metti in allowlist gli agenti firmati nel WAF | Le risposte sullo shopping citano le schede prodotto, e gli agenti devono poter arrivare a carrello e checkout |
| Testate giornalistiche ed editori finanziati dalla pubblicità | Blocca | Consenti, o blocca sulle pagine con annunci | Decidi operatore per operatore | Il contenuto è il prodotto; le citazioni riportano comunque qualche lettore |
| Documentazione per sviluppatori e progetti open source | Consenti | Consenti | Consenti | Gli sviluppatori chiedono agli assistenti come usare la tua API; una conoscenza accurata nel modello riduce il carico sul supporto |
| Contenuti a pagamento o in licenza | Blocca | Consenti solo le pagine indice | Blocca con il WAF se la licenza lo richiede | Mantieni citabili le anteprime, tieni fuori il testo completo |
| Ambienti di staging, intranet, app private | Blocca | Blocca | Blocca | Usa l’autenticazione; robots.txt è una richiesta, non una serratura |
| Server sotto pressione per il crawling | Limita la frequenza o blocca | Consenti, con rate limit sulla CDN | Consenti | Risolvi il carico sull’edge invece di perdere citazioni |
Come bloccare i crawler IA di addestramento ma consentire la ricerca con IA in robots.txt?
Dai a ogni token di addestramento un gruppo proprio con Disallow: / e lascia i crawler di ricerca sotto le tue regole normali. Un crawler segue solo il gruppo più specifico che lo nomina, quindi un blocco per l’addestramento non si estende mai ai bot di ricerca.
Snippet 1: blocca l’addestramento, mantieni ricerca IA e fetcher degli utenti
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 consente a più righe User-agent di condividere lo stesso gruppo, e il confronto non distingue tra maiuscole e minuscole. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot e Bingbot ricadono nel gruppo * e restano consentiti.
Snippet 2: dichiara esplicitamente l’apertura alla ricerca IA
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Nominare esplicitamente i bot di ricerca ti protegge da una futura regola generica scritta da qualcun altro, per esempio un plugin che aggiunge User-agent: * con Disallow: /. Tieni i percorsi privati in disallow dentro il gruppo, perché per quel bot un gruppo con nome sostituisce il gruppo *, non si somma.
Snippet 3: tre trappole che rompono i file reali
- Applebot eredita le regole di Googlebot. Apple spiega che, se il tuo file non menziona Applebot ma menziona Googlebot, Applebot segue il gruppo di Googlebot. Un blocco pensato solo per Googlebot può toglierti in silenzio da Siri e Spotlight.
- Amzn-SearchBot eredita le regole degli altri bot di ricerca quando non è nominato, secondo Amazon. Nominalo se vuoi un risultato diverso.
- I sottodomini hanno bisogno di un file proprio. Anthropic e Amazon dicono entrambe di leggere robots.txt host per host, quindi
docs.example.comha bisogno della sua copia.
Puoi creare e controllare questi gruppi con il generatore di robots.txt gratuito di AI Rank Lab, e i nostri modelli di robots.txt per i crawler IA approfondiscono le configurazioni ad accesso completo e ad accesso selettivo.
Come verificare che un crawler IA sia autentico e non falsificato?
Non fidarti mai del solo user agent: chiunque può mettere «GPTBot» in un header, e Common Crawl avverte nella sua stessa pagina che ci sono crawler che si spacciano per CCBot. Gli operatori supportano tre metodi di verifica, e quale usare dipende dall’operatore.
- DNS inverso, poi DNS diretto. Lancia
hostsull’IP preso dal log, controlla che l’hostname finisca con il dominio dell’operatore, poi lanciahostsu quell’hostname e conferma che restituisca lo stesso IP. Google documenta questa procedura pergooglebot.com,google.comegoogleusercontent.comnella sua guida alla verifica; Apple usa*.applebot.apple.com; Common Crawl usa*.crawl.commoncrawl.org(solo IPv4). - Confronta l’IP con l’elenco pubblicato dall’operatore. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral e Amazon pubblicano i propri intervalli di IP. È l’unico metodo per OpenAI, Anthropic e Perplexity, che non documentano un pattern di DNS inverso.
- Controlla una firma crittografica (Web Bot Auth). Il Cloud browser di ChatGPT firma le sue richieste secondo la RFC 9421, con un header
Signature-Agentpari a"https://chatgpt.com". Google sta testando la stessa bozza IETF per alcune richieste di Google-Agent, firmate comehttps://agent.bot.goog, e la sua pagina su Web Bot Auth consiglia di mantenere i controlli sugli IP come piano B, perché non tutte le richieste sono firmate.
# Lookup inverso e poi diretto (esempio Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# Controllo sull’elenco IP del crawler di ricerca di OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
Quanto sono aggiornati gli elenchi di IP pubblicati?
Il 18 ottobre 2026 abbiamo scaricato tutti i file di IP pubblicati per i crawler IA e letto il campo creationTime che ogni operatore vi inserisce. Una data vecchia può voler dire semplicemente che gli intervalli non sono cambiati, ma ti dice quanto fidarti di una allowlist scritta a mano, e mostra quali elenchi non possono tenere conto del traffico che l’operatore non ha mai dichiarato.
| Elenco pubblicato | creationTime nel file | Prefissi IPv4 / IPv6 |
|---|---|---|
| Crawler comuni di Google (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Agenti di Google su richiesta dell’utente (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (tutti e tre i bot, un solo elenco) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Due lezioni pratiche. Gli elenchi di Google e quello di ChatGPT-User di OpenAI sono cambiati nelle ultime due settimane, quindi una allowlist del firewall copiata quest’estate è probabilmente già sbagliata: scarica questi file ogni giorno o ogni settimana. E Anthropic avverte che bloccare i suoi IP «potrebbe non funzionare correttamente né garantire in modo permanente l’esclusione», perché impedisce ad Anthropic di leggere il tuo robots.txt. Usa quindi robots.txt per l’esclusione e gli IP solo per la verifica.
Come vedere l’attività dei crawler IA: log del server o tag JavaScript?
Usa i log del server o della CDN per i crawler e gli analytics in JavaScript per i visitatori umani che arrivano dagli assistenti IA. Un tag JS parte solo quando qualcosa esegue il JavaScript della pagina, e la maggior parte dei crawler IA non lo fa. L’analisi di Vercel sulla propria rete ha rilevato che nessuno dei principali crawler IA eseguiva il rendering del JavaScript: i crawler di ChatGPT e di Claude scaricavano i file JS (l’11,50% e il 23,84% delle loro richieste) ma non li eseguivano. Le eccezioni erano Gemini, che sfrutta il rendering di Googlebot, e Applebot. Lo studio è di dicembre 2024, quindi rifai il test sul tuo sito, ma corrisponde a quello che vediamo noi.
Google Analytics allarga il divario per scelta. GA4 esclude automaticamente il traffico di bot e spider noti, e non puoi disattivare questo filtro né vedere quanto traffico è stato rimosso. GA4 è lo strumento giusto per il traffico di referral dall’IA, di cui parliamo in come tracciare il traffico di referral dall’IA in GA4, e quello sbagliato per contare i crawler.
Vediamo lo stesso schema nei dati di tracciamento di AI Rank Lab. Il nostro tag JavaScript registra in modo affidabile le persone che cliccano da ChatGPT, Gemini, Perplexity e Claude, ma vede solo una fetta piccola e poco rappresentativa del traffico dei crawler, ed è per questo che non pubblichiamo conteggi di crawler basati su di esso.
Un controllo dei log in cinque minuti
- Scarica un giorno di access log grezzi dal tuo hosting o dalla CDN (Nginx e Apache registrano entrambi lo user agent nel formato combined predefinito).
- Conta le richieste per ogni token IA:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Per i token più frequenti, controlla i codici di stato. Una sfilza di 403 o 429 di solito significa che una regola del WAF o della CDN sta bloccando un bot che il tuo robots.txt consente.
- Verifica un campione di IP con i metodi visti sopra prima di fidarti di qualsiasi conteggio.
- Controlla quali URL richiedono i bot di ricerca. Se OAI-SearchBot o Claude-SearchBot scaricano solo la tua homepage, rivedi i link interni e la sitemap.
Strumenti che mostrano l’attività dei crawler IA
Trasparenza: AI Rank Lab è il nostro prodotto. Lo mettiamo per primo perché questo è il nostro sito, e abbiamo usato gli stessi criteri per ogni strumento qui sotto.
- AI Rank Lab - il monitoraggio dei bot IA registra, pagina per pagina, i referral dagli assistenti IA e le visite dei bot IA che il suo tag riesce a vedere, accanto al monitoraggio della visibilità e delle citazioni nell’IA. Per i conteggi completi dei crawler, abbinalo ai log, per i motivi spiegati sopra.
- Cloudflare AI Crawl Control - se il tuo sito passa dal proxy di Cloudflare, è la vista più completa sui crawler oggi disponibile, perché vede ogni richiesta sull’edge, compresi i bot che non eseguono mai JavaScript. Mostra anche il rispetto di robots.txt crawler per crawler.
- Analizzatori di file di log come Log File Analyser di Screaming Frog o GoAccess - funzionano sui log grezzi di qualsiasi hosting e sono ottimi per audit una tantum.
- Log grezzi più il grep qui sopra - gratis, esatti, e il riferimento con cui ogni altro strumento dovrebbe combaciare.
Per una routine di monitoraggio più approfondita sui tre bot più grandi, leggi la nostra guida al monitoraggio di GPTBot, ClaudeBot e PerplexityBot.
Come controllano i bot IA Cloudflare e le altre CDN?
Le CDN impongono sull’edge di rete quello che robots.txt può solo chiedere. AI Crawl Control di Cloudflare, disponibile su tutti i piani, mostra quali servizi di IA visitano il tuo sito, ti permette di consentire o bloccare ogni crawler, tiene traccia delle violazioni di robots.txt e offre il pay per crawl in beta privata.
Le policy di Cloudflare sui bot IA ora usano la stessa divisione in tre classi di questo articolo. Le sue impostazioni Block AI Bots offrono preset separati per Search, Agent e Training, ciascuno con «blocca su tutte le pagine», «blocca sulle pagine con annunci» o «consenti». La documentazione dice che dal 15 settembre 2026 i nuovi domini ricevono impostazioni predefinite aggiornate: bot Training e Agent bloccati sulle pagine che mostrano annunci, Search consentito, e i crawler a uso misto, che uniscono ricerca e addestramento, bloccati da qualsiasi blocco sull’addestramento. Se hai messo un sito su Cloudflare dopo quella data e ti chiedi perché ChatGPT-User o Claude-User ricevono 403 sul tuo blog, controlla prima di tutto questa impostazione.
Cloudflare può anche gestire robots.txt al posto tuo. Con Bot Preference Sync attivo, il suo robots.txt gestito antepone alle tue regole esistenti dei gruppi di disallow per Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot e meta-externalagent, più una riga Content Signals (search=yes, ai-train=no). I Content Signals sono un vocabolario proposto da Cloudflare (search, ai-input, ai-train) che indica come si possono usare i contenuti dopo averli scaricati; se un determinato operatore li rispetti o meno, dipende da quell’operatore.
Anche altri provider supportano lo stesso schema. La documentazione di Perplexity include indicazioni per configurare il WAF di Cloudflare e AWS WAF con i suoi elenchi di IP, e il centro assistenza di OpenAI spiega come mettere in allowlist il suo Cloud browser firmato in Akamai (nome del bot «ChatGPT Agent») e in Cloudflare (detection ID 129220581). Qualunque sia la tua CDN, l’ordine delle operazioni è lo stesso: decidi per classe, esprimi la decisione in robots.txt, imponila sull’edge solo dove ti serve un blocco vero, e ricontrolla i log dopo ogni modifica alla CDN.
Google e Bing: i due casi particolari
Bloccare Google-Extended incide su Google Search o su AI Overviews?
No. Google afferma che Google-Extended «non influisce sull’inclusione di un sito in Google Search né viene usato come segnale di ranking». La sua documentazione sulle funzionalità di IA è esplicita: il controllo per la Ricerca, compresi AI Overviews e AI Mode, sono le regole di robots.txt per Googlebot, e puoi limitare ciò che compare con nosnippet, data-nosnippet, max-snippet o noindex. Google-Extended riguarda l’addestramento dei modelli Gemini e il grounding nelle app Gemini e in Vertex AI, che sono separati dalla Ricerca.
Come controllare se Microsoft Copilot usa i tuoi contenuti?
Microsoft non ha un token separato per un crawler IA: a fare la scansione è Bingbot, e l’uso per l’IA si controlla con i meta tag robots a livello di pagina. L’indicazione ufficiale più recente che abbiamo trovato è l’annuncio del team di Bing del 2023, scritto quando Copilot si chiamava ancora Bing Chat: i contenuti con il tag noarchive non vengono inclusi né linkati nelle risposte della chat di Bing e non vengono usati per addestrare i modelli di base di Microsoft; i contenuti con il tag nocache possono comparire solo con URL, titolo e snippet; i contenuti senza nessuno dei due tag possono essere usati per intero. Con entrambi i tag resti nei normali risultati di Bing. Bloccare Bingbot in robots.txt ti toglierebbe anche dalla ricerca di Bing, quindi usa i meta tag.
Limiti e come abbiamo verificato
Il 18 ottobre 2026 abbiamo letto la pagina sui crawler di ciascun operatore elencato sopra, scaricato tutti gli elenchi di IP pubblicati e annotato il creationTime dentro ogni file. Non siamo riusciti a visualizzare la pagina di aiuto di Microsoft sui crawler, che funziona solo con JavaScript, quindi la riga di Bingbot si basa sul blog di Bing Webmaster, sullo strumento Verify Bingbot e sul file bingbot.json pubblicato. Le colonne su robots.txt riformulano quello che dice ciascun operatore, non quello che abbiamo misurato in modo indipendente; i risultati di Cloudflare su Perplexity sono la principale prova pubblica che le due cose possono non coincidere. Gli operatori rinominano e aggiungono bot spesso (Google, per esempio, ha sostituito il token del fetcher Google-NotebookLM con Google-GeminiNotebook), quindi considera qualsiasi elenco, compreso questo, accurato alla data del controllo.
Se vuoi capire se la tua policy sui crawler ti sta davvero portando citazioni, AI Rank Lab monitora le tue menzioni e le pagine citate su ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews e AI Mode, accanto al traffico di referral che quelle risposte ti mandano.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


