



2026年、robots.txtがこれまで以上に重要な理由
robots.txtは1994年に、クローラーに「どのページを避けてほしいか」を伝えるために生まれたファイルです。それから30年間、ウェブマスターが気にすべき大きなクローラーはほぼGooglebotの一系統だけでした。ところが2026年の今、その顔ぶれは一気に増えています。OpenAI、Anthropic、Perplexity、GoogleといったAI企業はそれぞれ専用のクローラーを動かし、モデルの学習やナレッジベースの構築、AI検索の回答生成のためにあなたのコンテンツを読み込んでいます。
これらのクローラーを許可するかブロックするかは、AI検索での露出に直結します。GPTBotがサイトをクロールできなければ、あなたのコンテンツはChatGPTの回答に反映されません。PerplexityBotをブロックすれば、Perplexityはあなたのページを引用できません。Google-Extendedがブロックされていると、GoogleのAI Overviews(「AIによる概要」)やAI Modeの回答にコンテンツが表示されない可能性があります。
AIクローラー時代にrobots.txtを正しく設定するには、どんなボットが存在し、それぞれ何をしていて、コンテンツを守りながらAIに引用されるチャンスを最大化するにはアクセスをどう設定すればいいのかを理解する必要があります。このガイドではそのすべてを解説します。数分でAI対応の設定を作れる無料のrobots.txt生成ツールも紹介します。
主要AIクローラー一覧
設定に入る前に、どのボットを対象にするのかを押さえておきましょう。2026年時点の主なAIクローラーとそのユーザーエージェントは次のとおりです。
OpenAI - ChatGPT
- ユーザーエージェント:GPTBot
- 目的:学習データの収集とChatGPTのBrowse機能
- ブロックした場合の影響:コンテンツがChatGPTの回答に反映されず、ChatGPT Browseの引用にも表示されません
- ドキュメント:OpenAIはGPTBotのIPアドレス範囲を公開リストで管理しています
Anthropic - Claude
- ユーザーエージェント:ClaudeBot(anthropic-aiとしても識別されます)
- 目的:Claude AIの学習データとナレッジベース
- ブロックした場合の影響:ユーザーがあなたの分野について質問しても、コンテンツがClaudeの回答に反映されません
- ドキュメント:Anthropicはクロールポリシーを公開しており、robots.txtの指示を尊重しています
Perplexity AI
- ユーザーエージェント:PerplexityBot
- 目的:Perplexity AIの回答と引用のためのリアルタイムウェブ検索
- ブロックした場合の影響:関連性が高いページでも、Perplexityの回答で引用されなくなります
- ドキュメント:Perplexityはrobots.txtを尊重しており、クロールに関するガイドラインを公開しています
Google - AI機能
- ユーザーエージェント:Google-Extended
- 目的:Google Bard/Geminiの学習とAI Overviewsのコンテンツ
- ブロックした場合の影響:コンテンツがGoogleのAI Overviews、AI Mode、Geminiの回答に表示されない可能性があります
- 補足:Googlebotとは別物です。Googlebot(従来の検索)は許可しつつ、Google-Extended(AI機能)だけをブロックすることもできます
Microsoft - Copilot
- ユーザーエージェント:Bingbot(共通)、Copilot専用のクローラーはケースによって異なります
- 目的:Microsoft CopilotとBingのAI回答を支える
- ブロックした場合の影響:Microsoft CopilotやBingのAI機能での露出が減ります
Meta - Llama
- ユーザーエージェント:FacebookBot、Meta-ExternalAgent
- 目的:Meta AIとLlamaモデルの学習データ
- ブロックした場合の影響:コンテンツがMeta AIの回答に反映されません
Apple - Applebot
- ユーザーエージェント:Applebot、Applebot-Extended
- 目的:Siri、Apple Intelligence、Appleの検索機能
- ブロックした場合の影響:SiriやAppleのAI機能での露出が減ります
問題点:ほとんどのrobots.txtはAIクローラー登場前に書かれている
2020〜2023年ごろの典型的なrobots.txtは、次のようなものです。
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
この設定はGooglebotを許可していますが、それ以外のボットはすべてワイルドカードのルール任せです。解釈次第では、ワイルドカードのルールがサイトの一部でAIクローラーをブロックしているかもしれませんし、逆に守りたいページも含めてどこでもアクセスを許してしまっているかもしれません。
さらに困ったことに、AIの学習データ利用に対するパブリッシャーの反発がピークだったAIクローラー初期(2022〜2023年)に、強めのブロックを追加したサイトもあります。すべてのボットにDisallow: /を設定していたなら、AIクローラーを締め出したまま忘れているかもしれません。その影響は、AI検索の回答で自社ブランドの露出が少ないと気づいたときに初めて見えてきます。
AI Rank LabのAIボットトラッキング機能を使えば、手作業でログを分析しなくても、どのAIボットが実際にページを訪れているか、どのAIアシスタントがリファラルトラフィックを送ってくれているかがわかります。許可したつもりのクローラーが一度も現れないなら、robots.txtでそのクローラーのルールを確認してみてください。
ケース別robots.txtテンプレート
これらのテンプレートは、無料のrobots.txt生成ツールで自分のサイト向けにカスタマイズできます。以下はよく使われる設定です。
テンプレート1:AIに全面的にアクセスを許可(ほとんどのサイトにおすすめ)
すべてのAIクローラーにコンテンツへのアクセスを許可します。AI検索での露出を最大化したく、コンテンツがAIモデルの学習に使われることにも抵抗がないサイトに最適です。
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
テンプレート2:AIのアクセスを部分的に許可(コンテンツ保護)
公開コンテンツのページではAIクローラーを許可し、プレミアムコンテンツや有料記事、会員エリアはブロックします。サブスクリプション型のメディアや、会員限定コンテンツがあるサイトに最適です。
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
テンプレート3:AIの学習はブロックし、AI検索は許可
少しひねった設定です。コンテンツをリアルタイムの引用に使うPerplexityは許可し、モデルの学習にコンテンツを使う学習用クローラーはブロックします。AI検索での引用は欲しいけれど、モデルの学習に使われるのは避けたいパブリッシャーによくある落としどころです。
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml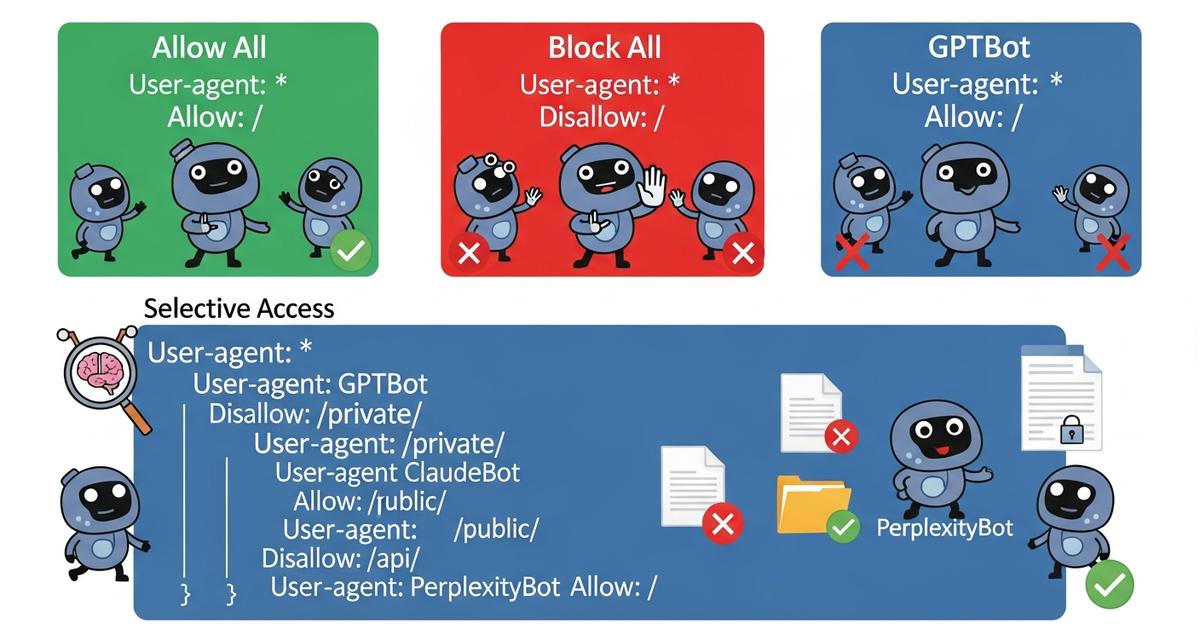
自分のサイトに合う設定はどう選ぶ?
最適なrobots.txtの設定は、コンテンツの種類、ビジネスモデル、AI検索での露出の目標によって変わります。次の判断基準を参考にしてください。
すべてのAIクローラーを許可するのはこんなとき:
- 誰でも読めるコンテンツ(ブログ、ドキュメント、資料)を公開している
- AI検索での露出を最大化したく、引用が集客源になっている
- 保護が必要な会員限定やプレミアムのコンテンツがない
- 情報提供型のコンテンツで、広く届くほどメリットがある
部分的なアクセスにするのはこんなとき:
- 無料コンテンツとプレミアムコンテンツが混在している
- 引用されたくないページがある(アカウントページ、購入手続き、会員限定コンテンツ)
- サイト全体をクロールさせるより、AIクローラーに優れたコンテンツへ集中してほしい
学習用クローラーをブロック(検索のみ許可)するのはこんなとき:
- AIの学習データ利用に懸念を持つパブリッシャーである
- それでもPerplexityやGoogleのAI Overviews(リアルタイム引用)には表示されたい
- コンテンツをAI企業へ個別にライセンス提供する選択肢を残しておきたい
すべてのAIクローラーをブロックするのは、こんなときだけ:
- コンテンツをAIシステムから遠ざけるべき明確な法的・競争上の理由がある
- 特定のAI企業とライセンス契約を結んでいて、独占性を守りたい
- ドメインのAI検索での露出がゼロになるというトレードオフを理解している
よくある失敗と注意点
失敗1:未知のボットをワイルドカードでブロックする
User-agent: * / Disallow: /のあとにGooglebot向けの許可ルールだけを書くような設定では、明示的な許可ルールがないAIクローラーはすべてブロックされます。AIクローラーへのアクセスは、必ず明示的に指定しましょう。
失敗2:現在の設定を把握していない
自社のrobots.txtがAIクローラーについて今どうなっているのか、知らないチームは少なくありません。今すぐyoursite.com/robots.txtを確認してみてください。AI Rank Labのツールも役立ちます。無料のサイト監査で、robots.txtが存在してアクセス可能かどうかをチェックできます。
失敗3:GooglebotとGoogle-Extendedを混同する
Googlebotを許可しても、Google-Extended(AI機能用のクローラー)が自動的に許可されるわけではありません。GoogleのAI OverviewsやAI Modeに表示されたいなら、Google-Extendedを許可する明示的なルールが必要です。
失敗4:変更後にテストしない
robots.txtを更新したら、公開中のファイルを確認し、robots.txtのテストツールを使って変更が反映されたかを検証しましょう。Google Search ConsoleにはGooglebot用のrobots.txtテスターが組み込まれていますが、AIクローラーのルールは手作業で確認する必要があります。
失敗5:一度設定したら放置する
新しいAIクローラーは次々に登場しています。2023年時点のAIユーザーエージェントのリストは、2026年の今ではすでに不完全です。robots.txtは少なくとも四半期に一度は見直し、大手AI企業が新しいクローラーのドキュメントを出していないかもチェックしましょう。
robots.txtだけじゃない:AIクローラーを制御するための全体像
robots.txtはAIクローラーのアクセスを制御するうえで最も重要な手段ですが、唯一の手段ではありません。AEOの技術的な設定を一通り整えるなら、次の要素が含まれます。
- robots.txt:クローラーのアクセスルール(ここまで解説した内容)
- llms.txt:サイトが何を扱っていて、コンテンツをどう使ってほしいかをLLMに伝えるガイドファイル。robots.txtを置き換えるものではなく、補完するものです
- noindexメタタグ:特定のページがインデックスされるのを防ぐページ単位の制御。一部のAIクローラーはこれを尊重します
- AIボットのモニタリング:どのクローラーがどれくらいの頻度でサイトにアクセスしているかを追跡します。AI Rank Labのボットトラッキング機能なら、ログを分析しなくてもこれを把握できます
無料のrobots.txt生成ツールを使ってみよう
robots.txtを一から書く代わりに、AI Rank Labの無料robots.txt生成ツールを使ってみてください。設定タイプ(全面許可、部分許可、学習をブロック、カスタム)を選び、保護したいパスを指定するだけで、現在のAIクローラーのユーザーエージェントをすべて含んだ、正しい形式のファイルを生成してくれます。出力はそのままサーバーにコピーすることも、ファイルとしてダウンロードすることもできます。
生成ツールは新しいAIクローラーのユーザーエージェントが出るたびに更新されているので、この記事の執筆時点では存在しなかったボットまで考慮した設定が手に入ります。
まとめ
robots.txtは、AI検索での露出を直接コントロールできる操作パネルです。正しく設定すれば、AIクローラーがコンテンツにアクセスして学習でき、それがChatGPT、Perplexity、Claude、Geminiの回答での引用につながります。逆に設定を誤ったり、古いファイルをそのまま放置したりすると、コンテンツと、ますます情報探しの入り口になりつつあるAIエンジンとの間に、目に見えない壁ができてしまいます。
今のrobots.txtを確認し、無料の生成ツールでAI対応の設定を作る。この5分の手間は、AI検索での露出のために打てる技術的な施策のなかでも、特に費用対効果の高いものです。今日さっそく取りかかり、新しいAIクローラーが登場することを見越して、四半期ごとに見直すリマインダーを設定しておきましょう。
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


