



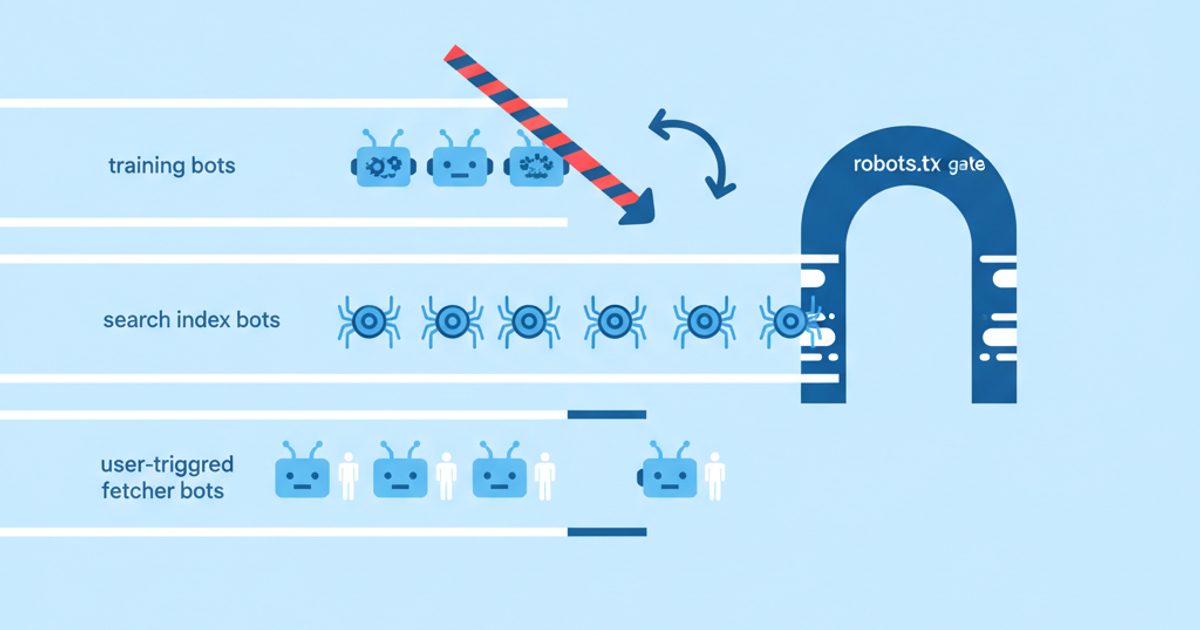
Crawlers de IA são bots automatizados mantidos por empresas de IA que acessam páginas da web para um de três trabalhos: coletar dados de treinamento para modelos (GPTBot, ClaudeBot), montar o índice de busca que as respostas de IA citam (OAI-SearchBot, Claude-SearchBot, PerplexityBot) ou buscar uma página ao vivo porque um usuário perguntou sobre ela a um assistente (ChatGPT-User, Claude-User, Perplexity-User). Bloquear um crawler de treinamento mantém seu conteúdo fora de modelos futuros; bloquear um crawler de busca ou um fetcher de usuário tira você das respostas e citações de IA. A decisão inteira gira em torno dessa diferença.
Este é um material de referência para colocar em prática. Cada user agent abaixo foi conferido na documentação oficial do próprio operador em 18 de outubro de 2026, com link para a página consultada. Você também encontra uma matriz de decisão por objetivo de negócio, grupos de robots.txt prontos para copiar, o método de verificação que cada operador aceita (com a data registrada dentro de cada lista de IPs publicada) e uma análise honesta de por que o analytics em JavaScript não mostra a maior parte do tráfego de crawlers.
Principais pontos
- Classifique todo bot de IA como de treinamento, de busca/indexação ou acionado pelo usuário. OpenAI, Anthropic, Amazon, Meta e Mistral publicam um token separado para cada classe, então dá para bloquear uma sem mexer nas outras.
- Bloquear o GPTBot não tira você da busca do ChatGPT. Segundo a OpenAI, só o OAI-SearchBot controla isso, e sites que bloquearam o OAI-SearchBot ainda podem aparecer como links de navegação.
- Google-Extended e Applebot-Extended são tokens de controle, não crawlers. Eles nunca aparecem nos seus logs, e o Google afirma que o Google-Extended não tem efeito nenhum na Pesquisa Google, o que inclui AI Overviews e AI Mode.
- Fetchers acionados pelo usuário podem ignorar o robots.txt por design: OpenAI, Perplexity, Google, Meta e Amazon dizem isso na própria documentação. Use um WAF se precisar de um bloqueio de verdade.
- A maioria dos crawlers de IA não executa JavaScript, então uma tag de analytics em JS vai contar bem menos visitas do que existem. Logs de servidor ou de CDN são a fonte confiável para a atividade de crawlers.
- Verifique bots por DNS reverso (Google, Apple, Common Crawl) ou comparando o IP com a lista JSON publicada pelo operador. Algumas dessas listas têm anos, então baixe-as de novo periodicamente.
O que são crawlers de IA e quais são as três classes?
Um crawler de IA é qualquer cliente automatizado que uma empresa de IA usa para requisitar suas páginas. Hoje os operadores separam os bots por finalidade, e é a finalidade que define quanto custa bloquear cada um. Os dados de rede da Cloudflare mostram como essa mistura é desequilibrada: nos 12 meses até meados de 2025, 80% do rastreamento por IA foi para treinamento, 18% para busca e 2% para ações de usuários, com o treinamento subindo para 82% nos seis meses mais recentes desse período.
Crawlers de treinamento
Crawlers de treinamento coletam conteúdo que pode ser usado para treinar ou fazer fine-tuning de modelos fundacionais. Aqui entram GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training e CCBot (o dataset aberto do Common Crawl, usado por muitos criadores de modelos). Bloqueá-los sinaliza que seu conteúdo futuro deve ficar fora dos conjuntos de treinamento. Isso não remove o que já foi coletado e não afeta a possibilidade de a busca por IA citar você.
Crawlers de busca e indexação
Crawlers de busca montam o índice de recuperação em que as respostas de IA se baseiam e para o qual as citações apontam. OAI-SearchBot (busca do ChatGPT), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index e DuckAssistBot são específicos de IA. Googlebot, Bingbot e Applebot são crawlers de busca clássicos cujo índice agora também alimenta recursos de IA: AI Overviews e AI Mode do Google, Microsoft Copilot e as respostas da Siri. Bloquear um crawler de busca é o erro caro, porque tira você das respostas que seus compradores leem. Se quiser entender na prática como um desses índices é usado, veja como funciona a busca do ChatGPT.
Fetchers e agentes acionados pelo usuário
Fetchers acionados pelo usuário visitam uma única URL porque alguém pediu a um assistente para ler, resumir ou agir sobre aquela página. Aqui entram ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User e MistralAI-User, além de agentes de navegador com assinatura, como o navegador em nuvem do ChatGPT. Vários operadores afirmam que o robots.txt pode não valer para esses bots, já que quem iniciou a requisição foi uma pessoa.
Tokens de controle que não são crawlers
Dois nomes que aparecem em toda lista nunca acessam nada por conta própria. O Google-Extended é um token de produto do robots.txt que o Google lê enquanto rastreia com seus user agents normais; ele controla se o conteúdo pode ser usado para treinar futuros modelos Gemini e para grounding (embasamento das respostas) nos Gemini Apps e na Vertex AI. O Applebot-Extended faz o mesmo para os modelos fundacionais da Apple. Você não vai encontrar nenhuma dessas strings nos seus logs de acesso, e é por isso que “bloqueei o Google-Extended, mas continuo vendo tráfego do Google” é o comportamento esperado.
Lista de crawlers de IA: todos os principais user agents, verificados em 18 de outubro de 2026
A tabela traz o token que vai na linha User-agent:, quem opera o bot, sua classe, o que a documentação do próprio operador diz sobre robots.txt, como você pode verificá-lo e a página oficial que consultamos. “Segundo a doc” significa que a coluna de robots.txt resume o que o operador diz; quando a documentação não fala nada, dizemos isso em vez de chutar.
| Token | Operador | Classe | O que faz | Robots.txt (segundo a doc) | Verificar via | Doc oficial |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Treinamento | Rastreia conteúdo que pode ser usado para treinar os modelos fundacionais da OpenAI | Sim | gptbot.json | Crawlers da OpenAI |
| OAI-SearchBot | OpenAI | Busca | Exibe sites nas respostas da busca do ChatGPT; não é usado para treinamento | Sim, mudanças levam cerca de 24 horas | searchbot.json | Crawlers da OpenAI |
| ChatGPT-User | OpenAI | Acionado pelo usuário | Visita páginas para ações de usuários no ChatGPT e em Custom GPTs | Pode não se aplicar | chatgpt-user.json | Crawlers da OpenAI |
| OAI-AdsBot | OpenAI | Especial | Verifica landing pages enviadas como anúncios do ChatGPT; não é usado para treinamento | Não informado; visita só páginas de anúncios enviadas | adsbot.json | Crawlers da OpenAI |
| ClaudeBot | Anthropic | Treinamento | Coleta conteúdo que pode contribuir para o treinamento dos modelos Claude | Sim; aceita Crawl-delay | bots.json (compartilhado) | Central de ajuda da Anthropic |
| Claude-SearchBot | Anthropic | Busca | Indexa conteúdo para melhorar os resultados de busca do Claude | Sim | bots.json (compartilhado) | Central de ajuda da Anthropic |
| Claude-User | Anthropic | Acionado pelo usuário | Busca páginas quando um usuário do Claude faz uma pergunta | Sim, desativar interrompe a recuperação feita a pedido do usuário | bots.json (compartilhado) | Central de ajuda da Anthropic |
| PerplexityBot | Perplexity | Busca | Exibe e linka sites nos resultados do Perplexity; não é usado para treinamento | Sim, em até 24 horas | perplexitybot.json | Crawlers do Perplexity |
| Perplexity-User | Perplexity | Acionado pelo usuário | Visita páginas para responder à pergunta de um usuário | Geralmente ignora | perplexity-user.json | Crawlers do Perplexity |
| Googlebot | Busca | Pesquisa Google, incluindo AI Overviews e AI Mode | Sim, sempre nos rastreamentos automáticos | DNS reverso ou common-crawlers.json | Crawlers comuns do Google | |
| Google-Extended | Token de controle | Treinamento do Gemini e grounding nos Gemini Apps e na Vertex AI | Só token; não tem user agent próprio | Não se aplica | Crawlers comuns do Google | |
| Google-CloudVertexBot | Busca (a pedido do dono do site) | Rastreia sites cujos donos criam Vertex AI Agents com base neles | Sim | DNS reverso ou common-crawlers.json | Crawlers comuns do Google | |
| Google-Agent | Agente acionado pelo usuário | Agentes na infraestrutura do Google que navegam e agem a pedido do usuário | Geralmente ignora (acionado pelo usuário) | user-triggered-agents.json; algumas requisições assinadas com Web Bot Auth | Fetchers do Google acionados pelo usuário | |
| Google-GeminiNotebook | Acionado pelo usuário | Busca URLs que os usuários adicionam como fontes no Gemini Notebook (antigo agente Google-NotebookLM, aceito até agosto de 2026) | Geralmente ignora (acionado pelo usuário) | Listas JSON dos fetchers acionados pelo usuário | Fetchers do Google acionados pelo usuário | |
| Bingbot | Microsoft | Busca | Índice do Bing, que também embasa as respostas do Copilot | Sim; o uso por IA é controlado com noarchive/nocache no nível da página | bingbot.json ou a ferramenta Verify Bingbot do Bing | Blog do Bing Webmaster |
| Applebot | Apple | Busca (pode também treinar) | Busca do Spotlight, da Siri e do Safari; os dados também podem treinar modelos da Apple | Sim; segue as regras do Googlebot se o Applebot não for citado; ignora Crawl-delay | DNS reverso (*.applebot.apple.com) ou applebot.json | Sobre o Applebot |
| Applebot-Extended | Apple | Token de controle | Exclui o conteúdo do treinamento dos modelos fundacionais da Apple | Só token | Não se aplica | Sobre o Applebot |
| Meta-ExternalAgent | Meta | Treinamento | Treina modelos fundacionais de IA ou indexa conteúdo diretamente | Sim | User agent mais os IPs publicados pela Meta | Web crawlers da Meta |
| Meta-WebIndexer | Meta | Busca | Melhora os resultados de busca da Meta AI para que ela possa citar e linkar você | Sim | User agent mais os IPs publicados pela Meta | Web crawlers da Meta |
| Meta-ExternalFetcher | Meta | Acionado pelo usuário | Busca links a pedido de um usuário, inclusive para tarefas de agentes | Pode ignorar | User agent mais os IPs publicados pela Meta | Web crawlers da Meta |
| Amazonbot | Amazon | Treinamento | Melhora os produtos da Amazon; pode ser usado para treinar modelos de IA da Amazon | Sim (RFC 9309); ignora Crawl-delay | Página de IPs publicados | Amazonbot |
| Amzn-SearchBot | Amazon | Busca | Experiências de busca como a Alexa; não é usado para treinamento | Sim; herda as regras de outros bots de busca se não for citado | Página de IPs publicados | Amazonbot |
| Amzn-User | Amazon | Acionado pelo usuário | Busca informações ao vivo para perguntas feitas à Alexa; não é usado para treinamento | Pode não seguir todas as diretivas | Página de IPs publicados | Amazonbot |
| MistralAI-Training | Mistral | Treinamento | Monta datasets para treinar os modelos da Mistral | Sim, pode ser bloqueado com Disallow | User agent | Crawlers da Mistral |
| MistralAI-Index | Mistral | Busca | Indexa conteúdo para a busca da Mistral no Vibe; não é usado para treinamento | Sim | mistralai-index-ips.json | Crawlers da Mistral |
| MistralAI-User | Mistral | Acionado pelo usuário | Visita páginas quando usuários do Vibe fazem uma pergunta | Sim, define quais sites as requisições dos usuários podem acessar | mistralai-user-ips.json | Crawlers da Mistral |
| DuckAssistBot | DuckDuckGo | Busca (tempo real) | Rastreia páginas para as respostas assistidas por IA do DuckDuckGo; não é usado para treinamento | Sim, entra em vigor após 72 horas | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Treinamento (dataset aberto) | Monta o corpus aberto do Common Crawl, muito usado para treinar modelos | Sim | DNS reverso (*.crawl.commoncrawl.org, só IPv4) | CCBot |
A tabela resolve duas dúvidas comuns. Primeiro, a página atual da Anthropic lista exatamente três bots: ClaudeBot, Claude-SearchBot e Claude-User. Listas antigas ainda trazem “anthropic-ai” e “Claude-Web”, que não aparecem na documentação da Anthropic em outubro de 2026. Segundo, os números de versão da OpenAI mudam: no dia em que conferimos, as strings de exemplo da OpenAI mostravam GPTBot/1.4 e OAI-SearchBot/1.4, então faça a correspondência pelo token, nunca pela string completa.
Bots sem documentação oficial
Alguns bots que aparecem nos logs não tinham nenhuma página do operador que conseguíssemos encontrar em 18 de outubro de 2026. O Bytespider, da ByteDance, é o mais conhecido; os agentes ligados ao Grok, da xAI, são outro caso. Diretórios de terceiros discordam sobre como eles se comportam, por isso os deixamos fora da tabela verificada. O robots.txt gerenciado da Cloudflare inclui um disallow para o Bytespider, e a Cloudflare informou que a participação do Bytespider no rastreamento por IA caiu de 14,1% para 2,4% entre meados de 2024 e meados de 2025. Se algum desses bots importa para você, aplique sua política com uma regra de WAF em vez de confiar no robots.txt.
Os crawlers de IA respeitam o robots.txt?
Os crawlers de treinamento e de busca documentados dizem que sim; os fetchers acionados pelo usuário muitas vezes dizem que não; e o robots.txt nunca é controle de acesso. O próprio padrão, a RFC 9309, afirma que “essas regras não são uma forma de autorização de acesso”. Ele também permite que os crawlers guardem seu arquivo em cache por até 24 horas, e é por isso que todo operador fala em um prazo antes de as mudanças valerem.
Dizer que cumpre não é o mesmo que cumprir na prática. Em agosto de 2025, a Cloudflare publicou um teste em que domínios recém-criados, que bloqueavam tudo, ainda eram descritos em detalhes pelo Perplexity. A Cloudflare disse ter observado um agente Perplexity-User declarado fazendo 20-25 milhões de requisições diárias e um agente não declarado, parecido com o Chrome, fazendo 3-6 milhões, e depois tirou o Perplexity da lista de bots verificados. É a constatação de um fornecedor sobre um operador, mas mostra por que uma string de user agent sozinha não prova nada.
| Operador | Quanto tempo as mudanças no robots.txt levam (segundo a doc) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | Cerca de 24 horas | Não informado |
| Perplexity | Até 24 horas | Não informado |
| Amazon | Cerca de 24 horas; pode usar uma cópia em cache de até 30 dias | Não aceito |
| Meta | Até 24 horas | Não informado |
| DuckDuckGo (DuckAssistBot) | 72 horas | Não informado |
| Anthropic | Não informado | Aceito |
| Apple | Não informado | Não aceito |
Quanto custa bloquear cada classe de crawler de IA?
Bloquear crawlers de treinamento custa pouca visibilidade hoje; bloquear crawlers de busca ou fetchers de usuário custa citações na hora. A tabela relaciona cada classe ao custo que os próprios operadores descrevem.
| Se você bloquear... | Você fica fora de | Você perde | Você continua aparecendo em |
|---|---|---|---|
| Crawlers de treinamento (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | Futuros datasets de treinamento daquele operador | Pouca visibilidade no curto prazo; talvez o quanto os modelos futuros “conhecem” sua marca sem precisar buscar | Busca do ChatGPT, busca do Claude, Perplexity, Pesquisa Google e AI Overviews, desde que os bots de busca deles estejam liberados |
| Crawlers de busca por IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | O índice de recuperação daquele mecanismo | Citações e links nas respostas daquele mecanismo; a OpenAI mantém só os links de navegação | Buscadores clássicos, a menos que você também os bloqueie |
| Fetchers acionados pelo usuário (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | Buscas ao vivo pedidas pelos usuários, quando o operador respeita o bloqueio | Respostas quando um usuário cola sua URL ou pergunta sobre ela; tarefas de agentes como checkout ou reserva | Respostas baseadas no índice, se o bot de busca estiver liberado |
| Googlebot | A Pesquisa Google inteira | Rankings orgânicos, AI Overviews e AI Mode, tudo junto | Nada no Google; raramente é isso que você quer |
O tamanho da troca também pesa. A Cloudflare mediu quantas páginas cada plataforma de IA rastreia para cada visitante que ela devolve ao site: em julho de 2025, a Anthropic estava em cerca de 38.000 rastreamentos por visitante encaminhado e o Perplexity em 194. Essas proporções são o argumento econômico que os publishers usam para bloquear crawlers de treinamento e manter os de busca liberados.
Quais crawlers de IA liberar ou bloquear? Uma matriz de decisão por objetivo de negócio
Comece pelo que você vende. Se ser recomendado por um assistente de IA pode trazer um cliente, libere todos os crawlers de busca e fetchers de usuário, e trate o treinamento como uma decisão à parte, e menor.
| Sua situação | Crawlers de treinamento | Crawlers de busca | Fetchers de usuário e agentes | Por quê |
|---|---|---|---|---|
| SaaS B2B, agências, serviços locais | Liberar (ou bloquear, custo baixo) | Liberar | Liberar | Compradores montam a lista de fornecedores nas respostas de IA; estar no conhecimento do modelo também ajuda em menções espontâneas |
| E-commerce | Você decide | Liberar | Liberar e colocar os agentes assinados na allowlist do seu WAF | Respostas de compras citam páginas de produto, e os agentes precisam chegar ao carrinho e ao checkout |
| Portais de notícias e publishers financiados por anúncios | Bloquear | Liberar, ou bloquear em páginas com anúncios | Decidir por operador | O conteúdo é o produto; as citações ainda trazem alguns leitores de volta |
| Documentação para desenvolvedores e projetos open source | Liberar | Liberar | Liberar | Desenvolvedores perguntam aos assistentes como usar sua API; um modelo bem informado reduz a carga do suporte |
| Conteúdo com paywall ou licenciado | Bloquear | Liberar só as páginas de índice | Bloquear com WAF se o licenciamento exigir | Mantenha os teasers citáveis e o texto completo fora |
| Staging, intranets, apps privados | Bloquear | Bloquear | Bloquear | Use autenticação; o robots.txt é um pedido, não uma fechadura |
| Servidor sobrecarregado por rastreamento | Limitar a taxa ou bloquear | Liberar, com limite de taxa na CDN | Liberar | Resolva a carga na borda em vez de perder citações |
Como bloquear crawlers de treinamento de IA e liberar a busca por IA no robots.txt?
Dê a cada token de treinamento seu próprio grupo com Disallow: / e deixe os crawlers de busca cobertos pelas suas regras normais. Um crawler obedece só ao grupo mais específico que o cita, então um bloqueio de treinamento nunca vaza para os bots de busca.
Snippet 1: bloquear o treinamento e manter a busca por IA e os fetchers de usuário
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
A RFC 9309 permite que várias linhas User-agent compartilhem um mesmo grupo, e a correspondência não diferencia maiúsculas de minúsculas. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot e Bingbot caem no grupo * e continuam liberados.
Snippet 2: deixar a busca por IA liberada de forma explícita
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Citar os bots de busca pelo nome protege você de uma regra genérica criada no futuro por outra pessoa, como um plugin que adiciona User-agent: * com Disallow: /. Mantenha os caminhos privados bloqueados dentro do grupo, porque um grupo nomeado substitui o grupo * para aquele bot em vez de se somar a ele.
Snippet 3: três pegadinhas que quebram arquivos reais
- O Applebot herda as regras do Googlebot. Segundo a Apple, se o seu arquivo não menciona o Applebot mas menciona o Googlebot, o Applebot segue o grupo do Googlebot. Um bloqueio específico para o Googlebot pode tirar você da Siri e do Spotlight sem você perceber.
- O Amzn-SearchBot herda as regras de outros bots de busca quando não é citado, segundo a Amazon. Cite-o pelo nome se quiser um resultado diferente.
- Subdomínios precisam de um arquivo próprio. Anthropic e Amazon dizem que leem o robots.txt por host, então
docs.example.comprecisa da sua própria cópia.
Você pode montar e conferir esses grupos com o gerador de robots.txt gratuito do AI Rank Lab, e nossos modelos de robots.txt para crawlers de IA se aprofundam em configurações de acesso total e de acesso seletivo.
Como verificar se um crawler de IA é real e não falsificado?
Nunca confie só no user agent: qualquer um pode mandar “GPTBot” em um cabeçalho, e o próprio Common Crawl avisa na sua página que há crawlers se passando por CCBot. Os operadores aceitam três métodos de verificação, e qual usar depende do operador.
- DNS reverso e depois DNS direto. Rode
hostno IP que aparece no seu log, confira se o hostname termina no domínio do operador e então rodehostnesse hostname para confirmar que ele devolve o mesmo IP. O Google documenta isso paragooglebot.com,google.comegoogleusercontent.comno seu guia de verificação; a Apple usa*.applebot.apple.com; o Common Crawl usa*.crawl.commoncrawl.org(só IPv4). - Compare o IP com a lista publicada pelo operador. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral e Amazon publicam faixas de IP. Esse é o único método para OpenAI, Anthropic e Perplexity, que não documentam um padrão de DNS reverso.
- Confira uma assinatura criptográfica (Web Bot Auth). O navegador em nuvem do ChatGPT assina suas requisições segundo a RFC 9421, com um cabeçalho
Signature-Agentde valor"https://chatgpt.com". O Google está testando o mesmo rascunho do IETF em algumas requisições do Google-Agent, assinadas comohttps://agent.bot.goog, e sua página sobre Web Bot Auth recomenda manter a checagem de IP como alternativa, porque nem toda requisição é assinada.
# Consulta reversa e depois direta (exemplo do Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# Checagem pela lista de IPs do crawler de busca da OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
Quão atualizadas estão as listas de IPs publicadas?
Baixamos todos os arquivos de IPs de crawlers de IA publicados em 18 de outubro de 2026 e lemos o campo creationTime que cada operador grava neles. Uma data antiga pode significar apenas que as faixas não mudaram, mas ela indica o quanto dá para confiar em uma allowlist fixa no código e mostra quais listas não conseguem dar conta de tráfego que o operador nunca declarou.
| Lista publicada | creationTime no arquivo | Prefixos IPv4 / IPv6 |
|---|---|---|
| Crawlers comuns do Google (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Agentes do Google acionados pelo usuário (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (os três bots, uma lista) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Duas lições práticas. As listas do Google e a do ChatGPT-User da OpenAI mudaram nas últimas duas semanas, então uma allowlist de firewall copiada no meio do ano provavelmente já está errada; baixe esses arquivos diária ou semanalmente. E a Anthropic diz que bloquear seus IPs “pode não funcionar corretamente nem garantir de forma permanente a exclusão”, porque isso impede a Anthropic de ler seu robots.txt; então use o robots.txt para se excluir e os IPs só para verificar.
Como enxergar a atividade dos crawlers de IA: logs de servidor ou tags em JavaScript?
Use logs de servidor ou de CDN para os crawlers e analytics em JavaScript para os visitantes humanos que chegam dos assistentes de IA. Uma tag JS só roda quando algo executa o JavaScript da página, e a maioria dos crawlers de IA não faz isso. A análise da Vercel sobre a própria rede concluiu que nenhum dos principais crawlers de IA renderizava JavaScript; os crawlers do ChatGPT e do Claude baixavam arquivos JS (11,50% e 23,84% das requisições deles), mas não os executavam. As exceções eram o Gemini, que usa a renderização do Googlebot, e o Applebot. O estudo é de dezembro de 2024, então teste de novo no seu site, mas ele bate com o que vemos.
O Google Analytics aumenta essa lacuna por design. O GA4 exclui automaticamente o tráfego de bots e spiders conhecidos, e não dá para desligar isso nem ver quanto foi removido. O GA4 é a ferramenta certa para o tráfego de referência vindo de IA, que explicamos em como rastrear o tráfego de referência de IA no GA4, e a ferramenta errada para contar crawlers.
Vemos o mesmo padrão nos dados de rastreamento do próprio AI Rank Lab. Nossa tag em JavaScript registra com confiabilidade as pessoas que clicam vindas do ChatGPT, Gemini, Perplexity e Claude, mas enxerga só uma fatia pequena e pouco representativa do tráfego de crawlers, e é por isso que não publicamos contagens de crawlers a partir dela.
Uma checagem de logs em cinco minutos
- Baixe um dia de logs de acesso brutos da sua hospedagem ou CDN (Nginx e Apache registram o user agent no formato combinado padrão).
- Conte as requisições por token de IA:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Para os tokens que mais aparecem, confira os códigos de status. Uma enxurrada de 403 ou 429 geralmente significa que uma regra de WAF ou de CDN está bloqueando um bot que o seu robots.txt libera.
- Verifique uma amostra de IPs com os métodos acima antes de confiar em qualquer contagem.
- Veja quais URLs os bots de busca requisitam. Se o OAI-SearchBot ou o Claude-SearchBot só buscam sua home, revise a linkagem interna e o seu sitemap.
Ferramentas que mostram a atividade dos crawlers de IA
Aviso: o AI Rank Lab é o nosso produto. Ele aparece primeiro porque este é o nosso site, e usamos os mesmos critérios para todas as ferramentas abaixo.
- AI Rank Lab - o rastreamento de bots de IA registra as referências vindas de assistentes de IA e as visitas de bots de IA que a tag consegue ver, por página, ao lado do acompanhamento da sua visibilidade e das suas citações em IA. Combine com os logs para ter a contagem completa de crawlers, pelos motivos acima.
- Cloudflare AI Crawl Control - se o seu site passa pelo proxy da Cloudflare, esta é a visão de crawlers mais completa disponível, porque ela enxerga cada requisição na borda, inclusive de bots que nunca executam JavaScript. Também mostra o cumprimento do robots.txt por crawler.
- Analisadores de arquivos de log, como o Log File Analyser do Screaming Frog ou o GoAccess - funcionam com logs brutos de qualquer hospedagem e são ótimos para auditorias pontuais.
- Logs brutos mais o grep acima - grátis, exatos e a referência com a qual qualquer outra ferramenta deveria bater.
Para uma rotina de monitoramento mais completa, focada nos três maiores bots, veja nosso guia de monitoramento de GPTBot, ClaudeBot e PerplexityBot.
Como a Cloudflare e outras CDNs controlam os bots de IA?
As CDNs impõem na borda da rede aquilo que o robots.txt só consegue pedir. O AI Crawl Control da Cloudflare, disponível em todos os planos, mostra quais serviços de IA acessam seu site, permite liberar ou bloquear cada crawler, acompanha violações do robots.txt e oferece pay per crawl (cobrança por rastreamento) em beta privado.
As políticas de bots de IA da Cloudflare agora usam a mesma divisão em três classes deste artigo. As configurações de Block AI Bots oferecem predefinições separadas para Search, Agent e Training, cada uma com as opções “bloquear em todas as páginas”, “bloquear em páginas com anúncios” ou “permitir”. A documentação diz que, a partir de 15 de setembro de 2026, novos domínios recebem padrões atualizados: bots de Training e Agent bloqueados em páginas que exibem anúncios, Search liberado, e crawlers de uso misto, que combinam busca e treinamento, bloqueados por qualquer bloqueio de treinamento. Se você colocou um site na Cloudflare depois dessa data e não entende por que o ChatGPT-User ou o Claude-User recebem 403 no seu blog, confira essa configuração primeiro.
A Cloudflare também pode gerenciar o robots.txt por você. Com o Bot Preference Sync ativado, o robots.txt gerenciado dela adiciona, antes das suas regras existentes, grupos de disallow para Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot e meta-externalagent, além de uma linha de Content Signals (search=yes, ai-train=no). Content Signals são um vocabulário proposto pela Cloudflare (search, ai-input, ai-train) que diz como o conteúdo pode ser usado depois de baixado; se um operador vai respeitá-los ou não, cabe a ele.
Outros provedores seguem o mesmo padrão. A documentação do Perplexity traz orientações de WAF para Cloudflare e AWS WAF usando suas listas de IPs, e a central de ajuda da OpenAI mostra como colocar seu navegador em nuvem assinado na allowlist no Akamai (nome do bot “ChatGPT Agent”) e na Cloudflare (detection ID 129220581). Seja qual for a sua CDN, a ordem é a mesma: decida por classe, expresse isso no robots.txt, imponha na borda só onde precisar de bloqueio de verdade e revise seus logs depois de qualquer mudança na CDN.
Google e Bing: os dois casos especiais
Bloquear o Google-Extended afeta a Pesquisa Google ou os AI Overviews?
Não. O Google afirma que o Google-Extended “não afeta a inclusão de um site na Pesquisa Google nem é usado como sinal de ranking”. Sua documentação sobre recursos de IA deixa claro que as regras de robots.txt para o Googlebot são o controle da Pesquisa, incluindo AI Overviews e AI Mode, e que você limita o que aparece usando nosnippet, data-nosnippet, max-snippet ou noindex. O Google-Extended cobre o treinamento dos modelos Gemini e o grounding nos Gemini Apps e na Vertex AI, que são separados da Pesquisa.
Como controlar se o Microsoft Copilot usa seu conteúdo?
A Microsoft não tem um token separado para crawler de IA; quem rastreia é o Bingbot, e você controla o uso por IA com meta tags robots no nível da página. A orientação oficial mais recente que encontramos é o anúncio de 2023 da equipe do Bing, escrito quando o Copilot ainda se chamava Bing Chat: conteúdo marcado com noarchive não é incluído nem linkado nas respostas do chat do Bing e não é usado para treinar os modelos fundacionais da Microsoft; conteúdo marcado com nocache pode aparecer apenas com URL, título e snippet; conteúdo sem nenhuma das duas tags pode ser usado por completo. As duas tags mantêm você nos resultados normais do Bing. Bloquear o Bingbot no robots.txt também tiraria você da busca do Bing, então use as meta tags.
Limitações e como fizemos a checagem
Em 18 de outubro de 2026, lemos a página de crawlers de cada operador listada acima, baixamos todas as listas de IPs publicadas e registramos o creationTime de cada arquivo. Não conseguimos renderizar a página de ajuda da Microsoft sobre crawlers, que funciona só com JavaScript, então a linha do Bingbot se apoia no blog do Bing Webmaster, na ferramenta Verify Bingbot e no bingbot.json publicado pela Microsoft. As colunas de robots.txt resumem o que cada operador diz, não o que medimos de forma independente; as constatações da Cloudflare sobre o Perplexity são a principal evidência pública de que as duas coisas podem ser diferentes. Os operadores renomeiam e adicionam bots com frequência (o Google trocou o token do fetcher Google-NotebookLM por Google-GeminiNotebook, por exemplo), então trate qualquer lista, inclusive esta, como precisa na data da checagem.
Se você quer saber se a sua política de crawlers está de fato gerando citações, o AI Rank Lab acompanha suas menções e páginas citadas no ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews e AI Mode, ao lado do tráfego de referência de IA que essas respostas enviam para você.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


