



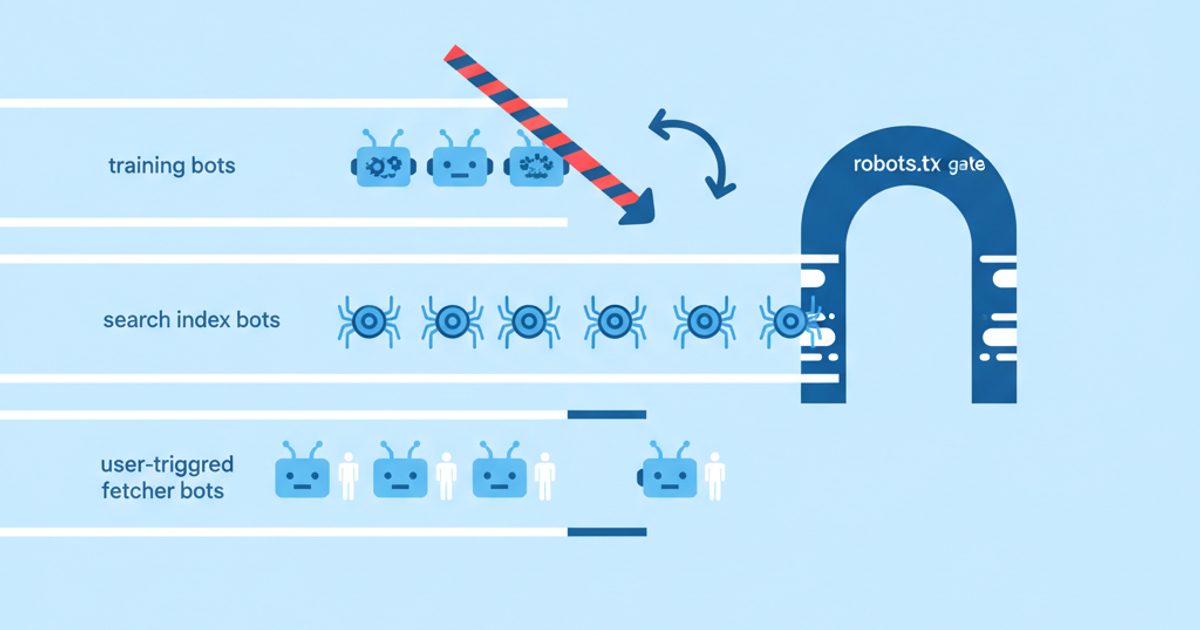
KI-Crawler sind automatisierte Bots von KI-Unternehmen, die Webseiten für genau einen von drei Zwecken abrufen: Sie sammeln Trainingsdaten für Modelle (GPTBot, ClaudeBot), sie bauen den Suchindex auf, aus dem KI-Antworten zitieren (OAI-SearchBot, Claude-SearchBot, PerplexityBot), oder sie holen eine Seite live ab, weil ein Nutzer einen Assistenten danach gefragt hat (ChatGPT-User, Claude-User, Perplexity-User). Sperrst du einen Trainings-Crawler, bleiben deine Inhalte aus künftigen Modellen draußen. Sperrst du einen Such-Crawler oder Nutzer-Fetcher, verschwindest du aus KI-Antworten und Quellenangaben. Genau dieser Unterschied ist die ganze Entscheidung.
Diese Seite ist eine Referenz, mit der du direkt arbeiten kannst. Jeden User-Agent unten haben wir am 18. Oktober 2026 mit der Dokumentation des jeweiligen Betreibers abgeglichen und die Seite verlinkt. Dazu bekommst du eine Entscheidungsmatrix nach Geschäftsziel, robots.txt-Gruppen zum Kopieren, die Verifizierungsmethode, die jeder Betreiber unterstützt (inklusive des Datums, das in jeder veröffentlichten IP-Liste steht), und einen ehrlichen Blick darauf, warum JavaScript-Analytics den Großteil des Crawler-Traffics gar nicht sehen kann.
Das Wichtigste in Kürze
- Ordne jeden KI-Bot einer Klasse zu: Training, Suche/Index oder nutzergesteuert. OpenAI, Anthropic, Amazon, Meta und Mistral veröffentlichen für jede Klasse ein eigenes Token, du kannst also eines sperren, ohne die anderen zu treffen.
- Wer GPTBot sperrt, fliegt nicht aus der ChatGPT-Suche. Laut OpenAI steuert das allein OAI-SearchBot, und Websites, die OAI-SearchBot ausgeschlossen haben, können trotzdem noch als Navigationslinks auftauchen.
- Google-Extended und Applebot-Extended sind Steuer-Tokens, keine Crawler. Sie tauchen nie in deinen Logs auf, und laut Google hat Google-Extended keinen Einfluss auf die Google-Suche – und damit auch nicht auf AI Overviews (Übersicht mit KI) und den AI Mode.
- Nutzergesteuerte Fetcher dürfen robots.txt bewusst ignorieren: OpenAI, Perplexity, Google, Meta und Amazon schreiben das alle in ihre Doku. Wenn du eine harte Sperre brauchst, nimm eine WAF.
- Die meisten KI-Crawler führen kein JavaScript aus, ein JS-Analytics-Tag zählt sie also viel zu niedrig. Für Crawler-Aktivität sind Server- oder CDN-Logs die maßgebliche Quelle.
- Verifiziere Bots per Reverse DNS (Google, Apple, Common Crawl) oder indem du die IP mit der veröffentlichten JSON-Liste des Betreibers abgleichst. Manche dieser Listen sind Jahre alt, lade sie deshalb regelmäßig neu herunter.
Was sind KI-Crawler und welche drei Klassen gibt es?
Ein KI-Crawler ist jeder automatisierte Client, mit dem ein KI-Unternehmen deine Seiten abruft. Die Betreiber trennen ihre Bots inzwischen nach Zweck, und dieser Zweck entscheidet, was dich eine Sperre kostet. Die Netzwerkdaten von Cloudflare zeigen, wie schief die Verteilung ist: In den zwölf Monaten bis Mitte 2025 dienten 80 % des KI-Crawlings dem Training, 18 % der Suche und 2 % Nutzeraktionen, wobei der Trainingsanteil in den letzten sechs Monaten dieses Zeitraums auf 82 % stieg.
Trainings-Crawler
Trainings-Crawler sammeln Inhalte, die zum Training oder Fine-Tuning von Foundation Models genutzt werden können. Hierher gehören GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training und CCBot (der offene Datensatz von Common Crawl, den viele Modellentwickler nutzen). Eine Sperre signalisiert, dass deine künftigen Inhalte nicht in Trainingsdaten landen sollen. Bereits gesammelte Inhalte entfernt sie nicht, und ob die KI-Suche dich zitieren kann, beeinflusst sie auch nicht.
Such- und Index-Crawler
Such-Crawler bauen den Retrieval-Index auf, auf dem KI-Antworten basieren und auf den die Quellenangaben zurückverlinken. OAI-SearchBot (ChatGPT-Suche), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index und DuckAssistBot sind KI-spezifisch. Googlebot, Bingbot und Applebot sind klassische Such-Crawler, deren Index inzwischen auch KI-Funktionen speist: Google AI Overviews und AI Mode, Microsoft Copilot und Siri-Antworten. Einen Such-Crawler zu sperren ist der teure Fehler, denn damit verschwindest du aus genau den Antworten, die deine Käufer lesen. Wie so ein Index konkret genutzt wird, erklärt unser Beitrag So funktioniert die ChatGPT-Suche.
Nutzergesteuerte Fetcher und Agents
Nutzergesteuerte Fetcher rufen eine einzelne URL ab, weil eine Person einen Assistenten gebeten hat, sie zu lesen, zusammenzufassen oder darauf zu handeln. Dazu zählen ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User und MistralAI-User, außerdem signierte Browser-Agents wie der Cloud-Browser von ChatGPT. Mehrere Betreiber erklären, dass robots.txt hier unter Umständen nicht greift, weil ein Mensch die Anfrage ausgelöst hat.
Steuer-Tokens, die keine Crawler sind
Zwei Namen, die auf jeder Liste stehen, rufen selbst nie etwas ab. Google-Extended ist ein Produkt-Token in robots.txt, das Google beim Crawlen mit seinen normalen User-Agents ausliest. Es legt fest, ob Inhalte für das Training künftiger Gemini-Modelle und für das Grounding in Gemini-Apps und Vertex AI genutzt werden dürfen. Applebot-Extended erledigt dasselbe für die Foundation Models von Apple. Keinen der beiden Strings wirst du in deinen Access-Logs finden. Deshalb ist „Ich habe Google-Extended gesperrt, sehe aber immer noch Google-Traffic“ völlig normales Verhalten.
Die Liste der KI-Crawler: alle wichtigen User-Agents, geprüft am 18. Oktober 2026
Die Tabelle zeigt das Token, das du in eine User-agent:-Zeile schreibst, wer es betreibt, seine Klasse, was die Doku des Betreibers selbst zu robots.txt sagt, wie du es verifizieren kannst, und die offizielle Seite, die wir geprüft haben. „Laut Doku“ heißt: Die robots.txt-Spalte gibt den Betreiber sinngemäß wieder. Wo die Doku schweigt, schreiben wir das, statt zu raten.
| Token | Betreiber | Klasse | Was er macht | Robots.txt (laut Doku) | Verifizierung über | Offizielle Doku |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Training | Crawlt Inhalte, die zum Training der Foundation Models von OpenAI genutzt werden können | Ja | gptbot.json | OpenAI-Crawler |
| OAI-SearchBot | OpenAI | Suche | Zeigt Websites in Antworten der ChatGPT-Suche; nicht fürs Training | Ja, Änderungen greifen nach etwa 24 Stunden | searchbot.json | OpenAI-Crawler |
| ChatGPT-User | OpenAI | Nutzergesteuert | Besucht Seiten für Nutzeraktionen in ChatGPT und Custom GPTs | Greift unter Umständen nicht | chatgpt-user.json | OpenAI-Crawler |
| OAI-AdsBot | OpenAI | Spezial | Prüft Landingpages, die als ChatGPT-Anzeigen eingereicht wurden; nicht fürs Training | Nicht angegeben; besucht nur eingereichte Anzeigenseiten | adsbot.json | OpenAI-Crawler |
| ClaudeBot | Anthropic | Training | Sammelt Inhalte, die in das Training von Claude-Modellen einfließen könnten | Ja; unterstützt Crawl-delay | bots.json (gemeinsam) | Anthropic-Hilfecenter |
| Claude-SearchBot | Anthropic | Suche | Indexiert Inhalte, um die Suchergebnisse von Claude zu verbessern | Ja | bots.json (gemeinsam) | Anthropic-Hilfecenter |
| Claude-User | Anthropic | Nutzergesteuert | Ruft Seiten ab, wenn ein Claude-Nutzer eine Frage stellt | Ja, eine Sperre stoppt den nutzergesteuerten Abruf | bots.json (gemeinsam) | Anthropic-Hilfecenter |
| PerplexityBot | Perplexity | Suche | Zeigt und verlinkt Websites in Perplexity-Ergebnissen; nicht fürs Training | Ja, bis zu 24 Stunden | perplexitybot.json | Perplexity-Crawler |
| Perplexity-User | Perplexity | Nutzergesteuert | Besucht Seiten, um die Frage eines Nutzers zu beantworten | Ignoriert sie in der Regel | perplexity-user.json | Perplexity-Crawler |
| Googlebot | Suche | Google-Suche, einschließlich AI Overviews und AI Mode | Ja, bei automatischen Crawls immer | Reverse DNS oder common-crawlers.json | Gängige Google-Crawler | |
| Google-Extended | Steuer-Token | Gemini-Training und Grounding in Gemini-Apps und Vertex AI | Nur Token; kein eigener User-Agent | Nicht zutreffend | Gängige Google-Crawler | |
| Google-CloudVertexBot | Suche (vom Websitebetreiber angefordert) | Crawlt Websites, auf deren Basis die Betreiber Vertex AI Agents bauen | Ja | Reverse DNS oder common-crawlers.json | Gängige Google-Crawler | |
| Google-Agent | Nutzergesteuerter Agent | Agents auf Google-Infrastruktur, die auf Nutzeranfrage browsen und handeln | Ignoriert sie in der Regel (nutzergesteuert) | user-triggered-agents.json; manche Anfragen mit Web Bot Auth signiert | Nutzergesteuerte Google-Fetcher | |
| Google-GeminiNotebook | Nutzergesteuert | Ruft URLs ab, die Nutzer in Gemini Notebook als Quellen hinzufügen (früherer Agent Google-NotebookLM, unterstützt bis August 2026) | Ignoriert sie in der Regel (nutzergesteuert) | JSON-Listen der nutzergesteuerten Fetcher | Nutzergesteuerte Google-Fetcher | |
| Bingbot | Microsoft | Suche | Bing-Index, der auch Copilot-Antworten mit Quellen versorgt | Ja; KI-Nutzung wird auf Seitenebene über noarchive/nocache gesteuert | bingbot.json oder das Bing-Tool „Verify Bingbot“ | Bing-Webmaster-Blog |
| Applebot | Apple | Suche (evtl. auch Training) | Suche in Spotlight, Siri und Safari; Daten können auch Apple-Modelle trainieren | Ja; folgt den Googlebot-Regeln, wenn Applebot nicht genannt wird; ignoriert Crawl-delay | Reverse DNS (*.applebot.apple.com) oder applebot.json | Über Applebot |
| Applebot-Extended | Apple | Steuer-Token | Schließt Inhalte vom Training der Apple Foundation Models aus | Nur Token | Nicht zutreffend | Über Applebot |
| Meta-ExternalAgent | Meta | Training | Training von KI-Foundation-Models oder direkte Indexierung von Inhalten | Ja | User-Agent plus die von Meta veröffentlichten IPs | Meta-Webcrawler |
| Meta-WebIndexer | Meta | Suche | Verbessert die Suchergebnisse von Meta AI, damit Meta AI dich zitieren und verlinken kann | Ja | User-Agent plus die von Meta veröffentlichten IPs | Meta-Webcrawler |
| Meta-ExternalFetcher | Meta | Nutzergesteuert | Ruft Links auf Nutzeranfrage ab, auch für agentische Aufgaben | Kann sie umgehen | User-Agent plus die von Meta veröffentlichten IPs | Meta-Webcrawler |
| Amazonbot | Amazon | Training | Verbessert Amazon-Produkte; kann zum Training von Amazon-KI-Modellen genutzt werden | Ja (RFC 9309); ignoriert Crawl-delay | Veröffentlichte IP-Seite | Amazonbot |
| Amzn-SearchBot | Amazon | Suche | Sucherlebnisse wie Alexa; nicht fürs Training | Ja; übernimmt die Regeln anderer Such-Bots, wenn er nicht genannt wird | Veröffentlichte IP-Seite | Amazonbot |
| Amzn-User | Amazon | Nutzergesteuert | Ruft Live-Informationen für Alexa-Anfragen ab; nicht fürs Training | Befolgt unter Umständen nicht alle Direktiven | Veröffentlichte IP-Seite | Amazonbot |
| MistralAI-Training | Mistral | Training | Baut Datensätze für das Training von Mistral-Modellen auf | Ja, kann per Disallow ausgeschlossen werden | User-Agent | Mistral-Crawler |
| MistralAI-Index | Mistral | Suche | Indexiert Inhalte für die Mistral-Suche in Vibe; nicht fürs Training | Ja | mistralai-index-ips.json | Mistral-Crawler |
| MistralAI-User | Mistral | Nutzergesteuert | Besucht Seiten, wenn Vibe-Nutzer eine Frage stellen | Ja, legt fest, welche Websites Nutzeranfragen erreichen dürfen | mistralai-user-ips.json | Mistral-Crawler |
| DuckAssistBot | DuckDuckGo | Suche (Echtzeit) | Crawlt Seiten für die KI-gestützten Antworten von DuckDuckGo; nicht fürs Training | Ja, greift nach 72 Stunden | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Training (offener Datensatz) | Baut den offenen Common-Crawl-Korpus auf, der breit fürs Modelltraining genutzt wird | Ja | Reverse DNS (*.crawl.commoncrawl.org, nur IPv4) | CCBot |
Zwei Dinge klärt die Tabelle. Erstens: Die aktuelle Seite von Anthropic nennt genau drei Bots – ClaudeBot, Claude-SearchBot und Claude-User. Ältere Listen führen noch „anthropic-ai“ und „Claude-Web“, die in der Anthropic-Dokumentation Stand Oktober 2026 nicht mehr vorkommen. Zweitens: Die Versionsnummern bei OpenAI ändern sich. Am Tag unserer Prüfung zeigten die Beispiel-Strings von OpenAI GPTBot/1.4 und OAI-SearchBot/1.4. Gleiche also immer das Token ab, nie den kompletten String.
Bots ohne offizielle Dokumentation
Für einige Bots, die dir in den Logs begegnen, haben wir am 18. Oktober 2026 keine Betreiberseite gefunden. Der bekannteste ist Bytespider von ByteDance, ein weiteres Beispiel sind die Grok-bezogenen Agents von xAI. Verzeichnisse von Drittanbietern widersprechen sich bei ihrem Verhalten, deshalb haben wir sie aus der verifizierten Tabelle herausgelassen. Die verwaltete robots.txt von Cloudflare enthält allerdings ein Disallow für Bytespider, und laut Cloudflare sank der Anteil von Bytespider am KI-Crawling zwischen Mitte 2024 und Mitte 2025 von 14,1 % auf 2,4 %. Wenn einer dieser Bots für dich relevant ist, setz deine Regeln per WAF durch, statt dich auf robots.txt zu verlassen.
Halten sich KI-Crawler an robots.txt?
Dokumentierte Trainings- und Such-Crawler sagen Ja, nutzergesteuerte Fetcher sagen oft Nein – und eine Zugriffskontrolle ist robots.txt ohnehin nie. Der Standard selbst, RFC 9309, stellt klar: „these rules are not a form of access authorization“ – die Regeln sind also keine Form der Zugriffsberechtigung. Außerdem dürfen Crawler deine Datei bis zu 24 Stunden cachen. Deshalb nennt jeder Betreiber eine Verzögerung, bis Änderungen greifen.
Was Betreiber versprechen, ist nicht dasselbe wie das, was man beobachtet. Im August 2025 veröffentlichte Cloudflare einen Test, bei dem brandneue Domains, die alles per Disallow ausschlossen, von Perplexity trotzdem detailliert beschrieben wurden. Cloudflare gab an, einen deklarierten Perplexity-User-Agent mit 20–25 Millionen Anfragen pro Tag und einen nicht deklarierten, Chrome-ähnlichen Agent mit 3–6 Millionen beobachtet zu haben, und strich Perplexity daraufhin von der Liste verifizierter Bots. Das ist der Befund eines Anbieters über einen Betreiber, aber er zeigt, warum ein User-Agent-String allein gar nichts beweist.
| Betreiber | Wie lange robots.txt-Änderungen dauern (laut Doku) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | Etwa 24 Stunden | Nicht angegeben |
| Perplexity | Bis zu 24 Stunden | Nicht angegeben |
| Amazon | Etwa 24 Stunden; nutzt eventuell eine bis zu 30 Tage alte Kopie aus dem Cache | Nicht unterstützt |
| Meta | Bis zu 24 Stunden | Nicht angegeben |
| DuckDuckGo (DuckAssistBot) | 72 Stunden | Nicht angegeben |
| Anthropic | Nicht angegeben | Unterstützt |
| Apple | Nicht angegeben | Nicht unterstützt |
Was kostet dich die Sperre der einzelnen Crawler-Klassen?
Trainings-Crawler zu sperren kostet dich heute kaum Sichtbarkeit. Such-Crawler oder Nutzer-Fetcher zu sperren kostet dich sofort Zitierungen. Die Tabelle stellt jeder Klasse die Kosten gegenüber, die die Betreiber selbst beschreiben.
| Wenn du sperrst … | … bleibst du draußen aus | … verlierst du | … bleibst du sichtbar in |
|---|---|---|---|
| Trainings-Crawler (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | künftigen Trainingsdatensätzen dieses Betreibers | kurzfristig kaum Sichtbarkeit; möglicherweise, wie gut künftige Modelle deine Marke ohne Suche „kennen“ | ChatGPT-Suche, Claude-Suche, Perplexity, Google-Suche und AI Overviews, solange deren Such-Bots erlaubt sind |
| KI-Such-Crawler (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | dem Retrieval-Index dieser Engine | Zitierungen und Links in den Antworten dieser Engine; OpenAI behält nur Navigationslinks | klassischen Suchmaschinen, sofern du die nicht auch sperrst |
| nutzergesteuerte Fetcher (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | Live-Abrufen auf Nutzeranfrage, sofern der Betreiber die Sperre respektiert | Antworten, wenn ein Nutzer deine URL einfügt oder danach fragt; Agent-Aufgaben wie Checkout oder Buchung | indexbasierten Antworten, sofern der Such-Bot erlaubt ist |
| Googlebot | der Google-Suche komplett | organische Rankings, AI Overviews und AI Mode auf einen Schlag | nichts bei Google; das willst du so gut wie nie |
Auch die Größenordnung des Tauschgeschäfts zählt. Cloudflare hat gemessen, wie viele Seiten jede KI-Plattform pro zurückvermitteltem Besucher crawlt: Im Juli 2025 lag Anthropic bei etwa 38.000 Crawls pro vermitteltem Besucher, Perplexity bei 194. Mit genau diesen Verhältnissen begründen Publisher, warum sie Trainings-Crawler sperren und Such-Crawler offen lassen.
Welche KI-Crawler solltest du zulassen oder sperren? Eine Entscheidungsmatrix nach Geschäftsziel
Fang bei dem an, was du verkaufst. Wenn dir eine Empfehlung durch einen KI-Assistenten einen Kunden bringen kann, lass alle Such-Crawler und Nutzer-Fetcher zu und behandle Training als eigene, kleinere Entscheidung.
| Deine Situation | Trainings-Crawler | Such-Crawler | Nutzer-Fetcher und Agents | Warum |
|---|---|---|---|---|
| B2B-SaaS, Agenturen, lokale Dienstleister | Zulassen (oder sperren, geringe Kosten) | Zulassen | Zulassen | Käufer erstellen ihre Anbieter-Shortlist in KI-Antworten; im Modellwissen präsent zu sein hilft auch bei ungefragten Erwähnungen |
| E-Commerce | Deine Entscheidung | Zulassen | Zulassen und signierte Agents in der WAF auf die Allowlist setzen | Shopping-Antworten zitieren Produktseiten, und Agents müssen Warenkorb und Checkout erreichen |
| News- und werbefinanzierte Publisher | Sperren | Zulassen oder auf Seiten mit Werbung sperren | Je nach Betreiber entscheiden | Der Content ist das Produkt; Zitierungen schicken trotzdem einige Leser zurück |
| Entwicklerdokus und Open-Source-Projekte | Zulassen | Zulassen | Zulassen | Entwickler fragen Assistenten, wie sie deine API nutzen; korrektes Modellwissen entlastet den Support |
| Inhalte hinter Paywall oder unter Lizenz | Sperren | Nur Übersichtsseiten zulassen | Per WAF sperren, wenn die Lizenz es verlangt | Teaser zitierfähig halten, den Volltext draußen |
| Staging, Intranets, private Apps | Sperren | Sperren | Sperren | Setz auf Authentifizierung; robots.txt ist eine Bitte, kein Schloss |
| Server unter Crawl-Last | Drosseln oder sperren | Zulassen, im CDN drosseln | Zulassen | Last lieber am Edge lösen, statt Zitierungen zu verlieren |
Wie sperrst du in robots.txt KI-Training, lässt KI-Suche aber zu?
Gib jedem Trainings-Token eine eigene Gruppe mit Disallow: / und überlass die Such-Crawler deinen normalen Regeln. Ein Crawler befolgt nur die spezifischste Gruppe, die ihn nennt – eine Trainingssperre schwappt also nie auf Such-Bots über.
Snippet 1: Training sperren, KI-Suche und Nutzer-Fetcher behalten
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 erlaubt, dass sich mehrere User-agent-Zeilen eine Gruppe teilen, und beim Abgleich spielt Groß- und Kleinschreibung keine Rolle. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot und Bingbot fallen in die *-Gruppe und bleiben erlaubt.
Snippet 2: KI-Suche ausdrücklich zulassen
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Wenn du Such-Bots ausdrücklich nennst, schützt dich das vor einer künftigen Pauschalregel, die jemand anderes schreibt – etwa ein Plugin, das User-agent: * mit Disallow: / einfügt. Lass private Pfade innerhalb der Gruppe gesperrt, denn eine benannte Gruppe ersetzt für diesen Bot die *-Gruppe, statt sie zu ergänzen.
Snippet 3: drei Stolperfallen, die echte Dateien kaputt machen
- Applebot übernimmt die Googlebot-Regeln. Laut Apple folgt Applebot der Googlebot-Gruppe, wenn deine Datei Applebot nicht erwähnt, Googlebot aber schon. Eine Googlebot-spezifische Sperre kann dich so stillschweigend aus Siri und Spotlight werfen.
- Amzn-SearchBot übernimmt die Regeln anderer Such-Bots, wenn er nicht genannt wird, so Amazon. Nenn ihn, wenn du ein anderes Ergebnis willst.
- Subdomains brauchen eine eigene Datei. Anthropic und Amazon lesen robots.txt nach eigener Aussage pro Host,
docs.example.combraucht also eine eigene Kopie.
Diese Gruppen kannst du mit dem kostenlosen robots.txt-Generator von AI Rank Lab erstellen und prüfen. Unsere früheren robots.txt-Vorlagen für KI-Crawler gehen tiefer auf Setups mit vollem und selektivem Zugriff ein.
Wie prüfst du, ob ein KI-Crawler echt und nicht gefälscht ist?
Verlass dich nie allein auf den User-Agent: Jeder kann „GPTBot“ in einen Header schreiben, und Common Crawl warnt auf seiner eigenen Seite, dass sich Crawler fälschlich als CCBot ausgeben. Die Betreiber unterstützen drei Verifizierungsmethoden; welche du nutzt, hängt vom Betreiber ab.
- Reverse DNS, dann Forward DNS. Führe
hostmit der IP aus deinem Log aus, prüfe, ob der Hostname auf die Domain des Betreibers endet, führe dannhostmit diesem Hostnamen aus und bestätige, dass dieselbe IP zurückkommt. Google dokumentiert das fürgooglebot.com,google.comundgoogleusercontent.comin seiner Anleitung zur Verifizierung; Apple nutzt*.applebot.apple.com, Common Crawl*.crawl.commoncrawl.org(nur IPv4). - Die IP mit der veröffentlichten Liste des Betreibers abgleichen. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral und Amazon veröffentlichen IP-Bereiche. Bei OpenAI, Anthropic und Perplexity ist das die einzige Methode, denn sie dokumentieren kein Reverse-DNS-Muster.
- Eine kryptografische Signatur prüfen (Web Bot Auth). Der Cloud-Browser von ChatGPT signiert seine Anfragen nach RFC 9421 mit einem
Signature-Agent-Header mit dem Wert"https://chatgpt.com". Google testet denselben IETF-Entwurf für einige Google-Agent-Anfragen, signiert alshttps://agent.bot.goog, und rät auf seiner Web-Bot-Auth-Seite, IP-Prüfungen als Fallback beizubehalten, weil nicht jede Anfrage signiert ist.
# Reverse- und danach Forward-Lookup (Beispiel Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# IP-Listen-Check für den Such-Crawler von OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
Wie aktuell sind die veröffentlichten IP-Listen?
Wir haben am 18. Oktober 2026 jede veröffentlichte IP-Datei für KI-Crawler heruntergeladen und das Feld creationTime ausgelesen, das jeder Betreiber hineinschreibt. Ein altes Datum kann schlicht bedeuten, dass sich die Bereiche nicht geändert haben. Es sagt dir aber, wie sehr du einer fest eingetragenen Allowlist trauen kannst, und zeigt, welche Listen Traffic, den der Betreiber nie deklariert hat, gar nicht abbilden können.
| Veröffentlichte Liste | creationTime in der Datei | IPv4-/IPv6-Präfixe |
|---|---|---|
| Gängige Google-Crawler (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Nutzergesteuerte Google-Agents (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (alle drei Bots, eine Liste) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Zwei Lehren für die Praxis. Die Listen von Google und die ChatGPT-User-Liste von OpenAI haben sich in den letzten zwei Wochen geändert. Eine Firewall-Allowlist, die du im Sommer kopiert hast, ist also wahrscheinlich schon veraltet – lade diese Dateien lieber täglich oder wöchentlich neu. Und Anthropic sagt, dass das Sperren seiner IPs „may not work correctly or persistently guarantee an opt-out“, also unter Umständen nicht zuverlässig oder dauerhaft für ein Opt-out sorgt, weil Anthropic dann deine robots.txt nicht mehr lesen kann. Nutze für das Opt-out also robots.txt und IPs nur zur Verifizierung.
Wie siehst du KI-Crawler-Aktivität: Server-Logs oder JavaScript-Tags?
Nimm Server- oder CDN-Logs für Crawler und JavaScript-Analytics für menschliche Besucher, die von KI-Assistenten kommen. Ein JS-Tag läuft nur, wenn etwas das JavaScript der Seite ausführt – und die meisten KI-Crawler tun das nicht. Die Analyse von Vercel über das eigene Netzwerk ergab, dass keiner der großen KI-Crawler JavaScript rendert. Die Crawler von ChatGPT und Claude luden zwar JS-Dateien (11,50 % bzw. 23,84 % ihrer Anfragen), führten sie aber nicht aus. Ausnahmen waren Gemini, das das Rendering von Googlebot nutzt, und Applebot. Die Studie stammt von Dezember 2024, teste also auf deiner eigenen Website nach – sie deckt sich aber mit dem, was wir sehen.
Google Analytics vergrößert die Lücke sogar absichtlich. GA4 schließt Traffic von bekannten Bots und Spidern automatisch aus, und du kannst das weder abschalten noch sehen, wie viel entfernt wurde. Für KI-Referral-Traffic ist GA4 das richtige Werkzeug – dazu mehr in So trackst du KI-Referral-Traffic in GA4 –, für Crawler-Zahlen das falsche.
Dasselbe Muster sehen wir in den eigenen Tracking-Daten von AI Rank Lab. Unser JavaScript-Tag erfasst zuverlässig Menschen, die von ChatGPT, Gemini, Perplexity und Claude durchklicken, sieht aber nur einen kleinen, nicht repräsentativen Ausschnitt des Crawler-Traffics. Deshalb veröffentlichen wir daraus keine Crawler-Zahlen.
Ein Log-Check in fünf Minuten
- Lade einen Tag Roh-Access-Logs von deinem Hoster oder CDN herunter (Nginx und Apache protokollieren den User-Agent standardmäßig im Combined-Format).
- Zähle die Anfragen pro KI-Token:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Prüfe für die häufigsten Tokens die Statuscodes. Eine Wand aus 403ern oder 429ern heißt meist, dass eine WAF- oder CDN-Regel einen Bot blockiert, den deine robots.txt erlaubt.
- Verifiziere eine Stichprobe von IPs mit den Methoden oben, bevor du irgendeiner Zahl traust.
- Schau, welche URLs die Such-Bots abrufen. Holen OAI-SearchBot oder Claude-SearchBot nur deine Startseite, solltest du dir die interne Verlinkung und deine Sitemap ansehen.
Tools, die KI-Crawler-Aktivität zeigen
Transparenzhinweis: AI Rank Lab ist unser Produkt. Wir nennen es zuerst, weil das hier unsere Website ist, und haben für jedes Tool unten dieselben Kriterien angelegt.
- AI Rank Lab – das KI-Bot-Tracking erfasst pro Seite Referrals von KI-Assistenten und die KI-Bot-Besuche, die sein Tag sehen kann, direkt neben deinem Tracking von KI-Sichtbarkeit und Zitierungen. Für vollständige Crawler-Zahlen kombinierst du es aus den oben genannten Gründen mit Logs.
- Cloudflare AI Crawl Control – wenn deine Website über Cloudflare läuft, ist das die vollständigste verfügbare Crawler-Ansicht, weil sie jede Anfrage am Edge sieht, auch von Bots, die nie JavaScript ausführen. Außerdem zeigt sie die robots.txt-Einhaltung pro Crawler.
- Logfile-Analyzer wie der Log File Analyser von Screaming Frog oder GoAccess – arbeiten mit Roh-Logs von jedem Hoster und eignen sich gut für einmalige Audits.
- Roh-Logs plus der grep-Befehl oben – kostenlos, exakt und die Messlatte, an der sich jedes andere Tool messen lassen muss.
Eine ausführlichere Monitoring-Routine rund um die drei größten Bots findest du in unserem Leitfaden zum Monitoring von GPTBot, ClaudeBot und PerplexityBot.
Wie steuern Cloudflare und andere CDNs KI-Bots?
CDNs setzen am Netzwerkrand durch, worum robots.txt nur bitten kann. AI Crawl Control von Cloudflare, verfügbar in allen Tarifen, zeigt, welche KI-Dienste deine Website aufrufen, lässt dich jeden Crawler einzeln zulassen oder sperren, erfasst robots.txt-Verstöße und bietet in einer privaten Beta „Pay per Crawl“ an.
Die KI-Bot-Richtlinien von Cloudflare nutzen inzwischen dieselbe Dreiteilung wie dieser Artikel. Die Einstellungen „Block AI Bots“ bieten getrennte Voreinstellungen für Search, Agent und Training, jeweils mit „auf allen Seiten sperren“, „auf Seiten mit Werbung sperren“ oder „zulassen“. Laut Doku bekommen neue Domains ab dem 15. September 2026 geänderte Standardwerte: Training- und Agent-Bots werden auf Seiten mit Werbung gesperrt, Search bleibt erlaubt, und Crawler mit Mischzweck, die Suche und Training kombinieren, werden von jeder Trainingssperre erfasst. Hast du eine Website nach diesem Datum zu Cloudflare umgezogen und wunderst dich, warum ChatGPT-User oder Claude-User auf deinem Blog 403er bekommen, prüf zuerst diese Einstellung.
Cloudflare kann robots.txt auch für dich verwalten. Ist Bot Preference Sync aktiv, stellt die verwaltete robots.txt deinen bestehenden Regeln Disallow-Gruppen für Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot und meta-externalagent voran, dazu eine Content-Signals-Zeile (search=yes, ai-train=no). Content Signals sind ein von Cloudflare vorgeschlagenes Vokabular (search, ai-input, ai-train), das festhält, wie Inhalte nach dem Abruf genutzt werden dürfen. Ob ein Betreiber sich daran hält, liegt bei ihm.
Andere Anbieter unterstützen dasselbe Muster. Die Doku von Perplexity enthält WAF-Anleitungen für Cloudflare und AWS WAF auf Basis seiner IP-Listen, und das Hilfecenter von OpenAI zeigt, wie du den signierten Cloud-Browser in Akamai (Bot-Name „ChatGPT Agent“) und Cloudflare (Detection-ID 129220581) auf die Allowlist setzt. Egal welches CDN du nutzt, die Reihenfolge bleibt gleich: pro Klasse entscheiden, in robots.txt festhalten, nur dort am Edge durchsetzen, wo du eine harte Sperre brauchst, und nach jeder CDN-Änderung die Logs erneut prüfen.
Google und Bing: die zwei Sonderfälle
Wirkt sich eine Sperre von Google-Extended auf die Google-Suche oder AI Overviews aus?
Nein. Google erklärt, dass Google-Extended „does not impact a site's inclusion in Google Search nor is it used as a ranking signal“ – also weder die Aufnahme einer Website in die Google-Suche beeinflusst noch als Rankingsignal dient. Die Dokumentation zu KI-Funktionen stellt klar, dass die robots.txt-Regeln für Googlebot die Suche steuern, einschließlich AI Overviews und AI Mode, und dass du über nosnippet, data-nosnippet, max-snippet oder noindex einschränkst, was angezeigt wird. Google-Extended betrifft das Training von Gemini-Modellen und das Grounding in Gemini-Apps und Vertex AI, die von der Suche getrennt sind.
Wie steuerst du, ob Microsoft Copilot deine Inhalte nutzt?
Microsoft hat kein eigenes Token für einen KI-Crawler. Das Crawlen übernimmt Bingbot, und die KI-Nutzung steuerst du über Robots-Meta-Tags auf Seitenebene. Die jüngste offizielle Anleitung, die wir gefunden haben, ist die Ankündigung des Bing-Teams von 2023, geschrieben, als Copilot noch Bing Chat hieß: Inhalte mit noarchive werden in den Chat-Antworten von Bing weder aufgenommen noch verlinkt und nicht zum Training der Foundation Models von Microsoft genutzt. Inhalte mit nocache dürfen nur mit URL, Titel und Snippet erscheinen. Inhalte ohne eines der beiden Tags dürfen vollständig genutzt werden. Mit beiden Tags bleibst du in den normalen Bing-Ergebnissen. Würdest du Bingbot in robots.txt sperren, flögst du auch aus der Bing-Suche – nimm also lieber die Meta-Tags.
Einschränkungen und wie wir geprüft haben
Am 18. Oktober 2026 haben wir die oben verlinkte Crawler-Seite jedes Betreibers gelesen, jede veröffentlichte IP-Liste heruntergeladen und den Wert creationTime in jeder Datei notiert. Microsofts Hilfeseite zu Crawlern, die nur per JavaScript lädt, konnten wir nicht rendern. Die Bingbot-Zeile stützt sich daher auf den Bing-Webmaster-Blog von Microsoft, das Tool „Verify Bingbot“ und die veröffentlichte bingbot.json. Die robots.txt-Spalten geben wieder, was die Betreiber sagen, nicht was wir unabhängig gemessen haben; die Perplexity-Befunde von Cloudflare sind der wichtigste öffentliche Beleg dafür, dass beides auseinanderliegen kann. Betreiber benennen Bots oft um oder fügen neue hinzu (Google hat zum Beispiel das Fetcher-Token Google-NotebookLM durch Google-GeminiNotebook ersetzt). Betrachte deshalb jede Liste, auch diese, als korrekt zum Prüfdatum.
Du willst sehen, ob deine Crawler-Strategie tatsächlich Zitierungen bringt? AI Rank Lab trackt deine Erwähnungen und zitierten Seiten in ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews und AI Mode – direkt neben dem KI-Referral-Traffic, den dir diese Antworten bringen.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


