



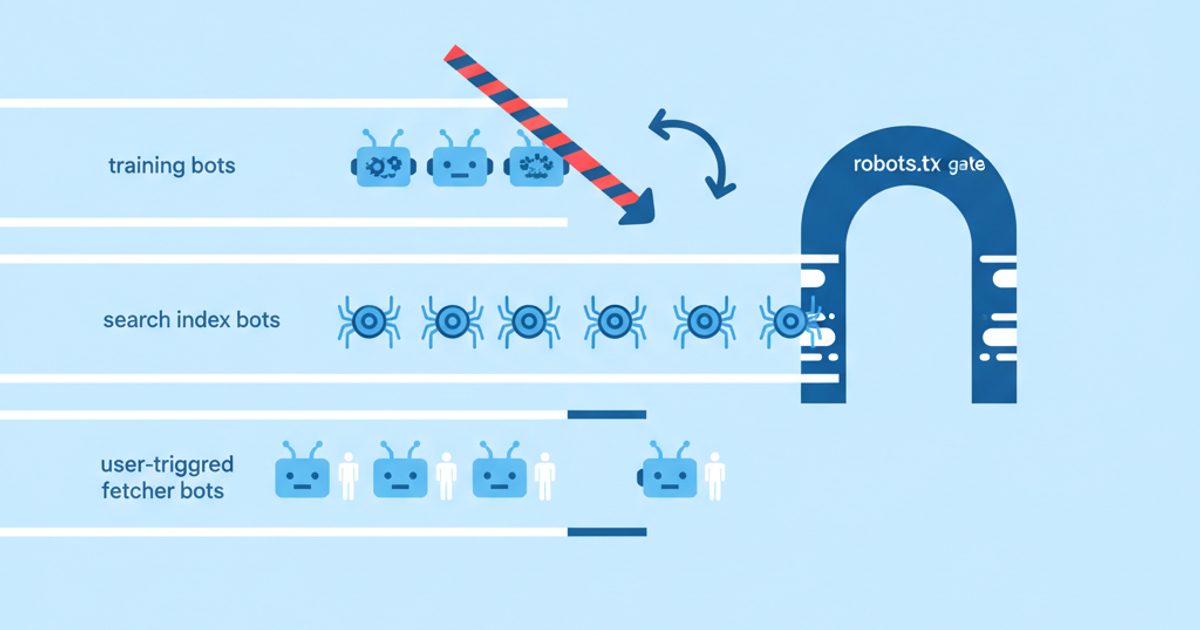
Los crawlers de IA (o rastreadores de IA) son bots automatizados de las empresas de inteligencia artificial que descargan páginas web para una de estas tres tareas: reunir datos de entrenamiento para sus modelos (GPTBot, ClaudeBot), construir el índice de búsqueda que citan las respuestas de la IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot) o leer una página en directo porque un usuario le preguntó por ella a un asistente (ChatGPT-User, Claude-User, Perplexity-User). Si bloqueas un crawler de entrenamiento, tu contenido queda fuera de los modelos futuros; si bloqueas un crawler de búsqueda o un fetcher de usuario, desapareces de las respuestas y las citas de la IA. Toda la decisión se reduce a esa diferencia.
Esta página es una referencia pensada para pasar a la acción. Cada user agent de la lista se comprobó el 18 de octubre de 2026 con la documentación oficial de su operador, y enlazamos esa página. También encontrarás una matriz de decisión según tu objetivo de negocio, grupos de robots.txt listos para copiar, el método de verificación que admite cada operador (con la fecha que figura dentro de cada lista de IP publicada) y una explicación honesta de por qué la analítica basada en JavaScript no puede mostrarte la mayor parte del tráfico de crawlers.
Lo esencial
- Clasifica cada bot de IA como de entrenamiento, de búsqueda/indexación o activado por el usuario. OpenAI, Anthropic, Amazon, Meta y Mistral publican un token distinto para cada tipo, así que puedes bloquear uno sin tocar los demás.
- Bloquear GPTBot no te saca de la búsqueda de ChatGPT. OpenAI afirma que eso lo controla únicamente OAI-SearchBot, y los sitios que excluyen a OAI-SearchBot pueden seguir apareciendo como enlaces de navegación.
- Google-Extended y Applebot-Extended son tokens de control, no crawlers. Nunca aparecen en tus logs, y Google asegura que Google-Extended no tiene ningún efecto en la Búsqueda de Google, que incluye AI Overviews y AI Mode.
- Los fetchers activados por el usuario pueden saltarse robots.txt por diseño: OpenAI, Perplexity, Google, Meta y Amazon lo dicen en su documentación. Si necesitas un bloqueo real, usa un WAF.
- La mayoría de los crawlers de IA no ejecutan JavaScript, así que una etiqueta de analítica en JS se queda corta al contarlos. La fuente fiable de la actividad de crawlers son los logs del servidor o de la CDN.
- Verifica los bots con DNS inverso (Google, Apple, Common Crawl) o comprobando la IP contra la lista JSON que publica el operador. Algunas de esas listas tienen años, así que vuelve a descargarlas de forma periódica.
¿Qué son los crawlers de IA y cuáles son sus tres tipos?
Un crawler de IA es cualquier cliente automatizado que una empresa de IA usa para pedir tus páginas. Hoy los operadores separan sus bots por finalidad, y la finalidad es lo que determina cuánto te cuesta bloquearlos. Los datos de red de Cloudflare muestran lo desequilibrado del reparto: en los 12 meses hasta mediados de 2025, el 80 % del rastreo de IA fue para entrenamiento, el 18 % para búsqueda y el 2 % para acciones de usuarios, y el entrenamiento subió al 82 % en los seis meses más recientes de ese periodo.
Crawlers de entrenamiento
Los crawlers de entrenamiento recopilan contenido que puede usarse para entrenar o ajustar modelos fundacionales. Aquí entran GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training y CCBot (el dataset abierto de Common Crawl, que usan muchos desarrolladores de modelos). Bloquearlos es una señal de que tu contenido futuro debe quedar fuera de los conjuntos de entrenamiento. No elimina lo que ya se recopiló ni afecta a que la búsqueda con IA pueda citarte.
Crawlers de búsqueda e indexación
Los crawlers de búsqueda construyen el índice de recuperación en el que se apoyan las respuestas de la IA y al que enlazan las citas. OAI-SearchBot (búsqueda de ChatGPT), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index y DuckAssistBot son específicos de IA. Googlebot, Bingbot y Applebot son crawlers de búsqueda clásicos cuyo índice ahora también alimenta funciones de IA: AI Overviews (los resúmenes con IA de Google) y AI Mode (el Modo IA de Google), Microsoft Copilot y las respuestas de Siri. Bloquear un crawler de búsqueda es el error caro, porque te borra de las respuestas que leen tus compradores. Si quieres entender cómo se usa uno de estos índices por dentro, mira cómo funciona la búsqueda de ChatGPT.
Fetchers y agentes activados por el usuario
Los fetchers activados por el usuario visitan una única URL porque una persona le pidió a un asistente que la leyera, la resumiera o hiciera algo con ella. Aquí están ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User y MistralAI-User, además de agentes de navegador firmados como el Cloud browser de ChatGPT. Varios operadores indican que robots.txt puede no aplicarse a ellos, porque la petición la inició un humano.
Tokens de control que no son crawlers
Hay dos nombres que salen en todas las listas y que nunca descargan nada por sí mismos. Google-Extended es un token de producto de robots.txt que Google lee mientras rastrea con sus user agents normales; controla si el contenido puede usarse para entrenar futuros modelos de Gemini y para el grounding (anclaje de respuestas en fuentes) en las apps de Gemini y en Vertex AI. Applebot-Extended hace lo mismo con los modelos fundacionales de Apple. No vas a encontrar ninguna de las dos cadenas en tus logs de acceso, y por eso es normal eso de "bloqueé Google-Extended pero sigo viendo tráfico de Google".
La lista de crawlers de IA: todos los user agents importantes, verificados el 18 de octubre de 2026
La tabla recoge el token que pones en una línea User-agent:, quién lo opera, su tipo, qué dice la documentación del propio operador sobre robots.txt, cómo puedes verificarlo y la página oficial que consultamos. "Según su doc." significa que la columna de robots.txt resume lo que dice el operador; cuando la documentación no dice nada, lo indicamos en lugar de suponer.
| Token | Operador | Tipo | Qué hace | Robots.txt (según su doc.) | Cómo verificarlo | Doc. oficial |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Entrenamiento | Rastrea contenido que puede usarse para entrenar los modelos fundacionales de OpenAI | Sí | gptbot.json | Crawlers de OpenAI |
| OAI-SearchBot | OpenAI | Búsqueda | Muestra sitios en las respuestas de la búsqueda de ChatGPT; no se usa para entrenar | Sí, los cambios tardan unas 24 horas | searchbot.json | Crawlers de OpenAI |
| ChatGPT-User | OpenAI | Activado por el usuario | Visita páginas por acciones de usuarios en ChatGPT y en los Custom GPTs | Puede no aplicarse | chatgpt-user.json | Crawlers de OpenAI |
| OAI-AdsBot | OpenAI | Especial | Revisa las landing pages enviadas como anuncios de ChatGPT; no se usa para entrenar | No se indica; solo visita páginas de anuncios enviadas | adsbot.json | Crawlers de OpenAI |
| ClaudeBot | Anthropic | Entrenamiento | Recopila contenido que podría contribuir al entrenamiento de los modelos Claude | Sí; admite Crawl-delay | bots.json (compartido) | Centro de ayuda de Anthropic |
| Claude-SearchBot | Anthropic | Búsqueda | Indexa contenido para mejorar los resultados de búsqueda de Claude | Sí | bots.json (compartido) | Centro de ayuda de Anthropic |
| Claude-User | Anthropic | Activado por el usuario | Descarga páginas cuando un usuario de Claude hace una pregunta | Sí; desactivarlo detiene la recuperación dirigida por el usuario | bots.json (compartido) | Centro de ayuda de Anthropic |
| PerplexityBot | Perplexity | Búsqueda | Muestra y enlaza sitios en los resultados de Perplexity; no se usa para entrenar | Sí, en hasta 24 horas | perplexitybot.json | Crawlers de Perplexity |
| Perplexity-User | Perplexity | Activado por el usuario | Visita páginas para responder la pregunta de un usuario | Por lo general lo ignora | perplexity-user.json | Crawlers de Perplexity |
| Googlebot | Búsqueda | Búsqueda de Google, incluidos AI Overviews y AI Mode | Sí, siempre en los rastreos automáticos | DNS inverso o common-crawlers.json | Rastreadores comunes de Google | |
| Google-Extended | Token de control | Entrenamiento de Gemini y grounding en las apps de Gemini y en Vertex AI | Solo token; sin user agent propio | No aplica | Rastreadores comunes de Google | |
| Google-CloudVertexBot | Búsqueda (a petición del propietario del sitio) | Rastrea sitios sobre los que sus propietarios crean agentes de Vertex AI | Sí | DNS inverso o common-crawlers.json | Rastreadores comunes de Google | |
| Google-Agent | Agente activado por el usuario | Agentes en la infraestructura de Google que navegan y actúan a petición del usuario | Por lo general lo ignora (activado por el usuario) | user-triggered-agents.json; algunas peticiones van firmadas con Web Bot Auth | Fetchers de Google activados por el usuario | |
| Google-GeminiNotebook | Activado por el usuario | Descarga las URL que los usuarios añaden como fuentes en Gemini Notebook (antes era el agente Google-NotebookLM, admitido hasta agosto de 2026) | Por lo general lo ignora (activado por el usuario) | Listas JSON de fetchers activados por el usuario | Fetchers de Google activados por el usuario | |
| Bingbot | Microsoft | Búsqueda | Índice de Bing, que también sirve de base a las respuestas de Copilot | Sí; el uso para IA se controla con noarchive/nocache a nivel de página | bingbot.json o la herramienta Verify Bingbot de Bing | Blog de Bing Webmaster |
| Applebot | Apple | Búsqueda (también puede entrenar) | Búsqueda de Spotlight, Siri y Safari; los datos también pueden entrenar modelos de Apple | Sí; sigue las reglas de Googlebot si Applebot no aparece; ignora Crawl-delay | DNS inverso (*.applebot.apple.com) o applebot.json | Acerca de Applebot |
| Applebot-Extended | Apple | Token de control | Excluye el contenido del entrenamiento de los modelos fundacionales de Apple | Solo token | No aplica | Acerca de Applebot |
| Meta-ExternalAgent | Meta | Entrenamiento | Entrenar modelos fundacionales de IA o indexar contenido directamente | Sí | User agent más las IP publicadas por Meta | Crawlers web de Meta |
| Meta-WebIndexer | Meta | Búsqueda | Mejora los resultados de búsqueda de Meta AI para que Meta AI pueda citarte y enlazarte | Sí | User agent más las IP publicadas por Meta | Crawlers web de Meta |
| Meta-ExternalFetcher | Meta | Activado por el usuario | Descarga enlaces a petición de un usuario, también para tareas agénticas | Puede saltárselo | User agent más las IP publicadas por Meta | Crawlers web de Meta |
| Amazonbot | Amazon | Entrenamiento | Mejora los productos de Amazon; puede usarse para entrenar modelos de IA de Amazon | Sí (RFC 9309); ignora Crawl-delay | Página de IP publicadas | Amazonbot |
| Amzn-SearchBot | Amazon | Búsqueda | Experiencias de búsqueda como Alexa; no se usa para entrenar | Sí; si no se le nombra, hereda las reglas dadas a otros bots de búsqueda | Página de IP publicadas | Amazonbot |
| Amzn-User | Amazon | Activado por el usuario | Obtiene información en directo para consultas de Alexa; no se usa para entrenar | Puede no seguir todas las directivas | Página de IP publicadas | Amazonbot |
| MistralAI-Training | Mistral | Entrenamiento | Crea datasets para entrenar los modelos de Mistral | Sí, se puede bloquear con Disallow | User agent | Crawlers de Mistral |
| MistralAI-Index | Mistral | Búsqueda | Indexa contenido para la búsqueda de Mistral en Vibe; no se usa para entrenar | Sí | mistralai-index-ips.json | Crawlers de Mistral |
| MistralAI-User | Mistral | Activado por el usuario | Visita páginas cuando los usuarios de Vibe hacen una pregunta | Sí, define a qué sitios pueden llegar las peticiones de los usuarios | mistralai-user-ips.json | Crawlers de Mistral |
| DuckAssistBot | DuckDuckGo | Búsqueda (en tiempo real) | Rastrea páginas para las respuestas asistidas por IA de DuckDuckGo; no se usa para entrenar | Sí, surte efecto a las 72 horas | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Entrenamiento (dataset abierto) | Construye el corpus abierto de Common Crawl, muy usado para entrenar modelos | Sí | DNS inverso (*.crawl.commoncrawl.org, solo IPv4) | CCBot |
La tabla deja dos cosas claras. Primero, la página actual de Anthropic recoge exactamente tres bots: ClaudeBot, Claude-SearchBot y Claude-User. Hay listas antiguas que todavía incluyen "anthropic-ai" y "Claude-Web", que no aparecen en la documentación de Anthropic a octubre de 2026. Segundo, los números de versión de OpenAI cambian: el día que lo comprobamos, las cadenas de ejemplo de OpenAI mostraban GPTBot/1.4 y OAI-SearchBot/1.4, así que filtra siempre por el token, nunca por la cadena completa.
Bots sin documentación oficial
Algunos bots que verás en los logs no tienen una página del operador que pudiéramos encontrar el 18 de octubre de 2026. El más conocido es Bytespider, de ByteDance; los agentes de xAI relacionados con Grok son otro caso. Los directorios de terceros no se ponen de acuerdo sobre cómo se comportan, así que los dejamos fuera de la tabla verificada. El robots.txt gestionado de Cloudflare sí incluye un disallow para Bytespider, y Cloudflare informó de que la cuota de Bytespider en el rastreo de IA cayó del 14,1 % al 2,4 % entre mediados de 2024 y mediados de 2025. Si alguno de estos bots te importa, aplica tu política con una regla de WAF en lugar de fiarte de robots.txt.
¿Respetan los crawlers de IA el robots.txt?
Los crawlers de entrenamiento y de búsqueda documentados dicen que sí; los fetchers activados por el usuario a menudo dicen que no; y robots.txt nunca es un control de acceso. El propio estándar, RFC 9309, afirma que "estas reglas no son una forma de autorización de acceso". También permite a los crawlers guardar tu archivo en caché hasta 24 horas, y por eso todos los operadores hablan de un plazo antes de que se apliquen los cambios.
Decir que se cumple no es lo mismo que cumplir. En agosto de 2025, Cloudflare publicó una prueba en la que dominios recién creados, que bloqueaban todo, seguían siendo descritos con detalle por Perplexity. Cloudflare afirmó haber observado un agente declarado Perplexity-User que hacía 20-25 millones de peticiones diarias y un agente no declarado, con apariencia de Chrome, que hacía 3-6 millones, y después retiró a Perplexity de su lista de bots verificados. Es el hallazgo de un proveedor sobre un operador, pero demuestra que una cadena de user agent, por sí sola, no prueba nada.
| Operador | Cuánto tardan los cambios en robots.txt (según su doc.) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | Unas 24 horas | No se indica |
| Perplexity | Hasta 24 horas | No se indica |
| Amazon | Unas 24 horas; puede usar una copia en caché de hasta 30 días | No admitido |
| Meta | Hasta 24 horas | No se indica |
| DuckDuckGo (DuckAssistBot) | 72 horas | No se indica |
| Anthropic | No se indica | Admitido |
| Apple | No se indica | No admitido |
¿Qué pierdes al bloquear cada tipo de crawler de IA?
Bloquear los crawlers de entrenamiento te cuesta poca visibilidad hoy; bloquear los crawlers de búsqueda o los fetchers de usuario te cuesta citas de inmediato. La tabla empareja cada tipo con el coste que describen los propios operadores.
| Si bloqueas... | Te quedas fuera de | Pierdes | Sigues apareciendo en |
|---|---|---|---|
| Crawlers de entrenamiento (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | Los futuros datasets de entrenamiento de ese operador | Poca visibilidad a corto plazo; quizá lo bien que los modelos futuros "conozcan" tu marca sin buscar | La búsqueda de ChatGPT, la búsqueda de Claude, Perplexity, la Búsqueda de Google y AI Overviews, siempre que sus bots de búsqueda estén permitidos |
| Crawlers de búsqueda con IA (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | El índice de recuperación de ese motor | Citas y enlaces en las respuestas de ese motor; OpenAI solo mantiene los enlaces de navegación | Los buscadores clásicos, salvo que también los bloquees |
| Fetchers activados por el usuario (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | Las lecturas en directo que piden los usuarios, cuando el operador respeta el bloqueo | Respuestas cuando un usuario pega tu URL o pregunta por ella; tareas de agentes como pagar o reservar | Respuestas basadas en el índice, si el bot de búsqueda está permitido |
| Googlebot | Toda la Búsqueda de Google | Rankings orgánicos, AI Overviews y AI Mode a la vez | Nada en Google; casi nunca es lo que quieres |
La escala del intercambio también cuenta. Cloudflare midió cuántas páginas rastrea cada plataforma de IA por cada visitante que te devuelve: en julio de 2025, Anthropic estaba en unos 38.000 rastreos por visitante referido y Perplexity en 194. Esas proporciones son el argumento económico que usan los editores para bloquear los crawlers de entrenamiento y dejar abiertos los de búsqueda.
¿Qué crawlers de IA deberías permitir o bloquear? Matriz de decisión según tu objetivo de negocio
Empieza por lo que vendes. Si que un asistente de IA te recomiende puede conseguirte un cliente, permite todos los crawlers de búsqueda y los fetchers de usuario, y trata el entrenamiento como una decisión aparte y de menor peso.
| Tu situación | Crawlers de entrenamiento | Crawlers de búsqueda | Fetchers de usuario y agentes | Por qué |
|---|---|---|---|---|
| SaaS B2B, agencias, servicios locales | Permitir (o bloquear, coste bajo) | Permitir | Permitir | Los compradores preseleccionan proveedores en las respuestas de la IA; estar en el conocimiento del modelo también ayuda a las menciones espontáneas |
| Ecommerce | Tú decides | Permitir | Permitir, y añadir los agentes firmados a la lista de permitidos de tu WAF | Las respuestas de compra citan fichas de producto, y los agentes necesitan llegar al carrito y al checkout |
| Medios de noticias y editores financiados con publicidad | Bloquear | Permitir, o bloquear en páginas con anuncios | Decidir según el operador | El contenido es el producto; las citas todavía devuelven algunos lectores |
| Documentación para desarrolladores y proyectos open source | Permitir | Permitir | Permitir | Los desarrolladores preguntan a los asistentes cómo usar tu API; un conocimiento preciso en el modelo reduce la carga de soporte |
| Contenido de pago o con licencia | Bloquear | Permitir solo las páginas índice | Bloquear con WAF si la licencia lo exige | Que los adelantos se puedan citar y el texto completo quede fuera |
| Staging, intranets, apps privadas | Bloquear | Bloquear | Bloquear | Usa autenticación; robots.txt es una petición, no un candado |
| Servidor bajo presión de rastreo | Limitar la frecuencia o bloquear | Permitir, con límite de frecuencia en la CDN | Permitir | Resuelve la carga en el edge en lugar de perder citas |
¿Cómo bloquear los crawlers de entrenamiento de IA y permitir la búsqueda con IA en robots.txt?
Dale a cada token de entrenamiento su propio grupo con Disallow: / y deja que tus reglas normales cubran a los crawlers de búsqueda. Un crawler solo obedece el grupo más específico que lo nombra, así que un bloqueo de entrenamiento nunca se extiende a los bots de búsqueda.
Ejemplo 1: bloquear el entrenamiento y mantener la búsqueda con IA y los fetchers de usuario
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 permite que varias líneas User-agent compartan un mismo grupo, y la coincidencia no distingue entre mayúsculas y minúsculas. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot y Bingbot caen en el grupo * y siguen permitidos.
Ejemplo 2: abrirte de forma explícita a la búsqueda con IA
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Nombrar los bots de búsqueda de forma explícita te protege de una futura regla general escrita por otra persona, como un plugin que añada User-agent: * con Disallow: /. Mantén las rutas privadas bloqueadas dentro del grupo, porque un grupo con nombre sustituye al grupo * para ese bot, no se suma a él.
Ejemplo 3: tres trampas que rompen archivos reales
- Applebot hereda las reglas de Googlebot. Apple explica que, si tu archivo no menciona a Applebot pero sí a Googlebot, Applebot sigue el grupo de Googlebot. Un bloqueo específico para Googlebot puede sacarte sin avisar de Siri y Spotlight.
- Amzn-SearchBot hereda las reglas de otros bots de búsqueda cuando no se le nombra, según Amazon. Nómbralo si quieres otro resultado.
- Cada subdominio necesita su propio archivo. Anthropic y Amazon dicen que leen robots.txt por host, así que
docs.example.comnecesita su propia copia.
Puedes crear y revisar estos grupos con el generador de robots.txt gratuito de AI Rank Lab, y nuestras plantillas de robots.txt para crawlers de IA profundizan en configuraciones de acceso total y de acceso selectivo.
¿Cómo verificar que un crawler de IA es real y no una suplantación?
Nunca te fíes solo del user agent: cualquiera puede poner "GPTBot" en una cabecera, y Common Crawl advierte en su propia página de que hay crawlers que se hacen pasar por CCBot. Los operadores admiten tres métodos de verificación, y cuál usar depende del operador.
- DNS inverso y luego DNS directo. Ejecuta
hostsobre la IP de tu log, comprueba que el nombre de host termina en el dominio del operador y luego ejecutahostsobre ese nombre de host para confirmar que devuelve la misma IP. Google lo documenta paragooglebot.com,google.comygoogleusercontent.comen su guía de verificación; Apple usa*.applebot.apple.com; Common Crawl usa*.crawl.commoncrawl.org(solo IPv4). - Comparar la IP con la lista publicada por el operador. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral y Amazon publican rangos de IP. Es el único método para OpenAI, Anthropic y Perplexity, que no documentan un patrón de DNS inverso.
- Comprobar una firma criptográfica (Web Bot Auth). El Cloud browser de ChatGPT firma sus peticiones según RFC 9421 con una cabecera
Signature-Agentcon el valor"https://chatgpt.com". Google está probando el mismo borrador del IETF en algunas peticiones de Google-Agent, firmadas comohttps://agent.bot.goog, y su página de Web Bot Auth recomienda mantener las comprobaciones de IP como respaldo, porque no todas las peticiones van firmadas.
# Búsqueda inversa y luego directa (ejemplo de Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# Comprobación con la lista de IP del crawler de búsqueda de OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
¿Qué tan actualizadas están las listas de IP publicadas?
El 18 de octubre de 2026 descargamos todos los archivos de IP de crawlers de IA publicados y leímos el campo creationTime que cada operador escribe en ellos. Una fecha antigua puede significar simplemente que los rangos no han cambiado, pero te dice cuánto puedes fiarte de una lista de permitidos escrita a mano, y muestra qué listas no pueden dar cuenta del tráfico que el operador nunca declaró.
| Lista publicada | creationTime en el archivo | Prefijos IPv4 / IPv6 |
|---|---|---|
| Rastreadores comunes de Google (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Agentes de Google activados por el usuario (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (los tres bots, una sola lista) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Dos lecciones prácticas. Las listas de Google y la de ChatGPT-User de OpenAI cambiaron en las últimas dos semanas, así que una lista de permitidos del firewall que copiaste en verano probablemente ya está mal; descarga estos archivos a diario o cada semana. Y Anthropic advierte que bloquear sus IP "puede no funcionar correctamente ni garantizar de forma persistente la exclusión", porque impide que Anthropic lea tu robots.txt; usa robots.txt para excluirte y las IP solo para verificar.
¿Cómo ver la actividad de los crawlers de IA: logs del servidor o etiquetas JavaScript?
Usa los logs del servidor o de la CDN para los crawlers, y la analítica en JavaScript para los visitantes humanos que llegan desde asistentes de IA. Una etiqueta JS solo se ejecuta cuando algo ejecuta el JavaScript de la página, y la mayoría de los crawlers de IA no lo hacen. El análisis de Vercel sobre su red concluyó que ninguno de los grandes crawlers de IA renderizaba JavaScript; los crawlers de ChatGPT y de Claude descargaban archivos JS (el 11,50 % y el 23,84 % de sus peticiones), pero no los ejecutaban. Las excepciones fueron Gemini, que usa el renderizado de Googlebot, y Applebot. El estudio es de diciembre de 2024, así que vuelve a comprobarlo en tu sitio, aunque coincide con lo que vemos nosotros.
Google Analytics agranda la brecha por diseño. GA4 excluye automáticamente el tráfico de bots y arañas conocidos, y no puedes desactivarlo ni ver cuánto se eliminó. GA4 es la herramienta adecuada para el tráfico de referencia desde IA, que explicamos en cómo medir el tráfico de referencia de IA en GA4, y la equivocada para contar crawlers.
Vemos el mismo patrón en los datos de seguimiento de AI Rank Lab. Nuestra etiqueta JavaScript registra de forma fiable a las personas que hacen clic desde ChatGPT, Gemini, Perplexity y Claude, pero solo ve una parte pequeña y poco representativa del tráfico de crawlers, y por eso no publicamos recuentos de crawlers a partir de ella.
Una revisión de logs en cinco minutos
- Descarga un día de logs de acceso en bruto de tu hosting o tu CDN (Nginx y Apache registran el user agent en el formato combinado por defecto).
- Cuenta las peticiones por token de IA:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Para los tokens con más peticiones, revisa los códigos de estado. Un muro de 403 o 429 suele significar que una regla del WAF o de la CDN está bloqueando un bot que tu robots.txt permite.
- Verifica una muestra de IP con los métodos de arriba antes de fiarte de cualquier recuento.
- Mira qué URL piden los bots de búsqueda. Si OAI-SearchBot o Claude-SearchBot solo descargan tu página de inicio, revisa el enlazado interno y tu sitemap.
Herramientas que muestran la actividad de los crawlers de IA
Aviso: AI Rank Lab es nuestro producto. Lo ponemos primero porque este es nuestro sitio, y hemos aplicado los mismos criterios a todas las herramientas de la lista.
- AI Rank Lab - el seguimiento de bots de IA registra, por página, las referencias desde asistentes de IA y las visitas de bots de IA que su etiqueta puede ver, junto a tu seguimiento de visibilidad en IA y de citas. Combínalo con los logs para tener el recuento completo de crawlers, por las razones de arriba.
- Cloudflare AI Crawl Control - si tu sitio pasa por el proxy de Cloudflare, es la vista de crawlers más completa que existe, porque ve cada petición en el edge, incluidos los bots que nunca ejecutan JavaScript. También muestra el cumplimiento de robots.txt por crawler.
- Analizadores de logs como Log File Analyser de Screaming Frog o GoAccess - trabajan con logs en bruto de cualquier hosting y son muy buenos para auditorías puntuales.
- Logs en bruto más el grep de arriba - gratis, exacto y la referencia con la que debería cuadrar cualquier otra herramienta.
Si quieres una rutina de monitorización más completa centrada en los tres bots principales, consulta nuestra guía para monitorizar GPTBot, ClaudeBot y PerplexityBot.
¿Cómo controlan Cloudflare y otras CDN los bots de IA?
Las CDN imponen en el edge de la red lo que robots.txt solo puede pedir. AI Crawl Control de Cloudflare, disponible en todos los planes, muestra qué servicios de IA acceden a tu sitio, te deja permitir o bloquear cada crawler, registra las infracciones de robots.txt y ofrece pago por rastreo (pay per crawl) en beta privada.
Las políticas de bots de IA de Cloudflare usan ahora la misma división en tres tipos que este artículo. Sus ajustes de Block AI Bots ofrecen preajustes separados para Search, Agent y Training, cada uno con las opciones "bloquear en todas las páginas", "bloquear en páginas con anuncios" o "permitir". Según su documentación, desde el 15 de septiembre de 2026 los dominios nuevos reciben valores predeterminados actualizados: bots de Training y Agent bloqueados en las páginas que muestran anuncios, Search permitido, y los crawlers de uso mixto que combinan búsqueda y entrenamiento bloqueados por cualquier bloqueo de entrenamiento. Si pusiste un sitio en Cloudflare después de esa fecha y no entiendes por qué ChatGPT-User o Claude-User reciben 403 en tu blog, revisa este ajuste primero.
Cloudflare también puede gestionar tu robots.txt. Con Bot Preference Sync activado, su robots.txt gestionado antepone a tus reglas existentes grupos de disallow para Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot y meta-externalagent, además de una línea de Content Signals (search=yes, ai-train=no). Content Signals es un vocabulario propuesto por Cloudflare (search, ai-input, ai-train) que indica cómo puede usarse el contenido después de descargarlo; que un operador concreto lo respete depende de ese operador.
Otros proveedores admiten el mismo esquema. La documentación de Perplexity incluye indicaciones de WAF para Cloudflare y AWS WAF con sus listas de IP, y el centro de ayuda de OpenAI explica cómo añadir su Cloud browser firmado a la lista de permitidos en Akamai (nombre del bot "ChatGPT Agent") y en Cloudflare (ID de detección 129220581). Sea cual sea tu CDN, el orden es el mismo: decide por tipo, exprésalo en robots.txt, aplícalo en el edge solo donde necesites un bloqueo real y vuelve a revisar tus logs después de cualquier cambio en la CDN.
Google y Bing: los dos casos especiales
¿Bloquear Google-Extended afecta a la Búsqueda de Google o a AI Overviews?
No. Google afirma que Google-Extended "no influye en la inclusión de un sitio en la Búsqueda de Google ni se usa como señal de ranking". Su documentación sobre funciones de IA deja claro que las reglas de robots.txt para Googlebot son el control de la Búsqueda, incluidos AI Overviews y AI Mode, y que lo que aparece se limita con nosnippet, data-nosnippet, max-snippet o noindex. Google-Extended cubre el entrenamiento de los modelos de Gemini y el grounding en las apps de Gemini y en Vertex AI, que son algo aparte de la Búsqueda.
¿Cómo controlar si Microsoft Copilot usa tu contenido?
Microsoft no tiene un token de crawler de IA propio; el rastreo lo hace Bingbot, y el uso para IA se controla con metaetiquetas robots a nivel de página. La guía oficial más reciente que encontramos es el anuncio de 2023 del equipo de Bing, escrito cuando Copilot todavía se llamaba Bing Chat: el contenido marcado con noarchive no se incluye ni se enlaza en las respuestas del chat de Bing y no se usa para entrenar los modelos fundacionales de Microsoft; el contenido marcado con nocache puede aparecer solo con URL, título y fragmento; el contenido sin ninguna de las dos etiquetas puede usarse por completo. Con ambas etiquetas sigues en los resultados normales de Bing. Bloquear Bingbot en robots.txt también te sacaría de la búsqueda de Bing, así que usa las metaetiquetas.
Limitaciones y cómo lo comprobamos
El 18 de octubre de 2026 leímos la página de crawlers de cada operador citada arriba, descargamos todas las listas de IP publicadas y anotamos el creationTime de cada archivo. No pudimos renderizar la página de ayuda de Microsoft sobre su crawler, que funciona solo con JavaScript, así que la fila de Bingbot se basa en el blog de Bing Webmaster, en su herramienta Verify Bingbot y en su bingbot.json publicado. Las columnas de robots.txt resumen lo que dice cada operador, no lo que medimos por nuestra cuenta; los hallazgos de Cloudflare sobre Perplexity son la principal evidencia pública de que ambas cosas pueden diferir. Los operadores renombran y añaden bots a menudo (Google, por ejemplo, ha sustituido su token de fetcher Google-NotebookLM por Google-GeminiNotebook), así que considera cualquier lista, incluida esta, correcta en su fecha de comprobación.
Si quieres ver si tu política de crawlers te está consiguiendo citas de verdad, AI Rank Lab sigue tus menciones y las páginas citadas en ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews y AI Mode, junto al tráfico de referencia que te envían esas respuestas.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


