



ChatGPT検索は5つのステップで動いています。質問に最新情報が必要かどうかを判断し、質問を1つ以上の検索クエリに書き換え、OpenAI独自のインデックスとキャッシュ、そして提携検索プロバイダーから候補ページを集め、見つけたものをランク付けし、使ったページへのリンク付きで回答を書く、という流れです。OpenAIはこれらの要素をそれぞれドキュメントで説明しています。公表していないのは、各情報源がどれだけ重視されているかで、混乱(と憶測)のほとんどはここから生まれています。
この記事では、OpenAIが自社ドキュメントで公式に認めていることと、研究者がリバースエンジニアリングで突き止めたことを切り分けて整理します。さらに、OpenAIの4つのユーザーエージェントとそれぞれが何を制御しているかを解説し、サイト運営者が影響を与えられること・与えられないことのチェックリストをお届けします。2026年10月8日〜16日のUTMタグ欠落を含め、ChatGPTからの参照トラフィックについて私たち自身のトラッキングデータからわかったことも紹介します。情報源はすべて2026年10月18日に確認しています。
この記事のポイント
- 公式確認済み:ChatGPTは、OpenAI独自の「インデックス化・キャッシュされたウェブコンテンツ」に加えて、サードパーティの検索プロバイダーや提携先のコンテンツを利用しています。OpenAIは、書き換えたクエリを送る可能性のあるプロバイダーとしてMicrosoftとShopifyの名前を挙げています。
- 非公開:その配分。「Labrador」という内部インデックスや、それを外部の検索結果と比較するテストについての報告は、OpenAIではなく第三者の調査によるものです。
- 検索で重要なスイッチはOAI-SearchBot。これをブロックすると、ページはChatGPT検索の回答に表示されなくなります。GPTBotをブロックしても、モデル学習から外れるだけです。
- 引用は安定しない。私たちのトラッキングでは、あるプロンプトに対してChatGPTが引用したドメインのうち、そのプロンプトの全実行に登場したのは中央値でわずか7.7%でした。
- リファラーではなくUTMで数える。私たちのタグが記録したChatGPTタグ付きページビューの39%は、リファラーがまったくない状態で届いていました。
この記事の読み方:「公式確認済み」と「報告」の違い
以下のすべての情報には、3種類のラベルのいずれかを付けています。ChatGPT検索をめぐる議論ではこれらがごちゃ混ぜに語られがちで、それが誤ったアドバイスが広まる原因になっているからです。
- 公式確認済み:OpenAIがヘルプセンター、開発者向けドキュメント、リリースノート、公式発表で述べていること。
- 報告:第三者の調査、ChatGPTのネットワーク通信のリバースエンジニアリング、記者が伝えた法廷証言、伝聞による発言。信頼できる場合も多いものの、公式ではありません。
- 自社データ:AI Rank LabのプロンプトトラッキングとJavaScriptタグから得た、集計・匿名化済みの数値。各数値の横に方法とサンプルサイズを明記しています。
ChatGPT検索はどう動く?ステップごとに解説
ひと言でいえば、検索・取得のパイプラインです。検索するかどうかの判断、クエリの書き換え、複数の情報源からの取得、ランク付け、そして引用付きの回答作成。各ステップを根拠のレベルとあわせて見ていきましょう。
- 検索するかどうかを判断する。公式確認済み:OpenAIのヘルプ記事Searching the web with ChatGPTによると、ChatGPTは最新情報が役立つ質問に対して自動で検索することがあります。ツールメニューから「検索」を選ぶか、入力欄に「/」と入力して強制的に検索させることもできます。報告:RESONEOによる2026年2月のリバースエンジニアリングでは、プロンプトごとにスコアを付け、しきい値を超えると検索を起動する分類器の存在が説明されています。
- プロンプトを検索クエリに書き換える。公式確認済み:提携検索プロバイダーを使う場合、ChatGPTは通常、質問を1つ以上の的を絞ったクエリに書き換えます。最初の結果を読んだあとに、より具体的な追加クエリを送ることもあり、IPアドレスから推定したおおまかな位置情報(IPアドレスそのものではありません)を加えたり、書き換えの際に保存されたメモリを使ったりすることもあります。これがクエリファンアウトで、詳しくはクエリファンアウトの解説記事をご覧ください。
- 候補ページを取得する。公式確認済み:結果は、サードパーティの検索プロバイダー、提携先から直接提供されたコンテンツ、そしてOpenAI独自のインデックス化・キャッシュされたウェブコンテンツから得られます。報告:具体的なプロバイダー名とその割合(次のセクションを参照)。
- 候補をランク付けする。公式確認済み:OpenAIによると、ChatGPTは関連性が高く信頼できる情報を表示するための複数の要素で検索結果をランク付けしており、掲載は保証されません。その要素は公表されていません。報告:RESONEOは、複数のエンジンの結果が、順位付きリストを統合する標準的な手法であるReciprocal Rank Fusionで統合されていると説明しています。
- 回答を書き、情報源を引用する。公式確認済み:検索を使った回答には、本文中の引用、引用元やその他の関連リンクを一覧表示する「情報源」ボタン、画像の出典リンク、モバイルでは地図が含まれることがあります。回答を書くモデルは時期によって変わっており、2024年のリリース時はファインチューニングしたGPT-4oが使われていましたが、2026年10月7日のリリース以降、ChatGPTのチャットはGPT-6(有料プランではSol、FreeとGoではLuna)で動いており、グラフや比較、インタラクティブな要素で回答できる新しい「Intelligent UI」も導入されています。
ChatGPTが記憶ではなくウェブ検索で答えるのはどんなとき?
ChatGPTが検索するのは、ニュース、価格、試合結果、地域の情報、最近の出来事など、新しい情報や具体的な情報が必要だと判断したときです。それ以外は学習データから回答します。この判断は、手動で「検索」を選ぶか、ChatGPTにウェブ検索するよう頼むことで上書きできます。
実際にはどのくらいの頻度で検索しているのでしょうか。報告:Profoundによる米国の英語ChatGPT会話の調査(2025年10月〜12月。うち約730,000件の会話に1つ以上のウェブ引用が含まれていた)によると、少なくとも1回ウェブ検索が発生した会話は約18%で、会話が進むにつれて引用付きの回答が出る確率は下がっていました。最初のターンでは12.6%に引用がありましたが、10ターン目には4.5%まで減っています。
ここから実務的な結論が2つ導けます。1つ目は、ChatGPTが検索しない場合、今日サイトに加えた変更はその回答に一切影響しないということ。回答は学習データから来ており、それを左右するのはGPTBotの領域です。2つ目は、検索、つまり引用が最も起きやすいのは会話の最初の質問だということです。
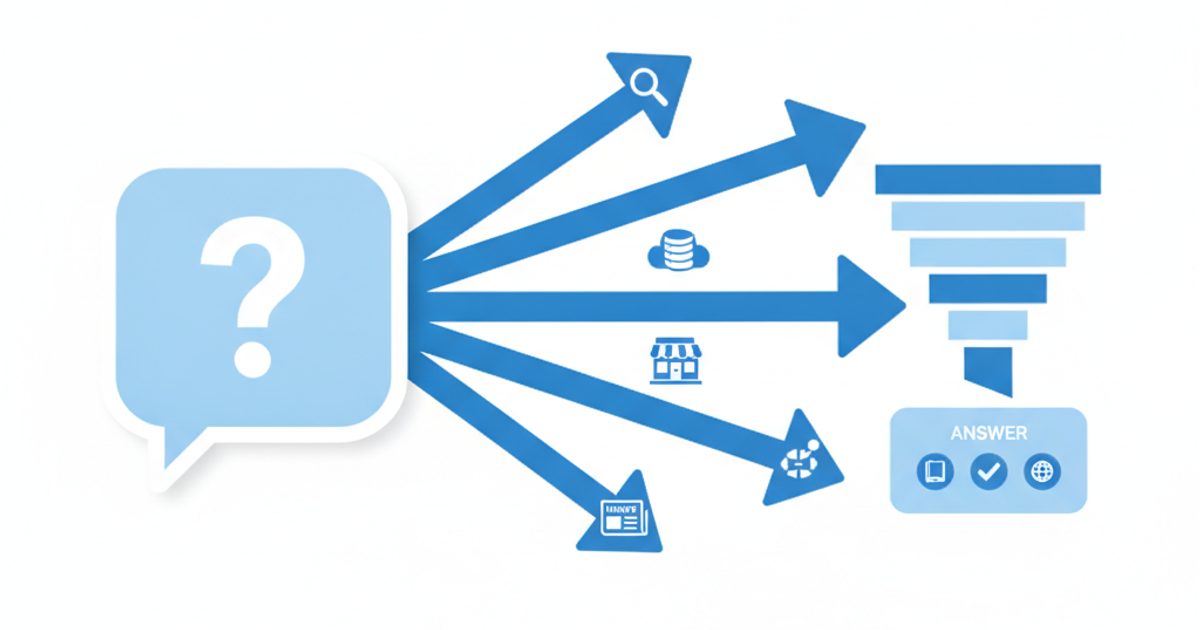
ChatGPT検索の結果はどこから来ている?
ChatGPT検索の結果は、OpenAI独自のインデックスとキャッシュ、サードパーティの検索プロバイダー、ライセンス契約や提携先のデータを組み合わせたものです。OpenAIはこの3つすべての存在を認めています。ただし、それぞれがどのくらいの頻度で使われているかは公表しておらず、その割合はニュース、ショッピング、地域情報、一般的なクエリで異なると考えられます。
OpenAIが公式に認めていること
- サードパーティのプロバイダーと提携先のコンテンツ。2024年10月31日のリリース記事では、ChatGPT検索がサードパーティの検索プロバイダーと提携先から直接提供されるコンテンツを使っており、天気、株価、スポーツ、ニュース、地図はニュースやデータの提携先が支えていると説明されています。
- 名前が挙がっているプロバイダー。現在のヘルプ記事では、書き換えたクエリを受け取る可能性のある検索プロバイダーとして、MicrosoftとShopifyのプライバシーポリシーが案内されています。レストラン予約については、OpenTable、Resy、Yelpの空き状況が表示されます。
- OpenAI独自のインデックスとキャッシュ。OpenAIのヘルプ記事ChatGPTワークスペース向けのオフラインウェブ検索では、ChatGPTがリアルタイムのプロバイダーを呼び出す代わりに「OpenAIがインデックス化・キャッシュしたウェブコンテンツ」を検索するモードが説明されています。特定のURLについて更新の保証はなく、カバー範囲はサイト、言語、地域、コンテンツの種類によって異なるとも書かれています。
ChatGPTには独自の検索インデックスがある?
あります。OpenAI自身のドキュメントに、同社が管理するインデックスとキャッシュが記載されており、それを埋めるために専用の検索クローラーであるOAI-SearchBotを運用しています。まだ確認されていないのは、一般ユーザーが日常的に使うChatGPT検索のうち、外部プロバイダーではなくそのインデックスから回答されている割合です。
この点について公開されている最良の根拠は、第三者によるものです。
- 報告:2025年4月に行われたGoogle検索の独占禁止法をめぐる是正措置の裁判で、ChatGPTのプロダクト責任者であるOpenAIのNick Turley氏は、OpenAIが独自のインデックスを構築中であること、それに完全に頼れるようになるまでにはおそらく何年もかかること、そして2024年にOpenAIが求めた検索APIへのアクセスをGoogleが断ったことを証言しました(Tech Policy Press)。
- 報告:Peec AIによる2026年9月の分析では、2026年5月21日から7月21日にかけて、ChatGPTのサーバー送信イベントに
result_sourceというフィールドが見つかり、その値はLabrador、Bright、Oxylabs、SERPの4種類でした。PeecはLabradorをOpenAIの分野別インデックス群(ウェブ、PDF、YouTube、ニュース、Wikipedia、arXiv、地域情報、金融、法律、医療、ショッピング、画像)と解釈し、残りの3つは外部のスクレイピング経路だと見ています。各値がどのくらいの頻度で現れたかは報告されていません。 - 報告:PeecとOtterly AIは、
prefer-index-over-serp-v3という名前の実験について説明しており、OpenAIのインデックスをサードパーティの検索結果と比較するテストとみられます。Otterlyは、2026年8月の時点で会話の約8%が対象だったとしています。Search Engine WatchはOpenAIにコメントを求めましたが、記事公開時点で回答はありませんでした。
ChatGPT検索はBingやGoogleを使っている?
Microsoftは公表されている検索プロバイダーですが、Googleは違います。OpenAIのヘルプセンターには検索に関するMicrosoftのプライバシーに関する声明が掲載されており、2026年6月に発表されたMicrosoftのグラウンディング基盤Web IQがChatGPTを支えていると、OtterlyとPeecが報告しています。ただ、私たちはこの内容をMicrosoftの一次情報で確認できなかったため、「報告」として扱ってください。Turley氏の証言によればGoogleはOpenAIと提携していませんが、複数の研究者(RESONEO、Peec)が、スクレイピング事業者を通じてGoogleの検索結果がChatGPTに届いていると報告しています。OpenAIはこれを認めていません。
実務上のポイントはこうです。BingやGoogleで上位表示されれば、ChatGPTが使う可能性のあるプロバイダーにページが見つけてもらいやすくなります。しかし、どちらの順位もChatGPTでの露出を正確に代弁するものではありません。ChatGPTは直接測定する必要があります。
| 主張 | ステータス | 情報源 | 日付 |
|---|---|---|---|
| ChatGPTはサードパーティの検索プロバイダーと提携先のコンテンツを使っている | 公式確認済み | OpenAIのリリース記事 | 2024年10月31日 |
| MicrosoftとShopifyはクエリを受け取る可能性のある検索プロバイダーである | 公式確認済み | OpenAIヘルプセンター | 2026年10月18日確認 |
| OpenAIは独自にインデックス化・キャッシュしたウェブコンテンツを保持している | 公式確認済み | OpenAIヘルプセンター(オフラインウェブ検索) | 2026年10月18日確認 |
| OAI-SearchBotはChatGPT検索にサイトを表示するためにクロールしている | 公式確認済み | OpenAI開発者向けドキュメント | 2026年10月18日確認 |
| OpenAIは独自インデックスを構築中で、完全に頼れるのは何年も先 | 報告(法廷証言) | Tech Policy Press | 2025年4月 |
| 「Labrador」と呼ばれる内部インデックス群と、Bright、Oxylabs、SERPの経路 | 報告(ネットワーク分析) | Peec AI | 2026年9月 |
| OpenAIのインデックスを外部の検索結果と比較する実験(チャットの約8%) | 報告 | Peec AI、Otterly AI | 2026年8月〜9月 |
| Microsoft Web IQがChatGPTの回答をグラウンディングしている | 報告(Microsoftの情報源では未確認) | Otterly AI、Peec AI | 2026年6月 |
| Googleの検索結果がスクレイピング事業者経由でChatGPTに届いている | 報告(未確認) | RESONEO、Peec AI | 2026年 |
OAI-SearchBot、GPTBot、ChatGPT-Userの違いとは?
OAI-SearchBotはChatGPT検索に表示されるかどうかを、GPTBotはコンテンツをOpenAIのモデルの学習に使ってよいかどうかを決めます。ChatGPT-Userは、ユーザーがChatGPTにページを開くよう頼んだときにそのページを取得するエージェントです。3つは互いに独立しているので、1つを許可して別のものをブロックできます。OpenAIのクローラーに関するドキュメントには、ChatGPT広告用の4つ目のエージェント、OAI-AdsBotも記載されています。
| ユーザーエージェント | 役割(OpenAIの説明) | robots.txtで制御できること | IPリスト |
|---|---|---|---|
| OAI-SearchBot | ChatGPTの検索機能にウェブサイトを表示するためにクロールする | 拒否すると、ページはChatGPT検索の回答に表示されなくなります。ただし、単なるナビゲーション用リンクとしては表示される場合があります。変更の反映には約24時間かかります。 | openai.com/searchbot.json |
| GPTBot | OpenAIの基盤モデルの学習に使われる可能性のあるコンテンツをクロールする | 拒否すると、コンテンツを学習に使わないでほしいという意思表示になります。検索の対象かどうかには影響しません。 | openai.com/gptbot.json |
| ChatGPT-User | ユーザーがChatGPTにページを読むよう頼んだときなど、ユーザー起点の訪問やGPT Actions | 訪問をユーザーが起こしているため、robots.txtのルールが適用されない場合があります。検索に含めるかどうかの判断には使われません。 | openai.com/chatgpt-user.json |
| OAI-AdsBot | ChatGPT広告として入稿されたランディングページを確認する。訪問するのはそのページのみ | ChatGPTに広告を出している場合にのみ関係します。収集したデータは基盤モデルの学習には使われません。 | openai.com/adsbot.json |
ChatGPT検索には表示されたいけれど学習には使われたくない、というサイトのよくある設定は次のとおりです。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /OpenAIのドキュメントで見落とされがちなポイントが2つあります。両方のボットを許可している場合、OpenAIは1回のクロールを両方の目的に使うことがあります。また、robots.txt自体の取得時には、ユーザーエージェント文字列に「robots.txt」という追加の目印が付くことがあります。AIクローラー全体のルール設定についてはAIクローラー向けrobots.txtガイドや無料のrobots.txtジェネレーターを、ログで本物のボットのアクセスを確認する方法についてはGPTBot・ClaudeBot・PerplexityBotのモニタリングガイドをご覧ください。
ChatGPTは引用する情報源をどう選んでいる?
OpenAIが述べているのは、ChatGPTが関連性と信頼性を重視した複数の要素で結果をランク付けしており、掲載は保証されない、ということだけです。ランキング要素のリストも送信ツールも公開されていません。私たちが測定できるのは、引用のパターンです。
報告:Profoundの3か月にわたる調査では、引用付きの回答は平均で約4つのユニークな情報源を使っており、引用のあるターンの66%は1〜4つの情報源を使っていました。引用は広く分散しており、上位10ドメインが占めるのは全引用のわずか12%で、Wikipediaが約5%、Redditが約3%でした。
自社データ:AI Rank Labがそれぞれ5回以上実行した11件のChatGPTプロンプト(成功した実行239回、2026年2月13日〜10月14日)では、同じプロンプトの連続する実行間で引用ドメインが重なる割合の中央値は0.54(Jaccard類似度。1は完全一致)でした。あるプロンプトに対してChatGPTが引用したドメインのうち、全実行に登場したのは中央値でわずか7.7%で、11件中6件のプロンプトは、トラッキング対象のブランドに言及するかしないかが少なくとも1回入れ替わりました。これは自動実行なので、ログインしているユーザーのパーソナライズされた結果とは一致しない可能性があります。方法の詳細はAI回答の一貫性に関する調査にまとめています。
つまり、「ChatGPTに引用されているか?」という問い自体がずれているのです。役に立つのは「繰り返し実行したうちの何割で、どのプロンプトについて引用されているか?」という問いです。手作業で1回チェックしても、ほとんど何もわかりません。
ChatGPT検索からのトラフィックはどう計測する?
ChatGPTからの訪問は、リファラーではなく、ChatGPTが外部リンクに付けるutm_source=chatgpt.comパラメータで計測しましょう。このパラメータはOpenAIのパブリッシャー向けFAQに記載されており(2026年10月18日にはそのページを読み込めなかったため、以前の版と私たちの観測内容に基づいています)、実際のトラフィックでもはっきり確認できます。
自社データ:2025年7月27日から2026年10月18日までに、AI Rank LabのJavaScriptタグは29サイトでutm_source=chatgpt.com付きのページビューを2,710件記録しました。一方、リファラーがchatgpt.comだったページビューは26サイトで2,087件です。タグ付きページビュー2,710件のうち1,048件(39%)は、リファラーがまったくない状態で届いていました。リファラーだけに頼るアナリティクスなら、これらの訪問はDirectに分類されていたはずです。
GA4では、セッションの参照元がchatgpt.comのもの(UTMも拾えます)を確認し、それを含むチャネルグループを作成します。設定方法はGA4でのAI参照トラフィックの計測で紹介しています。また、AIボットトラッキングを使えば、GA4に頼らずにページごとのAIアシスタントからの参照を記録できます。
2026年10月、ChatGPTのUTMタグに何が起きた?
GPT-6のリリース後およそ1週間、ChatGPTの多くのリンクがUTMタグなしで送出され、それまでChatGPT経由とされていた訪問がDirectとして表示されました。タグは10月15〜16日に復活しています。GPT-6のリリース日以外の情報はすべて第三者によるもので、OpenAIは公式な声明を出しておらず、リリースノートでも触れていません。
| 日付(2026年) | 出来事 | ステータス | 情報源 |
|---|---|---|---|
| 10月7〜8日 | GPT-6とIntelligent UIが有料プランに、続いてFreeとGoに展開 | 公式確認済み | OpenAIのリリースノート |
| 10月8日 18:30頃(UTC) | タグ付きリンクを含む回答の割合が約99%から下がり始める | 報告 | Profound |
| 10月9〜13日 | 約500ページで、ChatGPTからの訪問が1日あたり約31,000件減少し、Directが1日あたり約26,000件増加 | 報告 | AdobeのCedric Huesler氏(SEJ経由) |
| 10月14日 | Huesler氏が、OpenAIから既知のバグだと伝えられたと発言 | 報告(伝聞) | SEJ |
| 10月14日 19:00頃(UTC) | Intelligent UIの回答が92〜96%に達し、タグ付き回答は5〜10%まで低下 | 報告 | Profound |
| 10月15〜16日 | 修正が展開され、10月16日06:30(UTC)までにタグ付き回答が約99%に回復 | 報告 | Profound、SEJ |
出典:Search Engine Journal(2026年10月15日)、Profoundのインシデントタイムライン。
自社データ:この期間の私たちのサンプルは小さいので、測定値ではなく整合性の確認として読んでください。10月9日から18日にかけて、私たちのタグは2サイトでChatGPTタグ付きページビューを52件記録しましたが、そのうちchatgpt.comのリファラーを持つものは1件もありませんでした。その前の30日間(9月9日〜10月8日)では、7サイトのタグ付きページビュー368件のうち236件(64%)にリファラーがありました。これは、タグが戻ったあとも、ChatGPTからのクリックの多くはリファラーなしで届いているという報告と一致します。
やるべきことは3つです。レポートの10月8日〜16日に注記を入れること、トラフィックが失われたと判断する前に、普段ChatGPTから流入しているランディングページのDirectトラフィックを比較すること、そしてリファラーではなくUTMで数え続けることです。
ChatGPT検索の対象になるには、サイトで何をすればいい?
対象になるための条件は、OAI-SearchBotがページにアクセスして読めるようにすることに尽きます。OpenAIのヘルプセンターははっきりこう書いています。robots.txtでOAI-SearchBotを許可し、サーバーやCDNがOpenAIの公開している検索ボットのIPアドレスからのトラフィックを許可していることを確認してください、と。以下のリストのそれ以外の項目は、対象になるかどうかではなく、引用される確率を高めるためのものです。
- robots.txtでOAI-SearchBotを許可する。GPTBotについては別途判断しましょう。
User-agent: *のような広範なルールで誤ってブロックしていないかも確認してください。 - CDN、ファイアウォール、ボット対策の層でOpenAIのIPレンジを許可する。「AIボットをブロック」といった設定の多くは、OAI-SearchBotまでブロックしてしまいます。ログの403や429のレスポンスをopenai.com/searchbot.jsonと突き合わせましょう。
- メインコンテンツをHTMLに含める。OpenAIは、スクリプトへの過度な依存、動的な読み込み、ログイン、パーソナライズを、インデックスがページを取りこぼす理由として挙げています。重要なページはサーバーサイドレンダリングかプリレンダリングにしましょう。
- 深い階層のページを見つけやすくする。OpenAIは、深いページを埋もれさせるサイト構造も理由に挙げています。重要なページはハブページからリンクし、XMLサイトマップを最新に保ちましょう。
- ページを最新に保ち、日付を入れる。OpenAIはURLごとの更新スケジュールを示しておらず、鮮度はサイト、クロールのアクセス可否、キャッシュ、人気度によって決まるとしています。目に見える「更新日」は、読者にも、新しさを重視するあらゆるシステムにも役立ちます。
- 結論ファーストで、それだけで完結するパッセージを書く。これはOpenAIのガイダンスではなく、実務家の間での共通認識です。見出しの問いに最初の1文で答えるセクションは引用されやすくなります。コンテンツ面についてはChatGPTに引用されるための30日間プレイブックで解説しています。
- 自社の業界でChatGPTが参照するデータに載っておく。レストランではOpenTable、Resy、Yelpの空き状況が表示され、ショッピングではShopifyが公表されたプロバイダーです。該当する場合は、そこでの掲載情報もChatGPTでの露出の一部になります。
- OAI-SearchBotが実際に訪問しているか確認する。サーバーログをOAI-SearchBotのトークンで絞り込んでIPを検証し、そのうえで狙っているプロンプトに対してChatGPTがどのURLを引用しているかをトラッキングしましょう。
ステップ3〜5をサイト全体でチェックするなら、AEO監査がページをクロールし、SEO、回答エンジン、生成エンジンへの対応状況の問題を修正案付きで指摘します。ステップ8の後半については、引用トラッキングが、プロンプトに対してChatGPTが自社のどのURLを引用しているかを記録します。
自分のページがChatGPT検索に表示されないのはなぜ?
よくある理由は、クロールのブロック、CDNやファイアウォールのルール、JavaScriptの実行後にしか表示されないコンテンツ、そして新しい・階層が深い・ほとんどリンクされていないページです。OpenAIはオフラインウェブ検索のドキュメントで、ページがインデックスから漏れたり古くなったりする理由としてまさにこれらを挙げています。このリストはワークスペース管理者向けに書かれたものですが、OpenAIがインデックスの取りこぼしの理由を説明している唯一の場所なので、診断用のチェックリストとしても使えます。
| OpenAIが挙げる理由 | 確認方法 | 対処法 |
|---|---|---|
| robots.txtなどの制御でクロールがブロックされている | /robots.txtを開き、OAI-SearchBotの記述や全体へのDisallowがないか確認 | OAI-SearchBotを許可し、約24時間待つ |
| CDNやボットブロックの挙動 | ログで、403、429、チャレンジページを返しているOAI-SearchBotのリクエストを検索 | openai.com/searchbot.jsonのレンジを許可リストに追加 |
| ページにログインやパーソナライズが必要 | ログアウトした状態のプライベートウィンドウでページを開く | 主要コンテンツの公開版を用意する |
| コンテンツがスクリプトや動的読み込みに依存している | curlで生のHTMLを取得し、本文が含まれているか確認 | サーバーサイドレンダリングかプリレンダリングにする |
| ページが新しい、ほとんどアクセスされない、シグナルが弱い | 公開日と、ページに向いている内部リンク・外部リンクを確認 | 強いページからリンクし、言及を獲得し、時間をかける |
| サイト構造が深いページを埋もれさせている | トップページからのクリック数を数え、サイトマップを確認 | ハブからのリンクを追加し、サイトマップを最新に保つ |
すべての行に問題がないのにまだ引用されない場合、原因はたいていアクセスではなく、関連性や競合です。別のページのほうがプロンプトに直接答えているか、そもそもChatGPTがそのプロンプトで検索していないかのどちらかです。
ChatGPT検索でコントロールできないことは?
あなたがコントロールできるのは、アクセスとコンテンツの質です。その先で起こることの大半はコントロールできません。具体的には、次のようなことです。
- ChatGPTが検索するかどうか。ユーザーが検索を強制しない限り、判断するのはChatGPTです。
- どのプロバイダーが答えるか。OpenAIのインデックス、Microsoft、Shopify、提携先、あるいは報告されているスクレイピング経路が、非公開の比率で組み合わされており、OpenAIはその比率を積極的にテストしているようです。
- ランキングと引用。公開された要素のリストも保証もなく、私たちのデータでも引用は実行ごとに変わります。
- インデックスされる速さ。OpenAIは、URL送信ツール、インデックスカバレッジレポート、特定のURLの更新保証のいずれも用意していません。
- 学習データからの回答。ChatGPTが記憶から答える場合、今日のページ修正は反映されません。
- ChatGPT-Userの訪問。ユーザー起点の取得には、robots.txtが適用されない場合があります。
- ナビゲーション用リンク。OAI-SearchBotをブロックしたあとでも、サイトがナビゲーション用リンクとして表示されることはあります。
- リンクへのタグ付け。2026年10月の件が示したとおり、計測は予告なく崩れることがあります。
ChatGPTが引用しているURLはどうモニタリングする?
結果は実行ごとに変わるので、モニタリングとは、同じプロンプトを繰り返し実行し、言及と引用URLを時系列で記録することを意味します。プロンプトが数件程度なら、ログアウトしたブラウザで手作業でもできますが、それ以上になるとツールを使うほうが時間の節約になります。
開示:AI Rank Labは私たちの製品です。このサイトは私たち自身のものなので最初に掲載していますが、以下のすべてのツールに同じ基準を適用しています。
- AI Rank Lab:ChatGPT、Claude、Gemini、Perplexity、さらにGoogleのAI OverviewsとAIモードでプロンプトをスケジュールに沿って実行し、言及、順位、競合、引用URLを記録します。監査、Action Plan、コンテンツ公開を通じて、トラッキング結果を改善施策にもつなげます。詳しくはブランド可視性トラッキングをご覧ください。
- Profound:エンタープライズ向けで、上で引用した調査のように、ChatGPTの引用に関する公開データセットとしては最大級のものを発表しています。
- Peec AI:仕組みの調査に強く、ChatGPTのインデックスについて公開されている中で最も詳しい分析を行っています。
- Otterly AI:GEOの実験結果を頻繁に公開しており、複数のAIエンジンに対応しています。
調査方法と限界
2026年10月18日に、ウェブ検索、オフラインウェブ検索、リリースノートに関するOpenAIのヘルプセンター記事、OpenAIのクローラーに関するドキュメント、2024年のリリース記事を読み、ChatGPT検索の仕組みについて上位表示されている15本の記事とレポートを分析しました。第三者の調査結果は、いずれもOpenAIに確認されていないため「報告」としています。そのうちいくつかは、私たちと同様にAI可視性ツールを販売している企業によるものです。執筆当日はOpenAIのパブリッシャー向けFAQを読み込めず、ChatGPTにおけるMicrosoft Web IQの役割もMicrosoftの一次情報では確認できませんでした。自社データの数値は少数のサイトとプロンプトから得たもので、集計・匿名化したうえでサンプルサイズとともに示しています。これは私たちの顧客のトラフィックを表すものであり、ウェブ全体を表すものではありません。
重要なプロンプトに対してChatGPTが自社のどのページを実際に引用しているか、そしてそれが週ごとにどう変わるかを知りたいなら、AI Rank Labでトラッキングを始めましょう。
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


