



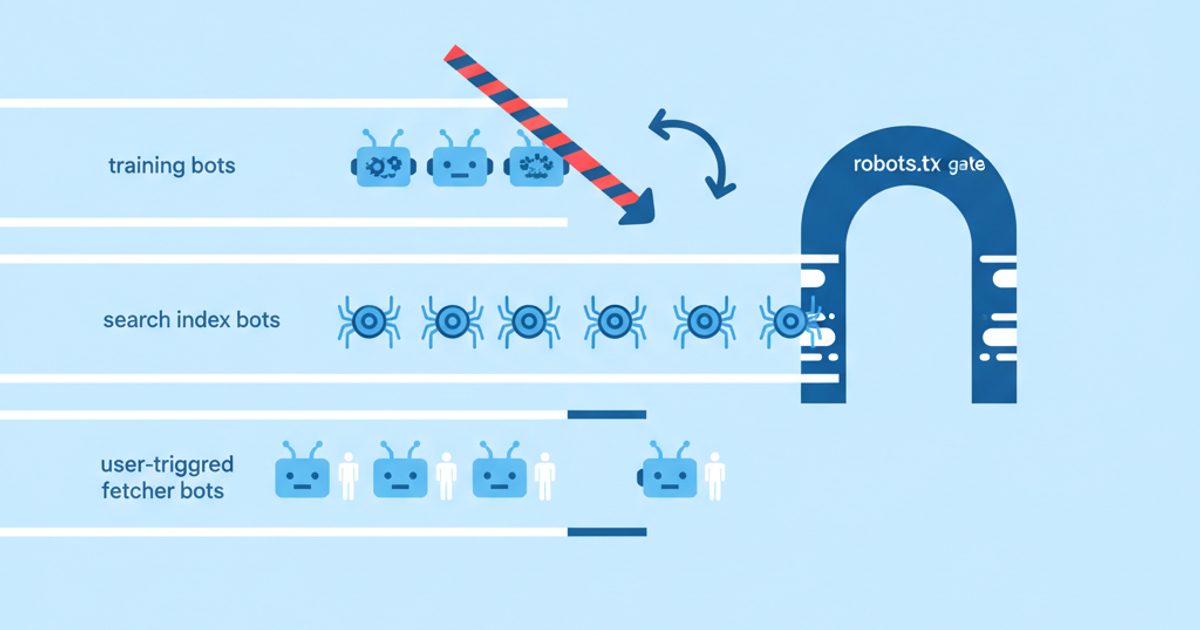
ИИ-краулеры — это автоматические боты ИИ-компаний, которые загружают веб-страницы для одной из трёх задач: собирают данные для обучения моделей (GPTBot, ClaudeBot), строят поисковый индекс, на который ссылаются ответы нейросетей (OAI-SearchBot, Claude-SearchBot, PerplexityBot), или загружают страницу в реальном времени, потому что пользователь спросил о ней ассистента (ChatGPT-User, Claude-User, Perplexity-User). Если заблокировать краулер для обучения, ваш контент не попадёт в будущие модели; если заблокировать поисковый краулер или бота, работающего по запросу пользователя, вы пропадёте из ИИ-ответов и цитирований. Всё решение сводится к этой разнице.
Это справочник, по которому можно сразу действовать. Каждый user agent ниже мы сверили с документацией самого оператора 18 октября 2026 года и дали ссылку на эту страницу. Кроме того, здесь есть матрица решений под разные бизнес-цели, готовые к копированию группы для robots.txt, способ проверки, который поддерживает каждый оператор (с датой, указанной внутри каждого опубликованного списка IP), и честный разбор того, почему JavaScript-аналитика не показывает большую часть трафика краулеров.
Коротко о главном
- Относите каждого ИИ-бота к одному из классов: обучение, поиск/индекс или по запросу пользователя. OpenAI, Anthropic, Amazon, Meta и Mistral публикуют отдельный токен для каждого класса, так что одного бота можно заблокировать, не трогая остальных.
- Блокировка GPTBot не убирает вас из поиска ChatGPT. По словам OpenAI, за это отвечает только OAI-SearchBot, а сайты, закрытые для OAI-SearchBot, всё равно могут появляться в виде навигационных ссылок.
- Google-Extended и Applebot-Extended — это управляющие токены, а не краулеры. В логах они не появляются никогда, а Google утверждает, что Google-Extended никак не влияет на Google Поиск, включая AI Overviews и AI Mode.
- Боты, работающие по запросу пользователя, могут игнорировать robots.txt намеренно: OpenAI, Perplexity, Google, Meta и Amazon прямо пишут об этом в документации. Если нужна жёсткая блокировка, используйте WAF.
- Большинство ИИ-краулеров не выполняют JavaScript, поэтому JS-тег аналитики их недосчитывается. Достоверный источник данных об активности краулеров — логи сервера или CDN.
- Проверяйте ботов через обратный DNS (Google, Apple, Common Crawl) или сверяйте IP с опубликованным оператором JSON-списком. Некоторым из этих списков уже несколько лет, так что скачивайте их заново по расписанию.
Что такое ИИ-краулеры и какие бывают три класса?
ИИ-краулер — это любой автоматический клиент, с помощью которого ИИ-компания запрашивает ваши страницы. Сегодня операторы разделяют своих ботов по назначению, и именно назначение определяет, чего вам будет стоить блокировка. Данные сети Cloudflare показывают, насколько перекошено это соотношение: за 12 месяцев до середины 2025 года 80 % ИИ-краулинга приходилось на обучение, 18 % на поиск и 2 % на действия пользователей, а в последние шесть месяцев этого периода доля обучения выросла до 82 %.
Краулеры для обучения
Эти краулеры собирают контент, который может использоваться для обучения или дообучения базовых моделей. Сюда относятся GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training и CCBot (открытый датасет Common Crawl, которым пользуются многие разработчики моделей). Блокировка этих ботов сигнализирует, что ваш будущий контент не должен попадать в обучающие выборки. Уже собранный контент она не удаляет и никак не влияет на то, может ли ИИ-поиск вас цитировать.
Поисковые и индексирующие краулеры
Поисковые краулеры строят индекс для извлечения данных, на котором основаны ИИ-ответы и на который ведут ссылки в цитатах. OAI-SearchBot (поиск ChatGPT), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index и DuckAssistBot созданы специально для ИИ. Googlebot, Bingbot и Applebot — классические поисковые краулеры, чей индекс теперь питает и ИИ-функции: Google AI Overviews и AI Mode, Microsoft Copilot и ответы Siri. Заблокировать поисковый краулер — дорогая ошибка: вы пропадаете из ответов, которые читают ваши покупатели. Если хотите разобраться, как используется один из таких индексов, читайте, как работает поиск ChatGPT.
Боты по запросу пользователя и агенты
Такие боты заходят на один конкретный URL, потому что человек попросил ассистента прочитать страницу, пересказать её или выполнить на ней действие. Сюда относятся ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User и MistralAI-User, а также браузерные агенты с цифровой подписью, например облачный браузер ChatGPT. Несколько операторов прямо указывают, что robots.txt на них может не распространяться, потому что запрос инициировал человек.
Управляющие токены, которые не являются краулерами
Два названия, которые есть в любом списке, сами ничего не загружают. Google-Extended — продуктовый токен robots.txt, который Google считывает во время обхода своими обычными user agent; он определяет, можно ли использовать контент для обучения будущих моделей Gemini и для grounding (обоснования ответов) в Gemini Apps и Vertex AI. Applebot-Extended делает то же самое для базовых моделей Apple. Ни одной из этих строк вы не найдёте в логах доступа, поэтому ситуация «я заблокировал Google-Extended, а трафик от Google всё равно идёт» — ожидаемое поведение.
Список ИИ-краулеров: все основные user agent, проверено 18 октября 2026 года
В таблице указан токен, который вы пишете в строке User-agent:, кто им управляет, его класс, что говорит о robots.txt документация самого оператора, как его проверить и какую официальную страницу мы сверяли. Пометка «по документации» означает, что колонка robots.txt пересказывает слова оператора; если документация молчит, мы так и пишем, а не гадаем.
| Токен | Оператор | Класс | Что делает | Robots.txt (по документации) | Как проверить | Официальная документация |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Обучение | Собирает контент, который может использоваться для обучения базовых моделей OpenAI | Да | gptbot.json | Краулеры OpenAI |
| OAI-SearchBot | OpenAI | Поиск | Показывает сайты в ответах поиска ChatGPT; не для обучения | Да, изменения вступают в силу примерно за 24 часа | searchbot.json | Краулеры OpenAI |
| ChatGPT-User | OpenAI | По запросу пользователя | Посещает страницы для действий пользователей в ChatGPT и Custom GPTs | Может не применяться | chatgpt-user.json | Краулеры OpenAI |
| OAI-AdsBot | OpenAI | Специальный | Проверяет посадочные страницы, отправленные как реклама в ChatGPT; не для обучения | Не указано; посещает только отправленные рекламные страницы | adsbot.json | Краулеры OpenAI |
| ClaudeBot | Anthropic | Обучение | Собирает контент, который может пойти на обучение моделей Claude | Да; поддерживает Crawl-delay | bots.json (общий) | Справочный центр Anthropic |
| Claude-SearchBot | Anthropic | Поиск | Индексирует контент, чтобы улучшить результаты поиска Claude | Да | bots.json (общий) | Справочный центр Anthropic |
| Claude-User | Anthropic | По запросу пользователя | Загружает страницы, когда пользователь Claude задаёт вопрос | Да, запрет отключает извлечение по запросам пользователей | bots.json (общий) | Справочный центр Anthropic |
| PerplexityBot | Perplexity | Поиск | Показывает сайты и ссылки на них в результатах Perplexity; не для обучения | Да, до 24 часов | perplexitybot.json | Краулеры Perplexity |
| Perplexity-User | Perplexity | По запросу пользователя | Посещает страницы, чтобы ответить на вопрос пользователя | Как правило, игнорирует | perplexity-user.json | Краулеры Perplexity |
| Googlebot | Поиск | Google Поиск, включая AI Overviews и AI Mode | Да, всегда при автоматическом обходе | Обратный DNS или common-crawlers.json | Стандартные краулеры Google | |
| Google-Extended | Управляющий токен | Обучение Gemini и grounding в Gemini Apps и Vertex AI | Только токен; собственного user agent нет | Неприменимо | Стандартные краулеры Google | |
| Google-CloudVertexBot | Поиск (по запросу владельца сайта) | Обходит сайты, владельцы которых создают на их основе агентов Vertex AI | Да | Обратный DNS или common-crawlers.json | Стандартные краулеры Google | |
| Google-Agent | Агент по запросу пользователя | Агенты на инфраструктуре Google, которые просматривают сайты и выполняют действия по запросу пользователя | Как правило, игнорирует (запрос пользователя) | user-triggered-agents.json; часть запросов подписана через Web Bot Auth | Сборщики Google по запросу пользователя | |
| Google-GeminiNotebook | По запросу пользователя | Загружает URL, которые пользователи добавляют как источники в Gemini Notebook (прежний агент Google-NotebookLM поддерживался до августа 2026 года) | Как правило, игнорирует (запрос пользователя) | JSON-списки сборщиков по запросу пользователя | Сборщики Google по запросу пользователя | |
| Bingbot | Microsoft | Поиск | Индекс Bing, на котором также основаны ответы Copilot | Да; использование в ИИ управляется метатегами noarchive/nocache на уровне страницы | bingbot.json или инструмент Bing Verify Bingbot | Блог Bing Webmaster |
| Applebot | Apple | Поиск (может использоваться и для обучения) | Поиск в Spotlight, Siri и Safari; данные также могут идти на обучение моделей Apple | Да; если Applebot не указан, следует правилам для Googlebot; игнорирует Crawl-delay | Обратный DNS (*.applebot.apple.com) или applebot.json | Об Applebot |
| Applebot-Extended | Apple | Управляющий токен | Исключает контент из обучения базовых моделей Apple | Только токен | Неприменимо | Об Applebot |
| Meta-ExternalAgent | Meta | Обучение | Обучение базовых ИИ-моделей или прямое индексирование контента | Да | User agent плюс опубликованные IP Meta | Веб-краулеры Meta |
| Meta-WebIndexer | Meta | Поиск | Улучшает результаты поиска Meta AI, чтобы Meta AI могла цитировать вас и ссылаться на вас | Да | User agent плюс опубликованные IP Meta | Веб-краулеры Meta |
| Meta-ExternalFetcher | Meta | По запросу пользователя | Загружает ссылки по запросу пользователя, в том числе для агентных задач | Может обходить | User agent плюс опубликованные IP Meta | Веб-краулеры Meta |
| Amazonbot | Amazon | Обучение | Улучшает продукты Amazon; может использоваться для обучения ИИ-моделей Amazon | Да (RFC 9309); игнорирует Crawl-delay | Страница с опубликованными IP | Amazonbot |
| Amzn-SearchBot | Amazon | Поиск | Поисковые сервисы, например Alexa; не для обучения | Да; если не указан, наследует правила для других поисковых ботов | Страница с опубликованными IP | Amazonbot |
| Amzn-User | Amazon | По запросу пользователя | Загружает актуальную информацию для запросов к Alexa; не для обучения | Может соблюдать не все директивы | Страница с опубликованными IP | Amazonbot |
| MistralAI-Training | Mistral | Обучение | Собирает датасеты для обучения моделей Mistral | Да, можно запретить | User agent | Краулеры Mistral |
| MistralAI-Index | Mistral | Поиск | Индексирует контент для поиска Mistral в Vibe; не для обучения | Да | mistralai-index-ips.json | Краулеры Mistral |
| MistralAI-User | Mistral | По запросу пользователя | Посещает страницы, когда пользователи Vibe задают вопрос | Да, определяет, на какие сайты могут попадать запросы пользователей | mistralai-user-ips.json | Краулеры Mistral |
| DuckAssistBot | DuckDuckGo | Поиск (в реальном времени) | Обходит страницы для ИИ-ответов DuckDuckGo; не для обучения | Да, вступает в силу через 72 часа | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Обучение (открытый датасет) | Формирует открытый корпус Common Crawl, который широко используется для обучения моделей | Да | Обратный DNS (*.crawl.commoncrawl.org, только IPv4) | CCBot |
Таблица снимает два вопроса. Во-первых, на текущей странице Anthropic перечислены ровно три бота: ClaudeBot, Claude-SearchBot и Claude-User. В старых списках до сих пор фигурируют «anthropic-ai» и «Claude-Web», которых на октябрь 2026 года в документации Anthropic нет. Во-вторых, номера версий у OpenAI меняются: в день нашей проверки примеры строк OpenAI содержали GPTBot/1.4 и OAI-SearchBot/1.4, поэтому ориентируйтесь на токен, а не на полную строку.
Боты без официальной документации
У некоторых ботов, которых вы увидите в логах, мы не нашли страницы оператора на 18 октября 2026 года. Самый известный из них — Bytespider от ByteDance; ещё один пример — агенты xAI, связанные с Grok. Сторонние каталоги расходятся в описании их поведения, поэтому в проверенную таблицу мы их не включили. При этом управляемый robots.txt от Cloudflare содержит запрет для Bytespider, а сама Cloudflare сообщала, что доля Bytespider в ИИ-краулинге упала с 14,1 % до 2,4 % с середины 2024 по середину 2025 года. Если какой-то из этих ботов для вас важен, закрепите свою политику правилом WAF, а не полагайтесь на robots.txt.
Соблюдают ли ИИ-краулеры robots.txt?
Задокументированные краулеры для обучения и поиска заявляют, что соблюдают; боты, работающие по запросу пользователя, часто прямо говорят, что нет; а robots.txt в любом случае не является средством контроля доступа. В самом стандарте, RFC 9309, сказано, что «эти правила не являются формой авторизации доступа». Он также разрешает краулерам кешировать ваш файл до 24 часов, поэтому каждый оператор называет задержку, прежде чем изменения вступят в силу.
Заявления о соблюдении правил — это не то же самое, что наблюдаемое поведение. В августе 2025 года Cloudflare опубликовала тест, в котором совершенно новые домены, запретившие обход полностью, всё равно подробно описывались в Perplexity. По данным Cloudflare, заявленный агент Perplexity-User делал 20–25 млн запросов в день, а незаявленный агент, маскирующийся под Chrome, — 3–6 млн, после чего Cloudflare исключила Perplexity из списка проверенных ботов. Это вывод одной компании об одном операторе, но он хорошо показывает, почему строка user agent сама по себе ничего не доказывает.
| Оператор | Через сколько применяются изменения robots.txt (по документации) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | Примерно через 24 часа | Не указано |
| Perplexity | До 24 часов | Не указано |
| Amazon | Примерно через 24 часа; может использовать кешированную копию давностью до 30 дней | Не поддерживается |
| Meta | До 24 часов | Не указано |
| DuckDuckGo (DuckAssistBot) | 72 часа | Не указано |
| Anthropic | Не указано | Поддерживается |
| Apple | Не указано | Не поддерживается |
Во что обходится блокировка каждого класса ИИ-краулеров?
Блокировка краулеров для обучения сегодня почти не сказывается на видимости; блокировка поисковых краулеров или ботов по запросу пользователя сразу стоит вам цитирований. В таблице каждому классу сопоставлены потери, которые описывают сами операторы.
| Если заблокировать... | Вы не попадёте в | Вы теряете | Вы по-прежнему видны в |
|---|---|---|---|
| Краулеры для обучения (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | Будущие обучающие датасеты этого оператора | Почти ничего в видимости на коротком горизонте; возможно, то, насколько хорошо будущие модели «знают» ваш бренд без поиска | Поиске ChatGPT, поиске Claude, Perplexity, Google Поиске и AI Overviews — если их поисковые боты разрешены |
| ИИ-поисковые краулеры (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | Индекс извлечения данных этой платформы | Цитирования и ссылки в ответах этой платформы; OpenAI оставляет только навигационные ссылки | Классических поисковиках, если вы не заблокировали и их |
| Боты по запросу пользователя (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | Загрузки в реальном времени по запросу пользователей — там, где оператор соблюдает запрет | Ответы, когда пользователь вставляет ваш URL или спрашивает о нём; агентные задачи вроде оформления заказа или бронирования | Ответах на основе индекса, если поисковый бот разрешён |
| Googlebot | Google Поиск целиком | Органические позиции, AI Overviews и AI Mode — всё сразу | Нигде в Google; почти никогда это не то, что вам нужно |
Важен и масштаб этого обмена. Cloudflare измерила, сколько страниц каждая ИИ-платформа обходит в расчёте на одного посетителя, которого она возвращает на сайт: в июле 2025 года у Anthropic было около 38 000 обходов на одного приведённого посетителя, у Perplexity — 194. Именно этими соотношениями издатели обосновывают блокировку краулеров для обучения при открытом доступе для поисковых краулеров.
Каких ИИ-краулеров пускать, а каких блокировать? Матрица решений под бизнес-цели
Отталкивайтесь от того, что вы продаёте. Если рекомендация ИИ-ассистента может принести вам клиента, пускайте всех поисковых краулеров и ботов по запросу пользователя, а обучение рассматривайте как отдельное, менее важное решение.
| Ваша ситуация | Краулеры для обучения | Поисковые краулеры | Боты по запросу пользователя и агенты | Почему |
|---|---|---|---|---|
| B2B SaaS, агентства, локальные услуги | Разрешить (или заблокировать, потери невелики) | Разрешить | Разрешить | Покупатели составляют шорт-лист поставщиков по ИИ-ответам; присутствие в знаниях модели также помогает получать упоминания без подсказки |
| Электронная коммерция | На ваше усмотрение | Разрешить | Разрешить и внести подписанных агентов в список разрешённых в WAF | Ответы о покупках цитируют карточки товаров, а агентам нужен доступ к корзине и оформлению заказа |
| СМИ и издатели, живущие за счёт рекламы | Заблокировать | Разрешить или заблокировать на страницах с рекламой | Решать отдельно для каждого оператора | Контент — это и есть продукт; цитирования всё же возвращают часть читателей |
| Документация для разработчиков и open-source-проекты | Разрешить | Разрешить | Разрешить | Разработчики спрашивают ассистентов, как пользоваться вашим API; точные знания модели снижают нагрузку на поддержку |
| Платный или лицензируемый контент | Заблокировать | Разрешить только индексные страницы | Заблокировать через WAF, если этого требует лицензия | Анонсы пусть цитируются, а полный текст остаётся закрытым |
| Тестовые среды, интранеты, закрытые приложения | Заблокировать | Заблокировать | Заблокировать | Используйте аутентификацию; robots.txt — это просьба, а не замок |
| Сервер под нагрузкой от краулеров | Ограничить частоту или заблокировать | Разрешить, ограничить частоту на уровне CDN | Разрешить | Снимайте нагрузку на периметре, а не ценой цитирований |
Как в robots.txt заблокировать ИИ-краулеры для обучения, но оставить ИИ-поиск?
Выделите каждому токену для обучения отдельную группу с Disallow: /, а поисковые краулеры оставьте под действием ваших обычных правил. Краулер подчиняется только самой конкретной группе, в которой он назван, поэтому запрет на обучение никогда не перекинется на поисковых ботов.
Фрагмент 1: блокируем обучение, оставляем ИИ-поиск и ботов по запросу пользователя
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 позволяет нескольким строкам User-agent делить одну группу, а сопоставление не зависит от регистра. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot и Bingbot попадают в группу * и остаются разрешены.
Фрагмент 2: явно открываем доступ для ИИ-поиска
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Если явно назвать поисковых ботов, вы защитите себя от будущего общего правила, которое напишет кто-то другой, — например, плагина, добавляющего User-agent: * с Disallow: /. Закрытые пути запрещайте прямо внутри группы, потому что именованная группа для этого бота заменяет группу *, а не дополняет её.
Фрагмент 3: три ловушки, которые ломают реальные файлы
- Applebot наследует правила Googlebot. Apple пишет, что если в вашем файле не упомянут Applebot, но упомянут Googlebot, Applebot следует группе для Googlebot. Блокировка, рассчитанная только на Googlebot, может незаметно убрать вас из Siri и Spotlight.
- Amzn-SearchBot наследует правила других поисковых ботов, если он не указан явно, — так пишет Amazon. Назовите его, если хотите другого результата.
- Поддоменам нужен собственный файл. И Anthropic, и Amazon сообщают, что читают robots.txt для каждого хоста отдельно, поэтому
docs.example.comнужна своя копия.
Собрать и проверить такие группы можно в бесплатном генераторе robots.txt от AI Rank Lab, а в наших шаблонах robots.txt для ИИ-краулеров подробнее разобраны конфигурации с полным и выборочным доступом.
Как проверить, что ИИ-краулер настоящий, а не подделка?
Никогда не доверяйте одному лишь user agent: кто угодно может отправить «GPTBot» в заголовке, а Common Crawl прямо предупреждает на своей странице, что краулеры выдают себя за CCBot. Операторы поддерживают три способа проверки, и какой из них использовать, зависит от оператора.
- Обратный DNS, затем прямой DNS. Выполните
hostдля IP из вашего лога, убедитесь, что имя хоста заканчивается на домен оператора, затем выполнитеhostдля этого имени и проверьте, что он возвращает тот же IP. Google описывает этот способ дляgooglebot.com,google.comиgoogleusercontent.comв своём руководстве по проверке; Apple использует*.applebot.apple.com, Common Crawl —*.crawl.commoncrawl.org(только IPv4). - Сверьте IP с опубликованным списком оператора. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral и Amazon публикуют диапазоны IP. Для OpenAI, Anthropic и Perplexity это единственный способ, поскольку шаблон обратного DNS они не документируют.
- Проверьте криптографическую подпись (Web Bot Auth). Облачный браузер ChatGPT подписывает свои запросы по RFC 9421 с заголовком
Signature-Agentсо значением"https://chatgpt.com". Google тестирует тот же черновик IETF для части запросов Google-Agent с подписьюhttps://agent.bot.goog, а на его странице о Web Bot Auth рекомендовано сохранять проверку по IP как запасной вариант, потому что подписан не каждый запрос.
# Обратный, затем прямой DNS-запрос (пример для Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# Проверка по списку IP для поискового краулера OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
Насколько свежие опубликованные списки IP?
18 октября 2026 года мы скачали все опубликованные файлы с IP ИИ-краулеров и посмотрели поле creationTime, которое каждый оператор записывает в файл. Старая дата может означать просто то, что диапазоны не менялись, но она подсказывает, насколько можно доверять жёстко прописанному списку разрешённых адресов, и показывает, какие списки не могут учесть трафик, который оператор никогда не заявлял.
| Опубликованный список | creationTime в файле | Префиксы IPv4 / IPv6 |
|---|---|---|
| Стандартные краулеры Google (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Агенты Google по запросу пользователя (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (все три бота, один список) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Отсюда два практических урока. Списки Google и список ChatGPT-User от OpenAI изменились за последние две недели, так что список разрешённых адресов в файрволе, скопированный летом, скорее всего, уже устарел — загружайте эти файлы ежедневно или еженедельно. Кроме того, Anthropic предупреждает, что блокировка её IP «может работать некорректно или не гарантировать отказ на постоянной основе», потому что мешает Anthropic прочитать ваш robots.txt. Поэтому для отказа используйте robots.txt, а IP — только для проверки.
Как увидеть активность ИИ-краулеров: логи сервера или JavaScript-теги?
Для краулеров используйте логи сервера или CDN, а JavaScript-аналитику — для живых посетителей, которые приходят из ИИ-ассистентов. JS-тег срабатывает, только когда что-то выполняет JavaScript страницы, а большинство ИИ-краулеров этого не делают. Анализ сети Vercel показал, что ни один из крупных ИИ-краулеров не рендерил JavaScript: краулеры ChatGPT и Claude загружали JS-файлы (11,50 % и 23,84 % их запросов), но не выполняли их. Исключениями были Gemini, который использует рендеринг Googlebot, и Applebot. Это исследование декабря 2024 года, так что перепроверьте на своём сайте, но оно совпадает с тем, что видим мы.
Google Analytics расширяет этот разрыв намеренно. GA4 автоматически исключает трафик известных ботов и пауков, и это нельзя ни отключить, ни посмотреть, сколько трафика было отброшено. GA4 — правильный инструмент для реферального трафика из ИИ, о котором мы пишем в материале как отслеживать реферальный трафик из ИИ в GA4, и неподходящий — для подсчёта краулеров.
Ту же картину мы видим в собственных данных отслеживания AI Rank Lab. Наш JavaScript-тег надёжно фиксирует людей, которые переходят из ChatGPT, Gemini, Perplexity и Claude, но видит лишь небольшую и нерепрезентативную часть трафика краулеров, поэтому мы не публикуем по нему цифры о краулерах.
Проверка логов за пять минут
- Скачайте сырые логи доступа за один день у хостинга или CDN (Nginx и Apache записывают user agent в стандартном формате combined).
- Посчитайте запросы для каждого ИИ-токена:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Для самых активных токенов проверьте коды ответа. Сплошные 403 или 429 обычно означают, что правило WAF или CDN блокирует бота, которого разрешает ваш robots.txt.
- Прежде чем доверять каким-либо цифрам, проверьте выборку IP описанными выше способами.
- Посмотрите, какие URL запрашивают поисковые боты. Если OAI-SearchBot или Claude-SearchBot загружают только главную страницу, займитесь внутренней перелинковкой и картой сайта.
Инструменты, которые показывают активность ИИ-краулеров
Раскрытие информации: AI Rank Lab — наш продукт. Мы ставим его первым, потому что это наш сайт, и оцениваем все инструменты ниже по одним и тем же критериям.
- AI Rank Lab — отслеживание ИИ-ботов фиксирует переходы из ИИ-ассистентов и те визиты ИИ-ботов, которые видит его тег, постранично и рядом с отслеживанием вашей ИИ-видимости и цитирований. По причинам, описанным выше, для полного подсчёта краулеров дополняйте его логами.
- Cloudflare AI Crawl Control — если ваш сайт проксируется через Cloudflare, это самая полная картина краулеров из доступных, потому что сервис видит каждый запрос на периметре, включая ботов, которые никогда не выполняют JavaScript. Он также показывает соблюдение robots.txt по каждому краулеру.
- Анализаторы логов, например Log File Analyser от Screaming Frog или GoAccess, — работают с сырыми логами любого хостинга и отлично подходят для разовых аудитов.
- Сырые логи плюс grep из примера выше — бесплатно, точно и служит эталоном, с которым должны сходиться все остальные инструменты.
Более подробный порядок мониторинга трёх крупнейших ботов описан в нашем руководстве по мониторингу GPTBot, ClaudeBot и PerplexityBot.
Как Cloudflare и другие CDN управляют ИИ-ботами?
CDN принудительно применяют на периметре сети то, о чём robots.txt может только попросить. AI Crawl Control от Cloudflare доступен на всех тарифах: он показывает, какие ИИ-сервисы обращаются к вашему сайту, позволяет разрешать или блокировать каждый краулер, отслеживает нарушения robots.txt и предлагает оплату за обход (pay per crawl) в закрытой бете.
Политики Cloudflare для ИИ-ботов теперь используют то же деление на три класса, что и эта статья. Её настройки Block AI Bots предлагают отдельные пресеты для Search, Agent и Training, у каждого из которых есть варианты «блокировать на всех страницах», «блокировать на страницах с рекламой» и «разрешить». Согласно документации, с 15 сентября 2026 года новые домены получают обновлённые настройки по умолчанию: боты Training и Agent блокируются на страницах с рекламой, Search разрешён, а краулеры смешанного назначения, совмещающие поиск и обучение, блокируются любой блокировкой обучения. Если вы подключили сайт к Cloudflare после этой даты и не понимаете, почему ChatGPT-User или Claude-User получают 403 в вашем блоге, сначала проверьте эту настройку.
Cloudflare может и сам управлять вашим robots.txt. При включённой функции Bot Preference Sync её управляемый robots.txt добавляет перед вашими существующими правилами группы с запретом для Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot и meta-externalagent, а также строку Content Signals (search=yes, ai-train=no). Content Signals — предложенный Cloudflare словарь (search, ai-input, ai-train), который сообщает, как можно использовать контент после загрузки; соблюдать ли эти сигналы, решает каждый оператор сам.
Другие провайдеры поддерживают ту же схему. В документации Perplexity есть рекомендации по настройке WAF в Cloudflare и AWS WAF на основе её списков IP, а справочный центр OpenAI показывает, как внести её подписанный облачный браузер в список разрешённых в Akamai (имя бота «ChatGPT Agent») и Cloudflare (ID обнаружения 129220581). Какой бы CDN вы ни использовали, порядок действий одинаков: примите решение для каждого класса, выразите его в robots.txt, применяйте принудительно на периметре только там, где нужна жёсткая блокировка, и перепроверяйте логи после любого изменения в CDN.
Google и Bing: два особых случая
Влияет ли блокировка Google-Extended на Google Поиск или AI Overviews?
Нет. Google заявляет, что Google-Extended «не влияет на включение сайта в Google Поиск и не используется как фактор ранжирования». В документации по ИИ-функциям прямо сказано, что для Поиска, включая AI Overviews и AI Mode, управляющим механизмом служат правила robots.txt для Googlebot, а ограничить показываемое можно с помощью nosnippet, data-nosnippet, max-snippet или noindex. Google-Extended отвечает за обучение моделей Gemini и grounding в Gemini Apps и Vertex AI, которые существуют отдельно от Поиска.
Как управлять тем, использует ли Microsoft Copilot ваш контент?
Отдельного токена ИИ-краулера у Microsoft нет: обход выполняет Bingbot, а использование в ИИ вы контролируете метатегами robots на уровне страницы. Самые свежие официальные рекомендации, которые мы нашли, — анонс команды Bing 2023 года, написанный, когда Copilot ещё назывался Bing Chat: контент с тегом noarchive не включается в чат-ответы Bing, на него там не ставятся ссылки, и он не используется для обучения базовых моделей Microsoft; контент с тегом nocache может показываться только с URL, заголовком и сниппетом; контент без обоих тегов может использоваться полностью. Ни один из тегов не убирает вас из обычной выдачи Bing. Блокировка Bingbot в robots.txt убрала бы вас и из поиска Bing, поэтому используйте метатеги.
Ограничения и как мы проверяли
18 октября 2026 года мы прочитали страницу о краулерах каждого перечисленного выше оператора, скачали все опубликованные списки IP и записали значение creationTime внутри каждого файла. Справочную страницу Microsoft о краулерах, которая работает только на JavaScript, отрендерить не удалось, поэтому строка о Bingbot опирается на блог Bing Webmaster, инструмент Verify Bingbot и опубликованный Microsoft файл bingbot.json. Колонки о robots.txt пересказывают слова каждого оператора, а не то, что мы измерили самостоятельно; выводы Cloudflare о Perplexity — главное публичное свидетельство того, что одно может расходиться с другим. Операторы часто переименовывают и добавляют ботов (например, Google заменил токен сборщика Google-NotebookLM на Google-GeminiNotebook), поэтому считайте любой список, включая этот, точным на дату проверки.
Хотите понять, приносит ли ваша политика для краулеров реальные цитирования? AI Rank Lab отслеживает ваши упоминания и цитируемые страницы в ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews и AI Mode — рядом с реферальным трафиком, который приносят вам эти ответы.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


