



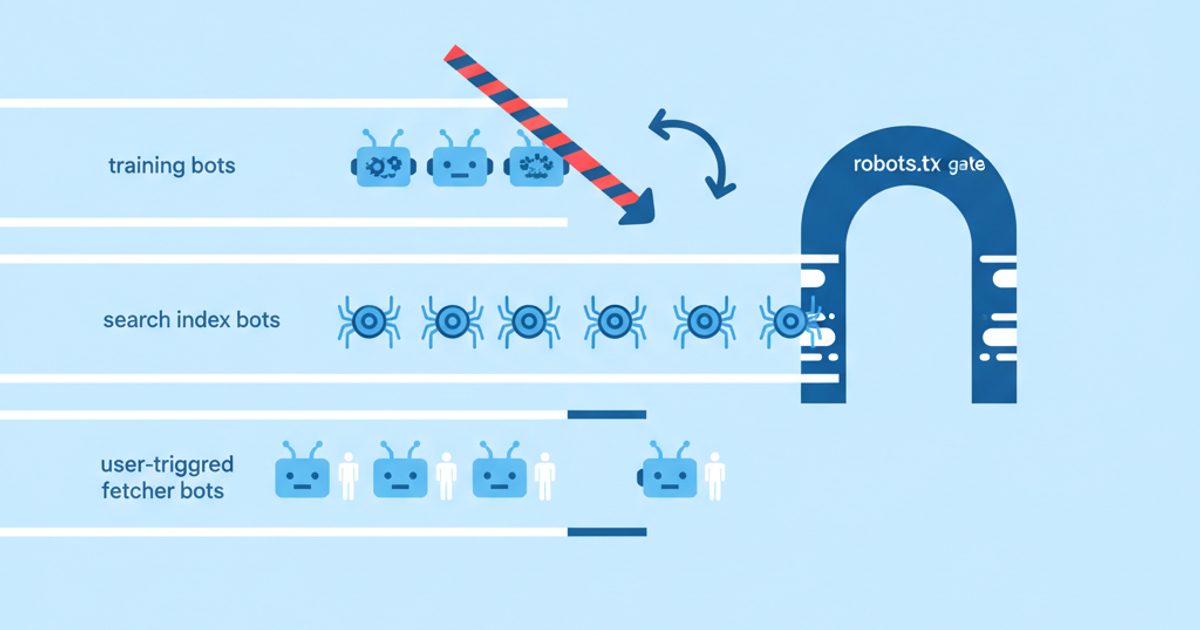
AI 爬虫是 AI 公司运营的自动化机器人,它们抓取网页无非为了三件事之一:为模型收集训练数据(GPTBot、ClaudeBot),为 AI 回答所引用的搜索索引建库(OAI-SearchBot、Claude-SearchBot、PerplexityBot),或者因为用户向 AI 助手问到某个页面而实时抓取它(ChatGPT-User、Claude-User、Perplexity-User)。屏蔽训练爬虫,你的内容就不会进入未来的模型;屏蔽搜索爬虫或用户触发的抓取器,你就会从 AI 回答和引用中消失。整个决策的关键就在这一点区别上。
这是一份可以直接照着操作的参考手册。下面每一个 User-Agent 都在 2026 年 10 月 18 日对照了运营方自己的官方文档,并附上了文档链接。你还会看到:按业务目标划分的决策矩阵、可直接复制的 robots.txt 规则组、每家运营方支持的验证方法(附每份公开 IP 列表里标注的日期),以及一个坦诚的分析:为什么 JavaScript 统计工具看不到大部分爬虫流量。
核心要点
- 把每个 AI 机器人归入三类之一:训练、搜索/索引或用户触发。OpenAI、Anthropic、Amazon、Meta 和 Mistral 为每一类都发布了单独的标识,所以你可以只屏蔽其中一类而不影响其他。
- 屏蔽 GPTBot 不会让你从 ChatGPT 搜索中消失。OpenAI 表示只有 OAI-SearchBot 控制这一点,而且即使屏蔽了 OAI-SearchBot,网站仍可能以导航链接的形式出现。
- Google-Extended 和 Applebot-Extended 是控制标识,不是爬虫。它们永远不会出现在你的日志里。Google 明确表示 Google-Extended 对 Google 搜索(包括 AI Overviews 和 AI Mode)没有任何影响。
- 用户触发的抓取器在设计上就可能不遵守 robots.txt:OpenAI、Perplexity、Google、Meta 和 Amazon 都在文档里这么写了。如果需要硬性拦截,请用 WAF。
- 大多数 AI 爬虫不执行 JavaScript,所以 JS 统计代码会严重低估它们。爬虫活动要以服务器或 CDN 日志为准。
- 通过反向 DNS(Google、Apple、Common Crawl)或把 IP 与运营方公开的 JSON 列表比对来验证机器人。其中有些列表已经好几年没更新,所以要定期重新下载。
什么是 AI 爬虫?分为哪三类?
AI 爬虫是指 AI 公司用来请求你网页的任何自动化客户端。如今各家运营方会按用途拆分自己的机器人,而用途决定了屏蔽它要付出什么代价。Cloudflare 的网络数据显示,三类爬虫的比例非常悬殊:截至 2025 年年中的 12 个月里,80% 的 AI 抓取用于训练,18% 用于搜索,2% 用于用户操作,而在这段时间的最近六个月里,训练占比上升到了 82%。
训练爬虫
训练爬虫收集的内容可能被用于训练或微调基础模型。GPTBot、ClaudeBot、Meta-ExternalAgent、Amazonbot、MistralAI-Training 和 CCBot(Common Crawl 的开放数据集,被许多模型开发者使用)都属于这一类。屏蔽它们相当于发出信号:你今后的内容不应进入训练集。但这不会删除已经收集的内容,也不影响 AI 搜索能否引用你。
搜索与索引爬虫
搜索爬虫负责构建检索索引,AI 回答以它为依据,引用链接也指回其中的页面。OAI-SearchBot(ChatGPT 搜索)、Claude-SearchBot、PerplexityBot、Meta-WebIndexer、Amzn-SearchBot、MistralAI-Index 和 DuckAssistBot 是 AI 专用的搜索爬虫。Googlebot、Bingbot 和 Applebot 是传统搜索爬虫,但它们的索引现在也为 AI 功能提供数据:Google AI Overviews(AI 概览)和 AI Mode(AI 模式)、Microsoft Copilot,以及 Siri 的回答。屏蔽搜索爬虫是代价最高的错误,因为它会让你从买家正在阅读的回答中消失。想了解这类索引具体是怎么被使用的,可以看看ChatGPT 搜索的工作原理。
用户触发的抓取器和智能体
用户触发的抓取器只访问单个 URL,原因是有人让 AI 助手去读取、总结或处理这个页面。ChatGPT-User、Claude-User、Perplexity-User、Google-Agent、Meta-ExternalFetcher、Amzn-User 和 MistralAI-User 都属于这一类,此外还有带签名的浏览器智能体,比如 ChatGPT 的 Cloud browser。有几家运营方明确表示,robots.txt 可能不适用于这类抓取,因为请求是由真人发起的。
不是爬虫的控制标识
每份清单上都有两个名字,它们自己从来不抓取任何内容。Google-Extended 是一个 robots.txt 产品标识,Google 用常规 User-Agent 抓取时会读取它;它控制内容能否用于训练未来的 Gemini 模型,以及能否用于 Gemini Apps 和 Vertex AI 中的事实依据(grounding)。Applebot-Extended 对 Apple 的基础模型起同样的作用。你在访问日志里找不到这两个字符串,所以“我屏蔽了 Google-Extended,却还能看到 Google 的流量”是完全正常的现象。
AI 爬虫清单:所有主流 User-Agent,2026 年 10 月 18 日核实
下表列出了你要写在 User-agent: 行里的标识、运营方、所属类别、运营方官方文档对 robots.txt 的说法、验证方式,以及我们核对过的官方页面。“据文档”表示 robots.txt 一栏是对运营方原话的转述;如果文档里没写,我们就直接说明没写,而不是猜测。
| 标识 | 运营方 | 类别 | 用途 | Robots.txt(据文档) | 验证方式 | 官方文档 |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | 训练 | 抓取可能用于训练 OpenAI 基础模型的内容 | 遵守 | gptbot.json | OpenAI 爬虫 |
| OAI-SearchBot | OpenAI | 搜索 | 让网站出现在 ChatGPT 搜索回答中;不用于训练 | 遵守,修改约 24 小时后生效 | searchbot.json | OpenAI 爬虫 |
| ChatGPT-User | OpenAI | 用户触发 | 为 ChatGPT 和 Custom GPTs 中的用户操作访问页面 | 可能不适用 | chatgpt-user.json | OpenAI 爬虫 |
| OAI-AdsBot | OpenAI | 特殊 | 检查作为 ChatGPT 广告提交的落地页;不用于训练 | 未说明;只访问提交的广告页面 | adsbot.json | OpenAI 爬虫 |
| ClaudeBot | Anthropic | 训练 | 收集可能用于 Claude 模型训练的内容 | 遵守;支持 Crawl-delay | bots.json(共用) | Anthropic 帮助中心 |
| Claude-SearchBot | Anthropic | 搜索 | 为改进 Claude 的搜索结果而索引内容 | 遵守 | bots.json(共用) | Anthropic 帮助中心 |
| Claude-User | Anthropic | 用户触发 | Claude 用户提问时抓取页面 | 遵守,禁用后会停止用户发起的检索 | bots.json(共用) | Anthropic 帮助中心 |
| PerplexityBot | Perplexity | 搜索 | 在 Perplexity 结果中展示并链接网站;不用于训练 | 遵守,最长 24 小时生效 | perplexitybot.json | Perplexity 爬虫 |
| Perplexity-User | Perplexity | 用户触发 | 为回答用户问题而访问页面 | 通常忽略 | perplexity-user.json | Perplexity 爬虫 |
| Googlebot | 搜索 | Google 搜索,包括 AI Overviews 和 AI Mode | 遵守,自动抓取时始终遵守 | 反向 DNS 或 common-crawlers.json | Google 常用爬虫 | |
| Google-Extended | 控制标识 | Gemini 训练,以及 Gemini Apps 和 Vertex AI 中的 grounding | 仅为标识;没有自己的 User-Agent | 不适用 | Google 常用爬虫 | |
| Google-CloudVertexBot | 搜索(应站长请求) | 抓取站长在其上构建 Vertex AI Agents 的网站 | 遵守 | 反向 DNS 或 common-crawlers.json | Google 常用爬虫 | |
| Google-Agent | 用户触发的智能体 | 运行在 Google 基础设施上、按用户请求浏览和执行操作的智能体 | 通常忽略(用户触发) | user-triggered-agents.json;部分请求使用 Web Bot Auth 签名 | Google 用户触发的抓取器 | |
| Google-GeminiNotebook | 用户触发 | 抓取用户在 Gemini Notebook 中添加为来源的 URL(旧标识 Google-NotebookLM,支持到 2026 年 8 月) | 通常忽略(用户触发) | 用户触发抓取器的 JSON 列表 | Google 用户触发的抓取器 | |
| Bingbot | Microsoft | 搜索 | Bing 索引,同时也是 Copilot 回答的依据 | 遵守;AI 用途通过页面级 noarchive/nocache 控制 | bingbot.json 或 Bing 的 Verify Bingbot 工具 | Bing 网站管理员博客 |
| Applebot | Apple | 搜索(也可能用于训练) | Spotlight、Siri 和 Safari 搜索;数据也可能用于训练 Apple 模型 | 遵守;若未点名 Applebot 则沿用 Googlebot 规则;忽略 Crawl-delay | 反向 DNS(*.applebot.apple.com)或 applebot.json | 关于 Applebot |
| Applebot-Extended | Apple | 控制标识 | 让内容不参与 Apple 基础模型训练 | 仅为标识 | 不适用 | 关于 Applebot |
| Meta-ExternalAgent | Meta | 训练 | 训练基础 AI 模型或直接索引内容 | 遵守 | User-Agent 加 Meta 公开的 IP | Meta 网络爬虫 |
| Meta-WebIndexer | Meta | 搜索 | 改进 Meta AI 搜索结果,让 Meta AI 能引用并链接你 | 遵守 | User-Agent 加 Meta 公开的 IP | Meta 网络爬虫 |
| Meta-ExternalFetcher | Meta | 用户触发 | 应用户请求抓取链接,包括智能体任务 | 可能绕过 | User-Agent 加 Meta 公开的 IP | Meta 网络爬虫 |
| Amazonbot | Amazon | 训练 | 改进 Amazon 产品;可能用于训练 Amazon AI 模型 | 遵守(RFC 9309);忽略 Crawl-delay | 公开的 IP 页面 | Amazonbot |
| Amzn-SearchBot | Amazon | 搜索 | Alexa 等搜索体验;不用于训练 | 遵守;若未点名则沿用给其他搜索机器人的规则 | 公开的 IP 页面 | Amazonbot |
| Amzn-User | Amazon | 用户触发 | 为 Alexa 查询抓取实时信息;不用于训练 | 可能不遵守所有指令 | 公开的 IP 页面 | Amazonbot |
| MistralAI-Training | Mistral | 训练 | 构建用于训练 Mistral 模型的数据集 | 遵守,可以 Disallow | User-Agent | Mistral 爬虫 |
| MistralAI-Index | Mistral | 搜索 | 为 Vibe 中的 Mistral 搜索索引内容;不用于训练 | 遵守 | mistralai-index-ips.json | Mistral 爬虫 |
| MistralAI-User | Mistral | 用户触发 | Vibe 用户提问时访问页面 | 遵守,决定用户请求能访问哪些网站 | mistralai-user-ips.json | Mistral 爬虫 |
| DuckAssistBot | DuckDuckGo | 搜索(实时) | 为 DuckDuckGo 的 AI 辅助回答抓取页面;不用于训练 | 遵守,72 小时后生效 | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | 训练(开放数据集) | 构建被广泛用于模型训练的开放 Common Crawl 语料库 | 遵守 | 反向 DNS(*.crawl.commoncrawl.org,仅 IPv4) | CCBot |
这张表厘清了两件事。第一,Anthropic 当前页面只列出了三个机器人:ClaudeBot、Claude-SearchBot 和 Claude-User。一些旧清单里还有“anthropic-ai”和“Claude-Web”,但截至 2026 年 10 月,它们已不在 Anthropic 的文档中。第二,OpenAI 的版本号会变:我们核对当天,OpenAI 的示例字符串显示的是 GPTBot/1.4 和 OAI-SearchBot/1.4,所以匹配时只看标识,千万不要匹配完整字符串。
没有官方文档的机器人
你在日志里会看到一些机器人,但截至 2026 年 10 月 18 日,我们找不到它们运营方的说明页面。最出名的是字节跳动的 Bytespider,xAI 与 Grok 相关的智能体也是一例。第三方目录对它们行为的描述互相矛盾,所以我们没有把它们放进已核实的表格。Cloudflare 托管的 robots.txt 确实包含针对 Bytespider 的 disallow 规则,Cloudflare 还报告称,从 2024 年年中到 2025 年年中,Bytespider 在 AI 抓取中的占比从 14.1% 降到了 2.4%。如果这些机器人对你很重要,请用 WAF 规则来执行你的策略,而不是只依赖 robots.txt。
AI 爬虫会遵守 robots.txt 吗?
有文档的训练爬虫和搜索爬虫都说会遵守;用户触发的抓取器往往说不一定;而 robots.txt 从来都不是访问控制。标准本身 RFC 9309 就写明:“these rules are not a form of access authorization”(这些规则并不是一种访问授权)。它还允许爬虫把你的文件缓存最长 24 小时,这也是为什么每家运营方都会说明修改需要一段时间才能生效。
声称遵守和实际行为不是一回事。2025 年 8 月,Cloudflare 发布了一项测试:一批全新注册、禁止一切抓取的域名,仍然被 Perplexity 详细地描述了出来。Cloudflare 表示,它观察到一个公开声明的 Perplexity-User 代理每天发出 2,000 万至 2,500 万次请求,另一个未声明、伪装成 Chrome 的代理每天发出 300 万至 600 万次,随后把 Perplexity 从已验证机器人名单中移除。这只是一家厂商针对一家运营方的发现,但足以说明:单凭 User-Agent 字符串什么也证明不了。
| 运营方 | robots.txt 修改多久生效(据文档) | Crawl-delay |
|---|---|---|
| OpenAI(OAI-SearchBot) | 约 24 小时 | 未说明 |
| Perplexity | 最长 24 小时 | 未说明 |
| Amazon | 约 24 小时;可能使用最长 30 天前的缓存副本 | 不支持 |
| Meta | 最长 24 小时 | 未说明 |
| DuckDuckGo(DuckAssistBot) | 72 小时 | 未说明 |
| Anthropic | 未说明 | 支持 |
| Apple | 未说明 | 不支持 |
屏蔽每一类 AI 爬虫分别要付出什么代价?
屏蔽训练爬虫,眼下对曝光几乎没有影响;屏蔽搜索爬虫或用户触发的抓取器,会立刻让你失去引用。下表把每一类爬虫和运营方自己描述的代价一一对应起来。
| 如果你屏蔽…… | 你的内容不会进入 | 你会失去 | 你仍会出现在 |
|---|---|---|---|
| 训练爬虫(GPTBot、ClaudeBot、Meta-ExternalAgent、Amazonbot、CCBot、Google-Extended、Applebot-Extended) | 该运营方未来的训练数据集 | 短期曝光几乎不受影响;可能影响未来模型在不搜索的情况下对你品牌的“了解”程度 | ChatGPT 搜索、Claude 搜索、Perplexity、Google 搜索和 AI Overviews,前提是它们的搜索机器人被放行 |
| AI 搜索爬虫(OAI-SearchBot、Claude-SearchBot、PerplexityBot、Meta-WebIndexer、Amzn-SearchBot、MistralAI-Index、DuckAssistBot) | 该引擎的检索索引 | 该引擎回答中的引用和链接;OpenAI 只保留导航链接 | 传统搜索引擎,除非你连它们也屏蔽了 |
| 用户触发的抓取器(ChatGPT-User、Claude-User、Perplexity-User、MistralAI-User) | 用户发起的实时抓取(在运营方遵守规则的情况下) | 用户粘贴或询问你的 URL 时的回答;结账、预订等智能体任务 | 基于索引的回答,前提是搜索机器人被放行 |
| Googlebot | 整个 Google 搜索 | 自然排名、AI Overviews 和 AI Mode 全部一起失去 | 在 Google 上什么都没有;这几乎从来不是你想要的结果 |
交换的规模同样重要。Cloudflare 统计了每个 AI 平台每带回一个访客要抓取多少页面:2025 年 7 月,Anthropic 约为每个引荐访客 38,000 次抓取,Perplexity 为 194 次。出版方主张屏蔽训练爬虫、同时开放搜索爬虫,背后的经济账就是这些比例。
哪些 AI 爬虫该放行,哪些该屏蔽?按业务目标划分的决策矩阵
先从你卖什么出发。如果被 AI 助手推荐能为你带来客户,就放行所有搜索爬虫和用户触发的抓取器,把训练当成一个单独的、次要的决定。
| 你的情况 | 训练爬虫 | 搜索爬虫 | 用户抓取器和智能体 | 原因 |
|---|---|---|---|---|
| B2B SaaS、代理机构、本地服务 | 放行(或屏蔽,代价很小) | 放行 | 放行 | 买家在 AI 回答里筛选供应商;进入模型知识也有助于获得主动提及 |
| 电商 | 自行决定 | 放行 | 放行,并在 WAF 中把带签名的智能体加入白名单 | 购物类回答会引用商品页,智能体也需要访问购物车和结账页 |
| 新闻和靠广告盈利的出版方 | 屏蔽 | 放行,或在广告页面上屏蔽 | 按运营方逐一决定 | 内容本身就是产品;引用仍能带回一部分读者 |
| 开发者文档和开源项目 | 放行 | 放行 | 放行 | 开发者会问 AI 助手怎么用你的 API;准确的模型知识能减轻支持压力 |
| 付费墙或授权内容 | 屏蔽 | 只放行索引页 | 如授权要求,用 WAF 屏蔽 | 让摘要可被引用,把全文挡在外面 |
| 测试环境、内网、私有应用 | 屏蔽 | 屏蔽 | 屏蔽 | 使用身份验证;robots.txt 只是请求,不是锁 |
| 服务器承受抓取压力 | 限速或屏蔽 | 放行,在 CDN 上限速 | 放行 | 在边缘解决负载问题,而不是丢掉引用 |
如何在 robots.txt 中屏蔽 AI 训练爬虫、同时放行 AI 搜索?
给每个训练标识单独设一个规则组并写上 Disallow: /,搜索爬虫则交给你的常规规则。爬虫只服从点名它的最具体的那个规则组,所以对训练爬虫的屏蔽永远不会波及搜索机器人。
示例 1:屏蔽训练,保留 AI 搜索和用户抓取器
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 允许多行 User-agent 共用一个规则组,而且匹配不区分大小写。OAI-SearchBot、Claude-SearchBot、PerplexityBot、Googlebot 和 Bingbot 会落到 * 规则组,保持放行。
示例 2:明确向 AI 搜索开放
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
明确点名搜索机器人,可以防止将来别人写的一条笼统规则误伤你,比如某个插件添加了 User-agent: * 加 Disallow: /。私有路径要在这个规则组里继续 disallow,因为对某个机器人来说,点名的规则组会替换 * 规则组,而不是在其基础上叠加。
示例 3:三个会让真实文件出错的坑
- Applebot 会沿用 Googlebot 的规则。Apple 表示,如果你的文件没提到 Applebot 但提到了 Googlebot,Applebot 就会遵循 Googlebot 规则组。一条专门针对 Googlebot 的屏蔽,可能悄无声息地让你从 Siri 和 Spotlight 中消失。
- Amzn-SearchBot 在未被点名时会沿用其他搜索机器人的规则,这是 Amazon 的说法。如果你想要不同的结果,就点名它。
- 子域名需要自己的文件。Anthropic 和 Amazon 都表示它们按主机读取 robots.txt,所以
docs.example.com需要单独一份。
你可以用 AI Rank Lab 免费的 robots.txt 生成器来编写和检查这些规则组;我们之前的 AI 爬虫 robots.txt 模板对完全开放和选择性开放的配置讲得更深入。
如何验证 AI 爬虫是真的,而不是伪造的?
永远不要只相信 User-Agent:任何人都能在请求头里写上“GPTBot”,Common Crawl 也在自己的页面上警告说,有爬虫冒充 CCBot。运营方支持三种验证方法,具体用哪种取决于运营方。
- 先反向 DNS,再正向 DNS。对日志里的 IP 运行
host,确认主机名以运营方的域名结尾,再对这个主机名运行host,确认返回的是同一个 IP。Google 在其验证指南中针对googlebot.com、google.com和googleusercontent.com说明了这一方法;Apple 使用*.applebot.apple.com;Common Crawl 使用*.crawl.commoncrawl.org(仅 IPv4)。 - 把 IP 与运营方公开的列表比对。OpenAI、Anthropic、Perplexity、Google、Apple、Microsoft、DuckDuckGo、Mistral 和 Amazon 都公开了 IP 段。对 OpenAI、Anthropic 和 Perplexity 来说这是唯一的方法,因为它们没有提供反向 DNS 规则。
- 检查加密签名(Web Bot Auth)。OpenAI 的 ChatGPT Cloud browser 会对请求签名,遵循 RFC 9421,
Signature-Agent请求头为"https://chatgpt.com"。Google 正在对部分 Google-Agent 请求测试同一份 IETF 草案,签名为https://agent.bot.goog,其 Web Bot Auth 页面建议保留 IP 检查作为后备,因为并非每个请求都有签名。
# Reverse then forward lookup (Google example)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# IP-list check for OpenAI's search crawler
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
公开的 IP 列表有多新?
我们在 2026 年 10 月 18 日下载了所有公开的 AI 爬虫 IP 文件,并读取了每家运营方写在文件里的 creationTime 字段。日期旧可能只是说明 IP 段没有变化,但它能告诉你一份写死的白名单有多可信,也能看出哪些列表无法覆盖运营方从未声明过的流量。
| 公开列表 | 文件中的 creationTime | IPv4 / IPv6 前缀数 |
|---|---|---|
| Google 常用爬虫(Googlebot、Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Google 用户触发智能体(Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic(三个机器人共用一份列表) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
这里有两条实用的教训。Google 的列表和 OpenAI 的 ChatGPT-User 列表都在最近两周内更新过,所以你夏天复制的防火墙白名单很可能已经过时了;请改为每天或每周拉取这些文件。另外,Anthropic 表示屏蔽它的 IP “may not work correctly or persistently guarantee an opt-out”(可能无法正常生效,也无法持续保证退出),因为这会让 Anthropic 读不到你的 robots.txt。所以要用 robots.txt 来退出,IP 只用来验证。
怎样查看 AI 爬虫活动:服务器日志还是 JavaScript 代码?
爬虫看服务器或 CDN 日志,从 AI 助手过来的真人访客看 JavaScript 统计。JS 代码只有在页面的 JavaScript 被执行时才会运行,而大多数 AI 爬虫并不执行 JavaScript。Vercel 对其网络的分析发现,主流 AI 爬虫都不渲染 JavaScript;ChatGPT 和 Claude 的爬虫会抓取 JS 文件(分别占其请求的 11.50% 和 23.84%),但并不执行。例外是 Gemini(使用 Googlebot 的渲染能力)和 Applebot。这项研究是 2024 年 12 月的,建议你在自己的网站上重新测试,不过它和我们观察到的情况一致。
Google Analytics 在设计上让这个缺口变得更大。GA4 会自动排除来自已知机器人和蜘蛛的流量,你既不能关闭这项功能,也看不到被排除了多少。GA4 适合统计 AI 引荐流量(详见如何在 GA4 中追踪 AI 引荐流量),却不适合统计爬虫数量。
AI Rank Lab 自己的追踪数据也呈现出同样的规律。我们的 JavaScript 代码能稳定记录从 ChatGPT、Gemini、Perplexity 和 Claude 点击过来的真人访客,但只能看到一小部分、并不具代表性的爬虫流量,所以我们不会用它来发布爬虫数量。
五分钟日志检查
- 从主机或 CDN 下载一天的原始访问日志(Nginx 和 Apache 在默认的 combined 格式中都会记录 User-Agent)。
- 按 AI 标识统计请求数:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - 对排名靠前的标识检查状态码。如果满屏都是 403 或 429,通常说明某条 WAF 或 CDN 规则正在拦截一个你在 robots.txt 里放行的机器人。
- 在相信任何数字之前,先用上面的方法抽样验证一批 IP。
- 看看搜索机器人请求了哪些 URL。如果 OAI-SearchBot 或 Claude-SearchBot 只抓取你的首页,就该检查内部链接和站点地图了。
能查看 AI 爬虫活动的工具
声明:AI Rank Lab 是我们自己的产品。因为这是我们的网站,所以把它列在第一位,下面每个工具我们都采用了相同的评判标准。
- AI Rank Lab - AI 机器人追踪按页面记录 AI 助手引荐以及其代码能看到的 AI 机器人访问,并与你的 AI 可见度和引用追踪放在一起。出于上面说的原因,要获得完整的爬虫数量,请配合日志使用。
- Cloudflare AI Crawl Control - 如果你的网站经过 Cloudflare 代理,这是目前最完整的爬虫视图,因为它在边缘看到每一个请求,包括从不运行 JavaScript 的机器人。它还会显示每个爬虫对 robots.txt 的遵守情况。
- 日志分析工具,如 Screaming Frog 的 Log File Analyser 或 GoAccess - 适用于任何主机的原始日志,做一次性审计很好用。
- 原始日志加上面的 grep 命令 - 免费、精确,是其他所有工具都应该对得上的基准。
如果想围绕三大机器人建立更深入的监控流程,请看我们的 GPTBot、ClaudeBot 和 PerplexityBot 监控指南。
Cloudflare 和其他 CDN 如何控制 AI 机器人?
robots.txt 只能“请求”的事情,CDN 可以在网络边缘强制执行。Cloudflare 的 AI Crawl Control 所有套餐都可使用,它能显示哪些 AI 服务访问了你的网站,让你逐个放行或屏蔽爬虫,追踪违反 robots.txt 的行为,并以内测形式提供按次付费抓取(pay per crawl)。
Cloudflare 的 AI 机器人策略现在采用了和本文相同的三类划分。它的 Block AI Bots 设置为搜索(Search)、智能体(Agent)和训练(Training)分别提供预设,每一类都可以选择“在所有页面屏蔽”“在有广告的页面屏蔽”或“放行”。文档称,从 2026 年 9 月 15 日起,新域名会使用更新后的默认设置:训练类和智能体类机器人在展示广告的页面上被屏蔽,搜索类放行,兼具搜索和训练用途的混合爬虫只要有任何训练屏蔽就会被拦截。如果你是在这个日期之后把网站接入 Cloudflare 的,又发现 ChatGPT-User 或 Claude-User 访问你的博客时收到 403,先检查这项设置。
Cloudflare 还可以替你管理 robots.txt。开启 Bot Preference Sync 后,它的托管 robots.txt 会在你现有规则之前,加上针对 Amazonbot、Applebot-Extended、Bytespider、CCBot、ClaudeBot、Google-Extended、GPTBot 和 meta-externalagent 的 disallow 规则组,外加一行 Content Signals(search=yes, ai-train=no)。Content Signals 是 Cloudflare 提出的一套词汇(search、ai-input、ai-train),用来声明内容被抓取后可以如何使用;具体某家运营方是否遵守,由它自己决定。
其他服务商也支持同样的做法。Perplexity 的文档提供了在 Cloudflare 和 AWS WAF 中使用其 IP 列表的 WAF 配置指南,OpenAI 的帮助中心则说明了如何在 Akamai(机器人名称“ChatGPT Agent”)和 Cloudflare(检测 ID 129220581)中把它带签名的 Cloud browser 加入白名单。无论你用哪家 CDN,操作顺序都一样:按类别做决定,用 robots.txt 表达出来,只在需要硬性拦截的地方到边缘强制执行,并在每次修改 CDN 配置后重新检查日志。
Google 和 Bing:两个特殊情况
屏蔽 Google-Extended 会影响 Google 搜索或 AI Overviews 吗?
不会。Google 明确表示,Google-Extended “does not impact a site's inclusion in Google Search nor is it used as a ranking signal”(不影响网站被 Google 搜索收录,也不作为排名信号)。其 AI 功能文档写得很清楚:针对 Googlebot 的 robots.txt 规则才是控制搜索(包括 AI Overviews 和 AI Mode)的手段,而你可以用 nosnippet、data-nosnippet、max-snippet 或 noindex 来限制展示的内容。Google-Extended 管的是 Gemini 模型训练以及 Gemini Apps 和 Vertex AI 中的 grounding,这些和搜索是分开的。
如何控制 Microsoft Copilot 是否使用你的内容?
Microsoft 没有单独的 AI 爬虫标识;抓取由 Bingbot 完成,AI 用途则通过页面级的 robots meta 标签来控制。我们找到的最新官方指南是 Bing 团队 2023 年的公告,当时 Copilot 还叫 Bing Chat:标记了 noarchive 的内容不会被纳入或链接到 Bing 的聊天回答中,也不会用于训练 Microsoft 的基础模型;标记了 nocache 的内容只能以 URL、标题和摘要的形式出现;两个标签都没有的内容可以被完整使用。这两个标签都不会影响你在 Bing 常规结果中的展示。在 robots.txt 中屏蔽 Bingbot 会让你连 Bing 搜索也一起消失,所以请改用 meta 标签。
局限性与核查方法
2026 年 10 月 18 日,我们阅读了上文列出的每家运营方的爬虫页面,下载了所有公开的 IP 列表,并记录了每个文件中的 creationTime。Microsoft 的爬虫帮助页面完全依赖 JavaScript,我们无法渲染,因此 Bingbot 一行依据的是 Microsoft 的 Bing 网站管理员博客、Verify Bingbot 工具和公开的 bingbot.json。robots.txt 各栏转述的是运营方的说法,而不是我们独立测量的结果;Cloudflare 对 Perplexity 的发现,是说明两者可能不一致的主要公开证据。运营方经常改名和新增机器人(例如,Google 已经用 Google-GeminiNotebook 取代了 Google-NotebookLM 这个抓取器标识),所以任何清单(包括这一份)都只在其核查日期时准确。
如果你想知道自己的爬虫策略是否真的在为你赢得引用,AI Rank Lab 会追踪你在 ChatGPT、Claude、Gemini、Perplexity、Google AI Overviews 和 AI Mode 中的提及和被引用页面,并与这些回答为你带来的 AI 引荐流量放在一起对照。
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


