



ChatGPT 搜索的工作流程可以拆成五步:先判断你的问题是否需要最新信息,再把问题改写成一条或多条搜索查询,然后从 OpenAI 自己的索引和缓存以及合作搜索服务商那里抓取候选网页,对找到的结果排序,最后写出答案,并附上所用网页的链接。这几个环节 OpenAI 都有文档说明。它没有公开的是每个来源各占多大权重,而大部分困惑(以及大部分猜测)正是从这里来的。
本文把 OpenAI 在官方文档里确认过的内容,和研究人员通过逆向分析得出的结论分开来讲,逐一解释 OpenAI 的四个用户代理(user agent)及其各自控制什么,并给出一份清单:站长能影响什么、不能影响什么。文中还加入了我们自己的追踪数据所反映的 ChatGPT 引荐流量情况,包括 2026 年 10 月 8 日至 16 日的 UTM 标记缺失问题。所有来源均于 2026 年 10 月 18 日核实。
核心要点
- 已确认:ChatGPT 会使用 OpenAI 自有的“已索引和已缓存的网页内容”,同时也调用第三方搜索服务商和合作伙伴内容。OpenAI 点名的服务商中包括 Microsoft 和 Shopify,改写后的查询可能会发给它们。
- 未公开:各来源的占比。关于一个名为“Labrador”的内部索引,以及拿它与外部结果对比的测试,这些说法都来自第三方研究,而非 OpenAI。
- 对搜索真正起作用的开关是 OAI-SearchBot。屏蔽它,你的网页就不会再出现在 ChatGPT 搜索答案里。屏蔽 GPTBot 只代表你退出模型训练。
- 引用很不稳定。在我们的追踪中,ChatGPT 针对某个提示词引用的域名里,每次运行都出现的只占中位数 7.7%。
- 看 UTM,别看 referrer。我们的追踪代码记录到的带 ChatGPT 标记的页面浏览中,有 39% 完全没有 referrer。
阅读说明:哪些是已确认,哪些是“据报道”
关于 ChatGPT 搜索的讨论常常把不同来源的信息混为一谈,错误建议就是这样传开的。所以下文每一条说法都会标上三种标签之一:
- 已确认 - OpenAI 在帮助中心、开发者文档、版本说明或官方公告中明确说过的内容。
- 据报道 - 第三方研究、对 ChatGPT 网络流量的逆向分析、经记者转述的法庭证词,或二手说法。往往可信,但从来不是官方口径。
- 我们的数据 - 来自 AI Rank Lab 提示词追踪和 JavaScript 追踪代码的汇总匿名数据,每个数字旁边都注明了方法和样本量。
ChatGPT 搜索是怎么一步步工作的?
简单说,这是一条检索流水线:决定是否搜索、改写查询、从多个来源检索、排序,最后生成带引用的答案。下面逐步说明,并标注每一步的证据等级。
- 决定是否搜索。已确认:根据 OpenAI 的帮助文章 Searching the web with ChatGPT,当问题能从最新信息中获益时,ChatGPT 可能会自动搜索。你也可以在工具菜单里选择“搜索”,或在输入框中键入“/”来强制搜索。据报道:RESONEO 在 2026 年 2 月的逆向分析描述了一个分类器,它会给每条提示词打分,分数超过阈值就触发搜索。
- 把提示词改写成搜索查询。已确认:当 ChatGPT 调用合作搜索服务商时,通常会把你的问题改写成一条或多条有针对性的查询;读完首批结果后,可能再发出更具体的追加查询;还可能加上根据你的 IP 地址推断出的大致位置(不会发送 IP 本身),并在改写时参考已保存的记忆。这就是查询扇出(query fan-out),我们在查询扇出指南里有详细讲解。
- 检索候选网页。已确认:结果来自第三方搜索服务商、合作伙伴直接提供的内容,以及 OpenAI 自有的已索引和已缓存的网页内容。据报道:具体是哪些服务商、各占多少(见下一节)。
- 对候选结果排序。已确认:OpenAI 表示,ChatGPT 会综合多种因素对搜索结果排序,目的是呈现相关、可靠的信息,且不保证排名位置。具体因素没有公开。据报道:RESONEO 描述说,来自多个引擎的结果会用倒数排名融合(Reciprocal Rank Fusion)合并,这是合并多个排序列表的常用技术。
- 撰写答案并引用来源。已确认:使用了搜索的答案可以包含行内引用、一个列出引用来源及其他相关链接的“来源”按钮、图片来源链接,在移动端还可能有地图。负责撰写答案的模型也一直在变:2024 年上线时用的是微调版 GPT-4o;自 2026 年 10 月 7 日的版本更新起,ChatGPT 的聊天体验改由 GPT-6 驱动(付费方案为 Sol,Free 和 Go 方案为 Luna),并配备了新的“Intelligent UI”,可以用图表、对比和交互元素来回答。
ChatGPT 什么时候会联网搜索,而不是凭记忆回答?
当 ChatGPT 判断一个问题需要新鲜或具体的信息时就会搜索,比如新闻、价格、比分、本地结果或任何近期发生的事;其余情况则用训练数据回答。你可以手动选择“搜索”,或直接让 ChatGPT 上网查,来推翻它的判断。
实际中这种情况有多常见?据报道:Profound 对美国英文 ChatGPT 对话的研究(2025 年 10 月至 12 月;其中约 730,000 次对话至少包含一条网页引用)发现,约 18% 的对话至少触发了一次网页搜索,而且随着对话推进,答案带引用的概率会下降:第一轮有 12.6% 带引用,到第十轮只剩 4.5%。
这带来两个实际影响。第一,ChatGPT 不搜索时,你今天对网站做的任何改动都不会影响那个答案,因为它来自训练数据,而这部分正是 GPTBot 管的。第二,对话的第一个问题最有可能触发搜索,因此也最有可能带来引用。
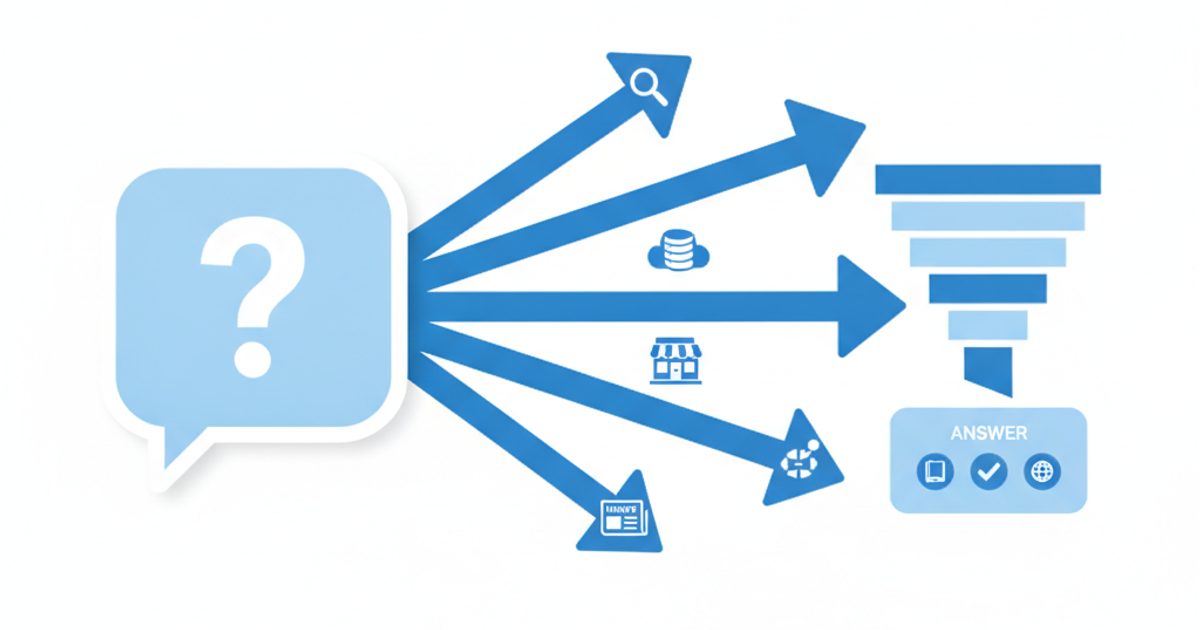
ChatGPT 的搜索结果从哪里来?
ChatGPT 的搜索结果来自多个渠道的组合:OpenAI 自有的索引和缓存、第三方搜索服务商,以及授权或合作伙伴数据。这三者的存在 OpenAI 都确认过,但没有透露各自的使用频率,而且新闻、购物、本地和一般查询的占比很可能各不相同。
OpenAI 已确认的内容
- 第三方服务商和合作伙伴内容。2024 年 10 月 31 日的上线公告指出,ChatGPT 搜索使用第三方搜索服务商以及合作伙伴直接提供的内容,天气、股票、体育、新闻和地图背后都有新闻和数据合作伙伴。
- 点名的服务商。当前的帮助文章引导用户查看 Microsoft 和 Shopify 的隐私政策,二者作为搜索服务商可能会收到改写后的查询。餐厅预订方面,则显示来自 OpenTable、Resy 和 Yelp 的空位信息。
- OpenAI 自有的索引和缓存。OpenAI 关于 ChatGPT 工作区离线网页搜索的帮助文章描述了一种模式:ChatGPT 不调用实时服务商,而是搜索“OpenAI 已索引和已缓存的网页内容”。文中还说明,不保证任何特定 URL 的刷新,覆盖范围也因网站、语言、地区和内容类型而异。
ChatGPT 有自己的搜索索引吗?
有。OpenAI 自己的文档描述了它维护的索引和缓存,OpenAI 还运行着一个专门的搜索爬虫 OAI-SearchBot 来填充它。尚未确认的是:日常消费者使用的 ChatGPT 搜索,有多少是靠这个索引回答的,又有多少来自外部服务商。
关于这个问题,目前最好的公开证据都来自第三方:
- 据报道:2025 年 4 月 Google 搜索反垄断救济审理期间,OpenAI 的 ChatGPT 产品负责人 Nick Turley 作证称,OpenAI 正在建设自己的索引,要完全依靠它可能还需要数年,而且 Google 拒绝了 OpenAI 在 2024 年提出的搜索 API 接入请求(Tech Policy Press)。
- 据报道:Peec AI 在 2026 年 9 月的分析发现,2026 年 5 月 21 日至 7 月 21 日期间,ChatGPT 的服务器推送事件(server-sent events)中有一个
result_source字段,取值有四种:Labrador、Bright、Oxylabs 和 SERP。Peec 认为 Labrador 是 OpenAI 的一组垂直索引(网页、PDF、YouTube、新闻、Wikipedia、arXiv、本地、金融、法律、医疗、购物、图片),另外三个则是外部抓取渠道。Peec 没有报告每种取值出现的频率。 - 据报道:Peec 和 Otterly AI 描述了一个名为
prefer-index-over-serp-v3的实验,看起来是在拿 OpenAI 的索引和第三方结果做对比测试;Otterly 估计 2026 年 8 月约有 8% 的对话参与其中。Search Engine Watch 曾请 OpenAI 置评,截至发稿未获回复。
ChatGPT 搜索用的是 Bing 还是 Google?
Microsoft 是公开披露的搜索服务商,Google 不是。OpenAI 帮助中心列出了 Microsoft 的搜索隐私声明;另据 Otterly 和 Peec 报道,Microsoft 在 2026 年 6 月发布的 Web IQ 落地(grounding)平台也在为 ChatGPT 提供支持。我们没能在 Microsoft 的一手资料中找到这一说法,所以请把它当作“据报道”。根据 Turley 的证词,Google 与 OpenAI 没有合作关系,但有几位研究者(RESONEO、Peec)报告称,Google 的结果会通过抓取服务商进入 ChatGPT。OpenAI 尚未证实这一点。
实际结论是:在 Bing 或 Google 排名靠前,有助于你的网页被 ChatGPT 可能使用的服务商发现,但这两者的排名都不能可靠地代表你在 ChatGPT 中的可见度。你必须直接衡量 ChatGPT。
| 说法 | 状态 | 来源 | 日期 |
|---|---|---|---|
| ChatGPT 使用第三方搜索服务商和合作伙伴内容 | 已确认 | OpenAI 上线公告 | 2024 年 10 月 31 日 |
| Microsoft 和 Shopify 是可能接收查询的搜索服务商 | 已确认 | OpenAI 帮助中心 | 2026 年 10 月 18 日核实 |
| OpenAI 保有自己已索引和已缓存的网页内容 | 已确认 | OpenAI 帮助中心(离线网页搜索) | 2026 年 10 月 18 日核实 |
| OAI-SearchBot 抓取网页,用于在 ChatGPT 搜索中展示网站 | 已确认 | OpenAI 开发者文档 | 2026 年 10 月 18 日核实 |
| OpenAI 正在建设自有索引;完全依靠它还需数年 | 据报道(法庭证词) | Tech Policy Press | 2025 年 4 月 |
| 名为“Labrador”的内部索引家族,以及 Bright、Oxylabs 和 SERP 渠道 | 据报道(网络分析) | Peec AI | 2026 年 9 月 |
| 拿 OpenAI 索引与外部结果对比的实验(约 8% 的对话) | 据报道 | Peec AI、Otterly AI | 2026 年 8 月至 9 月 |
| Microsoft Web IQ 为 ChatGPT 答案提供落地支持 | 据报道,我们未在 Microsoft 资料中证实 | Otterly AI、Peec AI | 2026 年 6 月 |
| Google 结果通过抓取服务商进入 ChatGPT | 据报道,未证实 | RESONEO、Peec AI | 2026 年 |
OAI-SearchBot、GPTBot 和 ChatGPT-User 有什么区别?
OAI-SearchBot 决定你能否出现在 ChatGPT 搜索中,GPTBot 决定你的内容能否用于训练 OpenAI 的模型,ChatGPT-User 则是用户让 ChatGPT 打开某个网页时负责抓取的代理。三者互相独立:你可以放行一个、屏蔽另一个。OpenAI 的爬虫文档还列出了第四个代理 OAI-AdsBot,用于 ChatGPT 广告。
| 用户代理 | 作用(据 OpenAI) | robots.txt 能控制什么 | IP 列表 |
|---|---|---|---|
| OAI-SearchBot | 抓取网页,用于在 ChatGPT 的搜索功能中展示网站 | 禁止它,你的网页就不会出现在 ChatGPT 搜索答案中,但仍可能以普通导航链接的形式出现。改动约 24 小时生效。 | openai.com/searchbot.json |
| GPTBot | 抓取可能用于训练 OpenAI 基础模型的内容 | 禁止它,即表示你的内容不应被用于训练。不影响搜索收录资格。 | openai.com/gptbot.json |
| ChatGPT-User | 由用户发起的访问,比如用户让 ChatGPT 阅读某个网页,或 GPT Actions | 由于访问是用户触发的,robots.txt 规则可能不适用。不用于决定是否收录进搜索。 | openai.com/chatgpt-user.json |
| OAI-AdsBot | 检查作为 ChatGPT 广告提交的落地页,只访问这些页面 | 只有在 ChatGPT 上投放广告时才相关。其数据不会用于训练基础模型。 | openai.com/adsbot.json |
如果你希望网站在 ChatGPT 搜索中可见、但不愿内容被用于训练,常见配置如下:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
OpenAI 文档里有两个容易被忽略的细节:如果两个爬虫你都放行,OpenAI 可能用一次抓取同时满足两种用途;而抓取 robots.txt 本身的请求,其 user-agent 字符串里可能会多带一个“robots.txt”标记。如果需要一套覆盖所有 AI 爬虫的完整规则,可以看我们的 AI 爬虫 robots.txt 指南或免费的 robots.txt 生成器;想在日志中验证真实的爬虫流量,可以参考我们的 GPTBot、ClaudeBot 和 PerplexityBot 监测指南。
ChatGPT 是怎么选择引用来源的?
OpenAI 只说 ChatGPT 会根据以相关性和可靠性为目标的多种因素对结果排序,且不保证排名位置。没有公开的排名因素清单,也没有提交工具。我们能衡量的是引用的规律。
据报道:在 Profound 为期三个月的研究中,一条带引用的答案平均使用约四个不同来源,66% 带引用的回合用了一到四个来源。引用分布很分散:排名前十的域名只拿到全部引用的 12%,其中 Wikipedia 约占 5%,Reddit 约占 3%。
我们的数据:AI Rank Lab 对 11 条 ChatGPT 提示词各运行了至少五次(共 239 次成功运行,2026 年 2 月 13 日至 10 月 14 日)。同一提示词相邻两次运行之间,被引用域名重合度的中位数为 0.54(Jaccard 相似度,1 表示完全相同)。ChatGPT 针对某条提示词引用的域名中,每次运行都出现的只占中位数 7.7%;11 条提示词中有 6 条至少有一次在“提到被追踪品牌”和“没提到”之间来回切换。这些都是自动化运行,可能与已登录用户看到的个性化结果不同;完整方法见我们的 AI 答案一致性研究。
这意味着,“ChatGPT 引用我们了吗?”这个问题问错了。有用的问题是:“在多次重复运行中,我们被引用的比例是多少?是在哪些提示词上?”手动查一次,几乎说明不了什么。
怎么追踪来自 ChatGPT 搜索的流量?
追踪 ChatGPT 访问要看 ChatGPT 在外链上附加的 utm_source=chatgpt.com 参数,而不是 referrer。OpenAI 的发布商 FAQ 记录过这个参数(2026 年 10 月 18 日我们没能打开那个页面,所以这里依据的是早先的存档和我们自己的观察),而且在真实流量中能清楚看到它。
我们的数据:2025 年 7 月 27 日至 2026 年 10 月 18 日,AI Rank Lab 的 JavaScript 追踪代码在 29 个网站上记录到 2,710 次带有 utm_source=chatgpt.com 的页面浏览;相比之下,referrer 为 chatgpt.com 的页面浏览是 2,087 次,分布在 26 个网站。在这 2,710 次带标记的页面浏览中,有 1,048 次(39%)完全没有 referrer。如果只看 referrer,这些访问都会被归入“直接访问”(Direct)。
在 GA4 中,查看会话来源等于 chatgpt.com 的数据(它能识别 UTM),并建立一个包含它的渠道组。我们的 GA4 AI 引荐流量追踪页面介绍了具体设置;AI 爬虫追踪则可以按页面记录 AI 助手带来的引荐,完全不依赖 GA4。
2026 年 10 月 ChatGPT 的 UTM 标记出了什么问题?
GPT-6 上线后大约一周内,很多 ChatGPT 链接发出时没有带 UTM 标记,于是原本归到 ChatGPT 的访问变成了“直接访问”。标记在 10 月 15 日至 16 日恢复。除 GPT-6 的上线日期外,这件事的所有信息都来自第三方;OpenAI 没有发表任何公开声明,版本说明里也只字未提。
| 日期(2026 年) | 发生了什么 | 状态 | 来源 |
|---|---|---|---|
| 10 月 7 日至 8 日 | GPT-6 和 Intelligent UI 先向付费方案推出,随后推广到 Free 和 Go | 已确认 | OpenAI 版本说明 |
| 10 月 8 日,约 18:30 UTC | 带标记链接的答案占比开始从约 99% 下滑 | 据报道 | Profound |
| 10 月 9 日至 13 日 | 在约 500 个页面上,ChatGPT 访问每天减少约 31,000 次,同时直接访问每天增加约 26,000 次 | 据报道 | Adobe 的 Cedric Huesler,经 SEJ 报道 |
| 10 月 14 日 | Huesler 称 OpenAI 告诉他这是一个已知 bug | 据报道(二手) | SEJ |
| 10 月 14 日,约 19:00 UTC | 随着 Intelligent UI 答案占比达到 92-96%,带标记的答案降至 5-10% | 据报道 | Profound |
| 10 月 15 日至 16 日 | 修复上线;到 10 月 16 日 06:30 UTC,带标记的答案回升至约 99% | 据报道 | Profound、SEJ |
来源:Search Engine Journal,2026 年 10 月 15 日,以及 Profound 的事件时间线。
我们的数据:我们在这段时间的样本很小,请把它当作一致性检验,而不是测量结果。10 月 9 日至 18 日,我们的追踪代码在两个网站上记录到 52 次带 ChatGPT 标记的页面浏览,其中没有一次带 chatgpt.com 的 referrer。而在此前 30 天(9 月 9 日至 10 月 8 日),七个网站上的 368 次带标记页面浏览中有 236 次(64%)带有该 referrer。这与“即使标记恢复后,大多数 ChatGPT 点击仍然没有 referrer”的报道相符。
应对办法:在报表中给 10 月 8 日至 16 日加上注释;在认定流量流失之前,先对比 ChatGPT 平时给你带来流量的那些落地页的直接访问数据;继续以 UTM 而不是 referrer 为准来统计。
怎样让网站具备被 ChatGPT 搜索收录的资格?
资格的关键在于让 OAI-SearchBot 能访问并读取你的网页。OpenAI 帮助中心说得很直白:在 robots.txt 中放行 OAI-SearchBot,并确保你的主机或 CDN 允许来自 OpenAI 公布的搜索爬虫 IP 地址的流量。清单里的其他项提升的是你的胜算,而不是资格本身。
- 在 robots.txt 中放行 OAI-SearchBot,GPTBot 则单独决定。检查有没有宽泛的
User-agent: *规则误把它拦掉了。 - 在 CDN、防火墙或防爬虫层放行 OpenAI 的 IP 段。很多“屏蔽 AI 爬虫”的开关也会把 OAI-SearchBot 一起拦掉。把日志里的 403 或 429 响应与 openai.com/searchbot.json 对照一下。
- 把主要内容放在 HTML 里。OpenAI 列出的索引可能漏掉页面的原因包括:严重依赖脚本、动态加载、需要登录和个性化内容。重要页面请做服务端渲染或预渲染。
- 让深层页面容易被发现。OpenAI 也把“把深层页面藏起来的网站结构”列为原因之一。从枢纽页面链接到重要页面,并保持 XML 站点地图及时更新。
- 保持页面内容新鲜并标注日期。OpenAI 没有给出针对每个 URL 的刷新计划,并表示新鲜度取决于网站本身、抓取权限、缓存和热度。醒目的“更新于”日期对读者和任何看重时效的系统都有帮助。
- 写“答案先行”、可独立成段的内容。这一条是业内从业者的共识,而非 OpenAI 的指导:一个在第一句话就回答了自身标题的段落更容易被引用。我们的 30 天 ChatGPT 引用实战手册讲的就是内容这一面。
- 出现在 ChatGPT 为你所在行业调用的数据里。餐厅会显示来自 OpenTable、Resy 和 Yelp 的空位信息;Shopify 是公开披露的购物服务商。如果这些与你相关,你在这些平台上的信息就是你 ChatGPT 可见度的一部分。
- 确认 OAI-SearchBot 真的来访过。在服务器日志中筛选 OAI-SearchBot 标识并核实 IP,然后追踪 ChatGPT 针对你的目标提示词引用了哪些 URL。
要在整个网站范围内检查第 3 到第 5 步,AEO 审计会抓取你的网页,标出 SEO、答案引擎和生成式引擎方面的就绪问题,并给出修复建议。至于第 8 步的后半部分,引用追踪会记录 ChatGPT 针对你的提示词引用了你的哪些 URL。
为什么我的网页没有出现在 ChatGPT 搜索中?
最常见的原因有:抓取被屏蔽、CDN 或防火墙规则、内容只有在 JavaScript 运行后才出现,以及页面太新、层级太深或很少被链接。OpenAI 在离线网页搜索文档中列出的、页面可能在其索引中缺失或过时的原因,恰恰就是这些。这份清单本来是写给工作区管理员的,但这是 OpenAI 唯一解释其索引为何漏掉页面的地方,所以也正好可以当诊断清单用。
| OpenAI 给出的原因 | 如何检查 | 修复方法 |
|---|---|---|
| robots.txt 或类似控制屏蔽了抓取 | 打开 /robots.txt,查找 OAI-SearchBot 或一刀切的 Disallow | 放行 OAI-SearchBot,等待约 24 小时 |
| CDN 或防爬虫拦截 | 在日志中搜索返回 403、429 或验证页面的 OAI-SearchBot 请求 | 把 openai.com/searchbot.json 中的 IP 段加入白名单 |
| 页面需要登录或个性化 | 在未登录状态下用无痕窗口打开页面 | 为关键内容发布一个公开版本 |
| 内容依赖脚本或动态加载 | 用 curl 获取原始 HTML,检查正文是否在里面 | 服务端渲染或预渲染 |
| 页面很新、访问很少或信号很弱 | 检查发布日期,以及指向它的内链和外链 | 从权重高的页面链接过去,争取外部引用,给它一些时间 |
| 网站结构把深层页面藏起来了 | 数一数从首页要点几次才能到达;检查站点地图 | 增加枢纽页面链接,并保持站点地图及时更新 |
如果每一项都没问题,你仍然没有被引用,那问题通常出在相关性或竞争上,而不是访问权限:要么别的页面更直接地回答了这个提示词,要么 ChatGPT 对这个提示词根本就不搜索。
ChatGPT 搜索中有哪些是你控制不了的?
你能控制的是访问权限和内容质量,之后发生的大部分事情你都控制不了。具体来说,你无法控制:
- ChatGPT 是否搜索。除非用户强制选择“搜索”,否则由 ChatGPT 自己决定。
- 由哪个服务商来回答。OpenAI 的索引、Microsoft、Shopify、合作伙伴,或据报道的抓取渠道,它们的组合比例并未公开,而且 OpenAI 似乎正在积极测试。
- 排名和引用。没有公开的因素清单,也没有任何保证,我们的数据显示引用每次运行都会变。
- 收录速度。OpenAI 没有提供 URL 提交工具、索引覆盖报告,也不保证特定 URL 的刷新。
- 基于训练数据的答案。ChatGPT 凭记忆回答时,你今天对页面的修改不起作用。
- ChatGPT-User 的访问。robots.txt 可能不适用于用户发起的抓取。
- 导航链接。即使你屏蔽了 OAI-SearchBot,你的网站仍可能以导航链接的形式出现。
- 链接标记。2026 年 10 月的情况说明,归因可能会在毫无预警的情况下失效。
怎么监测 ChatGPT 引用了哪些 URL?
由于每次运行的结果都不一样,监测就意味着反复运行同一批提示词,并持续记录提及情况和被引用的 URL。如果只有几条提示词,你可以在未登录的浏览器里手动做;数量再多,用工具会省很多时间。
说明:AI Rank Lab 是我们自己的产品。因为这是我们的网站,所以把它排在第一位,但下面每个工具我们都用了同一套标准。
- AI Rank Lab - 按计划在 ChatGPT、Claude、Gemini 和 Perplexity 上运行你的提示词,并覆盖 Google AI Overviews(AI 概览)和 AI Mode(AI 模式),记录提及、位置、竞争对手和被引用的 URL。它还通过审计、Action Plan 和内容发布,把追踪和修复连接起来。详见品牌可见度追踪。
- Profound - 面向企业,发布了一些规模最大的 ChatGPT 引用公开数据集,比如上文引用的那项研究。
- Peec AI - 擅长机制研究,包括目前对 ChatGPT 索引最详细的公开分析。
- Otterly AI - 经常发布 GEO 实验,覆盖多个 AI 引擎。
研究方法与局限
2026 年 10 月 18 日,我们阅读了 OpenAI 帮助中心关于网页搜索、离线网页搜索的文章和版本说明、OpenAI 的爬虫文档及其 2024 年的上线公告,并分析了 15 篇讲解 ChatGPT 搜索原理的高排名文章和报告。第三方的发现都标为“据报道”,因为没有一项得到 OpenAI 证实;其中好几项来自和我们一样销售 AI 可见度工具的公司。撰写当天我们没能打开 OpenAI 的发布商 FAQ,也没能在 Microsoft 的一手资料中证实 Microsoft Web IQ 在 ChatGPT 中的作用。我们的第一方数据来自少量网站和提示词,经过汇总和匿名化处理,并注明了样本量;它们描述的是我们客户的流量,而不是整个互联网。
如果你想知道,在你关心的提示词上 ChatGPT 实际引用了你的哪些网页,以及这种情况每周如何变化,就用 AI Rank Lab 开始追踪吧。
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


