



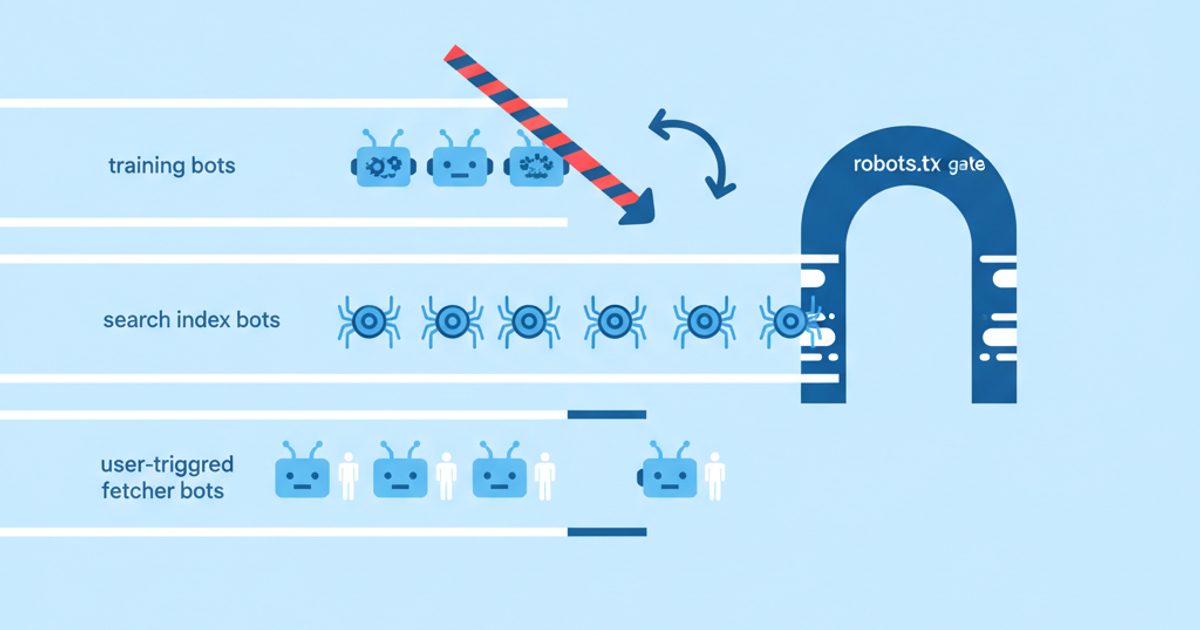
AIクローラーとは、AI企業が運用する自動ボットのことで、Webページを取得する目的は次の3つのどれかです。モデルの学習データを集める(GPTBot、ClaudeBot)、AIの回答が引用する検索インデックスを作る(OAI-SearchBot、Claude-SearchBot、PerplexityBot)、そしてユーザーがアシスタントにそのページについて尋ねたときにリアルタイムで取得する(ChatGPT-User、Claude-User、Perplexity-User)。学習用クローラーをブロックすれば、今後のモデルにあなたのコンテンツが入らなくなります。一方、検索用クローラーやユーザー起点のフェッチャーをブロックすると、AIの回答や引用から姿を消すことになります。判断のポイントは、ほぼこの違いだけです。
このページは、そのまま実務に使えるリファレンスです。以下のユーザーエージェントはすべて、2026年10月18日に各運営元の公式ドキュメントと照合し、そのページへのリンクを付けています。あわせて、ビジネス目的別の判断マトリクス、コピーしてすぐ使えるrobots.txtのグループ、各運営元が対応している検証方法(公開IPリストに記載された日付付き)、そしてJavaScriptベースのアクセス解析ではクローラーのトラフィックをほとんど把握できない理由も、包み隠さず解説します。
この記事のポイント
- AIボットはすべて学習用、検索・インデックス用、ユーザー起点のいずれかに分類しましょう。OpenAI、Anthropic、Amazon、Meta、Mistralはクラスごとに別のトークンを公開しているので、ほかに影響を与えずに1つだけブロックできます。
- GPTBotをブロックしても、ChatGPT検索から消えることはありません。OpenAIによれば、それを左右するのはOAI-SearchBotだけです。また、OAI-SearchBotをオプトアウトしたサイトでも、ナビゲーション用のリンクとしては表示されることがあります。
- Google-ExtendedとApplebot-Extendedはクローラーではなく制御用トークンです。アクセスログには一切現れません。またGoogleは、Google-ExtendedがGoogle検索(AI OverviewsとAI Modeを含む)には影響しないと明言しています。
- ユーザー起点のフェッチャーは、仕様としてrobots.txtを無視する場合があります。OpenAI、Perplexity、Google、Meta、Amazonはいずれもドキュメントでそう明記しています。確実にブロックしたいならWAFを使いましょう。
- ほとんどのAIクローラーはJavaScriptを実行しないため、JSのアクセス解析タグでは実際より少なくカウントされます。クローラーの動きを正確に知るには、サーバーやCDNのログが基準になります。
- ボットの検証は、逆引きDNS(Google、Apple、Common Crawl)か、運営元が公開しているJSONリストとのIP照合で行います。リストの中には何年も前のものもあるので、定期的にダウンロードし直しましょう。
AIクローラーとは?3つのクラスの違い
AIクローラーとは、AI企業があなたのページをリクエストするために使う自動クライアント全般を指します。いまや運営元は目的ごとにボットを分けており、その目的によって、ブロックしたときに何を失うかが決まります。Cloudflareのネットワークデータを見ると、その内訳はかなり偏っています。2025年半ばまでの12か月間で、AIクローリングの80%が学習目的、18%が検索目的、2%がユーザーのアクション目的で、直近6か月に限ると学習目的は82%まで増えていました。
学習用クローラー
学習用クローラーは、基盤モデルの学習やファインチューニングに使われる可能性のあるコンテンツを集めます。GPTBot、ClaudeBot、Meta-ExternalAgent、Amazonbot、MistralAI-Training、そしてCCBot(多くのモデル開発者が利用するCommon Crawlのオープンデータセット)がこれにあたります。これらをブロックするのは、「今後のコンテンツを学習データに含めないでほしい」という意思表示です。すでに収集されたコンテンツが消えるわけではなく、AI検索で引用されるかどうかにも影響しません。
検索・インデックス用クローラー
検索用クローラーは、AIの回答の根拠となり、引用リンクの参照先にもなる検索インデックスを構築します。OAI-SearchBot(ChatGPT検索)、Claude-SearchBot、PerplexityBot、Meta-WebIndexer、Amzn-SearchBot、MistralAI-Index、DuckAssistBotはAI専用のものです。Googlebot、Bingbot、Applebotは従来型の検索クローラーですが、そのインデックスはいまやAI機能にも使われています。具体的にはGoogleのAI OverviewsとAI Mode、Microsoft Copilot、そしてSiriの回答です。検索用クローラーのブロックは高くつくミスです。見込み客が読むAIの回答から、あなたが消えてしまうからです。こうしたインデックスが実際にどう使われるのかは、ChatGPT検索の仕組みで詳しく解説しています。
ユーザー起点のフェッチャーとエージェント
ユーザー起点のフェッチャーは、誰かがアシスタントに「このページを読んで」「要約して」「操作して」と頼んだときに、そのURLだけを訪問します。ChatGPT-User、Claude-User、Perplexity-User、Google-Agent、Meta-ExternalFetcher、Amzn-User、MistralAI-Userがこれにあたり、ChatGPTのCloud browserのような署名付きブラウザエージェントも含まれます。リクエストを始めたのが人間であるため、robots.txtが適用されない場合があると明記している運営元もいくつかあります。
クローラーではない制御用トークン
どの一覧にも載っている2つの名前は、それ自体では何も取得しません。Google-Extendedは、Googleが通常のユーザーエージェントでクロールする際に読み取るrobots.txtのプロダクトトークンで、今後のGeminiモデルの学習や、Geminiアプリ・Vertex AIでのグラウンディングにコンテンツを使ってよいかを制御します。Applebot-Extendedは、Appleの基盤モデルについて同じ役割を果たします。どちらの文字列もアクセスログには出てこないので、「Google-Extendedをブロックしたのに、まだGoogleのトラフィックがある」というのは想定どおりの挙動です。
AIクローラー一覧:主要ユーザーエージェントの全リスト(2026年10月18日確認)
この表には、User-agent:行に書くトークン、運営元、クラス、運営元のドキュメントにおけるrobots.txtの扱い、検証方法、そして確認した公式ページをまとめています。「ドキュメント上」とあるのは、robots.txtの列が運営元の説明を要約したものだという意味です。ドキュメントに記載がない場合は、推測せずにその旨を書いています。
| トークン | 運営元 | クラス | 役割 | robots.txt(ドキュメント上) | 検証方法 | 公式ドキュメント |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | 学習用 | OpenAIの基盤モデルの学習に使われる可能性のあるコンテンツをクロール | 従う | gptbot.json | OpenAIのクローラー |
| OAI-SearchBot | OpenAI | 検索用 | ChatGPT検索の回答にサイトを表示。学習には使われない | 従う。変更の反映まで約24時間 | searchbot.json | OpenAIのクローラー |
| ChatGPT-User | OpenAI | ユーザー起点 | ChatGPTやカスタムGPTでのユーザーのアクションに応じてページを訪問 | 適用されない場合がある | chatgpt-user.json | OpenAIのクローラー |
| OAI-AdsBot | OpenAI | 特殊 | ChatGPT広告として入稿されたランディングページをチェック。学習には使われない | 記載なし。入稿された広告ページのみ訪問 | adsbot.json | OpenAIのクローラー |
| ClaudeBot | Anthropic | 学習用 | Claudeモデルの学習に使われる可能性のあるコンテンツを収集 | 従う。Crawl-delayに対応 | bots.json(共通) | Anthropicヘルプセンター |
| Claude-SearchBot | Anthropic | 検索用 | Claudeの検索結果を改善するためにコンテンツをインデックス | 従う | bots.json(共通) | Anthropicヘルプセンター |
| Claude-User | Anthropic | ユーザー起点 | Claudeのユーザーが質問したときにページを取得 | 従う。無効にするとユーザー指示による取得が止まる | bots.json(共通) | Anthropicヘルプセンター |
| PerplexityBot | Perplexity | 検索用 | Perplexityの検索結果にサイトを表示・リンク。学習には使われない | 従う。反映まで最大24時間 | perplexitybot.json | Perplexityのクローラー |
| Perplexity-User | Perplexity | ユーザー起点 | ユーザーの質問に答えるためにページを訪問 | 基本的に無視する | perplexity-user.json | Perplexityのクローラー |
| Googlebot | 検索用 | Google検索(AI OverviewsとAI Modeを含む) | 自動クロールでは常に従う | 逆引きDNSまたはcommon-crawlers.json | Googleの一般的なクローラー | |
| Google-Extended | 制御用トークン | Geminiの学習と、GeminiアプリおよびVertex AIでのグラウンディング | トークンのみ。独自のユーザーエージェントはない | 該当なし | Googleの一般的なクローラー | |
| Google-CloudVertexBot | 検索用(サイト所有者の依頼による) | 所有者がVertex AI Agentsを構築しているサイトをクロール | 従う | 逆引きDNSまたはcommon-crawlers.json | Googleの一般的なクローラー | |
| Google-Agent | ユーザー起点のエージェント | Googleのインフラ上で動き、ユーザーの依頼に応じて閲覧・操作するエージェント | 基本的に無視する(ユーザー起点) | user-triggered-agents.json。一部のリクエストはWeb Bot Authで署名 | Googleのユーザー起点フェッチャー | |
| Google-GeminiNotebook | ユーザー起点 | ユーザーがGemini Notebookにソースとして追加したURLを取得(旧エージェントGoogle-NotebookLMは2026年8月までサポート) | 基本的に無視する(ユーザー起点) | ユーザー起点フェッチャーのJSONリスト | Googleのユーザー起点フェッチャー | |
| Bingbot | Microsoft | 検索用 | Bingのインデックス。Copilotの回答のグラウンディングにも使われる | 従う。AIでの利用はページ単位のnoarchive/nocacheで制御 | bingbot.jsonまたはBingのVerify Bingbotツール | Bing Webmasterブログ |
| Applebot | Apple | 検索用(学習にも使われる場合あり) | Spotlight、Siri、Safariの検索。データがAppleのモデルの学習に使われる場合もある | 従う。Applebotの記載がなければGooglebotのルールに従う。Crawl-delayは無視 | 逆引きDNS(*.applebot.apple.com)またはapplebot.json | Applebotについて |
| Applebot-Extended | Apple | 制御用トークン | Appleの基盤モデルの学習からコンテンツをオプトアウト | トークンのみ | 該当なし | Applebotについて |
| Meta-ExternalAgent | Meta | 学習用 | AI基盤モデルの学習、またはコンテンツの直接インデックス | 従う | ユーザーエージェントとMetaの公開IP | MetaのWebクローラー |
| Meta-WebIndexer | Meta | 検索用 | Meta AIの検索結果を改善し、Meta AIがあなたを引用・リンクできるようにする | 従う | ユーザーエージェントとMetaの公開IP | MetaのWebクローラー |
| Meta-ExternalFetcher | Meta | ユーザー起点 | エージェント型タスクを含め、ユーザーの依頼に応じてリンクを取得 | 回避する場合がある | ユーザーエージェントとMetaの公開IP | MetaのWebクローラー |
| Amazonbot | Amazon | 学習用 | Amazonの製品改善。AmazonのAIモデルの学習に使われる場合がある | 従う(RFC 9309)。Crawl-delayは無視 | 公開IPページ | Amazonbot |
| Amzn-SearchBot | Amazon | 検索用 | Alexaなどの検索体験。学習には使われない | 従う。名前の記載がなければ他の検索ボット向けのルールを引き継ぐ | 公開IPページ | Amazonbot |
| Amzn-User | Amazon | ユーザー起点 | Alexaへの質問に応じて最新情報を取得。学習には使われない | すべてのディレクティブには従わない場合がある | 公開IPページ | Amazonbot |
| MistralAI-Training | Mistral | 学習用 | Mistralモデルの学習用データセットを構築 | 従う。Disallowで拒否可能 | ユーザーエージェント | Mistralのクローラー |
| MistralAI-Index | Mistral | 検索用 | VibeでのMistral検索のためにコンテンツをインデックス。学習には使われない | 従う | mistralai-index-ips.json | Mistralのクローラー |
| MistralAI-User | Mistral | ユーザー起点 | Vibeのユーザーが質問したときにページを訪問 | 従う。ユーザーのリクエストがどのサイトに届くかを制御 | mistralai-user-ips.json | Mistralのクローラー |
| DuckAssistBot | DuckDuckGo | 検索用(リアルタイム) | DuckDuckGoのAIアシスト回答のためにページをクロール。学習には使われない | 従う。反映まで72時間 | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | 学習用(オープンデータセット) | モデル学習に広く使われるオープンなCommon Crawlコーパスを構築 | 従う | 逆引きDNS(*.crawl.commoncrawl.org、IPv4のみ) | CCBot |
この表ではっきりすることが2つあります。1つ目は、Anthropicの現行ページに載っているボットはClaudeBot、Claude-SearchBot、Claude-Userのちょうど3つだということ。古い一覧にはいまだに「anthropic-ai」や「Claude-Web」が載っていますが、2026年10月時点のAnthropicのドキュメントにはどちらも出てきません。2つ目は、OpenAIのバージョン番号は変わるということ。確認した当日、OpenAIの例示文字列はGPTBot/1.4とOAI-SearchBot/1.4でした。マッチングは必ずトークンで行い、文字列全体では行わないでください。
公式ドキュメントのないボット
ログに現れるボットの中には、2026年10月18日時点で運営元のページが見つからなかったものもあります。代表的なのはByteDanceのBytespiderで、xAIのGrok関連のエージェントもその1つです。サードパーティのディレクトリでも挙動についての情報が食い違っているため、検証済みの表からは外しました。なお、Cloudflareのマネージドrobots.txtにはBytespiderのdisallowが含まれており、CloudflareはAIクローリングに占めるBytespiderのシェアが2024年半ばから2025年半ばにかけて14.1%から2.4%に下がったと報告しています。これらのボットが気になる場合は、robots.txtに頼らず、WAFのルールでポリシーを強制しましょう。
AIクローラーはrobots.txtを守るのか?
ドキュメントのある学習用・検索用クローラーは「守る」としています。ユーザー起点のフェッチャーは「守らない」と書いていることが多いです。そして、robots.txtはそもそもアクセス制御ではありません。規格そのものであるRFC 9309にも、「these rules are not a form of access authorization」(これらのルールはアクセス認可の手段ではない)と書かれています。さらにクローラーはファイルを最大24時間キャッシュしてよいことになっているため、どの運営元も変更が反映されるまでの時間を示しています。
とはいえ、「守る」という主張と実際の挙動は別物です。2025年8月、Cloudflareは、すべてをdisallowにした新規ドメインの内容を、それでもPerplexityが詳しく説明できたというテスト結果を公開しました。Cloudflareによると、Perplexity-Userを名乗るエージェントが1日あたり2,000万〜2,500万件、正体を明かさないChrome風のエージェントが300万〜600万件のリクエストを送っていたことを確認し、その後Perplexityを検証済みボットのリストから外しました。1社が1つの運営元について出した調査結果ではありますが、ユーザーエージェントの文字列だけでは何の証明にもならないことがよくわかります。
| 運営元 | robots.txtの変更が反映されるまで(ドキュメント上) | Crawl-delay |
|---|---|---|
| OpenAI(OAI-SearchBot) | 約24時間 | 記載なし |
| Perplexity | 最大24時間 | 記載なし |
| Amazon | 約24時間。最大30日前のキャッシュを使う場合あり | 非対応 |
| Meta | 最大24時間 | 記載なし |
| DuckDuckGo(DuckAssistBot) | 72時間 | 記載なし |
| Anthropic | 記載なし | 対応 |
| Apple | 記載なし | 非対応 |
クラスごとにブロックすると何を失うのか?
学習用クローラーをブロックしても、現時点の可視性への影響は小さめです。一方、検索用クローラーやユーザー起点のフェッチャーをブロックすると、すぐに引用を失います。次の表は、各クラスと、運営元自身が説明しているブロックの代償をまとめたものです。
| ブロックする対象 | 入らなくなるもの | 失うもの | 引き続き表示される場所 |
|---|---|---|---|
| 学習用クローラー(GPTBot、ClaudeBot、Meta-ExternalAgent、Amazonbot、CCBot、Google-Extended、Applebot-Extended) | その運営元の今後の学習データセット | 短期的な可視性への影響は小さい。ただし今後のモデルが、検索なしでどれだけあなたのブランドを「知っている」かには影響する可能性がある | 各社の検索ボットを許可している限り、ChatGPT検索、Claudeの検索、Perplexity、Google検索とAI Overviews |
| AI検索用クローラー(OAI-SearchBot、Claude-SearchBot、PerplexityBot、Meta-WebIndexer、Amzn-SearchBot、MistralAI-Index、DuckAssistBot) | そのエンジンの検索インデックス | そのエンジンの回答での引用とリンク。OpenAIの場合はナビゲーション用リンクのみ残る | 従来型の検索エンジン(そちらもブロックしない限り) |
| ユーザー起点のフェッチャー(ChatGPT-User、Claude-User、Perplexity-User、MistralAI-User) | ユーザーが依頼したリアルタイム取得(運営元が従う場合) | ユーザーがあなたのURLを貼り付けたり質問したりしたときの回答。購入や予約などのエージェントタスク | 検索ボットを許可していれば、インデックスに基づく回答 |
| Googlebot | Google検索全体 | オーガニック順位、AI Overviews、AI Modeのすべて | Google上にはどこにも表示されない。ほとんどの場合、望む結果ではない |
やり取りの規模も重要です。Cloudflareは、各AIプラットフォームが送客する訪問者1人あたり何ページをクロールしているかを測定しました。2025年7月時点で、Anthropicは送客1人あたり約38,000回、Perplexityは194回でした。この比率こそ、パブリッシャーが「検索用クローラーは開けたまま、学習用クローラーはブロックする」と主張する経済的な根拠になっています。
どのAIクローラーを許可・ブロックすべきか?ビジネス目的別の判断マトリクス
まずは自社が何を売っているかから考えましょう。AIアシスタントにおすすめされることで顧客を獲得できるなら、検索用クローラーとユーザー起点のフェッチャーはすべて許可し、学習用については別の、比較的小さな判断として扱います。
| あなたの状況 | 学習用クローラー | 検索用クローラー | ユーザー起点のフェッチャーとエージェント | 理由 |
|---|---|---|---|---|
| BtoB SaaS、代理店、地域密着型サービス | 許可(ブロックしても代償は小さい) | 許可 | 許可 | 購買担当者はAIの回答でベンダーを絞り込む。モデルの知識に入っていれば、指名されていない場面での言及にも効く |
| EC | 判断はお任せ | 許可 | 許可し、さらにWAFで署名付きエージェントを許可リストに追加 | ショッピング系の回答は商品ページを引用し、エージェントはカートや決済画面にたどり着く必要がある |
| ニュースメディア、広告収益型のパブリッシャー | ブロック | 許可、または広告のあるページではブロック | 運営元ごとに判断 | コンテンツそのものが商品。それでも引用からは一定の読者が戻ってくる |
| 開発者向けドキュメント、オープンソースプロジェクト | 許可 | 許可 | 許可 | 開発者はAPIの使い方をアシスタントに尋ねる。モデルの知識が正確ならサポートの負担が減る |
| 有料会員限定・ライセンスコンテンツ | ブロック | 目次・一覧ページのみ許可 | ライセンス上必要ならWAFでブロック | 導入部分は引用可能にし、全文は出さない |
| ステージング環境、イントラネット、非公開アプリ | ブロック | ブロック | ブロック | 認証を使う。robots.txtはお願いであって鍵ではない |
| クロール負荷に苦しむサーバー | レート制限またはブロック | 許可し、CDNでレート制限 | 許可 | 引用を失うのではなく、エッジで負荷を解決する |
robots.txtでAIの学習用クローラーだけをブロックし、AI検索は許可するには?
学習用のトークンごとにDisallow: /付きのグループを用意し、検索用クローラーは通常のルールに任せます。クローラーは自分の名前が書かれた最も具体的なグループにしか従わないので、学習用のブロックが検索ボットに波及することはありません。
スニペット1:学習はブロックし、AI検索とユーザー起点のフェッチャーは残す
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309では、複数のUser-agent行で1つのグループを共有でき、マッチングは大文字・小文字を区別しません。OAI-SearchBot、Claude-SearchBot、PerplexityBot、Googlebot、Bingbotは*のグループに該当し、許可されたままになります。
スニペット2:AI検索に対して明示的に開放する
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/検索ボットを名前で指定しておけば、将来ほかの誰かが書いた一括ルール、たとえばUser-agent: *にDisallow: /を追加するプラグインなどから身を守れます。非公開パスはこのグループの中でもdisallowにしておきましょう。名前を指定したグループは、そのボットにとって*のグループに追加されるのではなく、置き換わるからです。
スニペット3:実際のファイルを壊す3つの落とし穴
- ApplebotはGooglebotのルールを引き継ぎます。Appleによると、ファイルにApplebotの記載がなくGooglebotの記載がある場合、ApplebotはGooglebotのグループに従います。Googlebot向けのブロックが、知らないうちにSiriやSpotlightからあなたを消してしまうことがあります。
- Amzn-SearchBotは、名前の記載がなければ他の検索ボットのルールを引き継ぎます(Amazonによる)。違う扱いにしたいなら名前を書きましょう。
- サブドメインには専用のファイルが必要です。AnthropicもAmazonもrobots.txtはホストごとに読むとしているので、
docs.example.comには個別のファイルが要ります。
こうしたグループは、AI Rank Labの無料robots.txtジェネレーターで作成・チェックできます。フルアクセスや選択的アクセスの設定をさらに詳しく知りたい方は、以前の記事AIクローラー向けrobots.txtテンプレートもご覧ください。
AIクローラーが本物か、なりすましかを確認するには?
ユーザーエージェントだけを信用してはいけません。ヘッダーに「GPTBot」と書くことは誰にでもできますし、Common Crawlも自社のページで、CCBotを名乗る偽のクローラーがいると注意喚起しています。運営元が対応している検証方法は3つあり、どれを使うかは運営元によって異なります。
- 逆引きDNSのあとに正引きDNS。ログに残っているIPに対して
hostを実行し、ホスト名が運営元のドメインで終わっているかを確認します。次にそのホスト名に対してhostを実行し、同じIPが返ってくることを確かめます。Googleは検証ガイドでgooglebot.com、google.com、googleusercontent.comについてこの方法を説明しています。Appleは*.applebot.apple.com、Common Crawlは*.crawl.commoncrawl.org(IPv4のみ)です。 - IPを運営元の公開リストと照合する。OpenAI、Anthropic、Perplexity、Google、Apple、Microsoft、DuckDuckGo、Mistral、AmazonはIPレンジを公開しています。逆引きDNSのパターンを公開していないOpenAI、Anthropic、Perplexityについては、これが唯一の方法です。
- 暗号署名(Web Bot Auth)を確認する。OpenAIのChatGPT Cloud browserはリクエストに署名しており、RFC 9421に基づき、
Signature-Agentヘッダーの値は"https://chatgpt.com"です。Googleも同じIETFドラフトを一部のGoogle-Agentのリクエストでテスト中で、署名はhttps://agent.bot.googです。GoogleのWeb Bot Authのページでは、すべてのリクエストが署名されているわけではないため、IPチェックを代替手段として残しておくよう案内しています。
# 逆引きのあとに正引き(Googleの例)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# OpenAIの検索クローラーのIPリストチェック
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
公開IPリストはどれくらい新しい?
2026年10月18日に、公開されているAIクローラーのIPファイルをすべてダウンロードし、各運営元がファイル内に書き込んでいるcreationTimeフィールドを確認しました。日付が古いのは単にレンジが変わっていないだけかもしれません。それでも、ハードコードした許可リストをどこまで信用できるかの目安になりますし、運営元が申告していないトラフィックをカバーできないリストがどれかもわかります。
| 公開リスト | ファイル内のcreationTime | IPv4 / IPv6プレフィックス数 |
|---|---|---|
| Googleの一般的なクローラー(Googlebot、Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Googleのユーザー起点エージェント(Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic(3つのボットすべて、1つのリスト) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
実務上の教訓は2つです。GoogleとOpenAIのChatGPT-Userのリストは直近2週間以内に更新されているので、夏にコピーしたファイアウォールの許可リストは、おそらくもう古くなっています。これらのファイルは毎日か毎週取得し直しましょう。また、AnthropicはIPをブロックすると自社がrobots.txtを読めなくなるため、「may not work correctly or persistently guarantee an opt-out」(正しく機能しない、あるいはオプトアウトを継続的に保証できない可能性がある)としています。オプトアウトにはrobots.txtを使い、IPは検証だけに使いましょう。
AIクローラーの動きはどう把握する?サーバーログかJavaScriptタグか
クローラーにはサーバーやCDNのログを、AIアシスタント経由で訪れる人間の訪問者にはJavaScriptのアクセス解析を使いましょう。JSタグは、何かがページのJavaScriptを実行したときにしか動きません。そしてほとんどのAIクローラーは実行しません。Vercelが自社ネットワークを分析したところ、主要なAIクローラーはどれもJavaScriptをレンダリングしていませんでした。ChatGPTとClaudeのクローラーはJSファイルを取得してはいたものの(リクエストのそれぞれ11.50%と23.84%)、実行はしていなかったのです。例外は、Googlebotのレンダリングを使うGeminiと、Applebotでした。この調査は2024年12月のものなので、自分のサイトで改めて確認すべきですが、私たちが見ている傾向とも一致しています。
Google Analyticsは、設計上このギャップをさらに広げます。GA4は既知のボットやスパイダーからのトラフィックを自動的に除外しており、この機能はオフにできず、どれだけ除外されたかも確認できません。GA4はAI経由の参照トラフィックを見るには適したツールで、その方法はGA4でAI経由の参照トラフィックを計測する方法で解説していますが、クローラーを数えるには向いていません。
AI Rank Lab自身のトラッキングデータでも同じ傾向が見られます。私たちのJavaScriptタグは、ChatGPT、Gemini、Perplexity、Claudeからクリックして訪れた人は確実に記録しますが、クローラーのトラフィックはごく一部しか見えず、しかも全体を代表するものではありません。そのため、このタグのデータからクローラー数は公表していません。
5分でできるログチェック
- ホスティング会社やCDNから、1日分の生のアクセスログをダウンロードします(NginxもApacheも、デフォルトのcombined形式でユーザーエージェントを記録します)。
- AIトークンごとのリクエスト数を数えます:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - 上位のトークンについてステータスコードを確認します。403や429がずらりと並んでいるなら、たいていはrobots.txtで許可しているボットをWAFやCDNのルールがブロックしています。
- どの数字も、上記の方法でIPのサンプルを検証してから信用しましょう。
- 検索ボットがどのURLをリクエストしているかを確認します。OAI-SearchBotやClaude-SearchBotがトップページしか取得していないなら、内部リンクとサイトマップを見直しましょう。
AIクローラーの動きを可視化できるツール
開示:AI Rank Labは当社の製品です。当社サイトのため最初に掲載していますが、以下のすべてのツールに同じ基準を適用しています。
- AI Rank Lab - AIボットトラッキングは、AIアシスタントからの参照と、タグで把握できる範囲のAIボットの訪問をページごとに記録し、AIでの可視性や引用のトラッキングと並べて表示します。上で説明した理由から、クローラーの全数を把握するにはログと組み合わせてください。
- Cloudflare AI Crawl Control - サイトがCloudflareを経由しているなら、これが最も網羅的なクローラーの可視化手段です。JavaScriptを実行しないボットも含め、エッジですべてのリクエストを見られるからです。クローラーごとのrobots.txt遵守状況も表示されます。
- ログファイル解析ツール(Screaming FrogのLog File AnalyserやGoAccessなど) - どのホストの生ログにも使え、単発の監査に強みがあります。
- 生ログと上記のgrep - 無料で正確。ほかのどのツールも、この数字と一致すべき基準値です。
主要3ボットを軸にした、より踏み込んだモニタリング手順は、GPTBot・ClaudeBot・PerplexityBotモニタリングガイドをご覧ください。
CloudflareなどのCDNはAIボットをどう制御する?
robots.txtではお願いすることしかできないことを、CDNはネットワークのエッジで強制します。CloudflareのAI Crawl Controlは全プランで使え、どのAIサービスがサイトにアクセスしているかを表示し、クローラーごとに許可・ブロックを設定でき、robots.txt違反を追跡し、プライベートベータとしてpay per crawl(クロール単位の課金)も提供しています。
CloudflareのAIボットポリシーは、いまやこの記事と同じ3分類を採用しています。Block AI Botsの設定には、Search、Agent、Trainingの別々のプリセットがあり、それぞれ「全ページでブロック」「広告のあるページでブロック」「許可」を選べます。ドキュメントによると、2026年9月15日以降、新規ドメインには更新されたデフォルトが適用されます。具体的には、TrainingとAgentのボットは広告を表示するページでブロック、Searchは許可、そして検索と学習を兼ねる多目的クローラーは学習のブロックが1つでもあればブロックされます。この日以降にサイトをCloudflareに載せて、ブログでChatGPT-UserやClaude-Userに403が返る理由がわからないなら、まずこの設定を確認してください。
Cloudflareはrobots.txtの管理も代行できます。Bot Preference Syncをオンにすると、マネージドrobots.txtが既存のルールの前に、Amazonbot、Applebot-Extended、Bytespider、CCBot、ClaudeBot、Google-Extended、GPTBot、meta-externalagent向けのdisallowグループと、Content Signalsの行(search=yes, ai-train=no)を追加します。Content SignalsはCloudflareが提案している語彙(search、ai-input、ai-train)で、取得後のコンテンツをどう使ってよいかを示すものです。それに従うかどうかは、各運営元次第です。
ほかのプロバイダーも同じパターンに対応しています。PerplexityのドキュメントにはIPリストを使ったCloudflareとAWS WAF向けのWAF設定ガイドがあり、OpenAIのヘルプセンターでは、署名付きのCloud browserをAkamai(ボット名「ChatGPT Agent」)とCloudflare(検出ID 129220581)で許可リストに登録する方法を紹介しています。どのCDNを使っていても、手順は同じです。クラスごとに方針を決め、robots.txtで表現し、確実なブロックが必要な箇所だけエッジで強制し、CDNの設定を変えたらログを再確認しましょう。
GoogleとBing:2つの特殊なケース
Google-ExtendedをブロックするとGoogle検索やAI Overviewsに影響する?
影響しません。Googleは、Google-Extendedが「does not impact a site's inclusion in Google Search nor is it used as a ranking signal」(Google検索へのサイトの掲載に影響せず、ランキングシグナルとしても使われない)と明言しています。GoogleのAI機能に関するドキュメントでも、AI OverviewsやAI Modeを含む検索を制御するのはGooglebot向けのrobots.txtルールであり、表示内容を制限するにはnosnippet、data-nosnippet、max-snippet、noindexを使うと明記されています。Google-ExtendedがカバーするのはGeminiモデルの学習と、GeminiアプリおよびVertex AIでのグラウンディングで、これらは検索とは別物です。
Microsoft Copilotにコンテンツを使わせるかどうかはどう制御する?
MicrosoftにはAI専用のクローラートークンがありません。クロールはBingbotが行い、AIでの利用はページ単位のrobotsメタタグで制御します。私たちが見つけた最新の公式ガイダンスは、CopilotがまだBing Chatと呼ばれていた2023年のBingチームの発表です。それによると、noarchiveを付けたコンテンツはBingのチャット回答に含まれず、リンクもされず、Microsoftの基盤モデルの学習にも使われません。nocacheを付けたコンテンツは、URL、タイトル、スニペットのみ表示される可能性があります。どちらのタグもないコンテンツは全面的に利用されることがあります。どちらのタグを付けても、通常のBing検索結果には残ります。robots.txtでBingbotをブロックするとBing検索からも消えてしまうので、メタタグを使いましょう。
調査の限界と確認方法
2026年10月18日に、上に挙げた各運営元のクローラーページを読み、公開されているIPリストをすべてダウンロードし、各ファイル内のcreationTimeを記録しました。MicrosoftのクローラーヘルプページはJavaScriptでしか表示されずレンダリングできなかったため、Bingbotの行はMicrosoftのBing Webmasterブログ、Verify Bingbotツール、公開されているbingbot.jsonに基づいています。robots.txtの列は各運営元の説明を要約したもので、私たちが独自に測定したものではありません。両者が食い違いうることを示す主な公開証拠が、CloudflareによるPerplexityの調査結果です。運営元はボットの名前変更や追加を頻繁に行うため(たとえばGoogleはGoogle-NotebookLMのフェッチャートークンをGoogle-GeminiNotebookに置き換えました)、この一覧も含め、どんなリストも確認日時点で正確なものとして扱ってください。
クローラーのポリシーが実際に引用につながっているかを知りたいなら、AI Rank LabがChatGPT、Claude、Gemini、Perplexity、Google AI Overviews、AI Modeでのあなたの言及と引用ページを、それらの回答から届くAI経由の参照トラフィックと並べてトラッキングします。
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


