



De discussie rond llms.txt: echt signaal of placebo?
Sinds de llms.txt-specificatie werd voorgesteld, is de SEO- en AEO-wereld verdeeld. Voorstanders zien het als een helder signaal aan AI-systemen over wat je site is en waar die over gaat: precies het soort gestructureerde sturing dat een citatiebeslissing jouw kant op kan laten vallen. Sceptici vinden het te nieuw om echt verschil te maken, wijzen erop dat maar weinig AI-systemen het formeel ondersteunen, en denken dat de citatiewinst die aan llms.txt wordt toegeschreven eigenlijk komt van de contentverbeteringen die teams tegelijk doorvoeren.
Wij wilden verder dan speculatie. Met de citatietracking van AI Rank Lab analyseerden we 500 sites voor en na het toevoegen van een llms.txt-bestand. Gedurende 90 dagen volgden we hoe vaak ze werden geciteerd door ChatGPT (GPT-4o), Perplexity en Claude 3.5 Sonnet. We keken ook naar wat sites met een grote citatiewinst onderscheidde van sites waar weinig veranderde.
Dit is wat we vonden, inclusief de punten die de meest optimistische claims over llms.txt onderuit halen.
Het onderzoek onder 500 sites: zo hebben we gemeten
We volgden 500 domeinen die tijdens een analyseperiode van zes maanden voor het eerst llms.txt toevoegden. Alle domeinen:
- gaven AI-crawlers al toegang (GPTBot, ClaudeBot en PerplexityBot toegestaan in robots.txt)
- hadden minstens 30 dagen aan nulmetingsdata over citaties voordat ze llms.txt toevoegden
- voerden tijdens de meetperiode geen grote contentwijzigingen door en kregen er geen noemenswaardige nieuwe backlinks bij
- hadden 10-500 pagina's (heel kleine en heel grote sites lieten we weg om verstorende factoren te beperken)
Het citatiepercentage definieerden we als het aantal keer dat een LLM een domein citeerde bij een vraag binnen het belangrijkste onderwerpcluster van dat domein, uitgedrukt als percentage van de geteste vragen. Per domein en per LLM testten we 50 vragen, gekozen uit de belangrijkste zoekwoorden van het domein.
De sites kwamen uit 12 branches: SaaS, e-commerce, lokale dienstverlening, zakelijke dienstverlening (B2B), uitgeverij, zorg, juridisch, financiële dienstverlening, onderwijs, vastgoed, reizen en technieuws.
Bevinding 1: llms.txt verhoogt het citatiepercentage, maar niet bij elke LLM
Over alle 500 sites zagen we in de 90 dagen na het toevoegen van llms.txt deze gemiddelde veranderingen in citatiepercentage:
- Perplexity: gemiddeld +18% hoger citatiepercentage
- ChatGPT (met Browse): gemiddeld +12% hoger citatiepercentage
- Claude: gemiddeld +7% hoger citatiepercentage
- ChatGPT (zonder Browse, basismodel GPT-4o): +3% (niet statistisch significant)
De verschillen per LLM zijn groot en niet volledig te verklaren door ander crawlgedrag. Dat Perplexity sterker reageert, komt waarschijnlijk door de realtime webzoekarchitectuur: het gebruikt gestructureerde sturingsbestanden actief bij het opstellen van antwoorden. De Browse-modus van ChatGPT (die live webcontent ophaalt) laat een duidelijke verbetering zien, terwijl het basismodel GPT-4o, dat vooral op trainingsdata leunt, nauwelijks reageert op één extra bestand.
De matige verbetering bij Claude past bij de gepubliceerde aanpak van Anthropic: ClaudeBot crawlt sturingsbestanden en respecteert ze, maar de trainingsdata van Claude worden minder vaak ververst dan de realtime retrieval van Perplexity. Het effect is echt, alleen komt het later.
Bevinding 2: de kwaliteit van je llms.txt-samenvatting maakt het grootste verschil
De sites met de grootste citatiewinst (het bovenste kwartiel, gemiddeld +31% hoger citatiepercentage) hadden één ding gemeen: een heel specifieke samenvatting in een blockquote, die duidelijk beschreef wat hen onderscheidt, voor wie ze er zijn en welke onderwerpen ze behandelen.
We beoordeelden de llms.txt-samenvatting van elke site op vijf criteria:
- Specifieke doelgroep (voor wie is dit?)
- Duidelijk onderscheid (wat maakt deze site anders?)
- Volledige onderwerpdekking (welke onderwerpen behandelt deze site?)
- Signalen van autoriteit (alles wat geloofwaardigheid geeft: data, expertise, methodologie)
- Handelingscontext (wat kunnen lezers met deze site doen?)
Sites die 4-5 scoorden op dit schema, kregen gemiddeld +27% citatieverbetering. Sites met een score van 1-2 kwamen gemiddeld op maar +6%, nauwelijks boven de ruis. Het bestandsformaat doet er veel minder toe dan de inhoud van de samenvatting.
Een voorbeeld van een samenvatting met een hoge en een lage score:
Lage score (1 van 5 criteria):
"Example Corp biedt marketingtools en resources voor bedrijven."
Hoge score (5 van 5 criteria):
"Example Corp is een B2B-platform voor marketingattributie dat wordt gebruikt door 2.000+ SaaS-bedrijven in het middensegment om de bijdrage aan de pipeline te meten vanuit dark social-kanalen (LinkedIn, vermeldingen in podcasts, communityfora) die standaard UTM-attributie mist. Belangrijkste toepassingen: VP's Marketing die aan de raad van bestuur rapporteren over niet-traceerbare pipeline, en demand gen-teams die hun uitgaven aan dark social onderbouwen."
Het voorbeeld met de hoge score benoemt de doelgroep (VP's Marketing en demand gen-teams bij SaaS-bedrijven in het middensegment), het onderscheid (attributie van dark social), autoriteit (2.000+ bedrijven) en handelingscontext (rapportage aan de raad van bestuur, onderbouwing van budget). Een AI-systeem dat dit leest, kan het product correct beschrijven zodra iemand vraagt naar tools voor marketingattributie voor SaaS-bedrijven.
Bevinding 3: paginaoverzichten zorgen voor citaties op longtail-vragen
Sites die in hun llms.txt ook uitgebreide paginaoverzichten opnamen (en niet alleen de samenvatting), zagen extra citatiewinst op longtail-vragen: vragen over specifieke functies, toepassingen of onderwerpen die op de vermelde pagina's worden behandeld.
Het effect was het sterkst bij pagina's waar intern weinig naar wordt gelinkt. Voor die "verweesde maar belangrijke" pagina's, zoals toolpagina's, technische documentatie en nichegidsen, was een vermelding in het paginaoverzicht van llms.txt de belangrijkste manier waarop AI-systemen leerden ze bij relevante vragen te citeren. Zonder die vermelding bleven deze pagina's grotendeels onzichtbaar voor AI-citaties, ondanks hun waardevolle inhoud.
Sites met 15+ goed beschreven pagina's in hun overzicht zagen +22% citatieverbetering op longtail-vragen, tegenover +9% voor sites zonder paginaoverzicht of met korte vermeldingen zonder beschrijving.
Bevinding 4: llms.txt alleen is niet genoeg
De belangrijkste negatieve bevinding: sites die AI-crawlers blokkeerden in robots.txt, zagen nul citatieverbetering na het toevoegen van llms.txt. Dat ligt voor de hand, maar het is goed om het hardop te zeggen: llms.txt helpt niet als AI-crawlers je site niet in mogen. Het bestand geeft sturing aan crawlers die al toegang hebben; het heft geen toegangsbeperkingen op.
Ook sites met dunne of zwakke content zagen weinig citatiewinst, zelfs met een sterk llms.txt-bestand. AI-systemen gaan slechte content niet vaker citeren omdat een bestand zegt dat die belangrijk is. Het bestand verbetert hoe AI-systemen je site begrijpen en doorlopen; de content zelf moet het citeren nog steeds waard zijn.
Wil je het volledige plaatje van wat AI-citaties bepaalt, lees dan de gids voor optimalisatie voor AI-zoekmachines. llms.txt is een van meerdere signalen die samenwerken, geen oplossing op zichzelf.
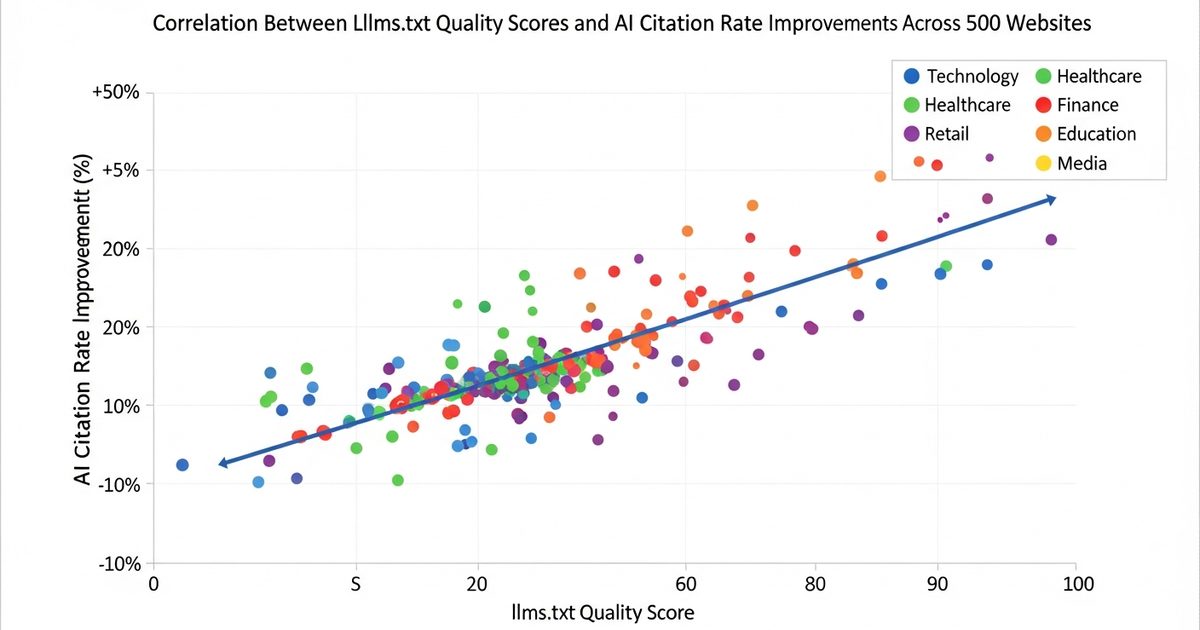
Per branche: wie heeft het meest aan llms.txt?
Hoeveel llms.txt de citaties verbeterde, verschilde sterk per branche:
Grootste winst (gemiddeld +20-35% verbetering)
- SaaS en technologie: AI-systemen delen softwareproducten vaak verkeerd in of beschrijven ze onjuist. Een specifieke llms.txt-samenvatting rekent effectief af met die misvattingen.
- Financiële dienstverlening: AI-systemen zijn voorzichtig met het citeren van financiële content zonder duidelijke signalen van autoriteit. Een llms.txt met vergunningen en registraties, een beschrijving van de methodologie of beroepskwalificaties verhoogt het citatiepercentage meetbaar.
- Zorg en medisch: Hetzelfde patroon als bij financiële dienstverlening: signalen van autoriteit in de samenvatting verhogen het citatiepercentage flink voor gezondheidssites met aantoonbare expertise.
Gemiddelde winst (gemiddeld +8-18% verbetering)
- Zakelijke dienstverlening (B2B): Complexe diensten die op basis van content alleen lastig in te delen zijn, hebben baat bij een expliciete beschrijving, maar de winst blijft gematigd.
- Onderwijs: Een heldere beschrijving van de behandelde onderwerpen helpt AI-systemen educatieve content te koppelen aan specifieke leervragen.
- Uitgeverij en nieuws: Profiteren vooral van sturing over actualiteit (aangeven welke secties vaak worden bijgewerkt), niet zozeer van de samenvatting zelf.
Kleinste winst (gemiddeld +3-8% verbetering)
- E-commerce: AI-systemen begrijpen productpagina's al goed dankzij gestructureerde data (Product-schema). Als je schema volledig is, voegt llms.txt minder toe.
- Lokale dienstverlening: Citatiepatronen voor lokale diensten worden veel sterker bepaald door reviews en consistente NAW-gegevens (NAP) dan door sturing via llms.txt.
Waar de sceptici gelijk hebben
Onze data bevestigen een aantal sceptische claims over llms.txt:
Het is geen garantie op citaties. Zelfs het bovenste kwartiel zag +31% verbetering, en dat is ten opzichte van een uitgangspunt. Sites met een citatiepercentage van 10% gingen naar ~13%. Geen revolutie, wel een betekenisvolle verbetering die zich in de loop van de tijd opstapelt.
Betere content weegt zwaarder. We vergeleken sites die alleen llms.txt toevoegden met sites die tegelijk hun content verbeterden (betere antwoorden in FAQ's, specifiekere gestructureerde data). De groep met contentverbeteringen zag 2,4x zoveel citatiewinst als de groep met alleen llms.txt. llms.txt versterkt goede content, maar vervangt die niet.
Niet elke LLM reageert even sterk. Bij het basismodel van ChatGPT (zonder Browse) is het effect klein. Worden jouw doelvragen vooral afgehandeld door modellen die op trainingsdata leunen in plaats van realtime retrieval, dan gaat de winst van llms.txt langzamer en is die lastiger te meten.
Ons advies
Op basis van de data raden we het volgende aan:
- Implementeer llms.txt als je dat nog niet hebt gedaan: de mogelijke winst is echt, de implementatie kost weinig (30-60 minuten voor een goed bestand) en er is geen nadeel
- Geef de samenvatting prioriteit: hier komt 70% van de citatiewinst vandaan, dus steek je tijd in een specifieke, onderscheidende beschrijving die op je doelgroep is gericht
- Neem je belangrijke, slecht gelinkte pagina's op: vooral toolpagina's, documentatie en onderwerpgerichte gidsen waar intern weinig naar wordt gelinkt
- Herstel eerst je robots.txt als AI-crawlers geblokkeerd zijn: llms.txt op een geblokkeerde site doet niets
- Combineer het met verbeteringen aan content en schema: llms.txt werkt het best als onderdeel van een complete AEO-strategie, niet als losse fix
Maak je bestand met de gratis llms.txt-generator van AI Rank Lab en gebruik de volledige audittool om te controleren of je huidige llms.txt goed is opgebouwd en of het samen met je andere AEO-signalen zijn werk doet.
Conclusie
llms.txt heeft een echt, meetbaar effect op hoe vaak AI je site citeert: vooral bij Perplexity en ChatGPT Browse, vooral voor sites met complexe of makkelijk verkeerd ingedeelde producten en diensten, en vooral als de samenvatting specifiek en onderscheidend is. Het bestand is geen wondermiddel. Het maakt zwakke content niet citeerwaardig en omzeilt geen geblokkeerde crawlers. Maar als onderdeel van een complete AEO-strategie is het die investering van 30 minuten ruimschoots waard.
De belangrijkste les: de kwaliteit van je llms.txt-samenvatting telt veel zwaarder dan het feit dat het bestand er staat. Een generieke beschrijving van twee zinnen levert weinig op. Een specifieke samenvatting die op je doelgroep is gericht, met signalen van autoriteit en een duidelijk onderscheid, zorgt voor merkbaar meer citaties bij de LLM's die het ondersteunen.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


