



Waarom je robots.txt in 2026 belangrijker is dan ooit
Het robots.txt-bestand is in 1994 bedacht om webcrawlers te vertellen welke pagina's ze moeten overslaan. Dertig jaar lang hoefden webmasters zich eigenlijk maar om één grote crawlerfamilie te bekommeren: Googlebot. In 2026 is dat lijstje flink gegroeid. AI-bedrijven als OpenAI, Anthropic, Perplexity en Google draaien allemaal eigen crawlers die je content lezen om modellen te trainen, kennisbanken op te bouwen en antwoorden in AI-zoekmachines te genereren.
Of je deze crawlers toelaat of blokkeert, heeft direct gevolgen voor je vindbaarheid in AI-zoekmachines. Kan GPTBot je site niet crawlen, dan speelt je content geen rol in de antwoorden van ChatGPT. Blokkeer je PerplexityBot, dan kan Perplexity je pagina's niet citeren. En staat Google-Extended op slot, dan verschijnt je content mogelijk niet in AI Overviews (de AI-overzichten van Google) en in AI Mode.
Om robots.txt goed in te richten voor het tijdperk van AI-crawlers, moet je weten welke bots er zijn, wat ze doen en hoe je toegang zo regelt dat je content beschermd blijft en je toch zoveel mogelijk kans maakt op AI-citaties. Dat behandelen we hier allemaal, inclusief een gratis robots.txt-generator waarmee je in een paar minuten een AI-klare configuratie maakt.
Overzicht van alle AI-crawlers
Voordat je iets configureert, moet je weten welke bots je aanspreekt. Dit zijn de belangrijkste AI-crawlers en hun user agents in 2026:
OpenAI - ChatGPT
- User-agent: GPTBot
- Doel: trainingsdata verzamelen en de Browse-functie van ChatGPT
- Gevolg van blokkeren: je content speelt geen rol in ChatGPT-antwoorden en verschijnt niet in de bronvermeldingen van ChatGPT Browse
- Documentatie: OpenAI houdt een openbare lijst bij van de IP-ranges van GPTBot
Anthropic - Claude
- User-agent: ClaudeBot (ook bekend als anthropic-ai)
- Doel: trainingsdata en kennisbank voor Claude
- Gevolg van blokkeren: je content speelt geen rol in de antwoorden van Claude als gebruikers vragen stellen over jouw vakgebied
- Documentatie: Anthropic heeft zijn crawlbeleid gepubliceerd en respecteert robots.txt-instructies
Perplexity AI
- User-agent: PerplexityBot
- Doel: realtime zoeken op het web voor de antwoorden en bronvermeldingen van Perplexity AI
- Gevolg van blokkeren: je pagina's worden niet geciteerd in Perplexity-antwoorden, ook niet als ze zeer relevant zijn
- Documentatie: Perplexity respecteert robots.txt en heeft richtlijnen voor het crawlen gepubliceerd
Google - AI-functies
- User-agent: Google-Extended
- Doel: training van Google Bard/Gemini en content voor AI Overviews
- Gevolg van blokkeren: je content verschijnt mogelijk niet in AI Overviews, AI Mode of de antwoorden van Gemini
- Let op: dit staat los van Googlebot. Je kunt Googlebot (de gewone zoekmachine) toelaten en Google-Extended (de AI-functies) blokkeren
Microsoft - Copilot
- User-agent: Bingbot (gedeeld), Copilot-specifieke crawlers wisselen
- Doel: levert de antwoorden van Microsoft Copilot en de AI-antwoorden van Bing
- Gevolg van blokkeren: minder zichtbaarheid in Microsoft Copilot en de AI-functies van Bing
Meta - Llama
- User-agent: FacebookBot, Meta-ExternalAgent
- Doel: trainingsdata voor Meta AI en de Llama-modellen
- Gevolg van blokkeren: je content speelt geen rol in de antwoorden van Meta AI
Apple - Applebot
- User-agent: Applebot, Applebot-Extended
- Doel: Siri, Apple Intelligence en de zoekfuncties van Apple
- Gevolg van blokkeren: minder zichtbaarheid in Siri en de AI-functies van Apple
Het probleem: de meeste robots.txt-bestanden zijn geschreven vóór de komst van AI-crawlers
Een typisch robots.txt-bestand uit 2020-2023 ziet er zo uit:
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

Sitemap: https://example.com/sitemap.xml
Deze configuratie laat Googlebot toe, maar vertrouwt voor alle andere bots op de wildcardregel. Afhankelijk van hoe die wordt geïnterpreteerd, houdt de wildcardregel AI-crawlers misschien weg uit delen van je site, of laat hij ze juist overal toe, ook op pagina's die je liever afschermt.
Erger nog: sommige sites zijn in de beginperiode van AI-crawlers (2022-2023), toen de weerstand van uitgevers tegen het gebruik van hun content als trainingsdata op zijn hoogtepunt was, fors gaan blokkeren. Heeft jouw site toen Disallow: / voor alle bots toegevoegd, dan heb je AI-crawlers misschien buitengesloten en ben je dat vergeten. De gevolgen zie je pas als je merkt dat je merk ondervertegenwoordigd is in de antwoorden van AI-zoekmachines.
Met de AI-bottracking van AI Rank Lab zie je welke AI-bots je pagina's echt bezoeken en welke AI-assistenten verwijzend verkeer naar je sturen, zonder dat je zelf logbestanden hoeft te analyseren. Duikt een crawler die je wilde toelaten nooit op? Controleer dan de regels voor die crawler in je robots.txt.
Robots.txt-templates voor verschillende situaties
Gebruik onze gratis robots.txt-generator om deze templates aan te passen aan je site. Dit zijn de meest voorkomende configuraties:
Template 1: volledige toegang voor AI (aanbevolen voor de meeste sites)
Laat alle AI-crawlers bij je content. Het beste voor sites die maximaal zichtbaar willen zijn in AI-zoekmachines en er geen moeite mee hebben dat hun content wordt gebruikt om AI-modellen te trainen.
# Standard search crawlers
User-agent: *
Disallow: /admin/
Disallow: /private/
Disallow: /checkout/
Disallow: /account/

# Traditional search engines
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

# AI Crawlers - explicitly allowed
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

Sitemap: https://yoursite.com/sitemap.xml
Template 2: selectieve toegang voor AI (content beschermen)
Laat AI-crawlers toe op openbare contentpagina's, maar blokkeer premiumcontent, artikelen achter een betaalmuur en ledengedeeltes. Het beste voor uitgevers met abonnementen en sites met afgeschermde content.
User-agent: *
Disallow: /admin/
Disallow: /members/
Disallow: /premium/
Disallow: /checkout/

User-agent: Googlebot
Allow: /

# AI Crawlers - public content only
User-agent: GPTBot
Allow: /blog/
Allow: /resources/
Allow: /about/
Disallow: /premium/
Disallow: /members/

User-agent: ClaudeBot
Allow: /blog/
Allow: /resources/
Disallow: /premium/

User-agent: PerplexityBot
Allow: /
Disallow: /premium/
Disallow: /members/

User-agent: Google-Extended
Allow: /
Disallow: /premium/

Sitemap: https://yoursite.com/sitemap.xml
Template 3: AI-training blokkeren, AI-zoeken toestaan
Een genuanceerde configuratie: laat Perplexity toe (dat je content gebruikt voor realtime bronvermeldingen), maar blokkeer trainingscrawlers (die je content gebruiken om modellen te trainen). Een veelgekozen middenweg voor uitgevers die wel geciteerd willen worden in AI-zoekmachines, maar bezwaar hebben tegen gebruik voor modeltraining.
User-agent: *
Disallow: /admin/
Disallow: /private/

User-agent: Googlebot
Allow: /

# Perplexity - real-time citations, allow
User-agent: PerplexityBot
Allow: /

# Google AI features - allow for AI Overviews
User-agent: Google-Extended
Allow: /

# OpenAI training - block
User-agent: GPTBot
Disallow: /

# Anthropic training - block
User-agent: ClaudeBot
Disallow: /

User-agent: anthropic-ai
Disallow: /

Sitemap: https://yoursite.com/sitemap.xml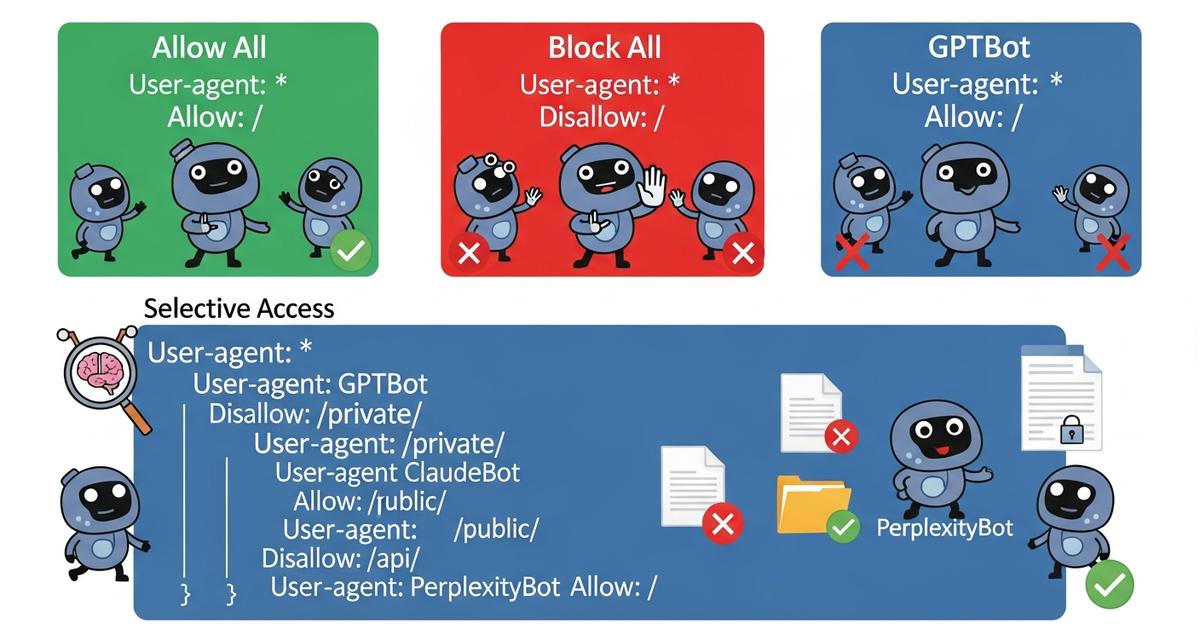
Welke configuratie past bij jou?
De juiste robots.txt-configuratie hangt af van je type content, je verdienmodel en je doelen voor zichtbaarheid in AI-zoekmachines. Gebruik dit beslisschema:
Laat alle AI-crawlers toe als:
- je site vrij toegankelijke content publiceert (blog, documentatie, kennisbank)
- je maximaal zichtbaar wilt zijn in AI-zoekmachines en citaties een bron van verkeer zijn
- je geen afgeschermde of premiumcontent hebt die bescherming nodig heeft
- je content informatief is en baat heeft bij een brede verspreiding
Kies voor selectieve toegang als:
- je een mix hebt van gratis en premiumcontent
- sommige pagina's niet geciteerd mogen worden (accountpagina's, afrekenstappen, content alleen voor leden)
- je wilt dat AI-crawlers zich op je beste content richten in plaats van alles te crawlen
Blokkeer trainingscrawlers (en sta alleen zoeken toe) als:
- je een uitgever bent met bedenkingen over het gebruik van je content als AI-trainingsdata
- je toch wilt verschijnen in Perplexity en Google AI Overviews (realtime citaties)
- je de mogelijkheid wilt houden om je content apart in licentie te geven aan AI-bedrijven
Blokkeer alle AI-crawlers alleen als:
- je duidelijke juridische of concurrentieredenen hebt om content buiten AI-systemen te houden
- je een licentieovereenkomst hebt met specifieke AI-bedrijven en exclusiviteit wilt afdwingen
- je de afweging begrijpt: nul zichtbaarheid in AI-zoekmachines voor je domein
Veelgemaakte fouten
Fout 1: een wildcardblokkade gebruiken voor onbekende bots
Configuraties als User-agent: * / Disallow: / met daarna alleen specifieke allow-regels voor Googlebot blokkeren alle AI-crawlers, omdat die geen expliciete allow-regels hebben. Wees altijd expliciet over de toegang van AI-crawlers.
Fout 2: niet weten wat er nu in je configuratie staat
Veel teams weten niet wat hun robots.txt op dit moment zegt over AI-crawlers. Kijk het meteen na op yoursite.com/robots.txt. De tools van AI Rank Lab helpen ook: de gratis site-audit controleert of je robots.txt aanwezig en bereikbaar is.
Fout 3: Googlebot en Google-Extended door elkaar halen
Als je Googlebot toelaat, laat je Google-Extended (de crawler voor AI-functies) niet automatisch toe. Wil je verschijnen in Google AI Overviews en AI Mode, dan heb je een expliciete regel nodig die Google-Extended toestaat.
Fout 4: niet testen na wijzigingen
Controleer na het aanpassen van je robots.txt of de wijzigingen zijn doorgevoerd: bekijk het live bestand en gebruik een robots.txt-testtool. Google Search Console heeft een ingebouwde robots.txt-tester voor Googlebot, maar de regels voor AI-crawlers moet je zelf handmatig nalopen.
Fout 5: instellen en vergeten
Er komen regelmatig nieuwe AI-crawlers bij. De lijst met AI-user-agents uit 2023 is in 2026 al onvolledig. Loop je robots.txt minstens elk kwartaal na en houd de documentatie van de grote AI-bedrijven in de gaten voor nieuwe crawlers.
Verder dan robots.txt: alle middelen om AI-crawlers te sturen
robots.txt is de belangrijkste, maar niet de enige knop om de toegang van AI-crawlers te regelen. Een complete technische AEO-inrichting bestaat uit:
- robots.txt: toegangsregels voor crawlers (zie hierboven)
- llms.txt: een richtlijnbestand voor LLM's over wat je site behandelt en hoe de content gebruikt mag worden; een aanvulling op robots.txt, geen vervanging
- noindex-metatags: controle per pagina die voorkomt dat specifieke pagina's worden geïndexeerd, en die door sommige AI-crawlers wordt gerespecteerd
- AI-botmonitoring: bijhouden welke crawlers je site bezoeken en hoe vaak; de bottracking van AI Rank Lab geeft je dat inzicht zonder loganalyse
Gebruik de gratis robots.txt-generator
Schrijf je robots.txt niet vanaf nul, maar gebruik de gratis robots.txt-generator van AI Rank Lab. Kies je type configuratie (volledige toegang, selectief, training blokkeren of aangepast), geef aan welke paden je wilt afschermen en de tool maakt een correct opgemaakt bestand met alle huidige user agents van AI-crawlers erin. Je kunt het resultaat direct naar je server kopiëren of als bestand downloaden.
De generator wordt bijgewerkt zodra er nieuwe user agents van AI-crawlers verschijnen. Zo krijg je een configuratie die ook rekening houdt met bots die nog niet bestonden toen dit artikel werd geschreven.
Conclusie
Je robots.txt is een directe knoppenkast voor je zichtbaarheid in AI-zoekmachines. Zet je hem goed, dan kunnen AI-crawlers je content lezen en ervan leren, en dat levert citaties op in de antwoorden van ChatGPT, Perplexity, Claude en Gemini. Zet je hem verkeerd, of laat je een verouderd bestand staan, dan bouw je onzichtbare drempels tussen je content en de AI-zoekmachines die steeds vaker bepalen wat mensen vinden.
Vijf minuten om je huidige robots.txt te controleren en met de gratis generator een AI-klare configuratie te maken: dat is een van de technische acties met het meeste effect op je zichtbaarheid in AI-zoekmachines. Doe het vandaag nog, en zet een herinnering om hem elk kwartaal na te lopen, want er komen steeds nieuwe AI-crawlers bij.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


