



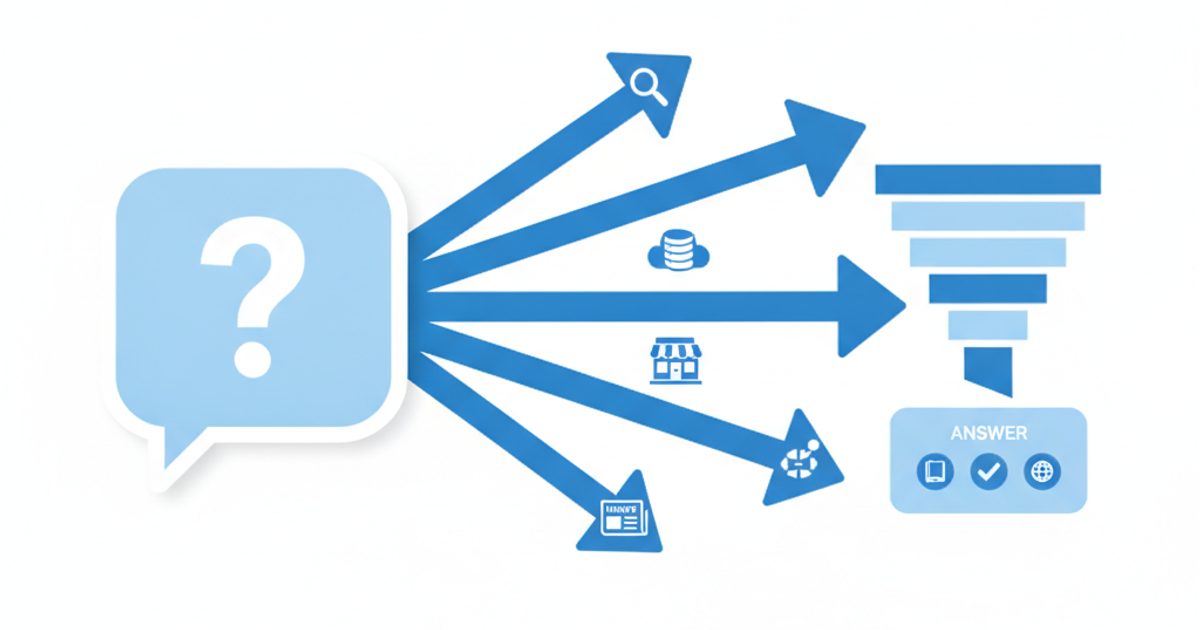
ChatGPT Search werkt in vijf stappen. Het bepaalt of je vraag actuele informatie nodig heeft, herschrijft die vraag tot een of meer zoekopdrachten, haalt kandidaat-pagina's op uit de eigen index en cache van OpenAI en bij externe zoekpartners, rangschikt wat het vindt en schrijft een antwoord met links naar de pagina's die het heeft gebruikt. Elk van die onderdelen heeft OpenAI gedocumenteerd. Wat het niet heeft gepubliceerd, is hoe zwaar elke bron meetelt. En precies daar komt de meeste verwarring (en de meeste speculatie) vandaan.
In deze gids scheiden we wat OpenAI in zijn eigen documentatie bevestigt van wat onderzoekers met reverse engineering hebben achterhaald. We leggen uit wat de vier user agents van OpenAI doen en wat elk ervan regelt, en je krijgt een checklist van wat je als site-eigenaar wel en niet kunt beïnvloeden. Ook laten we zien wat onze eigen trackingdata zegt over verwijzingsverkeer uit ChatGPT, inclusief het gat in de UTM-tagging van 8 tot en met 16 oktober 2026. Alle bronnen zijn gecontroleerd op 18 oktober 2026.
De belangrijkste punten
- Bevestigd: ChatGPT put uit de eigen "geïndexeerde en gecachete webcontent" van OpenAI, maar ook uit externe zoekproviders en content van partners. OpenAI noemt Microsoft en Shopify als providers waar het herschreven zoekopdrachten naartoe kan sturen.
- Niet openbaar: de verhouding daartussen. Berichten over een interne index met de naam "Labrador" en over tests die die index afwegen tegen externe resultaten komen van onderzoek door derden, niet van OpenAI.
- OAI-SearchBot is de schakelaar die telt voor zoeken. Blokkeer je die, dan verdwijnen je pagina's uit de zoekantwoorden van ChatGPT. Met een blokkade van GPTBot meld je je alleen af voor modeltraining.
- Bronvermeldingen zijn instabiel. In onze tracking kwam maar een mediaan van 7,7% van de domeinen die ChatGPT voor een prompt citeerde in elke run van die prompt terug.
- Tel de UTM, niet de referrer. 39% van de ChatGPT-getagde paginaweergaven die onze tag registreerde, kwam binnen zonder enige referrer.
Zo lees je dit artikel: bevestigd of gerapporteerd
Elke bewering hieronder krijgt een van drie labels. In de discussie over ChatGPT Search lopen die namelijk vrolijk door elkaar, en zo verspreidt slecht advies zich:
- Bevestigd - door OpenAI zelf gezegd in het helpcentrum, de documentatie voor ontwikkelaars, release notes of aankondigingen.
- Gerapporteerd - onderzoek door derden, reverse engineering van het netwerkverkeer van ChatGPT, getuigenissen in de rechtszaal zoals journalisten die doorgeven, of uitspraken uit de tweede hand. Vaak geloofwaardig, nooit officieel.
- Onze data - geaggregeerde, geanonimiseerde cijfers uit de prompttracking en JavaScript-tag van AI Rank Lab, met de methode en steekproefgrootte direct bij elk cijfer.
Hoe werkt ChatGPT Search, stap voor stap?
Kort gezegd is het een retrieval-pijplijn: de beslissing om te zoeken, het herschrijven van de vraag, ophalen uit meerdere bronnen, rangschikken en daarna een uitgeschreven antwoord met bronvermeldingen. Hieronder elke stap, met het bewijsniveau erbij.
- Bepalen of er gezocht wordt. Bevestigd: volgens het helpartikel van OpenAI Searching the web with ChatGPT kan ChatGPT automatisch zoeken als een vraag baat heeft bij actuele informatie. Je kunt het ook afdwingen door Search te kiezen in het menu met tools of door "/" te typen in het invoerveld. Gerapporteerd: de reverse engineering van RESONEO uit februari 2026 beschrijft een classifier die elke prompt een score geeft en boven een bepaalde drempel een zoekactie start.
- De prompt herschrijven tot zoekopdrachten. Bevestigd: als ChatGPT externe zoekpartners gebruikt, herschrijft het je vraag meestal tot een of meer gerichte zoekopdrachten. Na het lezen van de eerste resultaten kan het specifiekere vervolgzoekopdrachten sturen, een globale locatie toevoegen die het afleidt uit je IP-adres (niet het IP-adres zelf) en opgeslagen herinneringen gebruiken bij het herschrijven. Dit heet query fan-out, en dat leggen we uitgebreid uit in onze gids over query fan-out.
- Kandidaat-pagina's ophalen. Bevestigd: resultaten komen van externe zoekproviders, van content die partners rechtstreeks aanleveren en van de eigen geïndexeerde en gecachete webcontent van OpenAI. Gerapporteerd: welke providers het precies zijn en hoe groot hun aandeel is (zie de volgende sectie).
- De kandidaten rangschikken. Bevestigd: OpenAI zegt dat ChatGPT zoekresultaten rangschikt op basis van meerdere factoren die relevante, betrouwbare informatie naar boven moeten halen, en dat een plek niet gegarandeerd is. De factoren zelf heeft het niet gepubliceerd. Gerapporteerd: RESONEO beschrijft hoe resultaten van meerdere zoekmachines worden samengevoegd met Reciprocal Rank Fusion, een standaardtechniek om gerangschikte lijsten te combineren.
- Het antwoord schrijven en bronnen vermelden. Bevestigd: antwoorden die op zoekresultaten leunen, kunnen bronvermeldingen in de tekst bevatten, een knop Sources met de geciteerde bronnen en andere relevante links, bronlinks bij afbeeldingen en op mobiel ook kaarten. Het model dat het antwoord schrijft, is in de loop van de tijd veranderd: bij de lancering in 2024 was dat een gefinetunede GPT-4o, en sinds de release van 7 oktober 2026 draait de chat van ChatGPT op GPT-6 (Sol voor betaalde abonnementen, Luna voor Free en Go), met een nieuwe "Intelligent UI" die kan antwoorden met grafieken, vergelijkingen en interactieve elementen.
Wanneer zoekt ChatGPT op het web in plaats van uit zijn geheugen te antwoorden?
ChatGPT zoekt als het inschat dat een vraag verse of specifieke informatie nodig heeft, zoals nieuws, prijzen, uitslagen, lokale resultaten of iets wat net is gebeurd. In alle andere gevallen antwoordt het vanuit zijn trainingsdata. Je kunt die inschatting overrulen door handmatig Search te kiezen of door ChatGPT te vragen op het web te zoeken.
Hoe vaak gebeurt dat in de praktijk? Gerapporteerd: het onderzoek van Profound naar Engelstalige ChatGPT-gesprekken in de VS (oktober tot december 2025; zo'n 730.000 van die gesprekken bevatten minstens één bronvermelding naar het web) laat zien dat ongeveer 18% van de gesprekken minstens één webzoekactie startte. Ook neemt de kans op een antwoord met bronnen af naarmate een gesprek vordert: 12,6% van de eerste beurten bevatte bronvermeldingen, tegen 4,5% bij de tiende beurt.
Dat heeft twee praktische gevolgen. Ten eerste: als ChatGPT niet zoekt, maakt niets wat je vandaag op je site verandert verschil voor dat antwoord, want het komt uit de trainingsdata. Dat is het deel waar GPTBot over gaat. Ten tweede: de openingsvraag van een gesprek is het moment waarop zoeken, en dus een bronvermelding, het waarschijnlijkst is.
Waar komen de zoekresultaten van ChatGPT vandaan?
De zoekresultaten van ChatGPT komen uit een mix van de eigen index en cache van OpenAI, externe zoekproviders en gelicentieerde data of data van partners. OpenAI heeft bevestigd dat alle drie bestaan. Het heeft niet bekendgemaakt hoe vaak elke bron wordt gebruikt, en die verhouding verschilt waarschijnlijk per type vraag: nieuws, shopping, lokaal of algemeen.
Wat OpenAI heeft bevestigd
- Externe providers en content van partners. In de lanceringspost van 31 oktober 2024 staat dat ChatGPT Search externe zoekproviders gebruikt plus content die partners rechtstreeks aanleveren, met nieuws- en datapartners achter weer, aandelen, sport, nieuws en kaarten.
- Providers bij naam. Het huidige helpartikel verwijst gebruikers naar het privacybeleid van Microsoft en Shopify, als zoekproviders die herschreven zoekopdrachten kunnen ontvangen. Voor restaurantreserveringen toont het beschikbaarheid van OpenTable, Resy en Yelp.
- De eigen index en cache van OpenAI. Het helpartikel van OpenAI over offline web search voor ChatGPT-workspaces beschrijft een modus waarin ChatGPT zoekt in "de geïndexeerde en gecachete webcontent van OpenAI" in plaats van een live provider aan te roepen. Daarbij staat dat er voor geen enkele specifieke URL een verversingsgarantie is en dat de dekking verschilt per site, taal, regio en type content.
Heeft ChatGPT een eigen zoekindex?
Ja. De eigen documentatie van OpenAI beschrijft een index en cache die het zelf onderhoudt, en OpenAI heeft een aparte zoekcrawler, OAI-SearchBot, om die te vullen. Wat nog niet bevestigd is: hoeveel van de dagelijkse ChatGPT-zoekopdrachten van gewone gebruikers uit die index worden beantwoord en hoeveel via externe providers.
Het beste openbare bewijs op dat punt komt van derden:
- Gerapporteerd: tijdens de zaak over maatregelen in de antitrustzaak rond Google Search, in april 2025, verklaarde Nick Turley, hoofd product van ChatGPT bij OpenAI, dat OpenAI aan een eigen index bouwde, dat het waarschijnlijk nog jaren zou duren voordat het daar volledig op kon vertrouwen, en dat Google het verzoek van OpenAI uit 2024 om toegang tot een zoek-API had afgewezen (Tech Policy Press).
- Gerapporteerd: de analyse van Peec AI uit september 2026 vond tussen 21 mei en 21 juli 2026 een veld
result_sourcein de server-sent events van ChatGPT, met vier waarden: Labrador, Bright, Oxylabs en SERP. Peec ziet Labrador als een familie van verticale indexen van OpenAI (web, pdf, YouTube, nieuws, Wikipedia, arXiv, lokaal, financiën, juridisch, medisch, shopping, afbeeldingen) en de andere drie als externe scrapingkanalen. Peec meldt niet hoe vaak elke waarde voorkwam. - Gerapporteerd: Peec en Otterly AI beschrijven een experiment met de naam
prefer-index-over-serp-v3, dat de index van OpenAI lijkt te testen tegen resultaten van derden. Volgens Otterly ging het in augustus 2026 om zo'n 8% van de gesprekken. Search Engine Watch vroeg OpenAI om een reactie en had die bij publicatie nog niet gekregen.
Gebruikt ChatGPT Search Bing of Google?
Microsoft is een openlijk genoemde zoekprovider, Google niet. Het helpcentrum van OpenAI verwijst voor zoeken naar de privacyverklaring van Microsoft. Daarnaast melden Otterly en Peec dat Web IQ, het groundingplatform dat Microsoft in juni 2026 aankondigde, ChatGPT ondersteunt. Die bewering konden wij niet terugvinden in een primaire bron van Microsoft, dus beschouw haar als gerapporteerd. Volgens de verklaring van Turley heeft Google geen samenwerking met OpenAI, maar meerdere onderzoekers (RESONEO, Peec) melden dat Google-resultaten via scrapingproviders toch bij ChatGPT terechtkomen. OpenAI heeft dat niet bevestigd.
Wat je daar in de praktijk mee doet: goed ranken in Bing of Google helpt de providers die ChatGPT mogelijk gebruikt om je pagina's te vinden, maar geen van beide rankings is een betrouwbare graadmeter voor je zichtbaarheid in ChatGPT. Die moet je rechtstreeks in ChatGPT meten.
| Bewering | Status | Bron | Datum |
|---|---|---|---|
| ChatGPT gebruikt externe zoekproviders en content van partners | Bevestigd | Lanceringspost van OpenAI | 31 okt. 2024 |
| Microsoft en Shopify zijn zoekproviders die zoekopdrachten kunnen ontvangen | Bevestigd | Helpcentrum van OpenAI | Gecontroleerd 18 okt. 2026 |
| OpenAI houdt eigen geïndexeerde en gecachete webcontent bij | Bevestigd | Helpcentrum van OpenAI (offline web search) | Gecontroleerd 18 okt. 2026 |
| OAI-SearchBot crawlt om sites te tonen in ChatGPT Search | Bevestigd | Documentatie voor ontwikkelaars van OpenAI | Gecontroleerd 18 okt. 2026 |
| OpenAI bouwt een eigen index; volledig daarop vertrouwen duurt nog jaren | Gerapporteerd (getuigenis in de rechtszaal) | Tech Policy Press | Apr. 2025 |
| Interne indexfamilie met de naam "Labrador", plus de kanalen Bright, Oxylabs en SERP | Gerapporteerd (netwerkanalyse) | Peec AI | Sep. 2026 |
| Experiment dat de index van OpenAI test tegen externe resultaten (~8% van de chats) | Gerapporteerd | Peec AI, Otterly AI | Aug.-sep. 2026 |
| Microsoft Web IQ zorgt voor grounding van ChatGPT-antwoorden | Gerapporteerd, door ons niet bevestigd in een bron van Microsoft | Otterly AI, Peec AI | Jun. 2026 |
| Google-resultaten bereiken ChatGPT via scrapingproviders | Gerapporteerd, onbevestigd | RESONEO, Peec AI | 2026 |
Wat is het verschil tussen OAI-SearchBot, GPTBot en ChatGPT-User?
OAI-SearchBot bepaalt of je kunt verschijnen in ChatGPT Search, GPTBot bepaalt of je content mag worden gebruikt om de modellen van OpenAI te trainen, en ChatGPT-User is de agent die een pagina ophaalt als iemand ChatGPT vraagt die te openen. Ze staan los van elkaar: je kunt de ene toestaan en de andere blokkeren. De crawlerdocumentatie van OpenAI noemt ook nog een vierde agent, OAI-AdsBot, voor advertenties in ChatGPT.
| User agent | Wat hij doet (volgens OpenAI) | Wat robots.txt regelt | IP-lijst |
|---|---|---|---|
| OAI-SearchBot | Crawlt om websites te tonen in de zoekfuncties van ChatGPT | Sluit je hem uit, dan worden je pagina's niet getoond in de zoekantwoorden van ChatGPT, al kunnen ze nog wel als gewone navigatielinks verschijnen. Wijzigingen duren ongeveer 24 uur. | openai.com/searchbot.json |
| GPTBot | Crawlt content die kan worden gebruikt om de foundation models van OpenAI te trainen | Sluit je hem uit, dan geef je aan dat je content niet voor training mag worden gebruikt. Het heeft geen invloed op je kans om in de zoekresultaten te komen. | openai.com/gptbot.json |
| ChatGPT-User | Bezoeken die een gebruiker start, bijvoorbeeld als iemand ChatGPT een pagina laat lezen, of GPT Actions | Regels in robots.txt gelden mogelijk niet, omdat een gebruiker het bezoek heeft gestart. Wordt niet gebruikt om te bepalen of je in de zoekresultaten komt. | openai.com/chatgpt-user.json |
| OAI-AdsBot | Controleert landingspagina's die als ChatGPT-advertentie zijn ingediend en bezoekt alleen die pagina's | Alleen relevant als je adverteert in ChatGPT. De data wordt niet gebruikt om foundation models te trainen. | openai.com/adsbot.json |
Een gangbare opzet voor een site die zichtbaar wil zijn in ChatGPT Search, maar niet gebruikt wil worden voor training, ziet er zo uit:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
Twee details uit de documentatie van OpenAI die vaak over het hoofd worden gezien: als je beide bots toestaat, kan OpenAI één crawl voor beide doelen gebruiken, en het ophalen van robots.txt zelf kan een extra markering "robots.txt" in de user-agentstring hebben. Voor een complete set regels voor alle AI-crawlers lees je onze robots.txt-gids voor AI-crawlers of gebruik je de gratis robots.txt-generator. Wil je echt botverkeer in je logs controleren, kijk dan in onze gids voor het monitoren van GPTBot, ClaudeBot en PerplexityBot.
Hoe kiest ChatGPT welke bronnen het vermeldt?
OpenAI zegt alleen dat ChatGPT resultaten rangschikt op meerdere factoren die gericht zijn op relevantie en betrouwbaarheid, en dat een plek niet gegarandeerd is. Er is geen gepubliceerde lijst met rankingfactoren en geen tool om pagina's in te dienen. Wat we wel kunnen meten, is het patroon in de bronvermeldingen.
Gerapporteerd: in het driemaandenonderzoek van Profound gebruikte een antwoord met bronvermeldingen gemiddeld zo'n vier unieke bronnen, en 66% van de beurten met bronvermeldingen gebruikte er tussen één en vier. De bronvermeldingen waren breed verspreid: de tien grootste domeinen kregen samen maar 12% van alle bronvermeldingen, met Wikipedia op ongeveer 5% en Reddit op ongeveer 3%.
Onze data: over 11 ChatGPT-prompts die AI Rank Lab elk minstens vijf keer draaide (239 geslaagde runs, 13 februari tot 14 oktober 2026), was de mediane overlap in geciteerde domeinen tussen opeenvolgende runs van dezelfde prompt 0,54 (Jaccard-similariteit, waarbij 1 identiek betekent). Maar een mediaan van 7,7% van de domeinen die ChatGPT voor een prompt citeerde, kwam in elke run terug, en bij 6 van de 11 prompts wisselde het minstens één keer tussen wel en niet noemen van het gevolgde merk. Dit zijn geautomatiseerde runs, dus ze kunnen afwijken van de gepersonaliseerde resultaten van een ingelogde gebruiker. De volledige methode staat in ons onderzoek naar de consistentie van AI-antwoorden.
De conclusie: "Worden we geciteerd door ChatGPT?" is de verkeerde vraag. De nuttige vraag is: "In welk deel van herhaalde runs worden we geciteerd, en bij welke prompts?" Eén handmatige check zegt je vrijwel niets.
Hoe meet je verkeer uit ChatGPT Search?
Meet bezoeken uit ChatGPT aan de hand van de parameter utm_source=chatgpt.com die ChatGPT aan uitgaande links toevoegt, niet aan de hand van de referrer. De publisher-FAQ van OpenAI heeft die parameter gedocumenteerd (op 18 oktober 2026 konden we die pagina niet laden, dus we baseren ons op eerdere kopieën en op wat we zelf zien), en in echt verkeer is hij duidelijk zichtbaar.
Onze data: tussen 27 juli 2025 en 18 oktober 2026 registreerde de JavaScript-tag van AI Rank Lab 2.710 paginaweergaven met utm_source=chatgpt.com op 29 sites, tegenover 2.087 paginaweergaven met chatgpt.com als referrer op 26 sites. Van de 2.710 getagde paginaweergaven kwamen er 1.048 (39%) binnen zonder enige referrer. Analytics die alleen naar de referrer kijkt, had die bezoeken onder Direct geboekt.
Kijk in GA4 naar sessiebron gelijk aan chatgpt.com, die de UTM oppikt, en maak een kanaalgroep waar die in zit. Op onze pagina AI-verwijzingsverkeer meten in GA4 zie je hoe je dat instelt, en AI-bottracking registreert verwijzingen vanuit AI-assistenten per pagina, helemaal zonder GA4.
Wat gebeurde er in oktober 2026 met de UTM-tags van ChatGPT?
Ongeveer een week na de lancering van GPT-6 gingen veel ChatGPT-links de deur uit zonder UTM-tag. Bezoeken die eerder aan ChatGPT werden toegeschreven, verschenen daardoor als Direct. Op 15 en 16 oktober kwamen de tags terug. Alles hiervan, behalve de lanceringsdatum van GPT-6, komt van derden: OpenAI heeft er niets publiekelijk over gezegd en de release notes noemen het niet.
| Datum (2026) | Wat er gebeurde | Status | Bron |
|---|---|---|---|
| 7-8 okt. | GPT-6 en Intelligent UI worden uitgerold naar betaalde abonnementen, daarna naar Free en Go | Bevestigd | Release notes van OpenAI |
| 8 okt., ~18:30 UTC | Het aandeel antwoorden met getagde links begint te zakken van ongeveer 99% | Gerapporteerd | Profound |
| 9-13 okt. | Op zo'n 500 pagina's dalen de ChatGPT-bezoeken met ~31.000 per dag, terwijl Direct met ~26.000 per dag stijgt | Gerapporteerd | Cedric Huesler van Adobe, via SEJ |
| 14 okt. | Huesler zegt dat OpenAI hem heeft verteld dat het om een bekende bug ging | Gerapporteerd (tweede hand) | SEJ |
| 14 okt., ~19:00 UTC | Getagde antwoorden zakken naar 5-10%, terwijl Intelligent UI-antwoorden 92-96% bereiken | Gerapporteerd | Profound |
| 15-16 okt. | Fix wordt uitgerold; getagde antwoorden zitten op 16 okt. om 06:30 UTC weer op ongeveer 99% | Gerapporteerd | Profound, SEJ |
Bronnen: Search Engine Journal, 15 oktober 2026 en de tijdlijn van het incident van Profound.
Onze data: onze steekproef voor deze periode is klein, dus zie het als consistentiecheck, niet als meting. Van 9 tot en met 18 oktober zag onze tag 52 ChatGPT-getagde paginaweergaven op twee sites, en geen enkele daarvan had chatgpt.com als referrer. In de 30 dagen daarvoor (9 september tot 8 oktober) hadden 236 van de 368 getagde paginaweergaven op zeven sites (64%) dat wel. Dat sluit aan bij berichten dat de meeste kliks uit ChatGPT ook na de terugkeer van de tags zonder referrer binnenkomen.
Wat je nu doet: zet een annotatie op 8-16 oktober in je rapportages, vergelijk het Direct-verkeer op de landingspagina's waar ChatGPT je normaal bezoekers naartoe stuurt voordat je het verloren verkeer noemt, en blijf de UTM tellen in plaats van de referrer.
Hoe zorg je dat je website in aanmerking komt voor ChatGPT Search?
Of je in aanmerking komt, hangt ervan af of OAI-SearchBot je pagina's kan bereiken en lezen. Het helpcentrum van OpenAI zegt het zonder omwegen: sta OAI-SearchBot toe in robots.txt en zorg dat je host of CDN verkeer toelaat van de gepubliceerde IP-adressen van de zoekbot van OpenAI. Al het andere op deze lijst vergroot je kansen, niet je toelaatbaarheid.
- Sta OAI-SearchBot toe in robots.txt en neem de beslissing over GPTBot apart. Controleer of brede
User-agent: *-regels hem niet per ongeluk blokkeren. - Sta de IP-ranges van OpenAI toe op je CDN, firewall of botbeveiliging. Veel schakelaars om "AI-bots te blokkeren" blokkeren OAI-SearchBot ook. Vergelijk 403- of 429-responses in je logs met openai.com/searchbot.json.
- Zet de hoofdcontent in de HTML. OpenAI noemt zware afhankelijkheid van scripts, dynamisch laden, logins en personalisatie als redenen waarom zijn index een pagina kan missen. Render belangrijke pagina's server-side of prerender ze.
- Maak diepere pagina's makkelijk vindbaar. OpenAI noemt ook een sitestructuur die diepere pagina's verstopt. Link belangrijke pagina's vanaf hubpagina's en houd je XML-sitemap actueel.
- Houd pagina's actueel en voorzien van een datum. OpenAI geeft geen verversingsschema per URL en zegt dat versheid afhangt van de site, crawltoegang, caching en populariteit. Zichtbare "bijgewerkt"-datums helpen lezers en elk systeem dat actualiteit meeweegt.
- Schrijf passages die meteen antwoord geven en op zichzelf staan. Dit punt is consensus onder vakmensen, geen richtlijn van OpenAI: een sectie die de eigen kop in de eerste zin beantwoordt, is makkelijker te citeren. Ons 30-dagenplaybook om geciteerd te worden door ChatGPT behandelt de contentkant.
- Zorg dat je aanwezig bent in de data die ChatGPT voor jouw branche ophaalt. Bij restaurants komt de beschikbaarheid van OpenTable, Resy en Yelp; voor shopping is Shopify een genoemde provider. Geldt dat voor jou, dan horen je vermeldingen daar bij je zichtbaarheid in ChatGPT.
- Controleer of OAI-SearchBot echt langskomt. Filter je serverlogs op het token OAI-SearchBot en verifieer de IP-adressen. Volg daarna welke URL's ChatGPT citeert voor je doelprompts.
Wil je stap 3 tot en met 5 voor een hele site controleren, dan crawlt de AEO-audit je pagina's en markeert hij problemen met de gereedheid voor SEO, answer engines en generatieve zoekmachines, met voorgestelde oplossingen. Voor de tweede helft van stap 8 legt citatietracking vast welke van je URL's ChatGPT voor je prompts citeert.
Waarom verschijnt mijn pagina niet in ChatGPT Search?
De meest voorkomende oorzaken zijn een crawlblokkade, een CDN- of firewallregel, content die pas verschijnt nadat JavaScript is uitgevoerd, en pagina's die nieuw zijn, diep in de site zitten of weinig links krijgen. Precies deze redenen noemt OpenAI in zijn documentatie over offline web search als verklaring waarom pagina's ontbreken of verouderd zijn in zijn index. Die lijst is geschreven voor beheerders van workspaces, maar het is de enige plek waar OpenAI uitlegt waarom zijn index pagina's mist. Daarmee is het meteen een bruikbare diagnosechecklist.
| Reden volgens OpenAI | Zo controleer je het | Oplossing |
|---|---|---|
| robots.txt of vergelijkbare instellingen blokkeren het crawlen | Open /robots.txt; zoek naar OAI-SearchBot of een algemene Disallow | Sta OAI-SearchBot toe; wacht ongeveer 24 uur |
| Gedrag van CDN of botblokkering | Zoek in je logs naar OAI-SearchBot-requests met 403, 429 of challengepagina's | Zet de ranges uit openai.com/searchbot.json op de allowlist |
| Pagina vereist een login of personalisatie | Laad de pagina uitgelogd in een privévenster | Publiceer een openbare versie van de belangrijkste content |
| Content hangt af van scripts of dynamisch laden | Haal de ruwe HTML op met curl en controleer of de hoofdtekst erin staat | Render server-side of prerender |
| Pagina is nieuw, wordt zelden bezocht of geeft weinig signalen af | Controleer de publicatiedatum en de interne en externe links naar de pagina | Link ernaar vanaf sterke pagina's; verdien verwijzingen; geef het tijd |
| Sitestructuur verstopt diepere pagina's | Tel het aantal klikken vanaf de homepage; controleer de sitemap | Voeg links vanaf hubpagina's toe en houd de sitemap actueel |
Klopt elke rij en word je nog steeds niet geciteerd, dan zit het probleem meestal in relevantie of concurrentie, niet in toegang: een andere pagina beantwoordt de prompt directer, of ChatGPT zoekt voor die prompt helemaal niet.
Wat heb je bij ChatGPT Search niet in de hand?
Jij bepaalt de toegang en de kwaliteit van je content. Het meeste van wat daarna gebeurt, bepaal je niet. Concreet heb je geen invloed op:
- Of ChatGPT zoekt. Die beslissing ligt bij ChatGPT, tenzij de gebruiker Search afdwingt.
- Welke provider antwoordt. De index van OpenAI, Microsoft, Shopify, partners of de gerapporteerde scrapingkanalen, in een onbekende mix die OpenAI actief lijkt te testen.
- Ranking en bronvermelding. Er is geen gepubliceerde lijst met factoren en geen garantie, en onze data laat zien dat bronvermeldingen per run veranderen.
- Indexeringssnelheid. OpenAI documenteert geen tool om URL's in te dienen, geen rapport over indexdekking en geen verversingsgarantie voor een specifieke URL.
- Antwoorden uit trainingsdata. Als ChatGPT uit zijn geheugen antwoordt, hebben de aanpassingen die je vandaag aan een pagina doet geen effect.
- Bezoeken van ChatGPT-User. robots.txt geldt mogelijk niet voor ophaalacties die een gebruiker start.
- Navigatielinks. Ook nadat je OAI-SearchBot hebt geblokkeerd, kan je site nog als navigatielink verschijnen.
- Linktagging. Oktober 2026 liet zien dat attributie zonder waarschuwing kan wegvallen.
Hoe houd je bij welke URL's ChatGPT citeert?
Omdat resultaten per run verschillen, betekent monitoren dat je dezelfde prompts herhaaldelijk draait en vermeldingen en geciteerde URL's door de tijd heen vastlegt. Voor een handvol prompts kan dat met de hand in een uitgelogde browser. Daarboven bespaart een tool je veel tijd.
Openheid: AI Rank Lab is ons eigen product. We zetten het bovenaan omdat dit onze site is, en we hebben voor elke tool hieronder dezelfde criteria gehanteerd.
- AI Rank Lab - draait je prompts volgens een schema op ChatGPT, Claude, Gemini en Perplexity, plus Google AI Overviews en AI Mode, en legt vermeldingen, positie, concurrenten en geciteerde URL's vast. Het koppelt tracking ook aan verbeteringen, via audits, een Action Plan en het publiceren van content. Zie merkzichtbaarheid volgen.
- Profound - gericht op enterprise, en publiceert enkele van de grootste openbare datasets over bronvermeldingen in ChatGPT, zoals het onderzoek dat we hierboven aanhalen.
- Peec AI - sterk in onderzoek naar de werking, waaronder de meest gedetailleerde openbare analyse van de index van ChatGPT.
- Otterly AI - publiceert regelmatig GEO-experimenten en dekt meerdere AI-engines.
Methode en beperkingen
Op 18 oktober 2026 lazen we de helpartikelen van OpenAI over web search, offline web search en de release notes, de crawlerdocumentatie van OpenAI en de lanceringspost uit 2024, en analyseerden we 15 goed rankende artikelen en rapporten over hoe ChatGPT Search werkt. Bevindingen van derden hebben het label "gerapporteerd", omdat OpenAI geen ervan heeft bevestigd. Een aantal komt van bedrijven die, net als wij, tools voor AI-zichtbaarheid verkopen. De publisher-FAQ van OpenAI konden we op de dag van schrijven niet laden, en de rol van Microsoft Web IQ in ChatGPT konden we niet bevestigen in een primaire bron van Microsoft. Onze eigen cijfers komen van een klein aantal sites en prompts, zijn geaggregeerd en geanonimiseerd, en staan steeds met hun steekproefgrootte vermeld. Ze beschrijven het verkeer van onze klanten, niet het web als geheel.
Wil je zien welke van je pagina's ChatGPT echt citeert voor de prompts die voor jou tellen, en hoe dat week na week verandert? Begin met tracken in AI Rank Lab.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


