



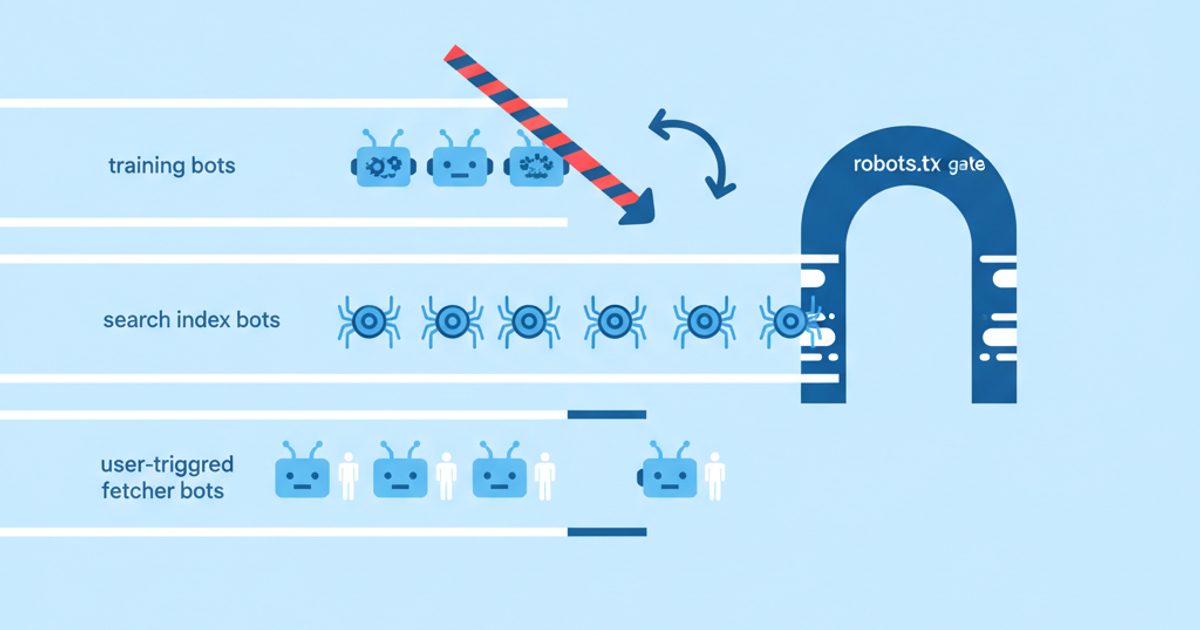
AI-crawlers zijn geautomatiseerde bots van AI-bedrijven die webpagina's ophalen voor een van drie taken: trainingsdata verzamelen voor modellen (GPTBot, ClaudeBot), de zoekindex opbouwen waaruit AI-antwoorden hun bronnen halen (OAI-SearchBot, Claude-SearchBot, PerplexityBot), of een pagina live ophalen omdat een gebruiker er een assistent naar vroeg (ChatGPT-User, Claude-User, Perplexity-User). Blokkeer je een trainingscrawler, dan blijft je content buiten toekomstige modellen. Blokkeer je een zoekcrawler of een gebruikersfetcher, dan verdwijn je uit AI-antwoorden en bronvermeldingen. Om dat verschil draait de hele keuze.
Dit artikel is een naslagwerk waar je direct mee aan de slag kunt. Elke user agent hieronder hebben we op 18 oktober 2026 gecontroleerd in de eigen documentatie van de aanbieder, met een link naar die pagina. Je krijgt er een beslismatrix per bedrijfsdoel bij, robots.txt-groepen die je zo kunt kopiëren, de verificatiemethode die elke aanbieder ondersteunt (met de datum die in elke gepubliceerde IP-lijst staat) en een eerlijke uitleg waarom JavaScript-analytics het grootste deel van het crawlerverkeer niet laat zien.
De belangrijkste punten
- Deel elke AI-bot in als training, zoeken/index of door de gebruiker gestart. OpenAI, Anthropic, Amazon, Meta en Mistral publiceren per klasse een apart token, dus je kunt er één blokkeren zonder de andere te raken.
- GPTBot blokkeren haalt je niet uit ChatGPT search. Volgens OpenAI bepaalt alleen OAI-SearchBot dat, en sites die OAI-SearchBot uitsluiten kunnen nog steeds als navigatielink verschijnen.
- Google-Extended en Applebot-Extended zijn controletokens, geen crawlers. Ze duiken nooit op in je logs, en volgens Google heeft Google-Extended geen effect op Google Zoeken, inclusief AI Overviews en AI Mode.
- Fetchers die door een gebruiker worden gestart, kunnen robots.txt bewust negeren: OpenAI, Perplexity, Google, Meta en Amazon zeggen dat allemaal in hun documentatie. Heb je een harde blokkade nodig, gebruik dan een WAF.
- De meeste AI-crawlers voeren geen JavaScript uit, dus een JS-analyticstag telt ze veel te laag. Voor crawleractiviteit zijn server- of CDN-logs de enige betrouwbare bron.
- Verifieer bots via reverse DNS (Google, Apple, Common Crawl) of door het IP-adres te vergelijken met de gepubliceerde JSON-lijst van de aanbieder. Sommige van die lijsten zijn jaren oud, dus download ze op vaste momenten opnieuw.
Wat zijn AI-crawlers en welke drie soorten zijn er?
Een AI-crawler is elke geautomatiseerde client waarmee een AI-bedrijf je pagina's opvraagt. Aanbieders splitsen hun bots inmiddels op naar doel, en dat doel bepaalt wat blokkeren je kost. De netwerkdata van Cloudflare laat zien hoe scheef de verdeling is: in de 12 maanden tot medio 2025 was 80% van het AI-crawlen voor training, 18% voor zoeken en 2% voor gebruikersacties, en in de laatste zes maanden van die periode liep training op tot 82%.
Trainingscrawlers
Trainingscrawlers verzamelen content die gebruikt kan worden om foundationmodellen te trainen of te finetunen. Hieronder vallen GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, MistralAI-Training en CCBot (de open dataset van Common Crawl, die veel modelbouwers gebruiken). Door ze te blokkeren geef je aan dat je toekomstige content buiten trainingssets moet blijven. Content die al verzameld is, verdwijnt daar niet mee, en het heeft geen invloed op de vraag of AI-zoekmachines je als bron kunnen noemen.
Zoek- en indexcrawlers
Zoekcrawlers bouwen de index waarop AI-antwoorden zijn gebaseerd en waarnaar de bronvermeldingen terugverwijzen. OAI-SearchBot (ChatGPT search), Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index en DuckAssistBot zijn specifiek voor AI. Googlebot, Bingbot en Applebot zijn klassieke zoekcrawlers waarvan de index nu ook AI-functies voedt: Google AI Overviews (de AI-overzichten in Google) en AI Mode (de AI-modus), Microsoft Copilot en de antwoorden van Siri. Een zoekcrawler blokkeren is de dure vergissing, want dan verdwijn je uit de antwoorden die je kopers lezen. Wil je weten hoe zo'n index precies wordt gebruikt, lees dan hoe ChatGPT search werkt.
Gebruikersfetchers en agents
Gebruikersfetchers (user-triggered fetchers) bezoeken één URL omdat iemand een assistent vroeg die pagina te lezen, samen te vatten of er iets mee te doen. Hieronder vallen ChatGPT-User, Claude-User, Perplexity-User, Google-Agent, Meta-ExternalFetcher, Amzn-User en MistralAI-User, plus ondertekende browseragents zoals de Cloud browser van ChatGPT. Meerdere aanbieders geven aan dat robots.txt hier mogelijk niet voor geldt, omdat een mens het verzoek heeft gestart.
Controletokens die geen crawler zijn
Twee namen die op elke lijst staan, halen zelf nooit iets op. Google-Extended is een producttoken voor robots.txt dat Google uitleest terwijl het crawlt met zijn gewone user agents. Het bepaalt of content gebruikt mag worden om toekomstige Gemini-modellen te trainen en voor grounding in Gemini Apps en Vertex AI. Applebot-Extended doet hetzelfde voor de foundationmodellen van Apple. Geen van beide strings vind je terug in je accesslogs. Daarom is „ik heb Google-Extended geblokkeerd, maar zie nog steeds Google-verkeer" precies wat je mag verwachten.
De lijst met AI-crawlers: elke grote user agent, gecontroleerd op 18 oktober 2026
De tabel toont het token dat je op een User-agent:-regel zet, wie het beheert, de klasse, wat de eigen documentatie van de aanbieder over robots.txt zegt, hoe je het kunt verifiëren en de officiële pagina die we hebben gecontroleerd. „Volgens doc" betekent dat de robots.txt-kolom de aanbieder in eigen woorden weergeeft. Zegt een document er niets over, dan melden we dat in plaats van te gokken.
| Token | Aanbieder | Klasse | Wat het doet | Robots.txt (volgens doc) | Verifiëren via | Officieel document |
|---|---|---|---|---|---|---|
| GPTBot | OpenAI | Training | Crawlt content die gebruikt kan worden om foundationmodellen van OpenAI te trainen | Ja | gptbot.json | OpenAI-crawlers |
| OAI-SearchBot | OpenAI | Zoeken | Toont sites in antwoorden van ChatGPT search; niet voor training | Ja, wijzigingen duren ongeveer 24 uur | searchbot.json | OpenAI-crawlers |
| ChatGPT-User | OpenAI | Gebruiker | Bezoekt pagina's voor gebruikersacties in ChatGPT en Custom GPTs | Geldt mogelijk niet | chatgpt-user.json | OpenAI-crawlers |
| OAI-AdsBot | OpenAI | Speciaal | Controleert landingspagina's die als ChatGPT-advertentie zijn ingediend; niet voor training | Niet vermeld; bezoekt alleen ingediende advertentiepagina's | adsbot.json | OpenAI-crawlers |
| ClaudeBot | Anthropic | Training | Verzamelt content die kan bijdragen aan de training van Claude-modellen | Ja; ondersteunt Crawl-delay | bots.json (gedeeld) | Helpcentrum van Anthropic |
| Claude-SearchBot | Anthropic | Zoeken | Indexeert content om de zoekresultaten van Claude te verbeteren | Ja | bots.json (gedeeld) | Helpcentrum van Anthropic |
| Claude-User | Anthropic | Gebruiker | Haalt pagina's op wanneer een Claude-gebruiker een vraag stelt | Ja, uitschakelen stopt het ophalen op verzoek van gebruikers | bots.json (gedeeld) | Helpcentrum van Anthropic |
| PerplexityBot | Perplexity | Zoeken | Toont en linkt sites in resultaten van Perplexity; niet voor training | Ja, binnen 24 uur | perplexitybot.json | Perplexity-crawlers |
| Perplexity-User | Perplexity | Gebruiker | Bezoekt pagina's om de vraag van een gebruiker te beantwoorden | Negeert het meestal | perplexity-user.json | Perplexity-crawlers |
| Googlebot | Zoeken | Google Zoeken, inclusief AI Overviews en AI Mode | Ja, altijd bij automatische crawls | Reverse DNS of common-crawlers.json | Gewone crawlers van Google | |
| Google-Extended | Controletoken | Gemini-training en grounding in Gemini Apps en Vertex AI | Alleen een token; geen eigen user agent | Niet van toepassing | Gewone crawlers van Google | |
| Google-CloudVertexBot | Zoeken (op verzoek van site-eigenaar) | Crawlt sites waarvan de eigenaren er Vertex AI Agents op bouwen | Ja | Reverse DNS of common-crawlers.json | Gewone crawlers van Google | |
| Google-Agent | Agent van gebruiker | Agents op de infrastructuur van Google die op verzoek van gebruikers browsen en handelen | Negeert het meestal (door gebruiker gestart) | user-triggered-agents.json; sommige verzoeken ondertekend met Web Bot Auth | Gebruikersfetchers van Google | |
| Google-GeminiNotebook | Gebruiker | Haalt URL's op die gebruikers als bron toevoegen in Gemini Notebook (voorheen de agent Google-NotebookLM, ondersteund tot augustus 2026) | Negeert het meestal (door gebruiker gestart) | JSON-lijsten voor gebruikersfetchers | Gebruikersfetchers van Google | |
| Bingbot | Microsoft | Zoeken | Index van Bing, die ook de basis vormt voor antwoorden van Copilot | Ja; AI-gebruik regel je met noarchive/nocache op paginaniveau | bingbot.json of de tool Verify Bingbot van Bing | Bing Webmaster-blog |
| Applebot | Apple | Zoeken (kan ook trainen) | Zoeken in Spotlight, Siri en Safari; data kan ook Apple-modellen trainen | Ja; volgt de Googlebot-regels als Applebot niet genoemd wordt; negeert Crawl-delay | Reverse DNS (*.applebot.apple.com) of applebot.json | Over Applebot |
| Applebot-Extended | Apple | Controletoken | Sluit content uit van training van foundationmodellen van Apple | Alleen een token | Niet van toepassing | Over Applebot |
| Meta-ExternalAgent | Meta | Training | Traint foundationmodellen voor AI of indexeert content direct | Ja | User agent plus de gepubliceerde IP's van Meta | Webcrawlers van Meta |
| Meta-WebIndexer | Meta | Zoeken | Verbetert de zoekresultaten van Meta AI, zodat Meta AI je kan noemen en naar je kan linken | Ja | User agent plus de gepubliceerde IP's van Meta | Webcrawlers van Meta |
| Meta-ExternalFetcher | Meta | Gebruiker | Haalt links op verzoek van een gebruiker op, ook voor agentische taken | Kan het omzeilen | User agent plus de gepubliceerde IP's van Meta | Webcrawlers van Meta |
| Amazonbot | Amazon | Training | Verbetert producten van Amazon; kan gebruikt worden om AI-modellen van Amazon te trainen | Ja (RFC 9309); negeert Crawl-delay | Pagina met gepubliceerde IP's | Amazonbot |
| Amzn-SearchBot | Amazon | Zoeken | Zoekervaringen zoals Alexa; niet voor training | Ja; neemt de regels van andere zoekbots over als hij niet genoemd wordt | Pagina met gepubliceerde IP's | Amazonbot |
| Amzn-User | Amazon | Gebruiker | Haalt actuele informatie op voor vragen aan Alexa; niet voor training | Volgt mogelijk niet alle instructies | Pagina met gepubliceerde IP's | Amazonbot |
| MistralAI-Training | Mistral | Training | Bouwt datasets voor het trainen van Mistral-modellen | Ja, kan worden uitgesloten met Disallow | User agent | Mistral-crawlers |
| MistralAI-Index | Mistral | Zoeken | Indexeert content voor zoeken van Mistral in Vibe; niet voor training | Ja | mistralai-index-ips.json | Mistral-crawlers |
| MistralAI-User | Mistral | Gebruiker | Bezoekt pagina's wanneer gebruikers van Vibe een vraag stellen | Ja, bepaalt welke sites gebruikersverzoeken kunnen bereiken | mistralai-user-ips.json | Mistral-crawlers |
| DuckAssistBot | DuckDuckGo | Zoeken (realtime) | Crawlt pagina's voor de AI-ondersteunde antwoorden van DuckDuckGo; niet voor training | Ja, werkt na 72 uur | duckassistbot.json | DuckAssistBot |
| CCBot | Common Crawl | Training (open dataset) | Bouwt het open corpus van Common Crawl, dat op grote schaal wordt gebruikt voor modeltraining | Ja | Reverse DNS (*.crawl.commoncrawl.org, alleen IPv4) | CCBot |
Twee dingen maakt de tabel duidelijk. Ten eerste noemt de huidige pagina van Anthropic precies drie bots: ClaudeBot, Claude-SearchBot en Claude-User. Oudere lijsten bevatten nog „anthropic-ai" en „Claude-Web", maar die staan per oktober 2026 niet in de documentatie van Anthropic. Ten tweede veranderen de versienummers van OpenAI: op de dag dat we keken, toonden de voorbeeldstrings van OpenAI GPTBot/1.4 en OAI-SearchBot/1.4. Match dus altijd op het token, nooit op de volledige string.
Bots zonder officiële documentatie
Sommige bots die je in je logs tegenkomt, hebben geen pagina van de aanbieder die we op 18 oktober 2026 konden vinden. Bytespider van ByteDance is de bekendste, de Grok-gerelateerde agents van xAI zijn een ander voorbeeld. Externe overzichten zijn het niet eens over hoe ze zich gedragen, dus we hebben ze buiten de geverifieerde tabel gelaten. De beheerde robots.txt van Cloudflare bevat wel een disallow voor Bytespider, en Cloudflare meldde dat het aandeel van Bytespider in AI-crawlen tussen medio 2024 en medio 2025 daalde van 14,1% naar 2,4%. Is een van deze bots belangrijk voor je, dwing je beleid dan af met een WAF-regel in plaats van te vertrouwen op robots.txt.
Houden AI-crawlers zich aan robots.txt?
Gedocumenteerde trainings- en zoekcrawlers zeggen van wel, gebruikersfetchers zeggen vaak van niet, en robots.txt is nooit een vorm van toegangscontrole. De standaard zelf, RFC 9309, stelt dat „these rules are not a form of access authorization" (deze regels zijn geen vorm van toegangsautorisatie). Crawlers mogen je bestand bovendien tot 24 uur cachen. Daarom noemt elke aanbieder een vertraging voordat wijzigingen ingaan.
Wat een aanbieder belooft, is niet hetzelfde als wat je in de praktijk ziet. In augustus 2025 publiceerde Cloudflare een test waarin gloednieuwe domeinen die alles blokkeerden, toch tot in detail door Perplexity werden beschreven. Cloudflare zag naar eigen zeggen een openlijk gemelde Perplexity-User-agent die 20-25 miljoen verzoeken per dag deed, en een niet-gemelde, op Chrome lijkende agent met 3-6 miljoen. Daarna haalde Cloudflare Perplexity van de lijst met geverifieerde bots. Het gaat om de bevinding van één partij over één aanbieder, maar het laat zien waarom een user-agentstring op zich niets bewijst.
| Aanbieder | Hoe lang wijzigingen in robots.txt duren (volgens doc) | Crawl-delay |
|---|---|---|
| OpenAI (OAI-SearchBot) | Ongeveer 24 uur | Niet vermeld |
| Perplexity | Tot 24 uur | Niet vermeld |
| Amazon | Ongeveer 24 uur; kan een gecachte kopie gebruiken van maximaal 30 dagen oud | Niet ondersteund |
| Meta | Tot 24 uur | Niet vermeld |
| DuckDuckGo (DuckAssistBot) | 72 uur | Niet vermeld |
| Anthropic | Niet vermeld | Ondersteund |
| Apple | Niet vermeld | Niet ondersteund |
Wat kost het je om elke soort AI-crawler te blokkeren?
Trainingscrawlers blokkeren kost je vandaag weinig zichtbaarheid. Zoekcrawlers of gebruikersfetchers blokkeren kost je direct bronvermeldingen. De tabel zet elke klasse naast de kosten die de aanbieders zelf beschrijven.
| Als je dit blokkeert... | Blijf je buiten | Verlies je | Verschijn je nog wel in |
|---|---|---|---|
| Trainingscrawlers (GPTBot, ClaudeBot, Meta-ExternalAgent, Amazonbot, CCBot, Google-Extended, Applebot-Extended) | Toekomstige trainingsdatasets van die aanbieder | Weinig zichtbaarheid op korte termijn; mogelijk hoe goed toekomstige modellen je merk „kennen" zonder te zoeken | ChatGPT search, Claude search, Perplexity, Google Zoeken en AI Overviews, zolang hun zoekbots zijn toegestaan |
| AI-zoekcrawlers (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, Amzn-SearchBot, MistralAI-Index, DuckAssistBot) | De zoekindex van die engine | Bronvermeldingen en links in de antwoorden van die engine; OpenAI houdt alleen navigatielinks over | Klassieke zoekmachines, tenzij je die ook blokkeert |
| Gebruikersfetchers (ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User) | Live ophaalverzoeken van gebruikers, voor zover de aanbieder de blokkade respecteert | Antwoorden wanneer een gebruiker je URL plakt of ernaar vraagt; agenttaken zoals afrekenen of boeken | Antwoorden op basis van de index, als de zoekbot is toegestaan |
| Googlebot | Google Zoeken volledig | Organische rankings, AI Overviews en AI Mode in één keer | Niets op Google; dit wil je zelden |
Ook de schaal van de ruil telt. Cloudflare mat hoeveel pagina's elk AI-platform crawlt per bezoeker die het terugstuurt: in juli 2025 zat Anthropic op ongeveer 38.000 crawls per doorverwezen bezoeker en Perplexity op 194. Met die verhoudingen onderbouwen uitgevers waarom ze trainingscrawlers blokkeren en zoekcrawlers openhouden.
Welke AI-crawlers laat je toe en welke blokkeer je? Een beslismatrix per bedrijfsdoel
Begin bij wat je verkoopt. Kan een aanbeveling van een AI-assistent je een klant opleveren, laat dan elke zoekcrawler en gebruikersfetcher toe en behandel training als een aparte, kleinere beslissing.
| Jouw situatie | Trainingscrawlers | Zoekcrawlers | Gebruikersfetchers en agents | Waarom |
|---|---|---|---|---|
| B2B-SaaS, bureaus, lokale dienstverleners | Toestaan (of blokkeren, lage kosten) | Toestaan | Toestaan | Kopers maken hun shortlist van leveranciers in AI-antwoorden; aanwezig zijn in de kennis van het model helpt ook bij vermeldingen waar niemand om vroeg |
| E-commerce | Jouw keuze | Toestaan | Toestaan, en zet ondertekende agents op de allowlist van je WAF | Shoppingantwoorden verwijzen naar productpagina's, en agents moeten winkelwagen en checkout kunnen bereiken |
| Nieuwssites en uitgevers die van advertenties leven | Blokkeren | Toestaan, of blokkeren op advertentiepagina's | Per aanbieder beslissen | Content is het product; bronvermeldingen sturen nog steeds een deel van de lezers terug |
| Developerdocumentatie en open-sourceprojecten | Toestaan | Toestaan | Toestaan | Developers vragen assistenten hoe ze je API gebruiken; accurate kennis in het model verlaagt de supportdruk |
| Content achter een betaalmuur of onder licentie | Blokkeren | Alleen indexpagina's toestaan | Blokkeren met een WAF als de licentie dat vereist | Houd teasers citeerbaar en de volledige tekst erbuiten |
| Staging, intranetten, privé-apps | Blokkeren | Blokkeren | Blokkeren | Gebruik authenticatie; robots.txt is een verzoek, geen slot |
| Server die zwaar wordt gecrawld | Rate-limiten of blokkeren | Toestaan, rate-limiten op de CDN | Toestaan | Los de belasting op aan de edge in plaats van bronvermeldingen te verliezen |
Hoe blokkeer je AI-trainingscrawlers en laat je AI-zoeken toe in robots.txt?
Geef elk trainingstoken een eigen groep met Disallow: / en laat zoekcrawlers onder je normale regels vallen. Een crawler volgt alleen de meest specifieke groep waarin hij genoemd wordt, dus een trainingsblokkade loopt nooit over naar zoekbots.
Snippet 1: training blokkeren, AI-zoeken en gebruikersfetchers behouden
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Amazonbot
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

User-agent: *
Allow: /

Sitemap: https://www.example.com/sitemap.xml
RFC 9309 staat toe dat meerdere User-agent-regels één groep delen, en de matching is niet hoofdlettergevoelig. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot en Bingbot vallen terug op de *-groep en blijven toegestaan.
Snippet 2: zet AI-zoeken expliciet open
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Meta-WebIndexer
User-agent: Amzn-SearchBot
User-agent: MistralAI-Index
User-agent: DuckAssistBot
Allow: /
Disallow: /cart/
Disallow: /account/
Door zoekbots expliciet te noemen, bescherm je jezelf tegen een toekomstige algemene regel die iemand anders schrijft, zoals een plug-in die User-agent: * met Disallow: / toevoegt. Houd privépaden binnen de groep op disallow, want een benoemde groep vervangt voor die bot de *-groep in plaats van er iets aan toe te voegen.
Snippet 3: drie valkuilen die echte bestanden breken
- Applebot neemt de regels van Googlebot over. Volgens Apple volgt Applebot de Googlebot-groep als je bestand Applebot niet noemt, maar Googlebot wel. Een blokkade die alleen voor Googlebot bedoeld is, kan je dus ongemerkt uit Siri en Spotlight halen.
- Amzn-SearchBot neemt de regels van andere zoekbots over als hij niet genoemd wordt, aldus Amazon. Noem hem als je een andere uitkomst wilt.
- Subdomeinen hebben een eigen bestand nodig. Anthropic en Amazon zeggen allebei dat ze robots.txt per host lezen, dus
docs.example.comheeft een eigen exemplaar nodig.
Je kunt deze groepen opbouwen en controleren met de gratis robots.txt-generator van AI Rank Lab, en onze eerdere robots.txt-templates voor AI-crawlers gaan dieper in op opstellingen met volledige en selectieve toegang.
Hoe controleer je of een AI-crawler echt is en niet gespoofd?
Vertrouw nooit alleen op de user agent: iedereen kan „GPTBot" in een header zetten, en Common Crawl waarschuwt op zijn eigen pagina dat crawlers zich ten onrechte als CCBot voordoen. Aanbieders ondersteunen drie verificatiemethoden, en welke je gebruikt hangt af van de aanbieder.
- Reverse DNS, daarna forward DNS. Draai
hostop het IP-adres uit je log, controleer of de hostnaam eindigt op het domein van de aanbieder, draai danhostop die hostnaam en kijk of je hetzelfde IP-adres terugkrijgt. Google beschrijft dit voorgooglebot.com,google.comengoogleusercontent.comin zijn verificatiegids; Apple gebruikt*.applebot.apple.com; Common Crawl gebruikt*.crawl.commoncrawl.org(alleen IPv4). - Vergelijk het IP-adres met de gepubliceerde lijst van de aanbieder. OpenAI, Anthropic, Perplexity, Google, Apple, Microsoft, DuckDuckGo, Mistral en Amazon publiceren IP-ranges. Voor OpenAI, Anthropic en Perplexity is dit de enige methode, want zij documenteren geen reverse-DNS-patroon.
- Controleer een cryptografische handtekening (Web Bot Auth). De Cloud browser van ChatGPT ondertekent zijn verzoeken volgens RFC 9421 met een
Signature-Agent-header met de waarde"https://chatgpt.com". Google test hetzelfde IETF-concept voor een deel van de Google-Agent-verzoeken, ondertekend alshttps://agent.bot.goog, en de pagina over Web Bot Auth adviseert IP-controles als terugvaloptie te houden, omdat niet elk verzoek ondertekend is.
# Reverse en daarna forward lookup (voorbeeld Google)
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com

# IP-lijstcontrole voor de zoekcrawler van OpenAI
curl -s https://openai.com/searchbot.json | python3 -c "
import json, sys, ipaddress
ip = ipaddress.ip_address(sys.argv[1])
nets = [p.get('ipv4Prefix') or p.get('ipv6Prefix') for p in json.load(sys.stdin)['prefixes']]
print(any(ip in ipaddress.ip_network(n) for n in nets))
" 203.0.113.7
Hoe actueel zijn de gepubliceerde IP-lijsten?
Op 18 oktober 2026 hebben we elk gepubliceerd IP-bestand van AI-crawlers gedownload en het veld creationTime gelezen dat elke aanbieder erin zet. Een oude datum kan gewoon betekenen dat de ranges niet zijn veranderd, maar het vertelt je hoeveel je op een hardgecodeerde allowlist kunt vertrouwen. Het laat ook zien welke lijsten geen rekening kunnen houden met verkeer dat de aanbieder nooit heeft gemeld.
| Gepubliceerde lijst | creationTime in bestand | IPv4- / IPv6-prefixen |
|---|---|---|
| Gewone crawlers van Google (Googlebot, Google-CloudVertexBot) | 2026-10-16 | 170 / 147 |
| Agents van Google op verzoek van gebruikers (Google-Agent) | 2026-10-16 | 12 / 8 |
| OpenAI ChatGPT-User | 2026-10-07 | 234 / 0 |
| Anthropic (alle drie de bots, één lijst) | 2026-10-07 | 38 / 0 |
| OpenAI GPTBot | 2026-09-22 | 18 / 0 |
| Apple Applebot | 2026-09-15 | 24 / 0 |
| DuckDuckGo DuckAssistBot | 2026-09-01 | 486 / 0 |
| OpenAI OAI-AdsBot | 2026-05-12 | 2 / 0 |
| Mistral MistralAI-Index | 2026-04-19 | 2 / 0 |
| OpenAI OAI-SearchBot | 2026-01-02 | 39 / 0 |
| Perplexity Perplexity-User | 2025-10-17 | 4 / 0 |
| Mistral MistralAI-User | 2025-02-19 | 4 / 0 |
| Perplexity PerplexityBot | 2025-02-07 | 8 / 0 |
| Microsoft Bingbot | 2024-01-03 | 28 / 0 |
Twee lessen voor de praktijk. De lijsten van Google en de ChatGPT-User-lijst van OpenAI zijn in de afgelopen twee weken veranderd, dus een firewall-allowlist die je deze zomer hebt gekopieerd, klopt waarschijnlijk al niet meer. Haal deze bestanden dagelijks of wekelijks opnieuw op. En Anthropic zegt dat het blokkeren van zijn IP-adressen „may not work correctly or persistently guarantee an opt-out" (mogelijk niet goed werkt of geen blijvende opt-out garandeert), omdat Anthropic je robots.txt dan niet meer kan lezen. Gebruik robots.txt dus om je af te melden en IP-adressen alleen om te verifiëren.
Hoe zie je activiteit van AI-crawlers: serverlogs of JavaScript-tags?
Gebruik server- of CDN-logs voor crawlers en JavaScript-analytics voor menselijke bezoekers die via AI-assistenten binnenkomen. Een JS-tag draait alleen als iets de JavaScript van de pagina uitvoert, en de meeste AI-crawlers doen dat niet. Uit de analyse van Vercel van zijn eigen netwerk bleek dat geen van de grote AI-crawlers JavaScript renderde. De crawlers van ChatGPT en Claude haalden wel JS-bestanden op (11,50% en 23,84% van hun verzoeken), maar voerden ze niet uit. De uitzonderingen waren Gemini, dat de rendering van Googlebot gebruikt, en Applebot. Dat onderzoek is van december 2024, dus test het opnieuw op je eigen site, maar het komt overeen met wat wij zien.
Google Analytics maakt het gat bewust groter. GA4 sluit verkeer van bekende bots en spiders automatisch uit, en je kunt dat niet uitzetten of zien hoeveel er is weggefilterd. GA4 is de juiste tool voor AI-verwijzingsverkeer, waarover je meer leest in AI-verwijzingsverkeer meten in GA4, en de verkeerde tool om crawlers te tellen.
Hetzelfde patroon zien we in de eigen trackingdata van AI Rank Lab. Onze JavaScript-tag registreert betrouwbaar mensen die doorklikken vanuit ChatGPT, Gemini, Perplexity en Claude, maar ziet maar een klein, niet-representatief deel van het crawlerverkeer. Daarom publiceren we daar geen crawleraantallen uit.
Een logcheck van vijf minuten
- Download een dag aan ruwe accesslogs bij je host of CDN (Nginx en Apache loggen allebei de user agent in het standaard combined-formaat).
- Tel de verzoeken per AI-token:
grep -oiE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|Claude-User|PerplexityBot|Perplexity-User|Meta-WebIndexer|meta-externalagent|Amazonbot|Amzn-SearchBot|Applebot|bingbot|Googlebot|CCBot|DuckAssistBot|MistralAI-[A-Za-z]+" access.log | sort | uniq -c | sort -rn - Controleer bij de tokens bovenaan de statuscodes. Een muur van 403's of 429's betekent meestal dat een WAF- of CDN-regel een bot blokkeert die je robots.txt toestaat.
- Verifieer een steekproef van IP-adressen met de methoden hierboven voordat je een telling vertrouwt.
- Kijk welke URL's zoekbots opvragen. Halen OAI-SearchBot of Claude-SearchBot alleen je homepage op, kijk dan naar je interne links en je sitemap.
Tools die activiteit van AI-crawlers laten zien
Openheid: AI Rank Lab is ons eigen product. We zetten het bovenaan omdat dit onze site is, en we hebben voor elke tool hieronder dezelfde criteria aangehouden.
- AI Rank Lab - AI-bottracking registreert verwijzingen vanuit AI-assistenten en de bezoeken van AI-bots die de tag kan zien, per pagina, naast het volgen van je AI-zichtbaarheid en bronvermeldingen. Combineer het met logs voor volledige crawleraantallen, om de redenen hierboven.
- Cloudflare AI Crawl Control - als je site via Cloudflare loopt, is dit het meest complete crawleroverzicht dat er is, omdat het elk verzoek aan de edge ziet, ook van bots die nooit JavaScript uitvoeren. Het toont ook per crawler of robots.txt wordt nageleefd.
- Logbestandanalyzers zoals de Log File Analyser van Screaming Frog of GoAccess - werken met ruwe logs van elke host en zijn sterk voor eenmalige audits.
- Ruwe logs plus de grep hierboven - gratis, exact, en de basislijn waar elke andere tool op moet uitkomen.
Voor een uitgebreidere monitoringroutine rond de drie grootste bots, zie onze gids voor het monitoren van GPTBot, ClaudeBot en PerplexityBot.
Hoe regelen Cloudflare en andere CDN's AI-bots?
CDN's dwingen aan de rand van het netwerk af wat robots.txt alleen maar kan vragen. AI Crawl Control van Cloudflare, beschikbaar op alle abonnementen, laat zien welke AI-diensten je site bezoeken, laat je elke crawler toestaan of blokkeren, houdt overtredingen van robots.txt bij en biedt pay per crawl aan in een private bèta.
Het AI-botbeleid van Cloudflare gebruikt inmiddels dezelfde driedeling als dit artikel. De instellingen voor Block AI Bots bieden aparte presets voor Search, Agent en Training, elk met „block on all pages", „block on pages with ads" of „allow". Volgens de documentatie krijgen nieuwe domeinen vanaf 15 september 2026 aangepaste standaardinstellingen: Training- en Agent-bots geblokkeerd op pagina's met advertenties, Search toegestaan, en crawlers met een gemengd doel (zoeken en trainen) geblokkeerd door elke trainingsblokkade. Zet je na die datum een site op Cloudflare en vraag je je af waarom ChatGPT-User of Claude-User 403's krijgt op je blog, kijk dan eerst naar deze instelling.
Cloudflare kan robots.txt ook voor je beheren. Met Bot Preference Sync aan zet de beheerde robots.txt disallow-groepen voor Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot en meta-externalagent vóór je bestaande regels, plus een Content Signals-regel (search=yes, ai-train=no). Content Signals is een door Cloudflare voorgesteld vocabulaire (search, ai-input, ai-train) dat aangeeft hoe content na het ophalen gebruikt mag worden. Of een aanbieder zich daaraan houdt, bepaalt die aanbieder zelf.
Andere aanbieders ondersteunen hetzelfde patroon. De documentatie van Perplexity bevat WAF-richtlijnen voor Cloudflare en AWS WAF op basis van zijn IP-lijsten, en het helpcentrum van OpenAI laat zien hoe je de ondertekende Cloud browser op de allowlist zet in Akamai (botnaam „ChatGPT Agent") en Cloudflare (detectie-ID 129220581). Welke CDN je ook gebruikt, de volgorde is steeds dezelfde: beslis per klasse, leg het vast in robots.txt, dwing het alleen aan de edge af waar je een harde blokkade nodig hebt, en controleer je logs opnieuw na elke wijziging aan je CDN.
Google en Bing: de twee uitzonderingen
Heeft het blokkeren van Google-Extended invloed op Google Zoeken of AI Overviews?
Nee. Google stelt dat Google-Extended „does not impact a site's inclusion in Google Search nor is it used as a ranking signal" (geen invloed heeft op de opname van een site in Google Zoeken en niet als rankingsignaal wordt gebruikt). De documentatie over AI-functies zegt expliciet dat robots.txt-regels voor Googlebot bepalen wat er in Zoeken gebeurt, inclusief AI Overviews en AI Mode, en dat je beperkt wat er verschijnt met nosnippet, data-nosnippet, max-snippet of noindex. Google-Extended gaat over de training van Gemini-modellen en grounding in Gemini Apps en Vertex AI, en die staan los van Zoeken.
Hoe bepaal je of Microsoft Copilot je content gebruikt?
Microsoft heeft geen apart token voor een AI-crawler. Bingbot doet het crawlen, en AI-gebruik regel je met robots-metatags op paginaniveau. De recentste officiële richtlijn die we vonden, is de aankondiging van het Bing-team uit 2023, geschreven toen Copilot nog Bing Chat heette: content met de tag noarchive wordt niet opgenomen of gelinkt in de chatantwoorden van Bing en niet gebruikt om de foundationmodellen van Microsoft te trainen; content met de tag nocache kan verschijnen met alleen URL, titel en snippet; content zonder een van beide tags mag volledig worden gebruikt. Met beide tags blijf je gewoon in de normale resultaten van Bing staan. Bingbot blokkeren in robots.txt haalt je ook uit Bing zelf, dus gebruik liever de metatags.
Beperkingen en hoe we hebben gecontroleerd
Op 18 oktober 2026 hebben we de crawlerpagina van elke hierboven genoemde aanbieder gelezen, elke gepubliceerde IP-lijst gedownload en de creationTime in elk bestand genoteerd. De helppagina van Microsoft over crawlers werkt alleen met JavaScript en konden we niet renderen, dus de rij voor Bingbot leunt op de Bing Webmaster-blog van Microsoft, de tool Verify Bingbot en het gepubliceerde bingbot.json. De robots.txt-kolommen geven weer wat elke aanbieder zegt, niet wat wij zelf hebben gemeten; de bevindingen van Cloudflare over Perplexity zijn het belangrijkste openbare bewijs dat die twee kunnen verschillen. Aanbieders hernoemen en voegen vaak bots toe (Google heeft zijn fetchertoken Google-NotebookLM bijvoorbeeld vervangen door Google-GeminiNotebook), dus beschouw elke lijst, ook deze, als accuraat op de datum van controle.
Wil je zien of je crawlerbeleid echt bronvermeldingen oplevert? AI Rank Lab volgt je vermeldingen en geciteerde pagina's in ChatGPT, Claude, Gemini, Perplexity, Google AI Overviews en AI Mode, naast het AI-verwijzingsverkeer dat die antwoorden naar je sturen.
Get a free AI ranking consultation
Want your brand to show up when ChatGPT, Gemini and Perplexity answer questions in your market? Tell us about your site and our team will send a personalized strategy.


